


 Maison
Il devrait obtenir 9 millions de dollars pour développer des systèmes d’IA plus fiables.
Malgré la puissance croissante des LLM, les hallucinations demeurent un défi persistant. Même les modèles les plus avancés génèrent des erreurs, et bien que des méthodes existent pour les détecter, l’industrie travaille encore à affiner l’approche la plus efficace.
Probably, qui a récemment obtenu 9 millions de dollars en financement initial d’Andreessen Horowitz, vise à développer une méthode plus fiable pour la détection des erreurs.
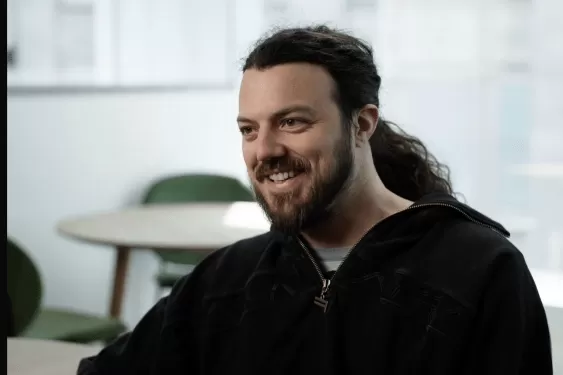
Le fondateur Peter Elias (voir photo ci-dessus) explique que la mission de l’entreprise est d’empêcher les hallucinations et les erreurs factuelles d’atteindre les utilisateurs, en visant une précision de 99,99 % typique des systèmes déterministes — un niveau beaucoup plus difficile à atteindre avec l’intelligence artificielle. Pour y parvenir avec les LLM, souligne-t-il, il est nécessaire de repenser les hypothèses fondamentales de l’ingénierie en IA.
Le produit initial de Probably est un outil de science des données conçu pour générer rapidement des réponses à partir de jeux de données complexes. Chaque résultat inclut une citation ainsi qu’un historique de sa dérivation, une pratique qui devient de plus en plus courante dans les outils d’IA.
Afin d’éviter que des erreurs ne se glissent dans ces synthèses, l’entreprise a mis au point un système complexe que Elias qualifie de « combinaison mécanique pour la science des données ». Les réponses initiales du LLM sont validées par un système déterministe, qui rejette tout résultat incompatible avec le jeu de données. Le LLM a été entraîné en fonction de ce validateur, et l’ensemble du système est optimisé pour la vitesse et la précision, selon l’entreprise.
« Ce que nous avons découvert, c’est que plus votre système de validation est solide, moins le modèle a besoin d’être puissant », dit Elias. « Si vous affinez suffisamment le contexte, le modèle n’a pas à se démener pour produire des résultats corrects. En somme, il s’agit de réduire l’ambiguïté. »
Cela permet à l’outil de science des données de Probably de fonctionner avec des modèles d’IA bien plus modestes. Elias note que la version actuelle utilise un modèle « quatre classes moins puissant que les modèles de pointe », ce qui lui permet de s’exécuter sur du matériel local — un ordinateur de bureau plutôt qu’un centre de données — réduisant ainsi considérablement les coûts liés à l’utilisation de l’IA.
Cette approche est d’autant plus pertinente que les coûts des tokens augmentent et que de nombreux clients réévaluent leurs budgets consacrés à l’IA. La vision d’Elias dépasse la science des données ; le même moteur peut être adapté à des domaines tels que la comptabilité ou les services médicaux — en ses termes, « tout domaine nécessitant une grande précision ».
« Il est frappant que les grands laboratoires d’IA n’aient même pas essayé cette approche », dit Elias. « Ils ont des incitations contraires, car ils tirent profit du besoin de corrections répétées. »
Article connexe
 Le TechCrunch Disrupt 2026 touche à sa fin
La dernière journée du TechCrunch Disrupt 2026 est arrivée, clôturant une semaine intense. Avec plus de 10 000 fondateurs, investisseurs et leaders du secteur technologique réunis au Moscone West de S
QueryStory appelle à la prudence face aux contenus générés par l'IA
En 2009, Shapor Naghibzadeh a découvert le pouvoir d’une narration captivante alors qu’il travaillait comme ingénieur en exploitation de systèmes chez Google. Lors de l’opération Aurora, alors que des
Un code d'IA a coûté 12,15 millions de yuans, soit 860 % de plus que le budget prévu : un incident interne chez Amazon tire la sonnette d'alarme sur les coûts liés à l'IA dans les entreprises
Les médias américains ont récemment fait état d’un important dépassement de budget lié à l’IA chez Amazon, où l’utilisation par un ingénieur du modèle « Claude Sonnet » d’Anthropic pour associer les d
Recommandations de sujets spéciaux liés
Conception et art
 Les meilleurs outils d'illustration basés sur l'IA : créez plus rapidement des scènes éditoriales et des illustrations de couverture
Les meilleurs outils d'illustration IA de 2026 : notre sélection regroupe les outils les plus performants pour créer rapidement de superbes scènes éditoriales et des couvertures accrocheuses. Chaque option a été soumise à des tests rigoureux en conditions réelles ; nous vous proposons une comparaison entre les versions gratuites et payantes afin de vous aider à trouver celle qui correspond le mieux à votre flux de travail. Essayez dès aujourd’hui ces solutions incontournables pour exploiter pleinement le potentiel de l’IA et booster votre productivité créative. Découvrez-les dès maintenant sur XIX.AI.
 10 outils
 xix.ai
Éducation et apprentissage
Les meilleurs professeurs particuliers spécialisés en IA pour la préparation aux examens : entraînez-vous en maths, en sciences et en anglais
Les meilleurs tuteurs IA 2026 les mieux notés pour la préparation aux examens sont disponibles ici, sur XIX.AI ! Notre sélection comprend des outils puissants et révolutionnaires qui proposent une comparaison entre les versions gratuites et payantes, des tests concrets et des classements mis à jour chaque semaine. Ils vous aident à améliorer votre efficacité à l'écrit, à simplifier l'apprentissage de sujets complexes et à libérer votre potentiel académique. Découvrez dès maintenant l'outil de préparation aux examens qui vous convient le mieux et commencez à créer dès aujourd'hui pour exploiter pleinement les avantages de l'IA !
10 outils
xix.ai
Finance
Outils de planification budgétaire par IA pour la gestion personnelle des finances
2026 Derniers Meilleurs Outils de Planification Budgétaire par IA les mieux notés pour la gestion personnelle des finances sont ici sur XIX.AI ! Cette collection soigneusement sélectionnée propose des solutions puissantes et révolutionnaires qui vous aident à réaliser des tests concrets, à comprendre vos habitudes de dépenses et à créer des plans personnalisés pour améliorer votre productivité. Profitez d’une comparaison entre versions gratuites et payantes ainsi que de classements détaillés. Des outils incontournables conçus pour simplifier la gestion financière et exploiter pleinement votre avantage grâce à l’IA. Explorez dès maintenant !
11 outils
xix.ai
Santé et bien-être
Assistants de suivi du sommeil par l’IA : améliorez votre récupération grâce à de meilleures habitudes avant le coucher
2026 : Découvrez les meilleurs assistants de suivi du sommeil basés sur l’IA, hautement notés et récemment mis à jour, conçus pour une récupération optimale. Ce guide hebdomadaire entièrement actualisé présente des outils puissants qui offrent des tests en conditions réelles, des comparaisons entre versions gratuites et payantes, ainsi que des classements détaillés afin de vous aider à trouver la solution idéale pour améliorer la qualité du sommeil et favoriser de meilleures habitudes avant le coucher. Explorez-le dès maintenant sur XIX.AI pour tirer parti des avantages offerts par l’IA.
10 outils
xix.ai
Analyse des données
Copilotes SQL basés sur l'IA pour l'analyse des produits et du chiffre d'affaires
2026 : les meilleurs copilotes SQL IA les mieux notés pour l'analyse des produits et du chiffre d'affaires ! XIX.AI a sélectionné une gamme d’outils puissants et révolutionnaires à essayer absolument, qui sont soumis à des tests en conditions réelles via des classements mis à jour chaque semaine. Ces outils aident les utilisateurs à booster considérablement leur productivité en accélérant l’analyse des données, en simplifiant les requêtes complexes et en générant des informations précises permettant de prendre des décisions commerciales plus éclairées. Explorez-les dès maintenant pour découvrir l’outil idéal qui vous permettra de tirer pleinement parti de l’IA !
14 outils
xix.ai
Éducation et apprentissage
Les meilleurs outils d'aide aux devoirs basés sur l'IA qui enseignent : apprenez les concepts, pas seulement les réponses
2026 : les meilleurs outils d'aide aux devoirs basés sur l'IA, les mieux notés, qui enseignent les concepts fondamentaux et ne se contentent pas de fournir des réponses. Des outils puissants pour les élèves. Une sélection incontournable à ne pas manquer. Mise à jour hebdomadaire. Comparaison entre les versions gratuites et payantes. Tests en conditions réelles. Classements précis pour vous aider à exploiter pleinement votre potentiel d'apprentissage. Explorez dès maintenant pour découvrir l'outil idéal qui vous permettra d'étudier plus efficacement.
10 outils
xix.ai

 commentaires (0)
Malgré la puissance croissante des LLM, les hallucinations demeurent un défi persistant. Même les modèles les plus avancés génèrent des erreurs, et bien que des méthodes existent pour les détecter, l’industrie travaille encore à affiner l’approche la plus efficace.
Probably, qui a récemment obtenu 9 millions de dollars en financement initial d’Andreessen Horowitz, vise à développer une méthode plus fiable pour la détection des erreurs.
Le fondateur Peter Elias (voir photo ci-dessus) explique que la mission de l’entreprise est d’empêcher les hallucinations et les erreurs factuelles d’atteindre les utilisateurs, en visant une précision de 99,99 % typique des systèmes déterministes — un niveau beaucoup plus difficile à atteindre avec l’intelligence artificielle. Pour y parvenir avec les LLM, souligne-t-il, il est nécessaire de repenser les hypothèses fondamentales de l’ingénierie en IA.
Le produit initial de Probably est un outil de science des données conçu pour générer rapidement des réponses à partir de jeux de données complexes. Chaque résultat inclut une citation ainsi qu’un historique de sa dérivation, une pratique qui devient de plus en plus courante dans les outils d’IA.
Afin d’éviter que des erreurs ne se glissent dans ces synthèses, l’entreprise a mis au point un système complexe que Elias qualifie de « combinaison mécanique pour la science des données ». Les réponses initiales du LLM sont validées par un système déterministe, qui rejette tout résultat incompatible avec le jeu de données. Le LLM a été entraîné en fonction de ce validateur, et l’ensemble du système est optimisé pour la vitesse et la précision, selon l’entreprise.
« Ce que nous avons découvert, c’est que plus votre système de validation est solide, moins le modèle a besoin d’être puissant », dit Elias. « Si vous affinez suffisamment le contexte, le modèle n’a pas à se démener pour produire des résultats corrects. En somme, il s’agit de réduire l’ambiguïté. »
Cela permet à l’outil de science des données de Probably de fonctionner avec des modèles d’IA bien plus modestes. Elias note que la version actuelle utilise un modèle « quatre classes moins puissant que les modèles de pointe », ce qui lui permet de s’exécuter sur du matériel local — un ordinateur de bureau plutôt qu’un centre de données — réduisant ainsi considérablement les coûts liés à l’utilisation de l’IA.
Cette approche est d’autant plus pertinente que les coûts des tokens augmentent et que de nombreux clients réévaluent leurs budgets consacrés à l’IA. La vision d’Elias dépasse la science des données ; le même moteur peut être adapté à des domaines tels que la comptabilité ou les services médicaux — en ses termes, « tout domaine nécessitant une grande précision ».
« Il est frappant que les grands laboratoires d’IA n’aient même pas essayé cette approche », dit Elias. « Ils ont des incitations contraires, car ils tirent profit du besoin de corrections répétées. »








 Le TechCrunch Disrupt 2026 touche à sa fin
La dernière journée du TechCrunch Disrupt 2026 est arrivée, clôturant une semaine intense. Avec plus de 10 000 fondateurs, investisseurs et leaders du secteur technologique réunis au Moscone West de S
 QueryStory appelle à la prudence face aux contenus générés par l'IA
En 2009, Shapor Naghibzadeh a découvert le pouvoir d’une narration captivante alors qu’il travaillait comme ingénieur en exploitation de systèmes chez Google. Lors de l’opération Aurora, alors que des
 Un code d'IA a coûté 12,15 millions de yuans, soit 860 % de plus que le budget prévu : un incident interne chez Amazon tire la sonnette d'alarme sur les coûts liés à l'IA dans les entreprises
Les médias américains ont récemment fait état d’un important dépassement de budget lié à l’IA chez Amazon, où l’utilisation par un ingénieur du modèle « Claude Sonnet » d’Anthropic pour associer les d

Les meilleurs outils d'illustration IA de 2026 : notre sélection regroupe les outils les plus performants pour créer rapidement de superbes scènes éditoriales et des couvertures accrocheuses. Chaque option a été soumise à des tests rigoureux en conditions réelles ; nous vous proposons une comparaison entre les versions gratuites et payantes afin de vous aider à trouver celle qui correspond le mieux à votre flux de travail. Essayez dès aujourd’hui ces solutions incontournables pour exploiter pleinement le potentiel de l’IA et booster votre productivité créative. Découvrez-les dès maintenant sur XIX.AI.
10 outils
xix.ai

Les meilleurs tuteurs IA 2026 les mieux notés pour la préparation aux examens sont disponibles ici, sur XIX.AI ! Notre sélection comprend des outils puissants et révolutionnaires qui proposent une comparaison entre les versions gratuites et payantes, des tests concrets et des classements mis à jour chaque semaine. Ils vous aident à améliorer votre efficacité à l'écrit, à simplifier l'apprentissage de sujets complexes et à libérer votre potentiel académique. Découvrez dès maintenant l'outil de préparation aux examens qui vous convient le mieux et commencez à créer dès aujourd'hui pour exploiter pleinement les avantages de l'IA !
10 outils
xix.ai

2026 Derniers Meilleurs Outils de Planification Budgétaire par IA les mieux notés pour la gestion personnelle des finances sont ici sur XIX.AI ! Cette collection soigneusement sélectionnée propose des solutions puissantes et révolutionnaires qui vous aident à réaliser des tests concrets, à comprendre vos habitudes de dépenses et à créer des plans personnalisés pour améliorer votre productivité. Profitez d’une comparaison entre versions gratuites et payantes ainsi que de classements détaillés. Des outils incontournables conçus pour simplifier la gestion financière et exploiter pleinement votre avantage grâce à l’IA. Explorez dès maintenant !
11 outils
xix.ai

2026 : Découvrez les meilleurs assistants de suivi du sommeil basés sur l’IA, hautement notés et récemment mis à jour, conçus pour une récupération optimale. Ce guide hebdomadaire entièrement actualisé présente des outils puissants qui offrent des tests en conditions réelles, des comparaisons entre versions gratuites et payantes, ainsi que des classements détaillés afin de vous aider à trouver la solution idéale pour améliorer la qualité du sommeil et favoriser de meilleures habitudes avant le coucher. Explorez-le dès maintenant sur XIX.AI pour tirer parti des avantages offerts par l’IA.
10 outils
xix.ai

2026 : les meilleurs copilotes SQL IA les mieux notés pour l'analyse des produits et du chiffre d'affaires ! XIX.AI a sélectionné une gamme d’outils puissants et révolutionnaires à essayer absolument, qui sont soumis à des tests en conditions réelles via des classements mis à jour chaque semaine. Ces outils aident les utilisateurs à booster considérablement leur productivité en accélérant l’analyse des données, en simplifiant les requêtes complexes et en générant des informations précises permettant de prendre des décisions commerciales plus éclairées. Explorez-les dès maintenant pour découvrir l’outil idéal qui vous permettra de tirer pleinement parti de l’IA !
14 outils
xix.ai

2026 : les meilleurs outils d'aide aux devoirs basés sur l'IA, les mieux notés, qui enseignent les concepts fondamentaux et ne se contentent pas de fournir des réponses. Des outils puissants pour les élèves. Une sélection incontournable à ne pas manquer. Mise à jour hebdomadaire. Comparaison entre les versions gratuites et payantes. Tests en conditions réelles. Classements précis pour vous aider à exploiter pleinement votre potentiel d'apprentissage. Explorez dès maintenant pour découvrir l'outil idéal qui vous permettra d'étudier plus efficacement.
10 outils
xix.ai












