


 Lar
Provavelmente conseguirá recursos da ordem de 9 milhões de dólares para desenvolver uma IA mais confiável.
Apesar do crescente poder dos LLMs, as alucinações continuam sendo um desafio persistente. Mesmo os modelos mais avançados geram erros, e embora existam métodos para detectá-los, o setor ainda está aperfeiçoando a melhor abordagem.
A Probably, que recentemente obteve 9 milhões de dólares em financiamento inicial da Andreessen Horowitz, tem como objetivo desenvolver um método mais robusto para detecção de erros.
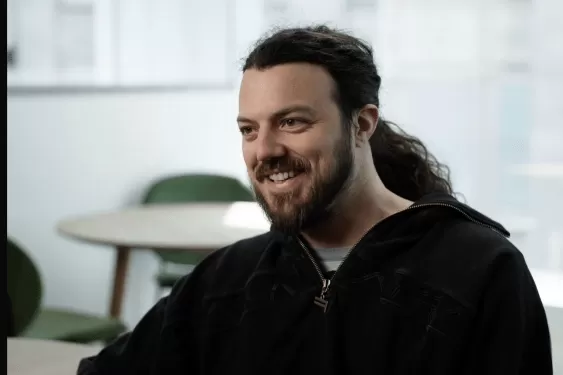
O fundador Peter Elias (na foto acima) explica que a missão da empresa é impedir que alucinações e erros factuais cheguem aos usuários, visando uma precisão de 99,99%, típica dos sistemas determinísticos — um nível muito mais difícil de alcançar com inteligência artificial. Para conseguir isso com LLMs, ele ressalta que é preciso repensar as premissas fundamentais da engenharia de IA.
O produto inicial da Probably é uma ferramenta de ciência de dados projetada para gerar respostas rápidas a partir de conjuntos de dados complexos. Cada resultado inclui uma citação e um rastro de auditoria de sua derivação, prática que está se tornando padrão em ferramentas de IA.
Para evitar que erros cheguem a esses resumos, a empresa criou um sistema elaborado que Elias chama de “traje mecânico de ciência de dados”. As respostas iniciais do LLM são validadas por um sistema determinístico, que rejeita quaisquer resultados inconsistentes com o conjunto de dados. O LLM foi treinado para funcionar em conjunto com esse validador, e todo o sistema é otimizado para velocidade e precisão, segundo a empresa.
“O que aprendemos é que, quanto mais robusto for o seu sistema de suporte, menor precisa ser o poder do modelo”, afirma Elias. “Se você aperfeiçoar suficientemente o contexto, o modelo não precisará se esforçar para produzir resultados corretos. Essencialmente, trata-se de reduzir a ambiguidade.”
Isso permite que a ferramenta de ciência de dados da Probably opere com modelos de IA muito menores. Elias observa que a versão atual utiliza um modelo “quatro categorias mais fraco do que os modelos de ponta”, o que lhe permite rodar em hardware local — um computador desktop, e não em um data center — reduzindo significativamente os custos associados ao uso da IA.
Essa abordagem é oportuna, já que os custos dos tokens estão aumentando e muitos clientes estão reavaliando seus orçamentos para IA. A visão de Elias vai além da ciência de dados; o mesmo mecanismo pode ser adaptado para casos de uso como contabilidade ou serviços médicos — em suas palavras, “qualquer cenário sensível à precisão”.
“É surpreendente que os principais laboratórios de IA ainda nem tenham tentado essa abordagem”, diz Elias. “Eles têm incentivos contrários, pois lucram com a necessidade de correções repetidas.”
Artigo relacionado
 O TechCrunch Disrupt 2026 chega ao fim
Chegou o último dia do TechCrunch Disrupt 2026, encerrando uma semana intensa. Com mais de 10.000 fundadores, investidores e líderes do setor de tecnologia reunidos no Moscone West, em São Francisco,
A QueryStory recomenda cautela em relação ao conteúdo gerado por IA
Em 2009, Shapor Naghibzadeh descobriu o poder de uma narrativa envolvente enquanto trabalhava como engenheiro de operações de sistemas no Google. Durante a Operação Aurora, quando hackers patrocinados
Código de IA gasta 12,15 milhões de yuans, ultrapassando o orçamento em 860%: incidente interno na Amazon soa o alarme sobre os custos corporativos com IA
A mídia norte-americana noticiou recentemente um significativo estouro nos custos com IA na Amazon, onde o uso, por parte de um engenheiro, do modelo Claude Sonnet, da Anthropic, para cruzar dados de
Recomendações de tópicos especiais relacionados
Design e Arte
 As melhores ferramentas de ilustração com IA: crie cenas editoriais e capas de forma mais rápida
As melhores ferramentas de ilustração com IA de 2026: nossa lista selecionada apresenta as melhores ferramentas, com design robusto, para criar rapidamente cenas editoriais impressionantes e capas atraentes. Cada opção passou por rigorosos testes práticos, oferecendo uma comparação entre versões gratuitas e pagas para ajudar você a encontrar a opção perfeita para o seu fluxo de trabalho. Experimente hoje mesmo essas soluções imperdíveis para aproveitar ao máximo as vantagens da IA e impulsionar sua produtividade criativa. Explore agora no XIX.AI.
 10 ferramentas
 xix.ai
Educação e Aprendizagem
Os melhores professores particulares especializados em IA para preparação para exames: pratique matemática, ciências e inglês
Os melhores tutores de IA para preparação para exames de 2026, com as melhores avaliações, estão aqui no XIX.AI! Nossa lista cuidadosamente selecionada apresenta ferramentas poderosas e revolucionárias que oferecem comparação entre versões gratuitas e pagas, testes práticos e rankings atualizados semanalmente. Elas ajudam a aumentar sua eficiência na redação, simplificar o aprendizado de tópicos complexos e liberar seu potencial acadêmico. Explore agora para descobrir sua ferramenta perfeita de preparação para exames e comece a criar hoje mesmo para aproveitar toda a vantagem da IA!
10 ferramentas
xix.ai
Financiar
Ferramentas de planejamento orçamentário com IA para gestão financeira pessoal
As melhores e mais bem avaliadas ferramentas de planejamento orçamentário com IA para gestão financeira pessoal de 2026 estão aqui no XIX.AI! Esta seleção especial apresenta soluções poderosas e revolucionárias que ajudam você a realizar testes na prática, entender hábitos de consumo e criar planos personalizados para aumentar a produtividade. Confira uma comparação entre versões gratuitas e pagas, além de rankings detalhados. Ferramentas imperdíveis, projetadas para simplificar a gestão financeira e explorar o potencial da IA. Explore agora!
11 ferramentas
xix.ai
Saúde e Bem-Estar
Assistentes de rastreamento do sono com IA: melhore sua recuperação adotando hábitos mais adequados antes de dormir
2026 – Os melhores assistentes de rastreamento do sono com inteligência artificial mais bem avaliados, selecionados para proporcionar uma recuperação máxima. Este guia semanal completamente atualizado apresenta ferramentas poderosas que incluem testes reais, comparações entre versões gratuitas e pagas, além de classificações detalhadas, visando ajudá-lo a encontrar a solução ideal para melhorar a qualidade do sono e fomentar hábitos noturnos mais saudáveis. Explore agora em XIX.AI e aproveite todas as vantagens oferecidas pela inteligência artificial.
10 ferramentas
xix.ai
Análise de dados
Copilotos de IA em SQL para análise de produtos e receitas
2026: Os melhores e mais bem avaliados copilotos de IA para SQL em análise de produtos e receitas! A XIX.AI selecionou um conjunto poderoso e revolucionário de ferramentas imperdíveis, que passam por testes práticos por meio de rankings atualizados semanalmente. Essas ferramentas ajudam os usuários a aumentar significativamente a produtividade, acelerando a análise de dados, simplificando consultas complexas e gerando insights precisos para impulsionar decisões de negócios mais inteligentes. Explore agora e descubra a ferramenta perfeita para aproveitar ao máximo o potencial da IA!
14 ferramentas
xix.ai
Educação e Aprendizagem
Os melhores auxiliares de tarefas escolares com IA que ensinam: aprenda conceitos, não apenas respostas
2026: Os melhores e mais bem avaliados auxiliares de tarefas com IA que ensinam conceitos fundamentais, não apenas respostas. Ferramentas poderosas para estudantes. Lista selecionada que você não pode deixar de conferir. Atualizada semanalmente. Comparação entre versões gratuitas e pagas. Testes em situações reais. Rankings precisos para ajudar você a atingir todo o seu potencial de aprendizado. Explore agora e descubra a ferramenta perfeita para estudar de forma mais inteligente.
10 ferramentas
xix.ai

 Comentários (0)
Apesar do crescente poder dos LLMs, as alucinações continuam sendo um desafio persistente. Mesmo os modelos mais avançados geram erros, e embora existam métodos para detectá-los, o setor ainda está aperfeiçoando a melhor abordagem.
A Probably, que recentemente obteve 9 milhões de dólares em financiamento inicial da Andreessen Horowitz, tem como objetivo desenvolver um método mais robusto para detecção de erros.
O fundador Peter Elias (na foto acima) explica que a missão da empresa é impedir que alucinações e erros factuais cheguem aos usuários, visando uma precisão de 99,99%, típica dos sistemas determinísticos — um nível muito mais difícil de alcançar com inteligência artificial. Para conseguir isso com LLMs, ele ressalta que é preciso repensar as premissas fundamentais da engenharia de IA.
O produto inicial da Probably é uma ferramenta de ciência de dados projetada para gerar respostas rápidas a partir de conjuntos de dados complexos. Cada resultado inclui uma citação e um rastro de auditoria de sua derivação, prática que está se tornando padrão em ferramentas de IA.
Para evitar que erros cheguem a esses resumos, a empresa criou um sistema elaborado que Elias chama de “traje mecânico de ciência de dados”. As respostas iniciais do LLM são validadas por um sistema determinístico, que rejeita quaisquer resultados inconsistentes com o conjunto de dados. O LLM foi treinado para funcionar em conjunto com esse validador, e todo o sistema é otimizado para velocidade e precisão, segundo a empresa.
“O que aprendemos é que, quanto mais robusto for o seu sistema de suporte, menor precisa ser o poder do modelo”, afirma Elias. “Se você aperfeiçoar suficientemente o contexto, o modelo não precisará se esforçar para produzir resultados corretos. Essencialmente, trata-se de reduzir a ambiguidade.”
Isso permite que a ferramenta de ciência de dados da Probably opere com modelos de IA muito menores. Elias observa que a versão atual utiliza um modelo “quatro categorias mais fraco do que os modelos de ponta”, o que lhe permite rodar em hardware local — um computador desktop, e não em um data center — reduzindo significativamente os custos associados ao uso da IA.
Essa abordagem é oportuna, já que os custos dos tokens estão aumentando e muitos clientes estão reavaliando seus orçamentos para IA. A visão de Elias vai além da ciência de dados; o mesmo mecanismo pode ser adaptado para casos de uso como contabilidade ou serviços médicos — em suas palavras, “qualquer cenário sensível à precisão”.
“É surpreendente que os principais laboratórios de IA ainda nem tenham tentado essa abordagem”, diz Elias. “Eles têm incentivos contrários, pois lucram com a necessidade de correções repetidas.”








 O TechCrunch Disrupt 2026 chega ao fim
Chegou o último dia do TechCrunch Disrupt 2026, encerrando uma semana intensa. Com mais de 10.000 fundadores, investidores e líderes do setor de tecnologia reunidos no Moscone West, em São Francisco,
 A QueryStory recomenda cautela em relação ao conteúdo gerado por IA
Em 2009, Shapor Naghibzadeh descobriu o poder de uma narrativa envolvente enquanto trabalhava como engenheiro de operações de sistemas no Google. Durante a Operação Aurora, quando hackers patrocinados
 Código de IA gasta 12,15 milhões de yuans, ultrapassando o orçamento em 860%: incidente interno na Amazon soa o alarme sobre os custos corporativos com IA
A mídia norte-americana noticiou recentemente um significativo estouro nos custos com IA na Amazon, onde o uso, por parte de um engenheiro, do modelo Claude Sonnet, da Anthropic, para cruzar dados de

As melhores ferramentas de ilustração com IA de 2026: nossa lista selecionada apresenta as melhores ferramentas, com design robusto, para criar rapidamente cenas editoriais impressionantes e capas atraentes. Cada opção passou por rigorosos testes práticos, oferecendo uma comparação entre versões gratuitas e pagas para ajudar você a encontrar a opção perfeita para o seu fluxo de trabalho. Experimente hoje mesmo essas soluções imperdíveis para aproveitar ao máximo as vantagens da IA e impulsionar sua produtividade criativa. Explore agora no XIX.AI.
10 ferramentas
xix.ai

Os melhores tutores de IA para preparação para exames de 2026, com as melhores avaliações, estão aqui no XIX.AI! Nossa lista cuidadosamente selecionada apresenta ferramentas poderosas e revolucionárias que oferecem comparação entre versões gratuitas e pagas, testes práticos e rankings atualizados semanalmente. Elas ajudam a aumentar sua eficiência na redação, simplificar o aprendizado de tópicos complexos e liberar seu potencial acadêmico. Explore agora para descobrir sua ferramenta perfeita de preparação para exames e comece a criar hoje mesmo para aproveitar toda a vantagem da IA!
10 ferramentas
xix.ai

As melhores e mais bem avaliadas ferramentas de planejamento orçamentário com IA para gestão financeira pessoal de 2026 estão aqui no XIX.AI! Esta seleção especial apresenta soluções poderosas e revolucionárias que ajudam você a realizar testes na prática, entender hábitos de consumo e criar planos personalizados para aumentar a produtividade. Confira uma comparação entre versões gratuitas e pagas, além de rankings detalhados. Ferramentas imperdíveis, projetadas para simplificar a gestão financeira e explorar o potencial da IA. Explore agora!
11 ferramentas
xix.ai

2026 – Os melhores assistentes de rastreamento do sono com inteligência artificial mais bem avaliados, selecionados para proporcionar uma recuperação máxima. Este guia semanal completamente atualizado apresenta ferramentas poderosas que incluem testes reais, comparações entre versões gratuitas e pagas, além de classificações detalhadas, visando ajudá-lo a encontrar a solução ideal para melhorar a qualidade do sono e fomentar hábitos noturnos mais saudáveis. Explore agora em XIX.AI e aproveite todas as vantagens oferecidas pela inteligência artificial.
10 ferramentas
xix.ai

2026: Os melhores e mais bem avaliados copilotos de IA para SQL em análise de produtos e receitas! A XIX.AI selecionou um conjunto poderoso e revolucionário de ferramentas imperdíveis, que passam por testes práticos por meio de rankings atualizados semanalmente. Essas ferramentas ajudam os usuários a aumentar significativamente a produtividade, acelerando a análise de dados, simplificando consultas complexas e gerando insights precisos para impulsionar decisões de negócios mais inteligentes. Explore agora e descubra a ferramenta perfeita para aproveitar ao máximo o potencial da IA!
14 ferramentas
xix.ai

2026: Os melhores e mais bem avaliados auxiliares de tarefas com IA que ensinam conceitos fundamentais, não apenas respostas. Ferramentas poderosas para estudantes. Lista selecionada que você não pode deixar de conferir. Atualizada semanalmente. Comparação entre versões gratuitas e pagas. Testes em situações reais. Rankings precisos para ajudar você a atingir todo o seu potencial de aprendizado. Explore agora e descubra a ferramenta perfeita para estudar de forma mais inteligente.
10 ferramentas
xix.ai












