


 Дом
Google использует архивы новостей и искусственный интеллект для прогнозирования внезапных наводнений
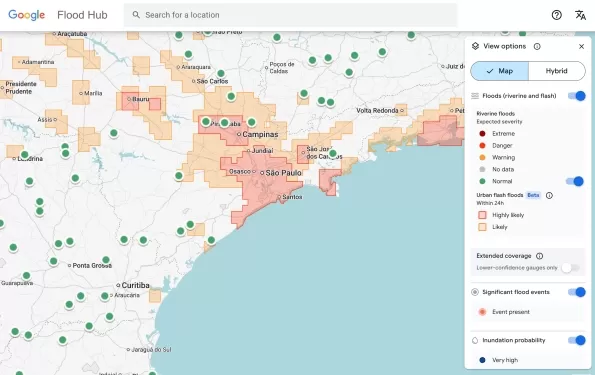
Мгновенные наводнения относятся к числу самых смертоносных погодных явлений на планете, унося ежегодно более 5 000 жизней. Кроме того, их прогнозирование славится своей сложностью. Однако в Google считают, что нашли новое решение этой проблемы: анализ новостных сообщений.
Хотя человечество накопило огромные объемы метеорологических данных, внезапные наводнения слишком кратковременны и локальны, чтобы их можно было систематически измерять, в отличие от температурных показателей или тенденций речного стока, которые отслеживаются в течение длительного времени. Этот дефицит данных мешает моделям глубокого обучения, даже несмотря на то, что они становятся все более опытными в общем прогнозировании погоды, точно предсказывать внезапные наводнения.
Чтобы преодолеть этот разрыв, исследователи Google использовали Gemini — крупную языковую модель компании — для просмотра 5 миллионов новостных статей со всего мира. В ходе этого процесса были выявлены сообщения о 2,6 миллионах отдельных случаев наводнений, которые были преобразованы в временную шкалу с геотегами под названием «Groundsource». По словам Гилы Лойк, менеджера по продуктам Google Research, это первый случай использования компанией языковых моделей для таких целей. Результаты исследования и набор данных были обнародованы в четверг утром.
Используя Groundsource в качестве реального эталона, команда обучила модель на основе нейронной сети с длинной краткосрочной памятью (LSTM). Эта модель обрабатывает глобальные прогнозы погоды для генерации оценок вероятности внезапных наводнений в конкретных местах.
Модель Google для прогнозирования ливневых паводков теперь определяет риски для городских районов в 150 странах на платформе Flood Hub и передает эти данные аварийным службам по всему миру. Антонио Жозе Белеза, сотрудник службы экстренного реагирования Южноафриканского сообщества по развитию, участвовавший в испытании модели, заявил, что она значительно повысила скорость реагирования его организации на паводки.
У модели есть и текущие ограничения. Ее разрешение относительно широкое: риск оценивается в зонах площадью 20 квадратных километров. Она также менее точна, чем такие системы, как оповещения о наводнениях Национальной метеорологической службы США, отчасти потому, что не интегрирует данные местных радаров для отслеживания осадков в реальном времени.
Однако одной из ключевых целей проекта было создание решения для регионов, где у местных органов власти нет ресурсов на дорогостоящую инфраструктуру для мониторинга погоды или подробные исторические метеорологические записи.
«Благодаря агрегированию миллионов сообщений набор данных Groundsource помогает сбалансировать глобальную карту», — пояснила Джульет Ротенберг, руководитель программы в команде Google по обеспечению устойчивости. «Это позволяет нам экстраполировать выводы на другие регионы, где доступно гораздо меньше информации».
Ротенберг добавила, что команда надеется, что эта методология — использование LLM для создания количественных наборов данных на основе качественных письменных источников — может быть применена к другим кратковременным, но критически важным задачам прогнозирования, таким как тепловые волны и оползни.
Маршалл Мутено, генеральный директор Upstream Tech — компании, использующей аналогичное глубокое обучение для прогнозирования речного стока для таких клиентов, как гидроэнергетические компании, — рассматривает работу Google как часть более широких усилий по сбору данных для моделей погоды на основе ИИ. Мутено также является соучредителем dynamical.org — группы, занимающейся кураторством данных о погоде, готовых для машинного обучения, для исследователей и стартапов.
«Нехватка данных остается одним из самых серьезных препятствий в геофизике», — отметил Мутено. «Парадоксально, но существует переизбыток данных о Земле, но при этом не хватает проверенных наземных данных для оценки. Это был очень креативный подход к получению этих важных данных».
Связанная статья
 Генеральный директор DeepMind Хассабис: я сплю шесть часов в день, обычно чувствую прилив энергии около часа ночи.
В недавнем интервью журналу Fortune генеральный директор Google DeepMind Демис Хаассабис раскрыл свой нестандартный подход к отдыху и продуктивности. Хаассабис признался, что спит очень мало, распределяя свои бодрствующие часы на два отдельных рабочи
OpenAI и Anthropic борются за долю рынка, несмотря на снижение выручки
Несмотря на недавние сообщения о том, что OpenAI не достигла целевых показателей по выручке, что во вторник оказало давление на акции технологических компаний, частные инвесторы, вкладывающие средства
Соблюдение требований к автономным транспортным средствам в Калифорнии: новая эра штрафов, геозоны и 1 млн миль
Компания Guident эксплуатирует шаттл AuveTech в Южной Флориде, обслуживая маршрут протяженностью четыре мили в Вест-Палм-Бич и маршрут протяженностью одну милю в Бока-Ратоне с использованием своей тех
Рекомендации по связанным специальным темам
письмо
 Инструменты для создания плана статей с использованием ИИ при написании длинных текстов
2026: лучшие и самые популярные инструменты для создания планов статей с помощью ИИ для написания длинных текстов! В эту тщательно подобранную подборку вошли мощные, революционные инструменты, которые генерируют точные и структурированные планы, прошедшие проверку на практике, что позволяет значительно повысить эффективность написания текстов. XIX.AI входит в эту элитную подборку. Получите сравнение бесплатных и платных версий, чтобы выбрать идеальный инструмент. Изучите их прямо сейчас и раскройте свой потенциал с помощью ИИ!
 9 инструментов
 xix.ai
чат-бот
Лучшие приложения для ролевых чатов с ИИ для практики языка, подготовки к собеседованиям и ежедневной разговорной практики
2026 г. — новейшие, лучшие и наиболее рейтинговые приложения для ИИ-ролевых чатов, предназначенные для практики языка, подготовки к собеседованиям и ежедневной беглости речи! XIX.AI предлагает мощную коллекцию, меняющую правила игры: бесплатные и платные варианты, реальные тесты и обновляемые еженедельно рейтинги. Эти обязательные к использованию инструменты помогут вам улучшить навыки письма, преодолеть трудности с беглостью и повысить эффективность общения во всех повседневных ситуациях. Исследуйте сейчас, чтобы найти идеальный инструмент для развития вашего языка!
10 инструментов
xix.ai
Музыкальная композиция
Инструменты разделения стемов с использованием ИИ для создания ремиксов, подготовки образцов звука и формирования финальных версий караоке.
2026 год: лучшие и наиболее высоко оценённые инструменты для разделения аудиосигналов с использованием ИИ, отобранные специально для работы над ремиксами, подготовки образцов звука и создания караоке-версий. Эти мощные революционные инструменты проходят реальные тесты, обеспечивая точную изоляцию аудиосигналов и значительно повышая производительность. XIX.AI предоставляет еженедельно обновляемый бесплатный справочник сравнения платных и бесплатных решений, который поможет вам найти оптимальный вариант, соответствующий вашим потребностям. Ознакомьтесь с ним прямо сейчас, чтобы раскрыть потенциал ИИ в вашей работе.
8 инструментов
xix.ai
Анализ данных
ИИ-копилоты для SQL, предназначенные для создания панелей управления доходами, анализа воронки продаж и отслеживания показателей продуктов.
2026 год: лучшие AI-ассистенты для SQL, занявшие верхние строчки рейтингов! XIX.AI собрал мощный набор инструментов, регулярно обновляемый на основе реальных тестов. Эти неотъемлемые инструменты помогают создавать точные дашборды с данными о доходах, анализировать каналы продаж и оперативно отслеживать показатели продуктов, значительно повышая производительность. Ознакомьтесь сейчас, чтобы найти идеальный инструмент для принятия решений на основе данных! 238 символов
9 инструментов
xix.ai
Музыкальная композиция
Лучшие инструменты для написания мелодий с помощью ИИ для черновиков песен
2026 год: лучшие, топовые и высокооценённые инструменты ИИ для написания мелодий для черновиков песен! XIX.AI подобрал высокоэффективную коллекцию, меняющую правила игры, которая прошла строгие реальные испытания, чтобы обеспечить лучший опыт написания. Вы можете найти подробные сравнения бесплатных и платных версий, точные рейтинги и обязательные к использованию варианты, разработанные, чтобы помочь вам создавать потрясающие черновики песен без усилий и значительно повысить вашу творческую продуктивность. Исследуйте сейчас, чтобы найти свой идеальный инструмент!
8 инструментов
xix.ai
чат-бот
Лучшие инструменты для тренировки разговоров с помощью ИИ для подготовки к собеседованиям
2026 г. — новейшие, лучшие и наиболее высоко оцененные инструменты для тренировки разговорных навыков с помощью ИИ для подготовки к собеседованиям уже доступны на XIX.AI! Эта тщательно отобранная подборка включает мощные, революционные инструменты, прошедшие строгие реальные испытания и обеспечивающие точную обратную связь. Вы найдете сравнение бесплатных и платных вариантов, а также подробные рейтинги, которые помогут вам выбрать наиболее подходящий инструмент, повышающий вашу уверенность и навыки. Исследуйте сейчас, чтобы найти идеальный инструмент для успешного прохождения собеседований!
12 инструментов
xix.ai

 Комментарии (2)
![JosephScott]()
So Google's basically using old news articles to predict floods? That's wild. I mean, if it works, it could save thousands of lives, but I wonder how much historical data is actually reliable when weather patterns are changing so fast. 🌊🤔
![RalphJohnson]()
ニュース記事をAIで分析して洪水を予測するなんて、Googleらしい発想だね。でも、データの偏りやプライバシーは大丈夫?特に途上国のニュース網が不十分な地域では、精度に影響が出そう。それに、この技術が有料サービス化されたら、災害予測にお金がかかる世の中になるのかな…ちょっと怖いかも😅
Мгновенные наводнения относятся к числу самых смертоносных погодных явлений на планете, унося ежегодно более 5 000 жизней. Кроме того, их прогнозирование славится своей сложностью. Однако в Google считают, что нашли новое решение этой проблемы: анализ новостных сообщений.
Хотя человечество накопило огромные объемы метеорологических данных, внезапные наводнения слишком кратковременны и локальны, чтобы их можно было систематически измерять, в отличие от температурных показателей или тенденций речного стока, которые отслеживаются в течение длительного времени. Этот дефицит данных мешает моделям глубокого обучения, даже несмотря на то, что они становятся все более опытными в общем прогнозировании погоды, точно предсказывать внезапные наводнения.
Чтобы преодолеть этот разрыв, исследователи Google использовали Gemini — крупную языковую модель компании — для просмотра 5 миллионов новостных статей со всего мира. В ходе этого процесса были выявлены сообщения о 2,6 миллионах отдельных случаев наводнений, которые были преобразованы в временную шкалу с геотегами под названием «Groundsource». По словам Гилы Лойк, менеджера по продуктам Google Research, это первый случай использования компанией языковых моделей для таких целей. Результаты исследования и набор данных были обнародованы в четверг утром.
Используя Groundsource в качестве реального эталона, команда обучила модель на основе нейронной сети с длинной краткосрочной памятью (LSTM). Эта модель обрабатывает глобальные прогнозы погоды для генерации оценок вероятности внезапных наводнений в конкретных местах.
Модель Google для прогнозирования ливневых паводков теперь определяет риски для городских районов в 150 странах на платформе Flood Hub и передает эти данные аварийным службам по всему миру. Антонио Жозе Белеза, сотрудник службы экстренного реагирования Южноафриканского сообщества по развитию, участвовавший в испытании модели, заявил, что она значительно повысила скорость реагирования его организации на паводки.
У модели есть и текущие ограничения. Ее разрешение относительно широкое: риск оценивается в зонах площадью 20 квадратных километров. Она также менее точна, чем такие системы, как оповещения о наводнениях Национальной метеорологической службы США, отчасти потому, что не интегрирует данные местных радаров для отслеживания осадков в реальном времени.
Однако одной из ключевых целей проекта было создание решения для регионов, где у местных органов власти нет ресурсов на дорогостоящую инфраструктуру для мониторинга погоды или подробные исторические метеорологические записи.
«Благодаря агрегированию миллионов сообщений набор данных Groundsource помогает сбалансировать глобальную карту», — пояснила Джульет Ротенберг, руководитель программы в команде Google по обеспечению устойчивости. «Это позволяет нам экстраполировать выводы на другие регионы, где доступно гораздо меньше информации».
Ротенберг добавила, что команда надеется, что эта методология — использование LLM для создания количественных наборов данных на основе качественных письменных источников — может быть применена к другим кратковременным, но критически важным задачам прогнозирования, таким как тепловые волны и оползни.
Маршалл Мутено, генеральный директор Upstream Tech — компании, использующей аналогичное глубокое обучение для прогнозирования речного стока для таких клиентов, как гидроэнергетические компании, — рассматривает работу Google как часть более широких усилий по сбору данных для моделей погоды на основе ИИ. Мутено также является соучредителем dynamical.org — группы, занимающейся кураторством данных о погоде, готовых для машинного обучения, для исследователей и стартапов.
«Нехватка данных остается одним из самых серьезных препятствий в геофизике», — отметил Мутено. «Парадоксально, но существует переизбыток данных о Земле, но при этом не хватает проверенных наземных данных для оценки. Это был очень креативный подход к получению этих важных данных».








 Генеральный директор DeepMind Хассабис: я сплю шесть часов в день, обычно чувствую прилив энергии около часа ночи.
В недавнем интервью журналу Fortune генеральный директор Google DeepMind Демис Хаассабис раскрыл свой нестандартный подход к отдыху и продуктивности. Хаассабис признался, что спит очень мало, распределяя свои бодрствующие часы на два отдельных рабочи
 OpenAI и Anthropic борются за долю рынка, несмотря на снижение выручки
Несмотря на недавние сообщения о том, что OpenAI не достигла целевых показателей по выручке, что во вторник оказало давление на акции технологических компаний, частные инвесторы, вкладывающие средства
Соблюдение требований к автономным транспортным средствам в Калифорнии: новая эра штрафов, геозоны и 1 млн миль
Компания Guident эксплуатирует шаттл AuveTech в Южной Флориде, обслуживая маршрут протяженностью четыре мили в Вест-Палм-Бич и маршрут протяженностью одну милю в Бока-Ратоне с использованием своей тех

2026: лучшие и самые популярные инструменты для создания планов статей с помощью ИИ для написания длинных текстов! В эту тщательно подобранную подборку вошли мощные, революционные инструменты, которые генерируют точные и структурированные планы, прошедшие проверку на практике, что позволяет значительно повысить эффективность написания текстов. XIX.AI входит в эту элитную подборку. Получите сравнение бесплатных и платных версий, чтобы выбрать идеальный инструмент. Изучите их прямо сейчас и раскройте свой потенциал с помощью ИИ!
9 инструментов
xix.ai

2026 г. — новейшие, лучшие и наиболее рейтинговые приложения для ИИ-ролевых чатов, предназначенные для практики языка, подготовки к собеседованиям и ежедневной беглости речи! XIX.AI предлагает мощную коллекцию, меняющую правила игры: бесплатные и платные варианты, реальные тесты и обновляемые еженедельно рейтинги. Эти обязательные к использованию инструменты помогут вам улучшить навыки письма, преодолеть трудности с беглостью и повысить эффективность общения во всех повседневных ситуациях. Исследуйте сейчас, чтобы найти идеальный инструмент для развития вашего языка!
10 инструментов
xix.ai

2026 год: лучшие и наиболее высоко оценённые инструменты для разделения аудиосигналов с использованием ИИ, отобранные специально для работы над ремиксами, подготовки образцов звука и создания караоке-версий. Эти мощные революционные инструменты проходят реальные тесты, обеспечивая точную изоляцию аудиосигналов и значительно повышая производительность. XIX.AI предоставляет еженедельно обновляемый бесплатный справочник сравнения платных и бесплатных решений, который поможет вам найти оптимальный вариант, соответствующий вашим потребностям. Ознакомьтесь с ним прямо сейчас, чтобы раскрыть потенциал ИИ в вашей работе.
8 инструментов
xix.ai

2026 год: лучшие AI-ассистенты для SQL, занявшие верхние строчки рейтингов! XIX.AI собрал мощный набор инструментов, регулярно обновляемый на основе реальных тестов. Эти неотъемлемые инструменты помогают создавать точные дашборды с данными о доходах, анализировать каналы продаж и оперативно отслеживать показатели продуктов, значительно повышая производительность. Ознакомьтесь сейчас, чтобы найти идеальный инструмент для принятия решений на основе данных! 238 символов
9 инструментов
xix.ai

2026 год: лучшие, топовые и высокооценённые инструменты ИИ для написания мелодий для черновиков песен! XIX.AI подобрал высокоэффективную коллекцию, меняющую правила игры, которая прошла строгие реальные испытания, чтобы обеспечить лучший опыт написания. Вы можете найти подробные сравнения бесплатных и платных версий, точные рейтинги и обязательные к использованию варианты, разработанные, чтобы помочь вам создавать потрясающие черновики песен без усилий и значительно повысить вашу творческую продуктивность. Исследуйте сейчас, чтобы найти свой идеальный инструмент!
8 инструментов
xix.ai

2026 г. — новейшие, лучшие и наиболее высоко оцененные инструменты для тренировки разговорных навыков с помощью ИИ для подготовки к собеседованиям уже доступны на XIX.AI! Эта тщательно отобранная подборка включает мощные, революционные инструменты, прошедшие строгие реальные испытания и обеспечивающие точную обратную связь. Вы найдете сравнение бесплатных и платных вариантов, а также подробные рейтинги, которые помогут вам выбрать наиболее подходящий инструмент, повышающий вашу уверенность и навыки. Исследуйте сейчас, чтобы найти идеальный инструмент для успешного прохождения собеседований!
12 инструментов
xix.ai

So Google's basically using old news articles to predict floods? That's wild. I mean, if it works, it could save thousands of lives, but I wonder how much historical data is actually reliable when weather patterns are changing so fast. 🌊🤔
ニュース記事をAIで分析して洪水を予測するなんて、Googleらしい発想だね。でも、データの偏りやプライバシーは大丈夫?特に途上国のニュース網が不十分な地域では、精度に影響が出そう。それに、この技術が有料サービス化されたら、災害予測にお金がかかる世の中になるのかな…ちょっと怖いかも😅












