


 Maison
Google exploite les données historiques relatives à l'actualité et l'intelligence artificielle pour prévoir les crues soudaines
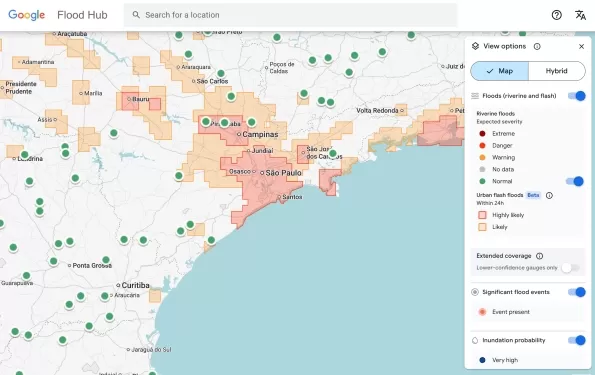
Les crues soudaines comptent parmi les phénomènes météorologiques les plus meurtriers de la planète, faisant plus de 5 000 victimes chaque année. Elles sont également réputées pour être particulièrement difficiles à prévoir. Google estime toutefois avoir trouvé une solution novatrice à ce problème : l'analyse des dépêches d'actualité.
Bien que l'humanité ait accumulé de vastes quantités de données météorologiques, les crues soudaines sont trop brèves et trop localisées pour être mesurées de manière systématique, contrairement aux tendances de température ou de débit fluvial suivies au fil du temps. Ce manque de données empêche les modèles d'apprentissage profond, même s'ils deviennent de plus en plus performants en matière de prévisions météorologiques générales, de prévoir avec précision les crues soudaines.
Pour combler cette lacune, les chercheurs de Google ont utilisé Gemini — le grand modèle linguistique de l'entreprise — pour passer au crible 5 millions d'articles d'actualité mondiaux. Ce processus a permis d'identifier des reportages sur 2,6 millions d'événements d'inondation distincts, les convertissant en une chronologie géolocalisée baptisée « Groundsource ». Selon Gila Loike, chef de produit chez Google Research, il s'agit de la première utilisation par l'entreprise de modèles linguistiques à cette fin. Les résultats de la recherche et l'ensemble de données ont été rendus publics jeudi matin.
En utilisant Groundsource comme référence dans le monde réel, l'équipe a entraîné un modèle basé sur un réseau neuronal à mémoire à court et long terme (LSTM). Ce modèle traite les prévisions météorologiques mondiales pour générer des estimations de probabilité de crues soudaines dans des lieux spécifiques.
Le modèle de prévision des crues soudaines de Google identifie désormais les risques pour les zones urbaines dans 150 pays sur sa plateforme Flood Hub et partage ces données avec les agences d'intervention d'urgence du monde entier. António José Beleza, responsable des interventions d'urgence au sein de la Communauté de développement de l'Afrique australe (SADC) qui a participé à un essai du modèle, a déclaré que celui-ci avait considérablement amélioré la rapidité de réaction de son organisation face aux inondations.
Le modèle présente toutefois des limites actuelles. Sa résolution est relativement large, évaluant les risques sur des zones de 20 kilomètres carrés. Il est également moins précis que des systèmes tels que les alertes d'inondation du Service météorologique national américain, en partie parce qu'il n'intègre pas les données radar locales pour le suivi en temps réel des précipitations.
L'un des principaux objectifs du projet était toutefois de créer une solution pour les régions où les autorités locales ne disposent pas des ressources nécessaires pour mettre en place des infrastructures coûteuses de surveillance météorologique ou pour établir des archives météorologiques historiques détaillées.
« En agrégant des millions de rapports, l'ensemble de données Groundsource contribue à rééquilibrer la carte mondiale », a expliqué Juliet Rothenberg, responsable de programme au sein de l'équipe Resilience de Google. « Il nous permet d'extrapoler des informations à d'autres régions disposant de bien moins de données. »
Mme Rothenberg a ajouté que l'équipe espère que cette méthodologie — qui utilise des modèles de langage (LLM) pour créer des ensembles de données quantitatives à partir de sources écrites qualitatives — pourra être appliquée à d'autres défis de prévision éphémères mais critiques, tels que les vagues de chaleur et les coulées de boue.
Marshall Moutenot, PDG d’Upstream Tech, une entreprise utilisant un apprentissage profond similaire pour les prévisions de débit fluvial pour des clients tels que des sociétés hydroélectriques, considère le travail de Google comme s’inscrivant dans une initiative plus large visant à compiler des données pour des modèles météorologiques basés sur l’IA. M. Moutenot a également cofondé dynamical.org, un groupe qui sélectionne des données météorologiques prêtes pour l’apprentissage automatique à l’intention des chercheurs et des start-ups.
« La rareté des données reste l’un des obstacles les plus difficiles à surmonter en géophysique », a noté M. Moutenot. « Paradoxalement, il existe une surabondance de données sur la Terre, mais un manque de données de référence validées pour l’évaluation. Il s’agissait là d’une approche très créative pour acquérir ces données essentielles. »
Article connexe
 Lovable Leads Atech's Seed Round as AI Ambient Coding Officially Enters the Hardware Field
Le 14 mai 2026, la plateforme de développement d’applications d’IA Lovable a annoncé sa participation à une levée de fonds amorce de 800 000 $ pour la startup danoise de matériel Atech. Pilotée par Lovable, cette levée de fonds a attiré des sociétés
Anthropic étend ses outils de codage IA Claude au Japon dans le cadre de sa stratégie de croissance à l’étranger
Anthropic, une entreprise américaine d’intelligence artificielle de premier plan, intensifie sa portée mondiale. Mercredi, l’entreprise a organisé une grande réunion de développeurs, « Code with Claude », à Tokyo, rassemblant près de 500 ingénieurs l
Le géant indien du logiciel réduit ses embauches et promet des licenciements nuls à mesure que les agents IA se développent
Alors que l’intelligence artificielle redéfinit les modèles d’affaires traditionnellement intensifs en main-d’œuvre, Tata Consultancy Services (TCS), l’un des principaux prestataires indiens de sous-traitance logicielle, a dévoilé sa réponse stratégi
Recommandations de sujets spéciaux liés
Conception et art
 Les meilleurs outils de transfert de style basés sur l'IA pour des expériences créatives
Les meilleurs outils de transfert de style par IA de 2026, les mieux notés, pour des expériences créatives ! XIX.AI a sélectionné une collection d’outils puissants et révolutionnaires à essayer absolument, qui offrent des résultats exceptionnels grâce à des tests en conditions réelles et à un classement rigoureux. Ces solutions de pointe aident les créatifs à booster considérablement leur productivité en accélérant la création de contenu et en ouvrant la voie à des possibilités créatives infinies. Découvrez-les dès maintenant pour trouver l'outil qui vous convient le mieux et commencez à créer dès aujourd'hui !
 9 outils
 xix.ai
Création de bande dessinée
Les meilleurs outils d'IA pour créer des bulles de dialogue destinés à la narration visuelle
Les meilleurs outils de 2026 pour la création de bulles de dialogue IA, les mieux notés pour la narration visuelle, sont disponibles ici sur XIX.AI ! Cette sélection regroupe des outils puissants et révolutionnaires qui aident les créateurs à booster leur productivité et à surmonter les blocages créatifs. Consultez un comparatif entre les versions gratuites et payantes, découvrez des tests en conditions réelles et consultez les derniers classements pour trouver les solutions incontournables, parfaites pour créer des récits visuels captivants. Explorez dès maintenant pour découvrir l'outil qui vous convient le mieux !
10 outils
xix.ai
Assistante de réunion
Les meilleurs outils de synthèse de réunions basés sur l'IA : suivez clairement les décisions et les actions à mener
2026 : les meilleurs outils d'IA pour la synthèse de réunions, les mieux notés, pour un suivi clair des décisions et des relances sans effort. Cette sélection présente des solutions puissantes et révolutionnaires qui boostent considérablement la productivité en automatisant la prise de notes lors des réunions, en identifiant les actions clés et en rationalisant la coordination des équipes sur l'ensemble des projets. Profitez d'une comparaison entre les versions gratuites et payantes, ainsi que de tests en conditions réelles et de classements mis à jour chaque semaine pour vous aider à trouver l'outil idéal. Découvrez-les dès maintenant pour tirer pleinement parti de l'IA !
9 outils
xix.ai
Analyse des données
Meilleurs outils de nettoyage de données IA : corrigez rapidement les valeurs manquantes et les doublons
2026 : Les meilleures outils de nettoyage de données IA les plus récents et hautement notés pour corriger rapidement les valeurs manquantes et les doublons. Cette liste rigoureusement sélectionnée met en avant des solutions puissantes capables d’améliorer considérablement la productivité. Chaque outil a été soumis à des tests approfondis dans des conditions réelles afin de garantir sa fiabilité. Obtenez une comparaison gratuite et payante pour découvrir l’outil qu’il vous faut le mieux, adapté à vos besoins. Explorez dès maintenant XIX.AI pour tirer parti au maximum des capacités de l’IA.
11 outils
xix.ai
Conception et art
Meilleurs outils d’idéation créative par IA pour les artistes : surmonter les blocages visuels
2026 Derniers Meilleurs Outils d’Idéation Créative par IA les Mieux Notés pour les Artistes sont sélectionnés par XIX.AI pour aider les créateurs à surmonner les blocages visuels et stimuler instantanément leur créativité. Ces outils puissants et révolutionnaires offrent des tests concrets, une comparaison détaillée entre les versions gratuites et payantes, ainsi que des classements mis à jour chaque semaine. Découvrez l’outil parfait pour accélérer la création de contenu et débloquer votre avantage IA dès aujourd’hui. Explorez maintenant !
14 outils
xix.ai
Composition musicale
Créateurs de musique par IA pour les pistes d'accompagnement TikTok, les fichiers audio Reels et la musique promotionnelle des créateurs
Les meilleurs générateurs de rythmes IA de 2026 pour les musiques de fond TikTok, les Reels et les morceaux promotionnels des créateurs ! XIX.AI a sélectionné une liste des outils les mieux notés, véritables révolutionnaires qui ont fait leurs preuves dans la pratique pour offrir une musique irréprochable, quel que soit votre besoin en matière de contenu. Vous y trouverez des comparaisons détaillées entre les versions gratuites et payantes, des classements mis à jour chaque semaine, ainsi que des options incontournables pour vous aider à stimuler votre créativité et votre productivité. Explorez-la dès maintenant pour découvrir l'outil qui vous convient le mieux !
11 outils
xix.ai

 commentaires (2)
![JosephScott]()
So Google's basically using old news articles to predict floods? That's wild. I mean, if it works, it could save thousands of lives, but I wonder how much historical data is actually reliable when weather patterns are changing so fast. 🌊🤔
![RalphJohnson]()
ニュース記事をAIで分析して洪水を予測するなんて、Googleらしい発想だね。でも、データの偏りやプライバシーは大丈夫?特に途上国のニュース網が不十分な地域では、精度に影響が出そう。それに、この技術が有料サービス化されたら、災害予測にお金がかかる世の中になるのかな…ちょっと怖いかも😅
Les crues soudaines comptent parmi les phénomènes météorologiques les plus meurtriers de la planète, faisant plus de 5 000 victimes chaque année. Elles sont également réputées pour être particulièrement difficiles à prévoir. Google estime toutefois avoir trouvé une solution novatrice à ce problème : l'analyse des dépêches d'actualité.
Bien que l'humanité ait accumulé de vastes quantités de données météorologiques, les crues soudaines sont trop brèves et trop localisées pour être mesurées de manière systématique, contrairement aux tendances de température ou de débit fluvial suivies au fil du temps. Ce manque de données empêche les modèles d'apprentissage profond, même s'ils deviennent de plus en plus performants en matière de prévisions météorologiques générales, de prévoir avec précision les crues soudaines.
Pour combler cette lacune, les chercheurs de Google ont utilisé Gemini — le grand modèle linguistique de l'entreprise — pour passer au crible 5 millions d'articles d'actualité mondiaux. Ce processus a permis d'identifier des reportages sur 2,6 millions d'événements d'inondation distincts, les convertissant en une chronologie géolocalisée baptisée « Groundsource ». Selon Gila Loike, chef de produit chez Google Research, il s'agit de la première utilisation par l'entreprise de modèles linguistiques à cette fin. Les résultats de la recherche et l'ensemble de données ont été rendus publics jeudi matin.
En utilisant Groundsource comme référence dans le monde réel, l'équipe a entraîné un modèle basé sur un réseau neuronal à mémoire à court et long terme (LSTM). Ce modèle traite les prévisions météorologiques mondiales pour générer des estimations de probabilité de crues soudaines dans des lieux spécifiques.
Le modèle de prévision des crues soudaines de Google identifie désormais les risques pour les zones urbaines dans 150 pays sur sa plateforme Flood Hub et partage ces données avec les agences d'intervention d'urgence du monde entier. António José Beleza, responsable des interventions d'urgence au sein de la Communauté de développement de l'Afrique australe (SADC) qui a participé à un essai du modèle, a déclaré que celui-ci avait considérablement amélioré la rapidité de réaction de son organisation face aux inondations.
Le modèle présente toutefois des limites actuelles. Sa résolution est relativement large, évaluant les risques sur des zones de 20 kilomètres carrés. Il est également moins précis que des systèmes tels que les alertes d'inondation du Service météorologique national américain, en partie parce qu'il n'intègre pas les données radar locales pour le suivi en temps réel des précipitations.
L'un des principaux objectifs du projet était toutefois de créer une solution pour les régions où les autorités locales ne disposent pas des ressources nécessaires pour mettre en place des infrastructures coûteuses de surveillance météorologique ou pour établir des archives météorologiques historiques détaillées.
« En agrégant des millions de rapports, l'ensemble de données Groundsource contribue à rééquilibrer la carte mondiale », a expliqué Juliet Rothenberg, responsable de programme au sein de l'équipe Resilience de Google. « Il nous permet d'extrapoler des informations à d'autres régions disposant de bien moins de données. »
Mme Rothenberg a ajouté que l'équipe espère que cette méthodologie — qui utilise des modèles de langage (LLM) pour créer des ensembles de données quantitatives à partir de sources écrites qualitatives — pourra être appliquée à d'autres défis de prévision éphémères mais critiques, tels que les vagues de chaleur et les coulées de boue.
Marshall Moutenot, PDG d’Upstream Tech, une entreprise utilisant un apprentissage profond similaire pour les prévisions de débit fluvial pour des clients tels que des sociétés hydroélectriques, considère le travail de Google comme s’inscrivant dans une initiative plus large visant à compiler des données pour des modèles météorologiques basés sur l’IA. M. Moutenot a également cofondé dynamical.org, un groupe qui sélectionne des données météorologiques prêtes pour l’apprentissage automatique à l’intention des chercheurs et des start-ups.
« La rareté des données reste l’un des obstacles les plus difficiles à surmonter en géophysique », a noté M. Moutenot. « Paradoxalement, il existe une surabondance de données sur la Terre, mais un manque de données de référence validées pour l’évaluation. Il s’agissait là d’une approche très créative pour acquérir ces données essentielles. »








 Lovable Leads Atech's Seed Round as AI Ambient Coding Officially Enters the Hardware Field
Le 14 mai 2026, la plateforme de développement d’applications d’IA Lovable a annoncé sa participation à une levée de fonds amorce de 800 000 $ pour la startup danoise de matériel Atech. Pilotée par Lovable, cette levée de fonds a attiré des sociétés
 Anthropic étend ses outils de codage IA Claude au Japon dans le cadre de sa stratégie de croissance à l’étranger
Anthropic, une entreprise américaine d’intelligence artificielle de premier plan, intensifie sa portée mondiale. Mercredi, l’entreprise a organisé une grande réunion de développeurs, « Code with Claude », à Tokyo, rassemblant près de 500 ingénieurs l
 Le géant indien du logiciel réduit ses embauches et promet des licenciements nuls à mesure que les agents IA se développent
Alors que l’intelligence artificielle redéfinit les modèles d’affaires traditionnellement intensifs en main-d’œuvre, Tata Consultancy Services (TCS), l’un des principaux prestataires indiens de sous-traitance logicielle, a dévoilé sa réponse stratégi

Les meilleurs outils de transfert de style par IA de 2026, les mieux notés, pour des expériences créatives ! XIX.AI a sélectionné une collection d’outils puissants et révolutionnaires à essayer absolument, qui offrent des résultats exceptionnels grâce à des tests en conditions réelles et à un classement rigoureux. Ces solutions de pointe aident les créatifs à booster considérablement leur productivité en accélérant la création de contenu et en ouvrant la voie à des possibilités créatives infinies. Découvrez-les dès maintenant pour trouver l'outil qui vous convient le mieux et commencez à créer dès aujourd'hui !
9 outils
xix.ai

Les meilleurs outils de 2026 pour la création de bulles de dialogue IA, les mieux notés pour la narration visuelle, sont disponibles ici sur XIX.AI ! Cette sélection regroupe des outils puissants et révolutionnaires qui aident les créateurs à booster leur productivité et à surmonter les blocages créatifs. Consultez un comparatif entre les versions gratuites et payantes, découvrez des tests en conditions réelles et consultez les derniers classements pour trouver les solutions incontournables, parfaites pour créer des récits visuels captivants. Explorez dès maintenant pour découvrir l'outil qui vous convient le mieux !
10 outils
xix.ai

2026 : les meilleurs outils d'IA pour la synthèse de réunions, les mieux notés, pour un suivi clair des décisions et des relances sans effort. Cette sélection présente des solutions puissantes et révolutionnaires qui boostent considérablement la productivité en automatisant la prise de notes lors des réunions, en identifiant les actions clés et en rationalisant la coordination des équipes sur l'ensemble des projets. Profitez d'une comparaison entre les versions gratuites et payantes, ainsi que de tests en conditions réelles et de classements mis à jour chaque semaine pour vous aider à trouver l'outil idéal. Découvrez-les dès maintenant pour tirer pleinement parti de l'IA !
9 outils
xix.ai

2026 : Les meilleures outils de nettoyage de données IA les plus récents et hautement notés pour corriger rapidement les valeurs manquantes et les doublons. Cette liste rigoureusement sélectionnée met en avant des solutions puissantes capables d’améliorer considérablement la productivité. Chaque outil a été soumis à des tests approfondis dans des conditions réelles afin de garantir sa fiabilité. Obtenez une comparaison gratuite et payante pour découvrir l’outil qu’il vous faut le mieux, adapté à vos besoins. Explorez dès maintenant XIX.AI pour tirer parti au maximum des capacités de l’IA.
11 outils
xix.ai

2026 Derniers Meilleurs Outils d’Idéation Créative par IA les Mieux Notés pour les Artistes sont sélectionnés par XIX.AI pour aider les créateurs à surmonner les blocages visuels et stimuler instantanément leur créativité. Ces outils puissants et révolutionnaires offrent des tests concrets, une comparaison détaillée entre les versions gratuites et payantes, ainsi que des classements mis à jour chaque semaine. Découvrez l’outil parfait pour accélérer la création de contenu et débloquer votre avantage IA dès aujourd’hui. Explorez maintenant !
14 outils
xix.ai

Les meilleurs générateurs de rythmes IA de 2026 pour les musiques de fond TikTok, les Reels et les morceaux promotionnels des créateurs ! XIX.AI a sélectionné une liste des outils les mieux notés, véritables révolutionnaires qui ont fait leurs preuves dans la pratique pour offrir une musique irréprochable, quel que soit votre besoin en matière de contenu. Vous y trouverez des comparaisons détaillées entre les versions gratuites et payantes, des classements mis à jour chaque semaine, ainsi que des options incontournables pour vous aider à stimuler votre créativité et votre productivité. Explorez-la dès maintenant pour découvrir l'outil qui vous convient le mieux !
11 outils
xix.ai

So Google's basically using old news articles to predict floods? That's wild. I mean, if it works, it could save thousands of lives, but I wonder how much historical data is actually reliable when weather patterns are changing so fast. 🌊🤔
ニュース記事をAIで分析して洪水を予測するなんて、Googleらしい発想だね。でも、データの偏りやプライバシーは大丈夫?特に途上国のニュース網が不十分な地域では、精度に影響が出そう。それに、この技術が有料サービス化されたら、災害予測にお金がかかる世の中になるのかな…ちょっと怖いかも😅












