


 Дом
TIPSv2 от Google DeepMind: ИИ, который действительно понимает изображения, а не просто бегло просматривает их
В настоящее время система искусственного интеллекта, распознающая изображения, имеет одно существенное ограничение.
На вопрос «Что изображено на этой картинке?» система может дать подробный ответ. Однако на вопрос «Где находится левая задняя лапа панды?» ответы будут расплывчатыми. Это не недостаток какой-то конкретной модели, а постоянная проблема, характерная для всей области крупных моделей визуально-языкового взаимодействия: сильное глобальное понимание, но слабая локальная локализация.
Google DeepMind представила в своей последней статье модель TIPSv2, специально разработанную для решения этой сложной проблемы.
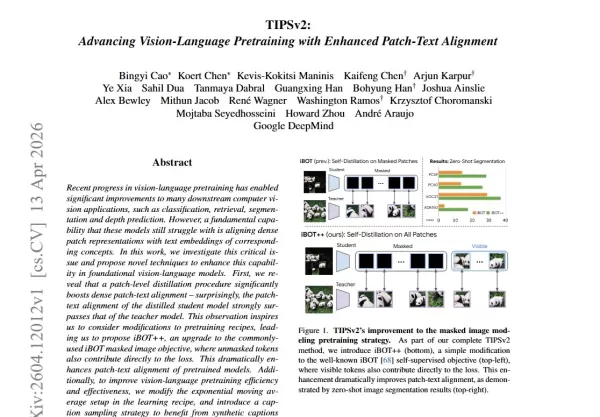
Исследовательская группа сделала неожиданное открытие: при выполнении задач тонкой сегментации небольшие «ученические» модели часто показывают лучшие результаты, чем более крупные «учительские» модели. Это происходит потому, что дистилляция устраняет механизм маскирования, заставляя модель изучать каждую деталь всего изображения, создавая своего рода «контроль над всей областью». Основываясь на этом открытии, в TIPSv2 были внедрены три ключевых усовершенствования.
Во-первых, iBOT++. Традиционное предварительное обучение вычисляет потери только для замаскированных областей, оставляя видимые области без внимания, что приводит к смещению локальной семантики. iBOT++ требует от модели обеспечения точного контроля над всеми видимыми областями, эффективно повышая уровень задачи с «игры-головоломки» до «внимательного чтения всего текста». Это одно улучшение повысило производительность сегментации без обучающих данных на 14,1 процентных пункта.
Во-вторых, EMA только для головки. Традиционное самообучение требует хранения в памяти двух почти идентичных больших моделей, что очень ресурсоемко. В TIPSv2 обнаружили, что одного контрастирующего убытка «изображение-текст» достаточно для стабилизации базовой сети, поэтому EMA нужно применять только к конечной проекционной головке, что устраняет необходимость дублирования базовой сети. Это сокращает количество параметров обучения примерно на 42%, ускоряя процесс практически без потери производительности.
В-третьих, сопоставление текста с различной степенью детализации. Во время обучения короткие описания из Интернета, описания средней детализации и длинные описания, сгенерированные Gemini, случайным образом смешиваются и подаются в модель, чередуя простые и сложные задачи. Это не позволяет модели «раскатиться» на простых задачах, одновременно гарантируя, что ни одна деталь не будет упущена.
Конечные результаты впечатляют. TIPSv2 прошла оценку в режиме «frozen» по девяти задачам и 20 авторитетным наборам данных. Семантическая сегментация без предварительного обучения (zero-shot) достигла нового отраслевого рекорда, а поиск и классификация по изображениям и тексту превзошли сравниваемые модели, имеющие на 56% больше параметров. Чисто визуальные задачи также вошли в число лучших результатов.
Код и веса модели TIPSv2 полностью открыты. Командам, работающим в области медицинской визуализации, автономного вождения, промышленного контроля и других областях, требующих высокоточного понимания изображений, стоит внимательно присмотреться к этому решению.
Статья: https://www.alphaxiv.org/abs/2604.12012
Связанная статья
 Генеральный директор DeepMind Хассабис: я сплю шесть часов в день, обычно чувствую прилив энергии около часа ночи.
В недавнем интервью журналу Fortune генеральный директор Google DeepMind Демис Хаассабис раскрыл свой нестандартный подход к отдыху и продуктивности. Хаассабис признался, что спит очень мало, распределяя свои бодрствующие часы на два отдельных рабочи
OpenAI и Anthropic борются за долю рынка, несмотря на снижение выручки
Несмотря на недавние сообщения о том, что OpenAI не достигла целевых показателей по выручке, что во вторник оказало давление на акции технологических компаний, частные инвесторы, вкладывающие средства
Соблюдение требований к автономным транспортным средствам в Калифорнии: новая эра штрафов, геозоны и 1 млн миль
Компания Guident эксплуатирует шаттл AuveTech в Южной Флориде, обслуживая маршрут протяженностью четыре мили в Вест-Палм-Бич и маршрут протяженностью одну милю в Бока-Ратоне с использованием своей тех
Рекомендации по связанным специальным темам
Музыкальная композиция
 Инструменты разделения стемов с использованием ИИ для создания ремиксов, подготовки образцов звука и формирования финальных версий караоке.
2026 год: лучшие и наиболее высоко оценённые инструменты для разделения аудиосигналов с использованием ИИ, отобранные специально для работы над ремиксами, подготовки образцов звука и создания караоке-версий. Эти мощные революционные инструменты проходят реальные тесты, обеспечивая точную изоляцию аудиосигналов и значительно повышая производительность. XIX.AI предоставляет еженедельно обновляемый бесплатный справочник сравнения платных и бесплатных решений, который поможет вам найти оптимальный вариант, соответствующий вашим потребностям. Ознакомьтесь с ним прямо сейчас, чтобы раскрыть потенциал ИИ в вашей работе.
 8 инструментов
 xix.ai
Анализ данных
ИИ-копилоты для SQL, предназначенные для создания панелей управления доходами, анализа воронки продаж и отслеживания показателей продуктов.
2026 год: лучшие AI-ассистенты для SQL, занявшие верхние строчки рейтингов! XIX.AI собрал мощный набор инструментов, регулярно обновляемый на основе реальных тестов. Эти неотъемлемые инструменты помогают создавать точные дашборды с данными о доходах, анализировать каналы продаж и оперативно отслеживать показатели продуктов, значительно повышая производительность. Ознакомьтесь сейчас, чтобы найти идеальный инструмент для принятия решений на основе данных! 238 символов
9 инструментов
xix.ai
Музыкальная композиция
Лучшие инструменты для написания мелодий с помощью ИИ для черновиков песен
2026 год: лучшие, топовые и высокооценённые инструменты ИИ для написания мелодий для черновиков песен! XIX.AI подобрал высокоэффективную коллекцию, меняющую правила игры, которая прошла строгие реальные испытания, чтобы обеспечить лучший опыт написания. Вы можете найти подробные сравнения бесплатных и платных версий, точные рейтинги и обязательные к использованию варианты, разработанные, чтобы помочь вам создавать потрясающие черновики песен без усилий и значительно повысить вашу творческую продуктивность. Исследуйте сейчас, чтобы найти свой идеальный инструмент!
8 инструментов
xix.ai
чат-бот
Лучшие инструменты для тренировки разговоров с помощью ИИ для подготовки к собеседованиям
2026 г. — новейшие, лучшие и наиболее высоко оцененные инструменты для тренировки разговорных навыков с помощью ИИ для подготовки к собеседованиям уже доступны на XIX.AI! Эта тщательно отобранная подборка включает мощные, революционные инструменты, прошедшие строгие реальные испытания и обеспечивающие точную обратную связь. Вы найдете сравнение бесплатных и платных вариантов, а также подробные рейтинги, которые помогут вам выбрать наиболее подходящий инструмент, повышающий вашу уверенность и навыки. Исследуйте сейчас, чтобы найти идеальный инструмент для успешного прохождения собеседований!
12 инструментов
xix.ai
Дизайн и искусство
Лучшие инструменты для переноса стилей с помощью ИИ для творческих экспериментов
2026: лучшие и самые популярные инструменты для переноса стиля с помощью ИИ для творческих экспериментов! XIX.AI подготовила подборку мощных, революционных инструментов, которые обязательно стоит попробовать: они демонстрируют исключительные результаты, подтвержденные реальными тестами и тщательным рейтингом. Эти ведущие решения помогают творческим людям значительно повысить продуктивность, ускоряя создание контента и открывая безграничные творческие возможности. Ознакомьтесь с ними прямо сейчас, чтобы найти идеальный инструмент и начать творить уже сегодня!
9 инструментов
xix.ai
Создание комиксов
Лучшие инструменты для создания диалоговых пузырей с помощью ИИ для визуального повествования
2026 года: самые новые и лучшие инструменты с ИИ для создания диалоговых пузырей в визуальном сторителлинге представлены на XIX.AI! В этой тщательно подобранной подборке представлены мощные, революционные инструменты, которые помогут творческим людям повысить продуктивность и преодолеть творческие кризисы. Ознакомьтесь со сравнением бесплатных и платных версий, посмотрите тесты в реальных условиях и изучите последние рейтинги, чтобы найти решения, которые обязательно стоит попробовать и которые идеально подходят для создания увлекательных визуальных историй. Исследуйте коллекцию прямо сейчас, чтобы найти свой идеальный инструмент!
10 инструментов
xix.ai

 Комментарии (0)
В настоящее время система искусственного интеллекта, распознающая изображения, имеет одно существенное ограничение.
На вопрос «Что изображено на этой картинке?» система может дать подробный ответ. Однако на вопрос «Где находится левая задняя лапа панды?» ответы будут расплывчатыми. Это не недостаток какой-то конкретной модели, а постоянная проблема, характерная для всей области крупных моделей визуально-языкового взаимодействия: сильное глобальное понимание, но слабая локальная локализация.
Google DeepMind представила в своей последней статье модель TIPSv2, специально разработанную для решения этой сложной проблемы.
Исследовательская группа сделала неожиданное открытие: при выполнении задач тонкой сегментации небольшие «ученические» модели часто показывают лучшие результаты, чем более крупные «учительские» модели. Это происходит потому, что дистилляция устраняет механизм маскирования, заставляя модель изучать каждую деталь всего изображения, создавая своего рода «контроль над всей областью». Основываясь на этом открытии, в TIPSv2 были внедрены три ключевых усовершенствования.
Во-первых, iBOT++. Традиционное предварительное обучение вычисляет потери только для замаскированных областей, оставляя видимые области без внимания, что приводит к смещению локальной семантики. iBOT++ требует от модели обеспечения точного контроля над всеми видимыми областями, эффективно повышая уровень задачи с «игры-головоломки» до «внимательного чтения всего текста». Это одно улучшение повысило производительность сегментации без обучающих данных на 14,1 процентных пункта.
Во-вторых, EMA только для головки. Традиционное самообучение требует хранения в памяти двух почти идентичных больших моделей, что очень ресурсоемко. В TIPSv2 обнаружили, что одного контрастирующего убытка «изображение-текст» достаточно для стабилизации базовой сети, поэтому EMA нужно применять только к конечной проекционной головке, что устраняет необходимость дублирования базовой сети. Это сокращает количество параметров обучения примерно на 42%, ускоряя процесс практически без потери производительности.
В-третьих, сопоставление текста с различной степенью детализации. Во время обучения короткие описания из Интернета, описания средней детализации и длинные описания, сгенерированные Gemini, случайным образом смешиваются и подаются в модель, чередуя простые и сложные задачи. Это не позволяет модели «раскатиться» на простых задачах, одновременно гарантируя, что ни одна деталь не будет упущена.
Конечные результаты впечатляют. TIPSv2 прошла оценку в режиме «frozen» по девяти задачам и 20 авторитетным наборам данных. Семантическая сегментация без предварительного обучения (zero-shot) достигла нового отраслевого рекорда, а поиск и классификация по изображениям и тексту превзошли сравниваемые модели, имеющие на 56% больше параметров. Чисто визуальные задачи также вошли в число лучших результатов.
Код и веса модели TIPSv2 полностью открыты. Командам, работающим в области медицинской визуализации, автономного вождения, промышленного контроля и других областях, требующих высокоточного понимания изображений, стоит внимательно присмотреться к этому решению.
Статья: https://www.alphaxiv.org/abs/2604.12012








 Генеральный директор DeepMind Хассабис: я сплю шесть часов в день, обычно чувствую прилив энергии около часа ночи.
В недавнем интервью журналу Fortune генеральный директор Google DeepMind Демис Хаассабис раскрыл свой нестандартный подход к отдыху и продуктивности. Хаассабис признался, что спит очень мало, распределяя свои бодрствующие часы на два отдельных рабочи
 OpenAI и Anthropic борются за долю рынка, несмотря на снижение выручки
Несмотря на недавние сообщения о том, что OpenAI не достигла целевых показателей по выручке, что во вторник оказало давление на акции технологических компаний, частные инвесторы, вкладывающие средства
Соблюдение требований к автономным транспортным средствам в Калифорнии: новая эра штрафов, геозоны и 1 млн миль
Компания Guident эксплуатирует шаттл AuveTech в Южной Флориде, обслуживая маршрут протяженностью четыре мили в Вест-Палм-Бич и маршрут протяженностью одну милю в Бока-Ратоне с использованием своей тех

2026 год: лучшие и наиболее высоко оценённые инструменты для разделения аудиосигналов с использованием ИИ, отобранные специально для работы над ремиксами, подготовки образцов звука и создания караоке-версий. Эти мощные революционные инструменты проходят реальные тесты, обеспечивая точную изоляцию аудиосигналов и значительно повышая производительность. XIX.AI предоставляет еженедельно обновляемый бесплатный справочник сравнения платных и бесплатных решений, который поможет вам найти оптимальный вариант, соответствующий вашим потребностям. Ознакомьтесь с ним прямо сейчас, чтобы раскрыть потенциал ИИ в вашей работе.
8 инструментов
xix.ai

2026 год: лучшие AI-ассистенты для SQL, занявшие верхние строчки рейтингов! XIX.AI собрал мощный набор инструментов, регулярно обновляемый на основе реальных тестов. Эти неотъемлемые инструменты помогают создавать точные дашборды с данными о доходах, анализировать каналы продаж и оперативно отслеживать показатели продуктов, значительно повышая производительность. Ознакомьтесь сейчас, чтобы найти идеальный инструмент для принятия решений на основе данных! 238 символов
9 инструментов
xix.ai

2026 год: лучшие, топовые и высокооценённые инструменты ИИ для написания мелодий для черновиков песен! XIX.AI подобрал высокоэффективную коллекцию, меняющую правила игры, которая прошла строгие реальные испытания, чтобы обеспечить лучший опыт написания. Вы можете найти подробные сравнения бесплатных и платных версий, точные рейтинги и обязательные к использованию варианты, разработанные, чтобы помочь вам создавать потрясающие черновики песен без усилий и значительно повысить вашу творческую продуктивность. Исследуйте сейчас, чтобы найти свой идеальный инструмент!
8 инструментов
xix.ai

2026 г. — новейшие, лучшие и наиболее высоко оцененные инструменты для тренировки разговорных навыков с помощью ИИ для подготовки к собеседованиям уже доступны на XIX.AI! Эта тщательно отобранная подборка включает мощные, революционные инструменты, прошедшие строгие реальные испытания и обеспечивающие точную обратную связь. Вы найдете сравнение бесплатных и платных вариантов, а также подробные рейтинги, которые помогут вам выбрать наиболее подходящий инструмент, повышающий вашу уверенность и навыки. Исследуйте сейчас, чтобы найти идеальный инструмент для успешного прохождения собеседований!
12 инструментов
xix.ai

2026: лучшие и самые популярные инструменты для переноса стиля с помощью ИИ для творческих экспериментов! XIX.AI подготовила подборку мощных, революционных инструментов, которые обязательно стоит попробовать: они демонстрируют исключительные результаты, подтвержденные реальными тестами и тщательным рейтингом. Эти ведущие решения помогают творческим людям значительно повысить продуктивность, ускоряя создание контента и открывая безграничные творческие возможности. Ознакомьтесь с ними прямо сейчас, чтобы найти идеальный инструмент и начать творить уже сегодня!
9 инструментов
xix.ai

2026 года: самые новые и лучшие инструменты с ИИ для создания диалоговых пузырей в визуальном сторителлинге представлены на XIX.AI! В этой тщательно подобранной подборке представлены мощные, революционные инструменты, которые помогут творческим людям повысить продуктивность и преодолеть творческие кризисы. Ознакомьтесь со сравнением бесплатных и платных версий, посмотрите тесты в реальных условиях и изучите последние рейтинги, чтобы найти решения, которые обязательно стоит попробовать и которые идеально подходят для создания увлекательных визуальных историй. Исследуйте коллекцию прямо сейчас, чтобы найти свой идеальный инструмент!
10 инструментов
xix.ai












