


 Lar
TIPSv2 do Google DeepMind: uma IA que realmente compreende imagens, e não apenas as analisa superficialmente
Atualmente, a compreensão de imagens por IA apresenta uma limitação fundamental.
Quando questionada com “O que há nesta imagem?”, ela pode fornecer uma resposta detalhada. No entanto, perguntar “Onde está a pata traseira esquerda do panda?” leva a respostas vagas. Isso não é uma falha em nenhum modelo específico, mas uma questão persistente em todo o domínio dos grandes modelos de linguagem visual: forte compreensão global, mas fraca localização local.
O Google DeepMind apresentou o TIPSv2 em seu artigo mais recente, projetado especificamente para lidar com esse problema desafiador.
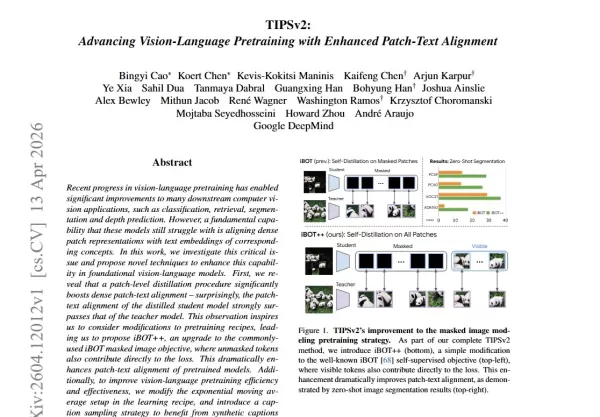
A equipe de pesquisa observou uma descoberta contraintuitiva: em tarefas de segmentação refinada, modelos alunos menores frequentemente superam os modelos professores maiores. Isso ocorre porque a destilação remove o mecanismo de mascaramento, obrigando o modelo a aprender cada detalhe da imagem inteira, criando uma forma de “supervisão de área total”. Motivado por essa percepção, o TIPSv2 introduziu três melhorias principais.
Primeiro, o iBOT++. O pré-treinamento tradicional calcula a perda apenas para regiões mascaradas, deixando as áreas visíveis em um estado negligenciado que causa o desvio da semântica local. O iBOT++ exige que o modelo forneça supervisão precisa sobre todas as áreas visíveis, efetivamente elevando a tarefa de um “jogo de quebra-cabeça” para “ler cuidadosamente o texto inteiro”. Essa única melhoria impulsionou o desempenho da segmentação zero-shot em 14,1 pontos percentuais.
Segundo, EMA apenas para a cabeça. O treinamento auto-supervisionado tradicional exige manter dois modelos grandes quase idênticos na memória, o que consome muitos recursos. O TIPSv2 descobriu que a perda contrastiva imagem-texto por si só é suficiente para estabilizar a rede backbone, de modo que o EMA precisa ser aplicado apenas à cabeça de projeção final, eliminando a necessidade de duplicar a backbone. Isso reduz a contagem de parâmetros de treinamento em cerca de 42%, tornando-o mais rápido quase sem perda de desempenho.
Terceiro, emparelhamento de texto com granularidade múltipla. Durante o treinamento, descrições curtas da web, descrições de detalhe médio e descrições longas geradas pelo Gemini são misturadas aleatoriamente e alimentadas no modelo, alternando entre tarefas fáceis e difíceis. Isso impede que o modelo se acomode em tarefas simples, ao mesmo tempo em que garante que nenhum detalhe seja negligenciado.
Os resultados finais são impressionantes. O TIPSv2 passou por uma avaliação congelada em nove tarefas e 20 conjuntos de dados de referência. A segmentação semântica zero-shot alcançou um novo benchmark do setor, enquanto a recuperação e classificação de imagem-texto superaram os modelos de comparação com 56% mais parâmetros. Tarefas puramente visuais também se destacaram entre as de melhor desempenho.
O código e os pesos do modelo do TIPSv2 são totalmente de código aberto. Para equipes que trabalham com imagens médicas, direção autônoma, inspeção industrial e outros domínios que exigem compreensão de imagens de alta precisão, vale a pena dar uma olhada mais de perto nessa solução.
Artigo: https://www.alphaxiv.org/abs/2604.12012
Artigo relacionado
 CEO da DeepMind, Hassabis: Durmo seis horas por dia, geralmente me sinto energético por volta da 1h
O Fortune recentemente publicou uma entrevista com Demis Hassabis, CEO da Google DeepMind, revelando sua abordagem incomum para descanso e produtividade. Hassabis revelou que dorme muito pouco, estruturando suas horas acordadas em dois blocos de trab
OpenAI e Anthropic disputam participação no mercado, apesar da queda na receita
Apesar de relatos recentes sugerirem que a OpenAI não atingiu suas metas de receita, o que gerou pressão sobre as ações do setor de tecnologia nesta terça-feira, os investidores privados em laboratóri
Conformidade com a regulamentação de veículos autônomos na Califórnia: uma nova era de multas, geocercas e 1 milhão de milhas
A Guident opera um veículo de transporte da AuveTech no sul da Flórida, administrando uma rota de quatro milhas em West Palm Beach e uma rota de uma milha em Boca Raton por meio de sua tecnologia de m
Recomendações de tópicos especiais relacionados
chatbot
 Melhores aplicativos de chat de interpretação de papéis com IA para prática de idiomas, preparação para entrevistas e fluência diária
2026 Últimas Melhores Aplicativos de Chat de Interpretação de Papéis por IA Mais Bem Avaliados para Prática de Idiomas, Preparação para Entrevistas e Fluência Diária! O XIX.AI seleciona uma poderosa coleção revolucionária que oferece comparação entre gratuito e pago, testes do mundo real e classificações atualizadas semanalmente. Essas ferramentas imperdíveis ajudam você a aprimorar suas habilidades de escrita, superar desafios de fluência e melhorar a eficiência da comunicação em todos os cenários diários. Explore agora para descobrir sua ferramenta perfeita para o crescimento do idioma!
 10 ferramentas
 xix.ai
Composição musical
Ferramentas de separação de stems com IA para produção de remixes, preparação de samples e masters de karaokê
As melhores e mais bem avaliadas ferramentas de separação de faixas com IA de 2026, selecionadas especialmente para produção de remixes, preparação de samples e masters de karaokê. Essas ferramentas poderosas e revolucionárias passaram por testes práticos para oferecer isolamento de áudio preciso, aumentando significativamente a produtividade. A XIX.AI oferece um guia comparativo entre versões gratuitas e pagas, atualizado semanalmente, para ajudá-lo a encontrar a solução imperdível que melhor atenda às suas necessidades. Explore agora para aproveitar ao máximo as vantagens da IA.
8 ferramentas
xix.ai
Análise de dados
Copilotos de IA para SQL voltados para painéis de receita, análise de funis e métricas de produtos
2026: Os melhores copilotos AI para SQL, atualizados e classificados entre os melhores! A XIX.AI reúne uma coleção poderosa e revolucionária, com testes em ambiente real atualizados semanalmente. Essas ferramentas indispensáveis ajudam a gerar painéis de controle de receita precisos, analisar funis de vendas e rastrear métricas de produtos de forma rápida, aumentando significativamente a produtividade. Explore agora e encontre a ferramenta perfeita para tomada de decisões baseadas em dados! 238 caracteres
9 ferramentas
xix.ai
Composição musical
Melhores Ferramentas de IA para Criação de Melodias para Rascunhos de Músicas
2026 Últimas Melhores Ferramentas de Escrita de Melodias por IA Mais Bem Avaliadas para Rascunhos de Músicas! A XIX.AI reuniu uma coleção altamente poderosa e transformadora, que passou por rigorosos testes no mundo real para oferecer a melhor experiência de escrita. Você pode encontrar comparações detalhadas entre as versões gratuita e paga, classificações precisas e opções imperdíveis projetadas para ajudá-lo a criar rascunhos de músicas impressionantes sem esforço e aumentar significativamente sua produtividade criativa. Explore agora para descobrir a ferramenta perfeita para você!
8 ferramentas
xix.ai
chatbot
Melhores ferramentas de treinamento de conversação com IA para prática de entrevistas
As melhores ferramentas de treinamento de conversação com IA mais recentes e altamente avaliadas para 2026, ideais para prática de entrevistas, estão disponíveis no XIX.AI! Esta coleção selecionada apresenta ferramentas poderosas e transformadoras, submetidas a rigorosos testes do mundo real para fornecer feedback preciso. Você encontrará uma comparação entre opções gratuitas e pagas, além de classificações detalhadas, para ajudá-lo a escolher a opção imperdível que aumenta sua confiança e habilidades. Explore agora para descobrir a ferramenta perfeita para o sucesso nas entrevistas!
12 ferramentas
xix.ai
Design e Arte
As melhores ferramentas de transferência de estilo com IA para experimentos criativos
As melhores e mais bem avaliadas ferramentas de transferência de estilo com IA de 2026 para experimentos criativos! A XIX.AI selecionou uma coleção poderosa e revolucionária de ferramentas imperdíveis, que oferecem resultados excepcionais por meio de testes reais e classificações rigorosas. Essas soluções de ponta ajudam os profissionais criativos a aumentar significativamente a produtividade, acelerando a criação de conteúdo e revelando possibilidades criativas infinitas. Explore agora para descobrir a ferramenta perfeita para você e comece a criar hoje mesmo!
9 ferramentas
xix.ai

 Comentários (0)
Atualmente, a compreensão de imagens por IA apresenta uma limitação fundamental.
Quando questionada com “O que há nesta imagem?”, ela pode fornecer uma resposta detalhada. No entanto, perguntar “Onde está a pata traseira esquerda do panda?” leva a respostas vagas. Isso não é uma falha em nenhum modelo específico, mas uma questão persistente em todo o domínio dos grandes modelos de linguagem visual: forte compreensão global, mas fraca localização local.
O Google DeepMind apresentou o TIPSv2 em seu artigo mais recente, projetado especificamente para lidar com esse problema desafiador.
A equipe de pesquisa observou uma descoberta contraintuitiva: em tarefas de segmentação refinada, modelos alunos menores frequentemente superam os modelos professores maiores. Isso ocorre porque a destilação remove o mecanismo de mascaramento, obrigando o modelo a aprender cada detalhe da imagem inteira, criando uma forma de “supervisão de área total”. Motivado por essa percepção, o TIPSv2 introduziu três melhorias principais.
Primeiro, o iBOT++. O pré-treinamento tradicional calcula a perda apenas para regiões mascaradas, deixando as áreas visíveis em um estado negligenciado que causa o desvio da semântica local. O iBOT++ exige que o modelo forneça supervisão precisa sobre todas as áreas visíveis, efetivamente elevando a tarefa de um “jogo de quebra-cabeça” para “ler cuidadosamente o texto inteiro”. Essa única melhoria impulsionou o desempenho da segmentação zero-shot em 14,1 pontos percentuais.
Segundo, EMA apenas para a cabeça. O treinamento auto-supervisionado tradicional exige manter dois modelos grandes quase idênticos na memória, o que consome muitos recursos. O TIPSv2 descobriu que a perda contrastiva imagem-texto por si só é suficiente para estabilizar a rede backbone, de modo que o EMA precisa ser aplicado apenas à cabeça de projeção final, eliminando a necessidade de duplicar a backbone. Isso reduz a contagem de parâmetros de treinamento em cerca de 42%, tornando-o mais rápido quase sem perda de desempenho.
Terceiro, emparelhamento de texto com granularidade múltipla. Durante o treinamento, descrições curtas da web, descrições de detalhe médio e descrições longas geradas pelo Gemini são misturadas aleatoriamente e alimentadas no modelo, alternando entre tarefas fáceis e difíceis. Isso impede que o modelo se acomode em tarefas simples, ao mesmo tempo em que garante que nenhum detalhe seja negligenciado.
Os resultados finais são impressionantes. O TIPSv2 passou por uma avaliação congelada em nove tarefas e 20 conjuntos de dados de referência. A segmentação semântica zero-shot alcançou um novo benchmark do setor, enquanto a recuperação e classificação de imagem-texto superaram os modelos de comparação com 56% mais parâmetros. Tarefas puramente visuais também se destacaram entre as de melhor desempenho.
O código e os pesos do modelo do TIPSv2 são totalmente de código aberto. Para equipes que trabalham com imagens médicas, direção autônoma, inspeção industrial e outros domínios que exigem compreensão de imagens de alta precisão, vale a pena dar uma olhada mais de perto nessa solução.
Artigo: https://www.alphaxiv.org/abs/2604.12012








 CEO da DeepMind, Hassabis: Durmo seis horas por dia, geralmente me sinto energético por volta da 1h
O Fortune recentemente publicou uma entrevista com Demis Hassabis, CEO da Google DeepMind, revelando sua abordagem incomum para descanso e produtividade. Hassabis revelou que dorme muito pouco, estruturando suas horas acordadas em dois blocos de trab
 OpenAI e Anthropic disputam participação no mercado, apesar da queda na receita
Apesar de relatos recentes sugerirem que a OpenAI não atingiu suas metas de receita, o que gerou pressão sobre as ações do setor de tecnologia nesta terça-feira, os investidores privados em laboratóri
Conformidade com a regulamentação de veículos autônomos na Califórnia: uma nova era de multas, geocercas e 1 milhão de milhas
A Guident opera um veículo de transporte da AuveTech no sul da Flórida, administrando uma rota de quatro milhas em West Palm Beach e uma rota de uma milha em Boca Raton por meio de sua tecnologia de m

2026 Últimas Melhores Aplicativos de Chat de Interpretação de Papéis por IA Mais Bem Avaliados para Prática de Idiomas, Preparação para Entrevistas e Fluência Diária! O XIX.AI seleciona uma poderosa coleção revolucionária que oferece comparação entre gratuito e pago, testes do mundo real e classificações atualizadas semanalmente. Essas ferramentas imperdíveis ajudam você a aprimorar suas habilidades de escrita, superar desafios de fluência e melhorar a eficiência da comunicação em todos os cenários diários. Explore agora para descobrir sua ferramenta perfeita para o crescimento do idioma!
10 ferramentas
xix.ai

As melhores e mais bem avaliadas ferramentas de separação de faixas com IA de 2026, selecionadas especialmente para produção de remixes, preparação de samples e masters de karaokê. Essas ferramentas poderosas e revolucionárias passaram por testes práticos para oferecer isolamento de áudio preciso, aumentando significativamente a produtividade. A XIX.AI oferece um guia comparativo entre versões gratuitas e pagas, atualizado semanalmente, para ajudá-lo a encontrar a solução imperdível que melhor atenda às suas necessidades. Explore agora para aproveitar ao máximo as vantagens da IA.
8 ferramentas
xix.ai

2026: Os melhores copilotos AI para SQL, atualizados e classificados entre os melhores! A XIX.AI reúne uma coleção poderosa e revolucionária, com testes em ambiente real atualizados semanalmente. Essas ferramentas indispensáveis ajudam a gerar painéis de controle de receita precisos, analisar funis de vendas e rastrear métricas de produtos de forma rápida, aumentando significativamente a produtividade. Explore agora e encontre a ferramenta perfeita para tomada de decisões baseadas em dados! 238 caracteres
9 ferramentas
xix.ai

2026 Últimas Melhores Ferramentas de Escrita de Melodias por IA Mais Bem Avaliadas para Rascunhos de Músicas! A XIX.AI reuniu uma coleção altamente poderosa e transformadora, que passou por rigorosos testes no mundo real para oferecer a melhor experiência de escrita. Você pode encontrar comparações detalhadas entre as versões gratuita e paga, classificações precisas e opções imperdíveis projetadas para ajudá-lo a criar rascunhos de músicas impressionantes sem esforço e aumentar significativamente sua produtividade criativa. Explore agora para descobrir a ferramenta perfeita para você!
8 ferramentas
xix.ai

As melhores ferramentas de treinamento de conversação com IA mais recentes e altamente avaliadas para 2026, ideais para prática de entrevistas, estão disponíveis no XIX.AI! Esta coleção selecionada apresenta ferramentas poderosas e transformadoras, submetidas a rigorosos testes do mundo real para fornecer feedback preciso. Você encontrará uma comparação entre opções gratuitas e pagas, além de classificações detalhadas, para ajudá-lo a escolher a opção imperdível que aumenta sua confiança e habilidades. Explore agora para descobrir a ferramenta perfeita para o sucesso nas entrevistas!
12 ferramentas
xix.ai

As melhores e mais bem avaliadas ferramentas de transferência de estilo com IA de 2026 para experimentos criativos! A XIX.AI selecionou uma coleção poderosa e revolucionária de ferramentas imperdíveis, que oferecem resultados excepcionais por meio de testes reais e classificações rigorosas. Essas soluções de ponta ajudam os profissionais criativos a aumentar significativamente a produtividade, acelerando a criação de conteúdo e revelando possibilidades criativas infinitas. Explore agora para descobrir a ferramenta perfeita para você e comece a criar hoje mesmo!
9 ferramentas
xix.ai












