


 Дом
Alibaba представила компактные модели графических процессоров Qwen3.5 для потребительского рынка
Компания Tongyi Lab официально представила новейшие компактные модели из серии Qwen3.5, представляющие новое поколение крупных языковых моделей. В релиз вошли четыре версии с количеством параметров 0,8 млрд, 2 млрд, 4 млрд и 9 млрд. Эти модели призваны снизить барьеры для внедрения ИИ за счет исключительной оптимизации производительности, что позволяет экономично и эффективно развертывать их повсеместно — от периферийных устройств до специализированных приложений.
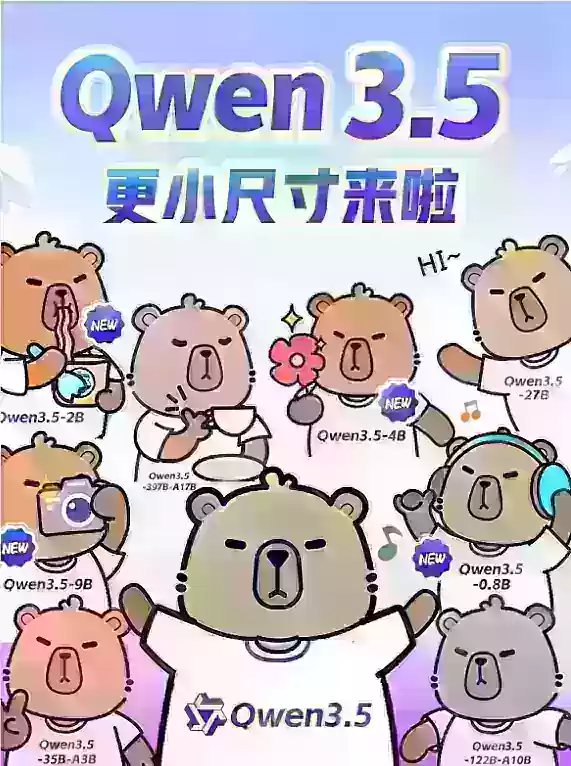
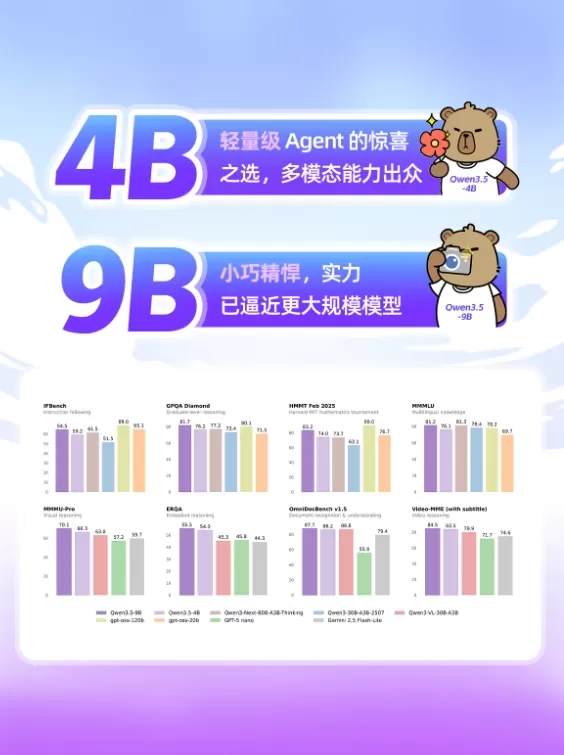
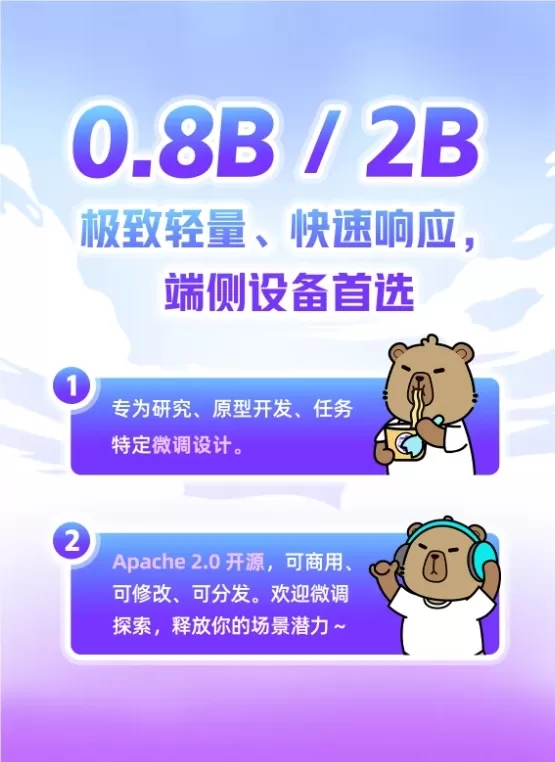
Вся серия построена на единой основе Qwen3.5. В отличие от более крупных моделей, в которых приоритет отдается огромному количеству параметров, эти компактные версии отличаются «легкостью» и «высокой адаптивностью». Модели 0,8B и 2B адаптированы для периферийных устройств, обеспечивая чрезвычайную эффективность и время отклика на уровне миллисекунд на таких платформах, как смартфоны и встроенное оборудование. Версия 4B выделяется своими мультимодальными способностями, что делает ее отличным выбором для разработки легких ИИ-агентов. Несмотря на скромный размер, модель 9B обеспечивает производительность, сопоставимую с гораздо более крупными аналогами, и способна обрабатывать сложные логические выводы.
В целях дальнейшей поддержки сообщества разработчиков Tongyi Lab выпустила эту серию под лицензией Apache 2.0, сделав ее открытой и бесплатной для коммерческого использования. Это позволяет разработчикам свободно проводить LoRA или полную тонкую настройку моделей, с возможностью начинать адаптацию под конкретные задачи с использованием обычных графических процессоров потребительского уровня. Такой подход значительно сокращает время и затраты для индивидуальных разработчиков и малых и средних предприятий на создание прототипов идей и разработку специализированных приложений.
Связанная статья
 Meta хочет, чтобы ваше следующее устройство было оснащено Muse
Искусственный интеллект Meta Muse, который занимается бронированием путешествий, заполнением форм и покупками, получил широкое распространение, однако новая инициатива может особенно заинтересовать разработчиков и энтузиастов аппаратного обеспечения.
Wan-Streamer v0.2 обеспечивает сверхнизкую задержку ИИ-чата
По мере стремительного развития современных технологий взаимодействие человека с искусственным интеллектом становится всё более распространённым. Традиционные видеозвонки часто страдают от задержек, лагов и рассинхронизации аудио- и видеоданных. Wan-
Meta присоединяется к TSMC и Micron для оснащения новых серверов старой памятью
По мере ускорения внедрения искусственного интеллекта во всем мире наблюдается острый дефицит памяти следующего поколения DDR5. Чтобы избежать задержек в развертывании центров обработки данных для ИИ, Meta заключила партнерство с ведущими отраслевыми
Рекомендации по связанным специальным темам
Дизайн и искусство
 Лучшие инструменты для создания иллюстраций с помощью ИИ: быстрее создавайте редакционные сцены и обложки
2026: Новейшие и самые популярные инструменты для создания иллюстраций с помощью ИИ: в нашем тщательно подобранном списке представлены лучшие инструменты с мощными функциональными возможностями, позволяющие быстро создавать потрясающие редакционные сцены и привлекательные обложки. Каждый вариант прошел тщательные практические испытания; мы предлагаем сравнение бесплатных и платных версий, чтобы помочь вам найти идеальный вариант для вашего рабочего процесса. Попробуйте эти незаменимые решения уже сегодня, чтобы раскрыть потенциал искусственного интеллекта и повысить свою творческую продуктивность. Узнайте больше на сайте XIX.AI.
 10 инструментов
 xix.ai
Образование и обучение
Лучшие репетиторы по искусственному интеллекту для подготовки к экзаменам: практикуйтесь по математике, естественным наукам и английскому языку
2026 года: лучшие и самые популярные ИИ-репетиторы для подготовки к экзаменам представлены на XIX.AI! В нашем тщательно подобранном списке представлены мощные инструменты, которые кардинально изменят ваш подход к обучению: здесь вы найдете сравнение бесплатных и платных версий, тесты на практике и еженедельно обновляемые рейтинги. Они помогут повысить эффективность вашего письма, упростить изучение сложных тем и раскрыть ваш академический потенциал. Ознакомьтесь с ними прямо сейчас, чтобы найти идеальный инструмент для подготовки к экзаменам, и начните творить уже сегодня, чтобы раскрыть свои преимущества благодаря ИИ!
10 инструментов
xix.ai
Финансы
Инструменты планирования бюджета на основе ИИ для управления личными финансами
В 2026 году на XIX.AI представлены новейшие, лучшие и наиболее рейтинговые инструменты ИИ для бюджетного планирования по личным финансам! Эта тщательно отобранная коллекция включает мощные, революционные решения, которые помогают проводить реальные тесты, понимать привычки расходов и создавать персонализированные планы для повышения продуктивности. Наслаждайтесь бесплатным сравнением с платными версиями вместе с подробными рейтингами. Инструменты, которые обязательно стоит попробовать, разработаны для упрощения управления деньгами и раскрытия вашего преимущества ИИ. Исследуйте сейчас!
11 инструментов
xix.ai
Здоровье и благополучие
Помощники для отслеживания сна с ИИ: улучшите восстановление за счёт более правильных привычек перед сном
2026 год: лучшие и наиболее высоко оценённые помощники для отслеживания сна на основе ИИ, отобранные для максимального восстановления организма. В этом полностью обновлённом еженедельном руководстве представлены мощные инструменты с результатами реальных тестов, сравнением бесплатных и платных версий, а также подробными рейтингами, которые помогут вам найти оптимальное решение для улучшения качества сна и формирования лучших привычек перед сном. Ознакомьтесь с ним прямо сейчас на сайте XIX.AI, чтобы раскрыть потенциал ИИ в вашей жизни.
10 инструментов
xix.ai
Анализ данных
AI-копилоты SQL для аналитики продуктов и выручки
2026: лучшие и самые популярные ИИ-помощники для работы с SQL в сфере аналитики продуктов и доходов! XIX.AI подготовила мощную, революционную подборку инструментов, которые обязательно стоит попробовать. Они проходят проверку в реальных условиях и включаются в еженедельно обновляемый рейтинг. Эти инструменты помогают пользователям значительно повысить продуктивность за счет ускорения анализа данных, оптимизации сложных запросов и получения точных аналитических выводов, которые позволяют принимать более обоснованные бизнес-решения. Ознакомьтесь с ними прямо сейчас, чтобы найти идеальный инструмент, который поможет вам раскрыть весь потенциал искусственного интеллекта!
14 инструментов
xix.ai
Образование и обучение
Лучшие помощники по домашним заданиям с ИИ, которые учат: изучайте концепции, а не просто ответы
2026: лучшие и самые популярные помощники по домашним заданиям с ИИ, которые обучают основным концепциям, а не просто дают готовые ответы. Мощные инструменты для студентов. Обязательный к пробованию тщательно отобранный список. Еженедельное обновление. Сравнение бесплатных и платных версий. Тестирование в реальных условиях. Точные рейтинги, которые помогут вам раскрыть весь свой учебный потенциал. Исследуйте сейчас, чтобы найти идеальный инструмент для более эффективного обучения.
10 инструментов
xix.ai

 Комментарии (1)
![GeorgeCarter]()
Wait, so Qwen3.5 is coming with tiny models that fit on consumer GPUs? That's actually huge for people like me who don't have a server farm in their basement. 0.8B to 9B parameters – I'm curious how much performance they sacrifice for size. Is it going to run smoothly on a 3060? 🤔 Also, Tongyi Lab is really pushing the trend of small but capable models, kinda like the iPhone of LLMs – compact but powerful. Let's see if they can beat the open-source competition.
Компания Tongyi Lab официально представила новейшие компактные модели из серии Qwen3.5, представляющие новое поколение крупных языковых моделей. В релиз вошли четыре версии с количеством параметров 0,8 млрд, 2 млрд, 4 млрд и 9 млрд. Эти модели призваны снизить барьеры для внедрения ИИ за счет исключительной оптимизации производительности, что позволяет экономично и эффективно развертывать их повсеместно — от периферийных устройств до специализированных приложений.
Вся серия построена на единой основе Qwen3.5. В отличие от более крупных моделей, в которых приоритет отдается огромному количеству параметров, эти компактные версии отличаются «легкостью» и «высокой адаптивностью». Модели 0,8B и 2B адаптированы для периферийных устройств, обеспечивая чрезвычайную эффективность и время отклика на уровне миллисекунд на таких платформах, как смартфоны и встроенное оборудование. Версия 4B выделяется своими мультимодальными способностями, что делает ее отличным выбором для разработки легких ИИ-агентов. Несмотря на скромный размер, модель 9B обеспечивает производительность, сопоставимую с гораздо более крупными аналогами, и способна обрабатывать сложные логические выводы.
В целях дальнейшей поддержки сообщества разработчиков Tongyi Lab выпустила эту серию под лицензией Apache 2.0, сделав ее открытой и бесплатной для коммерческого использования. Это позволяет разработчикам свободно проводить LoRA или полную тонкую настройку моделей, с возможностью начинать адаптацию под конкретные задачи с использованием обычных графических процессоров потребительского уровня. Такой подход значительно сокращает время и затраты для индивидуальных разработчиков и малых и средних предприятий на создание прототипов идей и разработку специализированных приложений.








 Meta хочет, чтобы ваше следующее устройство было оснащено Muse
Искусственный интеллект Meta Muse, который занимается бронированием путешествий, заполнением форм и покупками, получил широкое распространение, однако новая инициатива может особенно заинтересовать разработчиков и энтузиастов аппаратного обеспечения.
 Wan-Streamer v0.2 обеспечивает сверхнизкую задержку ИИ-чата
По мере стремительного развития современных технологий взаимодействие человека с искусственным интеллектом становится всё более распространённым. Традиционные видеозвонки часто страдают от задержек, лагов и рассинхронизации аудио- и видеоданных. Wan-
 Meta присоединяется к TSMC и Micron для оснащения новых серверов старой памятью
По мере ускорения внедрения искусственного интеллекта во всем мире наблюдается острый дефицит памяти следующего поколения DDR5. Чтобы избежать задержек в развертывании центров обработки данных для ИИ, Meta заключила партнерство с ведущими отраслевыми

2026: Новейшие и самые популярные инструменты для создания иллюстраций с помощью ИИ: в нашем тщательно подобранном списке представлены лучшие инструменты с мощными функциональными возможностями, позволяющие быстро создавать потрясающие редакционные сцены и привлекательные обложки. Каждый вариант прошел тщательные практические испытания; мы предлагаем сравнение бесплатных и платных версий, чтобы помочь вам найти идеальный вариант для вашего рабочего процесса. Попробуйте эти незаменимые решения уже сегодня, чтобы раскрыть потенциал искусственного интеллекта и повысить свою творческую продуктивность. Узнайте больше на сайте XIX.AI.
10 инструментов
xix.ai

2026 года: лучшие и самые популярные ИИ-репетиторы для подготовки к экзаменам представлены на XIX.AI! В нашем тщательно подобранном списке представлены мощные инструменты, которые кардинально изменят ваш подход к обучению: здесь вы найдете сравнение бесплатных и платных версий, тесты на практике и еженедельно обновляемые рейтинги. Они помогут повысить эффективность вашего письма, упростить изучение сложных тем и раскрыть ваш академический потенциал. Ознакомьтесь с ними прямо сейчас, чтобы найти идеальный инструмент для подготовки к экзаменам, и начните творить уже сегодня, чтобы раскрыть свои преимущества благодаря ИИ!
10 инструментов
xix.ai

В 2026 году на XIX.AI представлены новейшие, лучшие и наиболее рейтинговые инструменты ИИ для бюджетного планирования по личным финансам! Эта тщательно отобранная коллекция включает мощные, революционные решения, которые помогают проводить реальные тесты, понимать привычки расходов и создавать персонализированные планы для повышения продуктивности. Наслаждайтесь бесплатным сравнением с платными версиями вместе с подробными рейтингами. Инструменты, которые обязательно стоит попробовать, разработаны для упрощения управления деньгами и раскрытия вашего преимущества ИИ. Исследуйте сейчас!
11 инструментов
xix.ai

2026 год: лучшие и наиболее высоко оценённые помощники для отслеживания сна на основе ИИ, отобранные для максимального восстановления организма. В этом полностью обновлённом еженедельном руководстве представлены мощные инструменты с результатами реальных тестов, сравнением бесплатных и платных версий, а также подробными рейтингами, которые помогут вам найти оптимальное решение для улучшения качества сна и формирования лучших привычек перед сном. Ознакомьтесь с ним прямо сейчас на сайте XIX.AI, чтобы раскрыть потенциал ИИ в вашей жизни.
10 инструментов
xix.ai

2026: лучшие и самые популярные ИИ-помощники для работы с SQL в сфере аналитики продуктов и доходов! XIX.AI подготовила мощную, революционную подборку инструментов, которые обязательно стоит попробовать. Они проходят проверку в реальных условиях и включаются в еженедельно обновляемый рейтинг. Эти инструменты помогают пользователям значительно повысить продуктивность за счет ускорения анализа данных, оптимизации сложных запросов и получения точных аналитических выводов, которые позволяют принимать более обоснованные бизнес-решения. Ознакомьтесь с ними прямо сейчас, чтобы найти идеальный инструмент, который поможет вам раскрыть весь потенциал искусственного интеллекта!
14 инструментов
xix.ai

2026: лучшие и самые популярные помощники по домашним заданиям с ИИ, которые обучают основным концепциям, а не просто дают готовые ответы. Мощные инструменты для студентов. Обязательный к пробованию тщательно отобранный список. Еженедельное обновление. Сравнение бесплатных и платных версий. Тестирование в реальных условиях. Точные рейтинги, которые помогут вам раскрыть весь свой учебный потенциал. Исследуйте сейчас, чтобы найти идеальный инструмент для более эффективного обучения.
10 инструментов
xix.ai

Wait, so Qwen3.5 is coming with tiny models that fit on consumer GPUs? That's actually huge for people like me who don't have a server farm in their basement. 0.8B to 9B parameters – I'm curious how much performance they sacrifice for size. Is it going to run smoothly on a 3060? 🤔 Also, Tongyi Lab is really pushing the trend of small but capable models, kinda like the iPhone of LLMs – compact but powerful. Let's see if they can beat the open-source competition.












