


 집
알리바바의 Qwen 3.5, 소비자용 GPU용 소형 모델 출시
통이 랩(Tongyi Lab)은 차세대 대규모 언어 모델인 Qwen3.5 시리즈의 최신 소형 모델을 공식 출시했습니다. 이번 출시에는 0.8B, 2B, 4B, 9B 규모의 파라미터를 갖춘 4가지 버전이 포함됩니다. 이 모델들은 탁월한 성능 최적화를 통해 AI 도입의 장벽을 낮추도록 설계되어, 엣지 디바이스부터 특화 애플리케이션에 이르기까지 모든 분야에서 비용 효율적이고 효율적인 배포가 가능합니다.
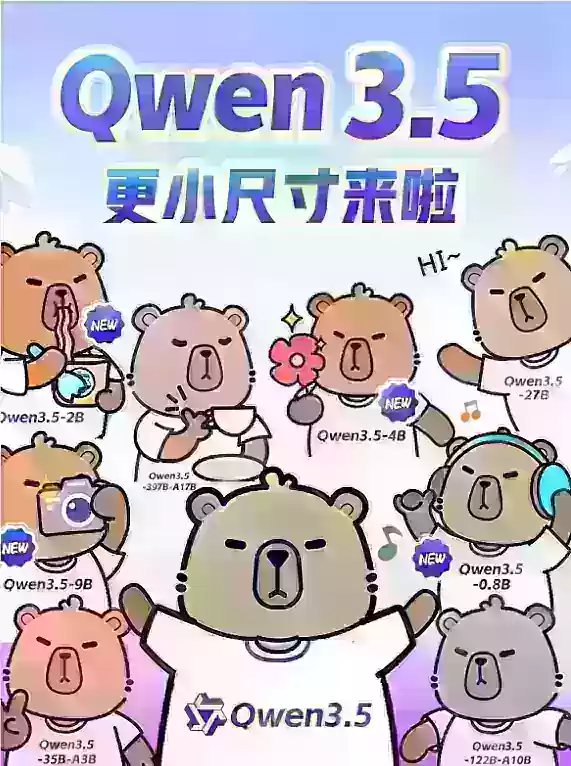
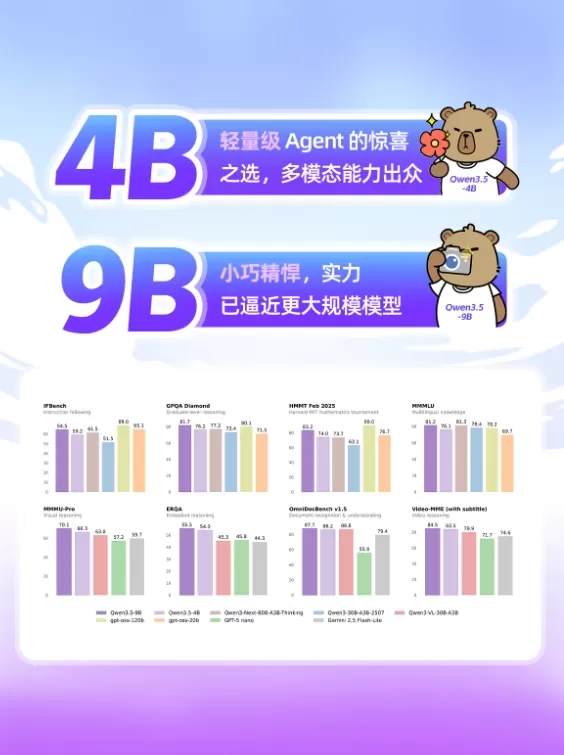
전체 시리즈는 통합된 Qwen3.5 기반 위에 구축되었습니다. 방대한 파라미터 수를 우선시하는 대형 모델과 달리, 이 소형 버전들은 "경량화"와 "높은 적응성"을 강조합니다. 0.8B 및 2B 모델은 엣지 디바이스에 최적화되어 있어, 스마트폰 및 임베디드 하드웨어와 같은 플랫폼에서 극도의 효율성과 밀리초 단위의 응답 속도를 제공합니다. 4B 버전은 다중 모달(multimodal) 처리 능력이 두드러져 경량 AI 에이전트 개발에 탁월한 선택입니다. 9B 모델은 비교적 작은 규모임에도 불구하고 훨씬 더 큰 모델에 필적하는 성능을 제공하며, 복잡한 논리적 추론을 처리할 수 있습니다.
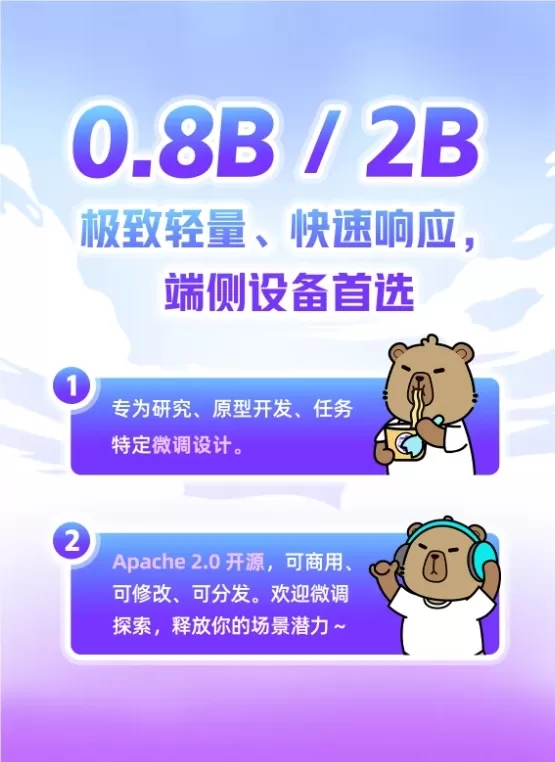
개발자 커뮤니티를 더욱 지원하기 위해 Tongyi Lab은 이 시리즈를 Apache 2.0 라이선스로 공개하여 오픈소스로 제공하고 상업적 사용도 무료로 허용했습니다. 이를 통해 개발자는 모델에 대해 LoRA 또는 완전한 미세 조정을 자유롭게 수행할 수 있으며, 일반적인 소비자용 GPU를 사용하여 특정 작업에 맞춘 적용을 시작할 수 있습니다. 이러한 접근 방식은 개인 개발자와 중소기업이 아이디어를 프로토타입으로 구현하고 특화된 애플리케이션을 구축하는 데 소요되는 시간과 비용을 크게 절감해 줍니다.
관련 기사
 Wan-Streamer v0.2는 초저지연 AI 채팅을 제공합니다
현대 기술이 빠르게 발전함에 따라 인간과 AI 간의 상호작용이 더욱 일반화되고 있습니다. 기존의 화상 통화는 종종 지연, 딜레이, 그리고 오디오-비디오 비동기화 문제를 겪습니다. 퉁이 연구소(Tongyi Lab)의 최신 릴리스인 Wan-Streamer v0.2는 이러한 과제를 완전히 극복하여, 단 550밀리초의 응답 지연으로 진정한 의미의 '대면' 소통을 가능하게 합니다.Wan-Streamer v0.2는 새로운 엔드투엔드 멀티모달 이해 및 생성
메타, TSMC와 마이크론과 협력해 구형 메모리를 탑재한 신규 서버 구축에 참여
전 세계적으로 인공지능(AI) 도입 속도가 가속화됨에 따라 차세대 DDR5 메모리에서 심각한 공급 부족 현상이 발생하고 있습니다. AI 데이터 센터 구축 지연을 피하기 위해 메타(Meta)는 TSMC와 마이크론(Micron)과 같은 업계 리더들과 협력하여 돌파구 역할을 할 혁신적인 과도기적 솔루션을 개발했습니다.이 혁신 기술은 원래 DDR5 전용으로 설계된 고급 AI 서버가 기존 DDR4 모듈과 원활하게 작동할 수 있도록 합니다. '프랑켄슈타인
시계열 데이터베이스가 실시간 로봇 데이터에 어떻게 힘을 실어주는가
타이거 데이터의 더그 파그누티.파그누티는 타이거 데이터에서 산업용 개발자 대변인 역할을 하며, 실제 산업 시스템 구축을 위한 팀을 지원합니다.석유 및 가스, 제조 자동화 분야에서 12년 이상의 경력을 가진 그는 PLC, 로봇, SCADA 시스템에서 작업한 후 델 EMC와 VTScada에서 산업용 소프트웨어 개발로 전향했습니다.그는 대규모 IIoT 배포를 위한 시계열 데이터 인프라를 다루는 자동화 엔지니어들을 도와 OT/IT 간 격차를 해소합니다
관련 특별 주제 추천
디자인과 예술
 최고의 AI 일러스트레이션 도구: 편집용 장면과 표지 아트를 더 빠르게 제작하세요
2026년 최신 최고 평점 AI 일러스트레이션 도구: 저희가 엄선한 이 목록에는 멋진 편집용 장면과 눈길을 사로잡는 표지 아트를 빠르게 제작할 수 있는, 강력하고 정교하게 설계된 최고의 도구들이 포함되어 있습니다. 각 도구는 엄격한 실전 테스트를 거쳤으며, 무료 버전과 유료 버전을 비교해 드려 여러분의 워크플로우에 딱 맞는 도구를 찾으실 수 있도록 도와드립니다. 오늘 바로 이 필수 솔루션을 사용해 AI의 장점을 극대화하고 창의적인 생산성을 높여보세요. 지금 XIX.AI에서 확인해 보세요.
 10 도구
 xix.ai
교육 및 학습
시험 준비를 위한 최고의 AI 과외 선생님: 수학, 과학, 영어 실전 연습
2026년 최신 최고 평점을 받은 최고의 시험 대비 AI 튜터들이 XIX.AI에 모였습니다! 저희가 엄선한 이 목록에는 무료와 유료 서비스 비교, 실제 시험 문제, 매주 업데이트되는 순위 정보를 제공하는 획기적인 도구들이 포함되어 있습니다. 이 도구들은 여러분의 글쓰기 효율을 높이고, 복잡한 주제 학습을 단순화하며, 학업적 잠재력을 최대한 발휘할 수 있도록 도와줍니다. 지금 바로 탐색하여 여러분에게 딱 맞는 시험 준비 도구를 찾아보세요. 오늘부터 창작을 시작하여 AI의 장점을 최대한 활용하세요!
10 도구
xix.ai
재원
개인 자금 관리를 위한 AI 예산 계획 도구
2026년 최신 최고의 평점 높은 AI 예산 관리 도구들이 XIX.AI에서 만나보세요! 이 선별된 컬렉션은 실제 테스트를 수행하고, 지출 습관을 이해하며, 생산성을 높일 수 있는 맞춤형 계획을 수립할 수 있도록 도와주는 강력한 혁신 솔루션을 제공합니다. 무료와 유료 버전을 비교하고 상세한 순위도 확인하세요. 돈 관리를 간소화하고 AI의 이점을 극대화하도록 설계된 필수 도구들을 지금 바로 탐색해 보세요!
11 도구
xix.ai
건강과 웰니스
AI 수면 추적 어시스턴트: 더 나은 취침 습관으로 회복력 향상
2026년 최신의 우수하고 평점이 높은 AI 수면 추적 보조 도구들을 엄선하여 최상의 회복 효과를 제공합니다. 완전히 새롭게 업데이트된 이 주간 가이드에는 실제 환경에서의 테스트 결과, 무료 버전과 유료 버전의 비교 내용, 그리고 상세한 순위 정보가 담겨 있어 수면의 질을 향상시키고 보다 건강한 취침 습관을 형성하는 데 도움이 되는 최적의 솔루션을 찾는 데 유용합니다. 지금 바로 XIX.AI에서 확인하여 AI 기술의 장점을 활용해 보세요.
10 도구
xix.ai
데이터 분석
제품 및 매출 분석을 위한 AI SQL 코파일럿
2026년 제품 및 매출 분석을 위한 최신 최고 평점 AI SQL 코파일럿! XIX.AI는 매주 업데이트되는 랭킹을 통해 실제 환경에서 검증된, 강력하고 판도를 바꿀 만한 필수 도구를 엄선했습니다. 이 도구들은 데이터 분석 속도를 높이고, 복잡한 쿼리를 간소화하며, 정확한 인사이트를 도출하여 더 현명한 비즈니스 의사결정을 내릴 수 있도록 지원함으로써 사용자의 생산성을 획기적으로 향상시킵니다. 지금 바로 살펴보고, 여러분의 AI 경쟁력을 극대화할 완벽한 도구를 찾아보세요!
14 도구
xix.ai
교육 및 학습
배움을 돕는 최고의 AI 숙제 도우미: 단순한 정답이 아닌 개념을 익히세요
2026년 최신 최고 평점을 받은 AI 숙제 도우미: 단순한 정답 제공이 아닌 핵심 개념을 가르쳐 주는 학생들을 위한 강력한 도구. 꼭 사용해 봐야 할 엄선된 목록, 매주 업데이트, 무료 vs 유료 비교, 실제 사용 후기, 정확한 순위 정보를 통해 여러분의 학습 잠재력을 최대한 발휘할 수 있도록 도와드립니다. 지금 바로 살펴보고 더 스마트한 공부를 위한 완벽한 도구를 찾아보세요.
10 도구
xix.ai

 의견 (1)
0/500
![GeorgeCarter]()
Wait, so Qwen3.5 is coming with tiny models that fit on consumer GPUs? That's actually huge for people like me who don't have a server farm in their basement. 0.8B to 9B parameters – I'm curious how much performance they sacrifice for size. Is it going to run smoothly on a 3060? 🤔 Also, Tongyi Lab is really pushing the trend of small but capable models, kinda like the iPhone of LLMs – compact but powerful. Let's see if they can beat the open-source competition.
통이 랩(Tongyi Lab)은 차세대 대규모 언어 모델인 Qwen3.5 시리즈의 최신 소형 모델을 공식 출시했습니다. 이번 출시에는 0.8B, 2B, 4B, 9B 규모의 파라미터를 갖춘 4가지 버전이 포함됩니다. 이 모델들은 탁월한 성능 최적화를 통해 AI 도입의 장벽을 낮추도록 설계되어, 엣지 디바이스부터 특화 애플리케이션에 이르기까지 모든 분야에서 비용 효율적이고 효율적인 배포가 가능합니다.
전체 시리즈는 통합된 Qwen3.5 기반 위에 구축되었습니다. 방대한 파라미터 수를 우선시하는 대형 모델과 달리, 이 소형 버전들은 "경량화"와 "높은 적응성"을 강조합니다. 0.8B 및 2B 모델은 엣지 디바이스에 최적화되어 있어, 스마트폰 및 임베디드 하드웨어와 같은 플랫폼에서 극도의 효율성과 밀리초 단위의 응답 속도를 제공합니다. 4B 버전은 다중 모달(multimodal) 처리 능력이 두드러져 경량 AI 에이전트 개발에 탁월한 선택입니다. 9B 모델은 비교적 작은 규모임에도 불구하고 훨씬 더 큰 모델에 필적하는 성능을 제공하며, 복잡한 논리적 추론을 처리할 수 있습니다.
개발자 커뮤니티를 더욱 지원하기 위해 Tongyi Lab은 이 시리즈를 Apache 2.0 라이선스로 공개하여 오픈소스로 제공하고 상업적 사용도 무료로 허용했습니다. 이를 통해 개발자는 모델에 대해 LoRA 또는 완전한 미세 조정을 자유롭게 수행할 수 있으며, 일반적인 소비자용 GPU를 사용하여 특정 작업에 맞춘 적용을 시작할 수 있습니다. 이러한 접근 방식은 개인 개발자와 중소기업이 아이디어를 프로토타입으로 구현하고 특화된 애플리케이션을 구축하는 데 소요되는 시간과 비용을 크게 절감해 줍니다.








 Wan-Streamer v0.2는 초저지연 AI 채팅을 제공합니다
현대 기술이 빠르게 발전함에 따라 인간과 AI 간의 상호작용이 더욱 일반화되고 있습니다. 기존의 화상 통화는 종종 지연, 딜레이, 그리고 오디오-비디오 비동기화 문제를 겪습니다. 퉁이 연구소(Tongyi Lab)의 최신 릴리스인 Wan-Streamer v0.2는 이러한 과제를 완전히 극복하여, 단 550밀리초의 응답 지연으로 진정한 의미의 '대면' 소통을 가능하게 합니다.Wan-Streamer v0.2는 새로운 엔드투엔드 멀티모달 이해 및 생성
 메타, TSMC와 마이크론과 협력해 구형 메모리를 탑재한 신규 서버 구축에 참여
전 세계적으로 인공지능(AI) 도입 속도가 가속화됨에 따라 차세대 DDR5 메모리에서 심각한 공급 부족 현상이 발생하고 있습니다. AI 데이터 센터 구축 지연을 피하기 위해 메타(Meta)는 TSMC와 마이크론(Micron)과 같은 업계 리더들과 협력하여 돌파구 역할을 할 혁신적인 과도기적 솔루션을 개발했습니다.이 혁신 기술은 원래 DDR5 전용으로 설계된 고급 AI 서버가 기존 DDR4 모듈과 원활하게 작동할 수 있도록 합니다. '프랑켄슈타인
 시계열 데이터베이스가 실시간 로봇 데이터에 어떻게 힘을 실어주는가
타이거 데이터의 더그 파그누티.파그누티는 타이거 데이터에서 산업용 개발자 대변인 역할을 하며, 실제 산업 시스템 구축을 위한 팀을 지원합니다.석유 및 가스, 제조 자동화 분야에서 12년 이상의 경력을 가진 그는 PLC, 로봇, SCADA 시스템에서 작업한 후 델 EMC와 VTScada에서 산업용 소프트웨어 개발로 전향했습니다.그는 대규모 IIoT 배포를 위한 시계열 데이터 인프라를 다루는 자동화 엔지니어들을 도와 OT/IT 간 격차를 해소합니다

2026년 최신 최고 평점 AI 일러스트레이션 도구: 저희가 엄선한 이 목록에는 멋진 편집용 장면과 눈길을 사로잡는 표지 아트를 빠르게 제작할 수 있는, 강력하고 정교하게 설계된 최고의 도구들이 포함되어 있습니다. 각 도구는 엄격한 실전 테스트를 거쳤으며, 무료 버전과 유료 버전을 비교해 드려 여러분의 워크플로우에 딱 맞는 도구를 찾으실 수 있도록 도와드립니다. 오늘 바로 이 필수 솔루션을 사용해 AI의 장점을 극대화하고 창의적인 생산성을 높여보세요. 지금 XIX.AI에서 확인해 보세요.
10 도구
xix.ai

2026년 최신 최고 평점을 받은 최고의 시험 대비 AI 튜터들이 XIX.AI에 모였습니다! 저희가 엄선한 이 목록에는 무료와 유료 서비스 비교, 실제 시험 문제, 매주 업데이트되는 순위 정보를 제공하는 획기적인 도구들이 포함되어 있습니다. 이 도구들은 여러분의 글쓰기 효율을 높이고, 복잡한 주제 학습을 단순화하며, 학업적 잠재력을 최대한 발휘할 수 있도록 도와줍니다. 지금 바로 탐색하여 여러분에게 딱 맞는 시험 준비 도구를 찾아보세요. 오늘부터 창작을 시작하여 AI의 장점을 최대한 활용하세요!
10 도구
xix.ai

2026년 최신 최고의 평점 높은 AI 예산 관리 도구들이 XIX.AI에서 만나보세요! 이 선별된 컬렉션은 실제 테스트를 수행하고, 지출 습관을 이해하며, 생산성을 높일 수 있는 맞춤형 계획을 수립할 수 있도록 도와주는 강력한 혁신 솔루션을 제공합니다. 무료와 유료 버전을 비교하고 상세한 순위도 확인하세요. 돈 관리를 간소화하고 AI의 이점을 극대화하도록 설계된 필수 도구들을 지금 바로 탐색해 보세요!
11 도구
xix.ai

2026년 최신의 우수하고 평점이 높은 AI 수면 추적 보조 도구들을 엄선하여 최상의 회복 효과를 제공합니다. 완전히 새롭게 업데이트된 이 주간 가이드에는 실제 환경에서의 테스트 결과, 무료 버전과 유료 버전의 비교 내용, 그리고 상세한 순위 정보가 담겨 있어 수면의 질을 향상시키고 보다 건강한 취침 습관을 형성하는 데 도움이 되는 최적의 솔루션을 찾는 데 유용합니다. 지금 바로 XIX.AI에서 확인하여 AI 기술의 장점을 활용해 보세요.
10 도구
xix.ai

2026년 제품 및 매출 분석을 위한 최신 최고 평점 AI SQL 코파일럿! XIX.AI는 매주 업데이트되는 랭킹을 통해 실제 환경에서 검증된, 강력하고 판도를 바꿀 만한 필수 도구를 엄선했습니다. 이 도구들은 데이터 분석 속도를 높이고, 복잡한 쿼리를 간소화하며, 정확한 인사이트를 도출하여 더 현명한 비즈니스 의사결정을 내릴 수 있도록 지원함으로써 사용자의 생산성을 획기적으로 향상시킵니다. 지금 바로 살펴보고, 여러분의 AI 경쟁력을 극대화할 완벽한 도구를 찾아보세요!
14 도구
xix.ai

2026년 최신 최고 평점을 받은 AI 숙제 도우미: 단순한 정답 제공이 아닌 핵심 개념을 가르쳐 주는 학생들을 위한 강력한 도구. 꼭 사용해 봐야 할 엄선된 목록, 매주 업데이트, 무료 vs 유료 비교, 실제 사용 후기, 정확한 순위 정보를 통해 여러분의 학습 잠재력을 최대한 발휘할 수 있도록 도와드립니다. 지금 바로 살펴보고 더 스마트한 공부를 위한 완벽한 도구를 찾아보세요.
10 도구
xix.ai

Wait, so Qwen3.5 is coming with tiny models that fit on consumer GPUs? That's actually huge for people like me who don't have a server farm in their basement. 0.8B to 9B parameters – I'm curious how much performance they sacrifice for size. Is it going to run smoothly on a 3060? 🤔 Also, Tongyi Lab is really pushing the trend of small but capable models, kinda like the iPhone of LLMs – compact but powerful. Let's see if they can beat the open-source competition.












