


 Lar
O Qwen3.5 da Alibaba lança modelos compactos para GPUs de consumo
O Tongyi Lab lançou oficialmente os mais recentes modelos de pequena escala da sua série Qwen3.5, que representam uma nova geração de modelos de linguagem de grande porte. O lançamento inclui quatro versões com tamanhos de parâmetros de 0,8B, 2B, 4B e 9B. Esses modelos foram projetados para reduzir as barreiras à implementação de IA, oferecendo uma otimização de desempenho excepcional, o que permite uma implantação econômica e eficiente em tudo, desde dispositivos de ponta até aplicações especializadas.
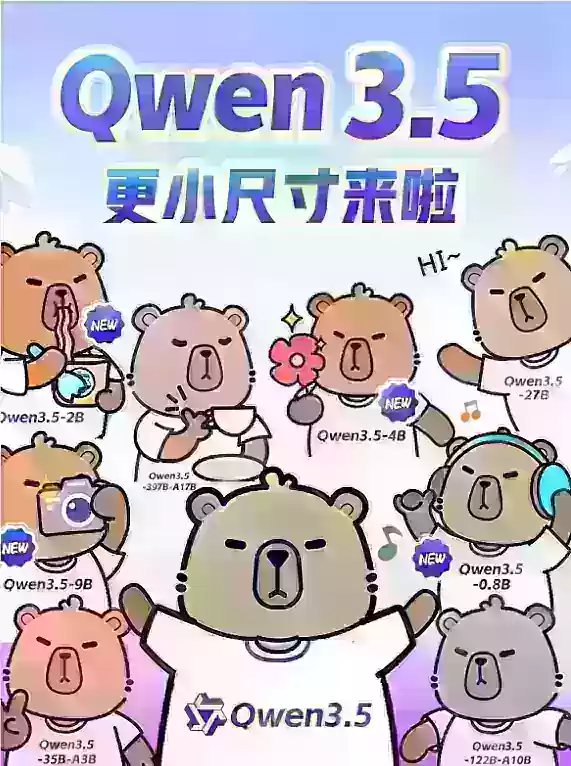
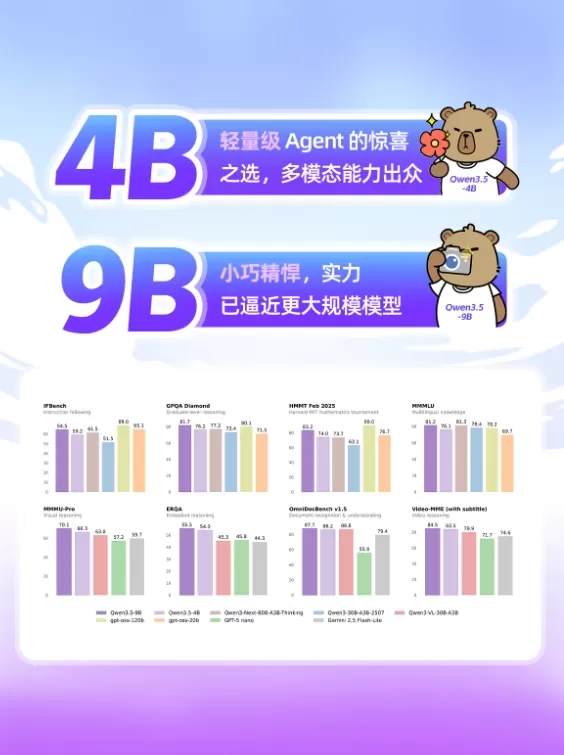
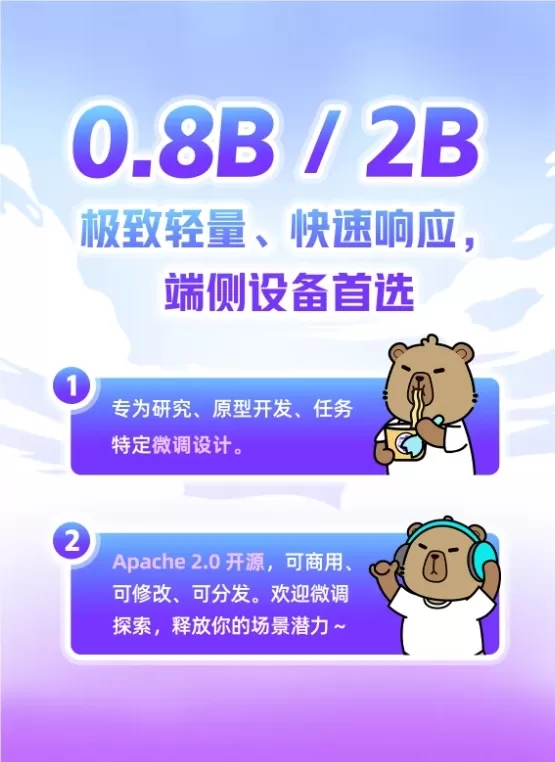
Toda a série é construída sobre uma base unificada do Qwen3.5. Ao contrário de modelos maiores que priorizam contagens massivas de parâmetros, essas versões compactas enfatizam ser “leves” e “altamente adaptáveis”. Os modelos de 0,8B e 2B são adaptados para dispositivos de borda, permitindo extrema eficiência e tempos de resposta na ordem de milissegundos em plataformas como smartphones e hardware embarcado. A versão de 4B se destaca por suas capacidades multimodais, tornando-a uma excelente escolha para o desenvolvimento de agentes de IA leves. Apesar de seu tamanho modesto, o modelo de 9B oferece desempenho comparável a contrapartes muito maiores e é capaz de lidar com raciocínio lógico complexo.
Em uma iniciativa para apoiar ainda mais a comunidade de desenvolvedores, o Tongyi Lab lançou a série sob a licença Apache 2.0, tornando-a de código aberto e gratuita para uso comercial. Isso permite que os desenvolvedores realizem livremente o LoRA ou o ajuste fino completo dos modelos, com a capacidade de iniciar adaptações específicas para tarefas usando GPUs comuns de nível de consumidor. Essa abordagem reduz significativamente o tempo e as despesas para desenvolvedores individuais e pequenas e médias empresas na criação de protótipos de ideias e na construção de aplicativos especializados.
Artigo relacionado
 Stripe vai adquirir a OpenRouter à medida que o roteamento baseado em modelos de IA ganha força
A Stripe concordou em adquirir a OpenRouter, uma plataforma de roteamento de modelos de IA que oferece aos desenvolvedores acesso a centenas de modelos por meio de uma única interface. O acordo amplia
O ex-pesquisador da OpenAI, Barrett Zoph, retorna ao Google para apoiar o desenvolvimento do Gemini
Barret Zoph, que anteriormente havia deixado a empresa de forma repentina e se juntado à OpenAI devido a um desentendimento com a CEO da Thinking Machines Lab, Miriam Mularati, mudou de emprego mais u
Como a Recursive Intelligence levantou US$ 335 milhões com uma avaliação de US$ 4 bilhões em 4 meses
As cofundadoras da startup Ricursive Intelligence pareciam destinadas a serem cofundadoras.Anna Goldie, CEO, e Azalia Mirhoseini, CTO, são tão conhecidas na comunidade de IA que estavam entre os engen
Recomendações de tópicos especiais relacionados
Design e Arte
 As melhores ferramentas de ilustração com IA: crie cenas editoriais e capas de forma mais rápida
As melhores ferramentas de ilustração com IA de 2026: nossa lista selecionada apresenta as melhores ferramentas, com design robusto, para criar rapidamente cenas editoriais impressionantes e capas atraentes. Cada opção passou por rigorosos testes práticos, oferecendo uma comparação entre versões gratuitas e pagas para ajudar você a encontrar a opção perfeita para o seu fluxo de trabalho. Experimente hoje mesmo essas soluções imperdíveis para aproveitar ao máximo as vantagens da IA e impulsionar sua produtividade criativa. Explore agora no XIX.AI.
 10 ferramentas
 xix.ai
Educação e Aprendizagem
Os melhores professores particulares especializados em IA para preparação para exames: pratique matemática, ciências e inglês
Os melhores tutores de IA para preparação para exames de 2026, com as melhores avaliações, estão aqui no XIX.AI! Nossa lista cuidadosamente selecionada apresenta ferramentas poderosas e revolucionárias que oferecem comparação entre versões gratuitas e pagas, testes práticos e rankings atualizados semanalmente. Elas ajudam a aumentar sua eficiência na redação, simplificar o aprendizado de tópicos complexos e liberar seu potencial acadêmico. Explore agora para descobrir sua ferramenta perfeita de preparação para exames e comece a criar hoje mesmo para aproveitar toda a vantagem da IA!
10 ferramentas
xix.ai
Financiar
Ferramentas de planejamento orçamentário com IA para gestão financeira pessoal
As melhores e mais bem avaliadas ferramentas de planejamento orçamentário com IA para gestão financeira pessoal de 2026 estão aqui no XIX.AI! Esta seleção especial apresenta soluções poderosas e revolucionárias que ajudam você a realizar testes na prática, entender hábitos de consumo e criar planos personalizados para aumentar a produtividade. Confira uma comparação entre versões gratuitas e pagas, além de rankings detalhados. Ferramentas imperdíveis, projetadas para simplificar a gestão financeira e explorar o potencial da IA. Explore agora!
11 ferramentas
xix.ai
Saúde e Bem-Estar
Assistentes de rastreamento do sono com IA: melhore sua recuperação adotando hábitos mais adequados antes de dormir
2026 – Os melhores assistentes de rastreamento do sono com inteligência artificial mais bem avaliados, selecionados para proporcionar uma recuperação máxima. Este guia semanal completamente atualizado apresenta ferramentas poderosas que incluem testes reais, comparações entre versões gratuitas e pagas, além de classificações detalhadas, visando ajudá-lo a encontrar a solução ideal para melhorar a qualidade do sono e fomentar hábitos noturnos mais saudáveis. Explore agora em XIX.AI e aproveite todas as vantagens oferecidas pela inteligência artificial.
10 ferramentas
xix.ai
Análise de dados
Copilotos de IA em SQL para análise de produtos e receitas
2026: Os melhores e mais bem avaliados copilotos de IA para SQL em análise de produtos e receitas! A XIX.AI selecionou um conjunto poderoso e revolucionário de ferramentas imperdíveis, que passam por testes práticos por meio de rankings atualizados semanalmente. Essas ferramentas ajudam os usuários a aumentar significativamente a produtividade, acelerando a análise de dados, simplificando consultas complexas e gerando insights precisos para impulsionar decisões de negócios mais inteligentes. Explore agora e descubra a ferramenta perfeita para aproveitar ao máximo o potencial da IA!
14 ferramentas
xix.ai
Educação e Aprendizagem
Os melhores auxiliares de tarefas escolares com IA que ensinam: aprenda conceitos, não apenas respostas
2026: Os melhores e mais bem avaliados auxiliares de tarefas com IA que ensinam conceitos fundamentais, não apenas respostas. Ferramentas poderosas para estudantes. Lista selecionada que você não pode deixar de conferir. Atualizada semanalmente. Comparação entre versões gratuitas e pagas. Testes em situações reais. Rankings precisos para ajudar você a atingir todo o seu potencial de aprendizado. Explore agora e descubra a ferramenta perfeita para estudar de forma mais inteligente.
10 ferramentas
xix.ai

 Comentários (1)
![GeorgeCarter]()
Wait, so Qwen3.5 is coming with tiny models that fit on consumer GPUs? That's actually huge for people like me who don't have a server farm in their basement. 0.8B to 9B parameters – I'm curious how much performance they sacrifice for size. Is it going to run smoothly on a 3060? 🤔 Also, Tongyi Lab is really pushing the trend of small but capable models, kinda like the iPhone of LLMs – compact but powerful. Let's see if they can beat the open-source competition.
O Tongyi Lab lançou oficialmente os mais recentes modelos de pequena escala da sua série Qwen3.5, que representam uma nova geração de modelos de linguagem de grande porte. O lançamento inclui quatro versões com tamanhos de parâmetros de 0,8B, 2B, 4B e 9B. Esses modelos foram projetados para reduzir as barreiras à implementação de IA, oferecendo uma otimização de desempenho excepcional, o que permite uma implantação econômica e eficiente em tudo, desde dispositivos de ponta até aplicações especializadas.
Toda a série é construída sobre uma base unificada do Qwen3.5. Ao contrário de modelos maiores que priorizam contagens massivas de parâmetros, essas versões compactas enfatizam ser “leves” e “altamente adaptáveis”. Os modelos de 0,8B e 2B são adaptados para dispositivos de borda, permitindo extrema eficiência e tempos de resposta na ordem de milissegundos em plataformas como smartphones e hardware embarcado. A versão de 4B se destaca por suas capacidades multimodais, tornando-a uma excelente escolha para o desenvolvimento de agentes de IA leves. Apesar de seu tamanho modesto, o modelo de 9B oferece desempenho comparável a contrapartes muito maiores e é capaz de lidar com raciocínio lógico complexo.
Em uma iniciativa para apoiar ainda mais a comunidade de desenvolvedores, o Tongyi Lab lançou a série sob a licença Apache 2.0, tornando-a de código aberto e gratuita para uso comercial. Isso permite que os desenvolvedores realizem livremente o LoRA ou o ajuste fino completo dos modelos, com a capacidade de iniciar adaptações específicas para tarefas usando GPUs comuns de nível de consumidor. Essa abordagem reduz significativamente o tempo e as despesas para desenvolvedores individuais e pequenas e médias empresas na criação de protótipos de ideias e na construção de aplicativos especializados.








 Stripe vai adquirir a OpenRouter à medida que o roteamento baseado em modelos de IA ganha força
A Stripe concordou em adquirir a OpenRouter, uma plataforma de roteamento de modelos de IA que oferece aos desenvolvedores acesso a centenas de modelos por meio de uma única interface. O acordo amplia
 O ex-pesquisador da OpenAI, Barrett Zoph, retorna ao Google para apoiar o desenvolvimento do Gemini
Barret Zoph, que anteriormente havia deixado a empresa de forma repentina e se juntado à OpenAI devido a um desentendimento com a CEO da Thinking Machines Lab, Miriam Mularati, mudou de emprego mais u
 Como a Recursive Intelligence levantou US$ 335 milhões com uma avaliação de US$ 4 bilhões em 4 meses
As cofundadoras da startup Ricursive Intelligence pareciam destinadas a serem cofundadoras.Anna Goldie, CEO, e Azalia Mirhoseini, CTO, são tão conhecidas na comunidade de IA que estavam entre os engen

As melhores ferramentas de ilustração com IA de 2026: nossa lista selecionada apresenta as melhores ferramentas, com design robusto, para criar rapidamente cenas editoriais impressionantes e capas atraentes. Cada opção passou por rigorosos testes práticos, oferecendo uma comparação entre versões gratuitas e pagas para ajudar você a encontrar a opção perfeita para o seu fluxo de trabalho. Experimente hoje mesmo essas soluções imperdíveis para aproveitar ao máximo as vantagens da IA e impulsionar sua produtividade criativa. Explore agora no XIX.AI.
10 ferramentas
xix.ai

Os melhores tutores de IA para preparação para exames de 2026, com as melhores avaliações, estão aqui no XIX.AI! Nossa lista cuidadosamente selecionada apresenta ferramentas poderosas e revolucionárias que oferecem comparação entre versões gratuitas e pagas, testes práticos e rankings atualizados semanalmente. Elas ajudam a aumentar sua eficiência na redação, simplificar o aprendizado de tópicos complexos e liberar seu potencial acadêmico. Explore agora para descobrir sua ferramenta perfeita de preparação para exames e comece a criar hoje mesmo para aproveitar toda a vantagem da IA!
10 ferramentas
xix.ai

As melhores e mais bem avaliadas ferramentas de planejamento orçamentário com IA para gestão financeira pessoal de 2026 estão aqui no XIX.AI! Esta seleção especial apresenta soluções poderosas e revolucionárias que ajudam você a realizar testes na prática, entender hábitos de consumo e criar planos personalizados para aumentar a produtividade. Confira uma comparação entre versões gratuitas e pagas, além de rankings detalhados. Ferramentas imperdíveis, projetadas para simplificar a gestão financeira e explorar o potencial da IA. Explore agora!
11 ferramentas
xix.ai

2026 – Os melhores assistentes de rastreamento do sono com inteligência artificial mais bem avaliados, selecionados para proporcionar uma recuperação máxima. Este guia semanal completamente atualizado apresenta ferramentas poderosas que incluem testes reais, comparações entre versões gratuitas e pagas, além de classificações detalhadas, visando ajudá-lo a encontrar a solução ideal para melhorar a qualidade do sono e fomentar hábitos noturnos mais saudáveis. Explore agora em XIX.AI e aproveite todas as vantagens oferecidas pela inteligência artificial.
10 ferramentas
xix.ai

2026: Os melhores e mais bem avaliados copilotos de IA para SQL em análise de produtos e receitas! A XIX.AI selecionou um conjunto poderoso e revolucionário de ferramentas imperdíveis, que passam por testes práticos por meio de rankings atualizados semanalmente. Essas ferramentas ajudam os usuários a aumentar significativamente a produtividade, acelerando a análise de dados, simplificando consultas complexas e gerando insights precisos para impulsionar decisões de negócios mais inteligentes. Explore agora e descubra a ferramenta perfeita para aproveitar ao máximo o potencial da IA!
14 ferramentas
xix.ai

2026: Os melhores e mais bem avaliados auxiliares de tarefas com IA que ensinam conceitos fundamentais, não apenas respostas. Ferramentas poderosas para estudantes. Lista selecionada que você não pode deixar de conferir. Atualizada semanalmente. Comparação entre versões gratuitas e pagas. Testes em situações reais. Rankings precisos para ajudar você a atingir todo o seu potencial de aprendizado. Explore agora e descubra a ferramenta perfeita para estudar de forma mais inteligente.
10 ferramentas
xix.ai

Wait, so Qwen3.5 is coming with tiny models that fit on consumer GPUs? That's actually huge for people like me who don't have a server farm in their basement. 0.8B to 9B parameters – I'm curious how much performance they sacrifice for size. Is it going to run smoothly on a 3060? 🤔 Also, Tongyi Lab is really pushing the trend of small but capable models, kinda like the iPhone of LLMs – compact but powerful. Let's see if they can beat the open-source competition.












