
opção
MichaelMartinez
MichaelMartinez
14 de Abril de 2026

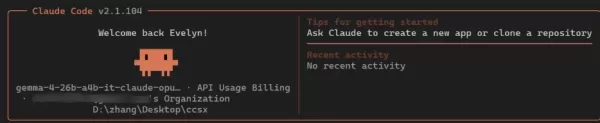
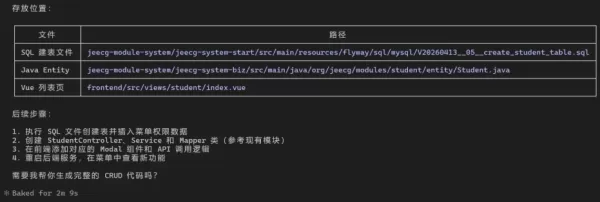
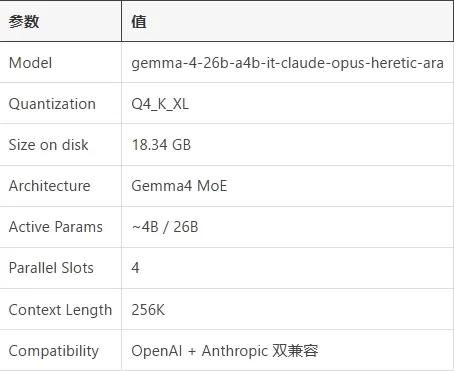
O desenvolvedor JeecgBoot testou um modelo de destilação modificado pela comunidade no Mac Studio M4Max, alcançando velocidades de geração 5 a 6 vezes mais rápidas do que a versão oficial. O modelo, que utiliza uma arquitetura A4B MoE com 26 bilhões de parâmetros no total, ativava apenas cerca de 4 bilhões por inferência, atingindo até 78 tokens por segundo e suportando 256 mil de contexto. Embora a geração seja rápida, fluxos de trabalho Agentic complexos para tarefas como geração de código podem levar cerca de 1,5 minuto devido a cadeias de decisão em várias etapas. O teste gerou com sucesso um esqueleto de projeto JeecgBoot padronizado. Recomenda-se uma estratégia de modelo duplo: usar o modelo modificado localmente para a maioria das tarefas (como CRUD) para garantir privacidade e economia de custos, e APIs na nuvem para necessidades de design complexas.
O desenvolvedor JeecgBoot testou um modelo de destilação modificado pela comunidade no Mac Studio M4Max, alcançando velocidades de geração 5 a 6 vezes mais rápidas do que a versão oficial. O modelo, que utiliza uma arquitetura A4B MoE com 26 bilhões de parâmetros no total, ativava apenas cerca de 4 bilhões por inferência, atingindo até 78 tokens por segundo e suportando 256 mil de contexto. Embora a geração seja rápida, fluxos de trabalho Agentic complexos para tarefas como geração de código podem levar cerca de 1,5 minuto devido a cadeias de decisão em várias etapas. O teste gerou com sucesso um esqueleto de projeto JeecgBoot padronizado. Recomenda-se uma estratégia de modelo duplo: usar o modelo modificado localmente para a maioria das tarefas (como CRUD) para garantir privacidade e economia de custos, e APIs na nuvem para necessidades de design complexas. O desenvolvedor JeecgBoot testou um modelo de destilação modificado pela comunidade no Mac Studio M4Max, alcançando velocidades de geração 5 a 6 vezes mais rápidas do que a versão oficial. O modelo, que utiliza uma arquitetura A4B MoE com 26 bilhões de parâmetros no total, ativava apenas cerca de 4 bilhões por inferência, atingindo até 78 tokens por segundo e suportando 256 mil de contexto. Embora a geração seja rápida, fluxos de trabalho Agentic complexos para tarefas como geração de código podem levar cerca de 1,5 minuto devido a cadeias de decisão em várias etapas. O teste gerou com sucesso um esqueleto de projeto JeecgBoot padronizado. Recomenda-se uma estratégia de modelo duplo: usar o modelo modificado localmente para a maioria das tarefas (como CRUD) para garantir privacidade e economia de custos, e APIs na nuvem para necessidades de design complexas. O desenvolvedor JeecgBoot testou um modelo de destilação modificado pela comunidade no Mac Studio M4Max, alcançando velocidades de geração 5 a 6 vezes mais rápidas do que a versão oficial. O modelo, que utiliza uma arquitetura A4B MoE com 26 bilhões de parâmetros no total, ativava apenas cerca de 4 bilhões por inferência, atingindo até 78 tokens por segundo e suportando 256 mil de contexto. Embora a geração seja rápida, fluxos de trabalho Agentic complexos para tarefas como geração de código podem levar cerca de 1,5 minuto devido a cadeias de decisão em várias etapas. O teste gerou com sucesso um esqueleto de projeto JeecgBoot padronizado. Recomenda-se uma estratégia de modelo duplo: usar o modelo modificado localmente para a maioria das tarefas (como CRUD) para garantir privacidade e economia de custos, e APIs na nuvem para necessidades de design complexas.
Comentários (0)
0/300
OR