


 집
Claude 3.5 Sonnet은 Chatgpt가 지배하는 AI 코딩 테스트에서 창의적으로 투쟁
Anthropic의 새로운 Claude 3.5 Sonnet의 기능 테스트
지난주, Anthropic으로부터 Claude 3.5 Sonnet 출시를 알리는 이메일을 받았다. 그들은 이 모델이 "지능 면에서 업계 표준을 높이며, 다양한 평가에서 경쟁 모델과 Claude 3 Opus를 능가한다"고 자랑했다. 또한 복잡한 작업, 특히 코드 생성에 완벽하다고 주장했다. 당연히 이 주장을 테스트해봐야 했다.
나는 여러 AI에 대해 일련의 코딩 테스트를 진행했으며, 당신도 할 수 있다. AI 챗봇의 코딩 능력을 테스트하는 방법 - 당신도 할 수 있다에서 모든 세부 정보를 확인할 수 있다. Claude 3.5 Sonnet이 나의 표준 테스트에서 어떻게 수행했는지, 그리고 Microsoft Copilot, Meta AI, Meta Code Llama, Google Gemini Advanced, ChatGPT와 비교해 어떻게 평가되는지 살펴보자.
1. WordPress 플러그인 작성
처음에 Claude 3.5 Sonnet은 큰 가능성을 보여줬다. 생성한 사용자 인터페이스는 깔끔한 레이아웃으로, 내가 테스트한 AI 중 처음으로 데이터 필드를 나란히 배치했다.
 David Gewirtz/ZDNET의 스크린샷
내 주의를 끈 것은 Claude가 코드 생성에 접근한 방식이었다. PHP, JavaScript, CSS 파일을 별도로 제공하는 대신, JavaScript와 CSS 파일을 플러그인 디렉토리에 자동 생성하는 단일 PHP 파일을 제공했다. 이 혁신적인 접근은 플러그인이 자체 폴더에 쓰기를 허용하는 OS 설정에 의존하기 때문에 위험하다—프로덕션 환경에서는 심각한 보안 결함이다.
불행히도, 창의적인 솔루션에도 불구하고 플러그인은 작동하지 않았다. "Randomize" 버튼은 아무 기능도 하지 않아 초기 약속에 비해 실망스러웠다.
이전 테스트와 비교한 종합 결과는 다음과 같다:
- Claude 3.5 Sonnet: 인터페이스: 좋음, 기능: 실패
- ChatGPT GPT-4o: 인터페이스: 좋음, 기능: 좋음
- Microsoft Copilot: 인터페이스: 적절, 기능: 실패
- Meta AI: 인터페이스: 적절, 기능: 실패
- Meta Code Llama: 완전 실패
- Google Gemini Advanced: 인터페이스: 좋음, 기능: 실패
- ChatGPT 4: 인터페이스: 좋음, 기능: 좋음
- ChatGPT 3.5: 인터페이스: 좋음, 기능: 좋음
2. 문자열 함수 재작성
이 테스트는 AI가 달러와 센트 변환을 위해 코드를 특정 요구사항에 맞게 재작성하는 능력을 평가한다. Claude 3.5 Sonnet은 선행 0 제거, 정수와 소수 처리, 음수 값 방지를 잘 수행했다. 또한 예기치 않은 입력에 대해 "0"을 반환해 오류를 방지했다.
하지만 ".50"과 같은 50센트 입력을 허용하지 않아 요구사항을 충족하지 못했다. 이는 수정된 코드가 실제 시나리오에서 작동하지 않는다는 의미로, 실패로 평가해야 한다.
종합 결과는 다음과 같다:
- Claude 3.5 Sonnet: 실패
- ChatGPT GPT-4o: 성공
- Microsoft Copilot: 실패
- Meta AI: 실패
- Meta Code Llama: 성공
- Google Gemini Advanced: 실패
- ChatGPT 4: 성공
- ChatGPT 3.5: 성공
3. 성가신 버그 찾기
이 테스트는 AI가 특정 WordPress 지식이 필요한 미묘한 버그를 찾아내는 능력을 요구하기 때문에 까다롭다. 처음에는 나도 놓쳤던 버그로, ChatGPT의 도움을 받아 해결했다.
Claude 3.5 Sonnet은 버그를 찾아 수정했을 뿐만 아니라, 게시 과정에서 발생한 오류를 발견해 내가 수정할 수 있게 했다. 이는 전체 테스트를 게시한 이후 내가 테스트한 AI 중 처음이었다.
종합 결과는 다음과 같다:
- Claude 3.5 Sonnet: 성공
- ChatGPT GPT-4o: 성공
- Microsoft Copilot: 실패. 화려하게. 열정적으로. 이모지로.
- Meta AI: 성공
- Meta Code Llama: 실패
- Google Gemini Advanced: 실패
- ChatGPT 4: 성공
- ChatGPT 3.5: 성공
지금까지 Claude 3.5 Sonnet은 세 가지 테스트 중 두 가지에서 실패했다. 마지막 테스트에서 어떻게 수행하는지 보자.
4. 스크립트 작성
이 테스트는 AppleScript와 Keyboard Maestro 같은 특수 프로그래밍 도구에 대한 AI의 지식을 확인한다. ChatGPT는 두 가지에서 능숙함을 보여줬지만, Claude 3.5 Sonnet은 그렇지 못했다. Chrome과 상호작용하려는 AppleScript를 작성했지만 Keyboard Maestro 구성 요소를 완전히 무시했다.
또한, AppleScript에 구문 오류가 있었다. 대소문자를 구분하지 않도록 하려다 런타임 오류를 일으키는 코드를 생성했다:
if theTab's title contains input ignoring case then
"contains" 문은 이미 대소문자를 구분하지 않으며, "ignoring case" 구문이 잘못 배치되어 오류가 발생했다.
종합 결과는 다음과 같다:
- Claude 3.5 Sonnet: 실패
- ChatGPT GPT-4o: 성공했으나 약간의 우려가 있음
- Microsoft Copilot: 실패
- Meta AI: 실패
- Meta Code Llama: 실패
- Google Gemini Advanced: 성공
- ChatGPT 4: 성공
- ChatGPT 3.5: 실패
전체 결과
Claude 3.5 Sonnet의 전체 성과는 다른 AI와 비교해 다음과 같다:
- Claude 3.5 Sonnet: 4개 중 1개 성공
- ChatGPT GPT-4o: 4개 중 4개 성공, 단 하나는 이상한 이중 선택 답변
- Microsoft Copilot: 4개 중 0개 성공
- Meta AI: 4개 중 1개 성공
- Meta Code Llama: 4개 중 1개 성공
- Google Gemini Advanced: 4개 중 1개 성공
- ChatGPT 4: 4개 중 4개 성공
- ChatGPT 3.5: 4개 중 3개 성공
Claude 3.5 Sonnet에 꽤 실망했다. Anthropic은 프로그래밍에 적합하다고 약속했지만, 기대를 충족하지 못했다. 프로그래밍을 못하는 것은 아니지만, 정확하게 프로그래밍하지 못한다. 나는 ChatGPT를 능가하는 AI를 찾고 싶었지만, 현재로서는 프로그래밍 도움으로 ChatGPT를 고수할 것이며, 당신도 그렇게 하기를 추천한다.
당신은 프로그래밍에 AI를 사용해봤나? 어떤 AI를 사용했으며, 어땠나? 아래 댓글에서 경험을 공유해 달라.
소셜 미디어에서 내 프로젝트 업데이트를 팔로우하고, 주간 뉴스레터를 구독하며, Twitter/X에서 @DavidGewirtz, Facebook에서 Facebook.com/DavidGewirtz, Instagram에서 Instagram.com/DavidGewirtz, YouTube에서 YouTube.com/DavidGewirtzTV로 나와 연결하라.
관련 기사
 플로리다주, 폭력 사건을 이유로 오픈AI와 샘 알트만을 상대로 소송 제기
플로리다주 검찰총장은 월요일 오픈AI와 샘 알트만 CEO를 상대로 주 차원의 첫 번째 소송을 제기하며, 회사의 ChatGPT가 여러 건의 폭력 사건과 연관되어 있다고 주장했습니다.소장은 오픈AI가 안전 문제를 무시한 채 ‘AI 군비경쟁’에서 승리하고 막대한 부를 축적하는 데 우선순위를 두었다고 주장합니다.“오늘 우리는 오픈AI와 그 CEO인 샘 알트만을 상대로 전국에서 처음으로 주 차원의 소송을 제기했다고 발표했습니다,”라고 플로리다주 검찰
OpenAI, 더욱 자연스러운 실시간 대화를 위한 첨단 음성 모델 공개
OpenAI는 더 자연스러운 음성을 제공하고 대화 순서를 보다 효과적으로 관리하도록 설계된 새로운 대화형 모델인 GPT-Live-1과 GPT-Live-1 mini를 출시했습니다. 이 전이중(full-duplex) 모델은 말하고 듣는 작업을 동시에 수행할 수 있어, 사용자가 자연스럽게 말을 끊을 수 있을 뿐만 아니라 실시간 번역과 같은 기능도 지원합니다.또한
OpenAI, 자사 모델 제품군의 최신 버전인 GPT-5.6을 공개했습니다
오픈AI는 목요일 최신 모델 제품군을 출시하며, 경쟁이 점점 치열해지는 AI 시장에 강력한 새로운 선택지를 선보였다.GPT-5.6은 Sol(주력 모델로 설계됨), Terra(중간급 옵션), Luna(가성비 좋은 선택지)의 세 가지 버전으로 제공된다. 이 모델들은 다양한 분야에서 기능을 확장하며, 회사는 기업 업무, 코딩, 과학 연구 분야에서 뛰어난 성능을
관련 특별 주제 추천
디자인과 예술
 창의적인 실험을 위한 최고의 AI 스타일 변환 도구
2026년 최신, 최고 평점을 받은 창의적 실험을 위한 AI 스타일 변환 도구! XIX.AI는 실제 테스트와 엄격한 평가를 통해 탁월한 결과를 보여주는, 강력하고 판도를 바꿀 만한 ‘꼭 사용해 봐야 할’ 도구들을 엄선했습니다. 이 최고의 솔루션들은 콘텐츠 제작 속도를 높이고 무한한 창의적 가능성을 열어줌으로써 크리에이터들의 생산성을 크게 높여줍니다. 지금 바로 탐색하여 나에게 딱 맞는 도구를 찾아보고, 오늘 바로 창작을 시작해 보세요!
 9 도구
 xix.ai
만화 창작
시각적 스토리텔링을 위한 최고의 AI 대화 풍선 도구
2026년 시각적 스토리텔링을 위한 최신 최고 평점의 AI 대화 풍선 도구가 XIX.AI에 소개됩니다! 이 엄선된 모음집에는 크리에이터들이 생산성을 높이고 창의적인 난관을 극복하는 데 도움을 주는, 강력하고 획기적인 도구들이 포함되어 있습니다. 무료 버전과 유료 버전의 비교 정보를 확인하고, 실제 테스트 결과를 살펴보며, 최신 순위를 통해 매력적인 시각적 이야기를 만드는 데 꼭 필요한 솔루션을 찾아보세요. 지금 바로 탐색하여 여러분에게 딱 맞는 도구를 발견해 보세요!
10 도구
xix.ai
회의 도우미
최고의 AI 회의 요약 도구: 의사 결정 사항과 후속 조치를 명확하게 추적하세요
2026년 최신 최고 평점을 받은 최고의 AI 회의 요약 도구로, 명확한 의사 결정 추적과 손쉬운 후속 조치를 실현하세요. 이 엄선된 목록은 회의록 자동화, 핵심 실행 과제 파악, 모든 프로젝트에 걸친 팀 협업 효율화를 통해 생산성을 획기적으로 높여주는 강력하고 혁신적인 솔루션을 소개합니다. 무료 버전과 유료 버전의 비교 정보, 실제 사용 후기, 매주 업데이트되는 순위 정보를 통해 여러분에게 딱 맞는 도구를 찾아보세요. 지금 바로 살펴보고 AI의 힘을 경험해 보세요!
9 도구
xix.ai
데이터 분석
최고의 AI 데이터 정제 도구: 누락된 값과 중복 데이터를 신속하게 수정하기
2026년 최신의 우수하고 높은 평가를 받는 AI 데이터 정제 도구들로, 누락된 값과 중복 데이터를 신속하게 수정할 수 있습니다. 이 선별된 목록에는 생산성을 획기적으로 향상시켜 주는 강력한 솔루션이 포함되어 있습니다. 각 도구는 신뢰성을 보장하기 위해 엄격한 실제 환경 테스트를 거쳤습니다. 무료 버전과 유료 버전의 비교 정보를 확인하고, 귀하의 요구사항에 가장 적합한 도구를 발견해 보세요. 지금 바로 XIX.AI에서 자세히 알아보시고 AI 분야에서의 경쟁 우위를 확보하세요.
11 도구
xix.ai
디자인과 예술
아티스트를 위한 최고의 AI 창의적 아이디어 도구: 시각적 블록을 돌파하라
2026년 최신 최고 인기 AI 창의적 아이디어 도구들은 XIX.AI가 선별한 것으로, 창작자들이 시각적 장벽을 돌파하고 즉각적으로 창의성을 높일 수 있도록 지원합니다. 이러한 강력한 혁신적 도구들은 실제 테스트 결과, 무료와 유료 버전의 상세 비교, 그리고 매주 업데이트되는 순위표를 제공합니다. 콘텐츠 제작을 가속화하고 AI 경쟁력을 발휘할 수 있는 완벽한 도구를 발견하세요. 지금 바로 탐색하세요!
14 도구
xix.ai
음악 작곡
틱톡 배경 음악, 릴스 오디오, 크리에이터 홍보용 음악을 위한 AI 비트 메이커
2026년 틱톡 배경 음악, 릴스 오디오, 크리에이터 홍보용 음악을 위한 최신 최고의 AI 비트 메이커! XIX.AI는 모든 콘텐츠 요구 사항에 맞는 완벽한 음악을 제공하기 위해 실제 테스트를 거친, 업계에 혁신을 일으킬 만한 강력한 도구들의 최고 평점 목록을 엄선했습니다. 창의성과 생산성을 높이는 데 도움이 될 상세한 무료 vs 유료 비교 자료, 매주 업데이트되는 순위, 그리고 꼭 시도해 봐야 할 추천 옵션을 확인하실 수 있습니다. 지금 바로 탐색하여 여러분에게 딱 맞는 도구를 찾아보세요!
11 도구
xix.ai

 의견 (11)
0/500
![CharlesYoung]()
Intéressant de voir Claude 3.5 Sonnet avoir du mal avec le codage créatif. Est-ce qu'on attend trop des IA actuellement ? Après tout, l'intelligence humaine reste unique 🤷♂️
![ScottMitchell]()
Claude 3.5 Sonnet is pretty good, but it's no match for ChatGPT in coding tests. It's like bringing a knife to a gunfight! 😂 Still, it's an improvement over the last version, so kudos to Anthropic for trying to keep up. Maybe next time, they'll surprise us!
![JamesMiller]()
Claude 3.5 Sonnet é bom, mas não chega aos pés do ChatGPT em testes de codificação. É como levar uma faca para uma batalha de armas! 😂 Ainda assim, é uma melhoria em relação à versão anterior, então parabéns à Anthropic por tentar acompanhar. Talvez da próxima vez eles nos surpreendam!
![StevenNelson]()
クロード3.5ソネットはコードテストではChatGPTにかなわないですね。まるでナイフを持って銃撃戦に挑むようなものです!😂 でも、前バージョンよりは改善されているので、アントロピックの努力には敬意を表します。次回は驚かせてくれるかも?
![JoseDavis]()
Claude 3.5 Sonnet qui galère en codage, c’est un peu décevant vu les promesses d’Anthropic. 😐 ChatGPT garde l’avantage, mais la course à l’IA est fascinante !
![HaroldLopez]()
클로드 3.5 소넷은 코드 테스트에서 ChatGPT에 비해 많이 부족해요. 마치 칼을 들고 총격전에 나서는 느낌이죠! 😂 그래도 이전 버전보다는 나아졌으니, 앤트로픽의 노력에 박수를 보냅니다. 다음에는 놀라게 해줄지 모르겠네요!
Anthropic의 새로운 Claude 3.5 Sonnet의 기능 테스트
지난주, Anthropic으로부터 Claude 3.5 Sonnet 출시를 알리는 이메일을 받았다. 그들은 이 모델이 "지능 면에서 업계 표준을 높이며, 다양한 평가에서 경쟁 모델과 Claude 3 Opus를 능가한다"고 자랑했다. 또한 복잡한 작업, 특히 코드 생성에 완벽하다고 주장했다. 당연히 이 주장을 테스트해봐야 했다.
나는 여러 AI에 대해 일련의 코딩 테스트를 진행했으며, 당신도 할 수 있다. AI 챗봇의 코딩 능력을 테스트하는 방법 - 당신도 할 수 있다에서 모든 세부 정보를 확인할 수 있다. Claude 3.5 Sonnet이 나의 표준 테스트에서 어떻게 수행했는지, 그리고 Microsoft Copilot, Meta AI, Meta Code Llama, Google Gemini Advanced, ChatGPT와 비교해 어떻게 평가되는지 살펴보자.
1. WordPress 플러그인 작성
처음에 Claude 3.5 Sonnet은 큰 가능성을 보여줬다. 생성한 사용자 인터페이스는 깔끔한 레이아웃으로, 내가 테스트한 AI 중 처음으로 데이터 필드를 나란히 배치했다.
내 주의를 끈 것은 Claude가 코드 생성에 접근한 방식이었다. PHP, JavaScript, CSS 파일을 별도로 제공하는 대신, JavaScript와 CSS 파일을 플러그인 디렉토리에 자동 생성하는 단일 PHP 파일을 제공했다. 이 혁신적인 접근은 플러그인이 자체 폴더에 쓰기를 허용하는 OS 설정에 의존하기 때문에 위험하다—프로덕션 환경에서는 심각한 보안 결함이다.
불행히도, 창의적인 솔루션에도 불구하고 플러그인은 작동하지 않았다. "Randomize" 버튼은 아무 기능도 하지 않아 초기 약속에 비해 실망스러웠다.
이전 테스트와 비교한 종합 결과는 다음과 같다:
- Claude 3.5 Sonnet: 인터페이스: 좋음, 기능: 실패
- ChatGPT GPT-4o: 인터페이스: 좋음, 기능: 좋음
- Microsoft Copilot: 인터페이스: 적절, 기능: 실패
- Meta AI: 인터페이스: 적절, 기능: 실패
- Meta Code Llama: 완전 실패
- Google Gemini Advanced: 인터페이스: 좋음, 기능: 실패
- ChatGPT 4: 인터페이스: 좋음, 기능: 좋음
- ChatGPT 3.5: 인터페이스: 좋음, 기능: 좋음
2. 문자열 함수 재작성
이 테스트는 AI가 달러와 센트 변환을 위해 코드를 특정 요구사항에 맞게 재작성하는 능력을 평가한다. Claude 3.5 Sonnet은 선행 0 제거, 정수와 소수 처리, 음수 값 방지를 잘 수행했다. 또한 예기치 않은 입력에 대해 "0"을 반환해 오류를 방지했다.
하지만 ".50"과 같은 50센트 입력을 허용하지 않아 요구사항을 충족하지 못했다. 이는 수정된 코드가 실제 시나리오에서 작동하지 않는다는 의미로, 실패로 평가해야 한다.
종합 결과는 다음과 같다:
- Claude 3.5 Sonnet: 실패
- ChatGPT GPT-4o: 성공
- Microsoft Copilot: 실패
- Meta AI: 실패
- Meta Code Llama: 성공
- Google Gemini Advanced: 실패
- ChatGPT 4: 성공
- ChatGPT 3.5: 성공
3. 성가신 버그 찾기
이 테스트는 AI가 특정 WordPress 지식이 필요한 미묘한 버그를 찾아내는 능력을 요구하기 때문에 까다롭다. 처음에는 나도 놓쳤던 버그로, ChatGPT의 도움을 받아 해결했다.
Claude 3.5 Sonnet은 버그를 찾아 수정했을 뿐만 아니라, 게시 과정에서 발생한 오류를 발견해 내가 수정할 수 있게 했다. 이는 전체 테스트를 게시한 이후 내가 테스트한 AI 중 처음이었다.
종합 결과는 다음과 같다:
- Claude 3.5 Sonnet: 성공
- ChatGPT GPT-4o: 성공
- Microsoft Copilot: 실패. 화려하게. 열정적으로. 이모지로.
- Meta AI: 성공
- Meta Code Llama: 실패
- Google Gemini Advanced: 실패
- ChatGPT 4: 성공
- ChatGPT 3.5: 성공
지금까지 Claude 3.5 Sonnet은 세 가지 테스트 중 두 가지에서 실패했다. 마지막 테스트에서 어떻게 수행하는지 보자.
4. 스크립트 작성
이 테스트는 AppleScript와 Keyboard Maestro 같은 특수 프로그래밍 도구에 대한 AI의 지식을 확인한다. ChatGPT는 두 가지에서 능숙함을 보여줬지만, Claude 3.5 Sonnet은 그렇지 못했다. Chrome과 상호작용하려는 AppleScript를 작성했지만 Keyboard Maestro 구성 요소를 완전히 무시했다.
또한, AppleScript에 구문 오류가 있었다. 대소문자를 구분하지 않도록 하려다 런타임 오류를 일으키는 코드를 생성했다:
"contains" 문은 이미 대소문자를 구분하지 않으며, "ignoring case" 구문이 잘못 배치되어 오류가 발생했다.
종합 결과는 다음과 같다:
- Claude 3.5 Sonnet: 실패
- ChatGPT GPT-4o: 성공했으나 약간의 우려가 있음
- Microsoft Copilot: 실패
- Meta AI: 실패
- Meta Code Llama: 실패
- Google Gemini Advanced: 성공
- ChatGPT 4: 성공
- ChatGPT 3.5: 실패
전체 결과
Claude 3.5 Sonnet의 전체 성과는 다른 AI와 비교해 다음과 같다:
- Claude 3.5 Sonnet: 4개 중 1개 성공
- ChatGPT GPT-4o: 4개 중 4개 성공, 단 하나는 이상한 이중 선택 답변
- Microsoft Copilot: 4개 중 0개 성공
- Meta AI: 4개 중 1개 성공
- Meta Code Llama: 4개 중 1개 성공
- Google Gemini Advanced: 4개 중 1개 성공
- ChatGPT 4: 4개 중 4개 성공
- ChatGPT 3.5: 4개 중 3개 성공
Claude 3.5 Sonnet에 꽤 실망했다. Anthropic은 프로그래밍에 적합하다고 약속했지만, 기대를 충족하지 못했다. 프로그래밍을 못하는 것은 아니지만, 정확하게 프로그래밍하지 못한다. 나는 ChatGPT를 능가하는 AI를 찾고 싶었지만, 현재로서는 프로그래밍 도움으로 ChatGPT를 고수할 것이며, 당신도 그렇게 하기를 추천한다.
당신은 프로그래밍에 AI를 사용해봤나? 어떤 AI를 사용했으며, 어땠나? 아래 댓글에서 경험을 공유해 달라.
소셜 미디어에서 내 프로젝트 업데이트를 팔로우하고, 주간 뉴스레터를 구독하며, Twitter/X에서 @DavidGewirtz, Facebook에서 Facebook.com/DavidGewirtz, Instagram에서 Instagram.com/DavidGewirtz, YouTube에서 YouTube.com/DavidGewirtzTV로 나와 연결하라.








 플로리다주, 폭력 사건을 이유로 오픈AI와 샘 알트만을 상대로 소송 제기
플로리다주 검찰총장은 월요일 오픈AI와 샘 알트만 CEO를 상대로 주 차원의 첫 번째 소송을 제기하며, 회사의 ChatGPT가 여러 건의 폭력 사건과 연관되어 있다고 주장했습니다.소장은 오픈AI가 안전 문제를 무시한 채 ‘AI 군비경쟁’에서 승리하고 막대한 부를 축적하는 데 우선순위를 두었다고 주장합니다.“오늘 우리는 오픈AI와 그 CEO인 샘 알트만을 상대로 전국에서 처음으로 주 차원의 소송을 제기했다고 발표했습니다,”라고 플로리다주 검찰
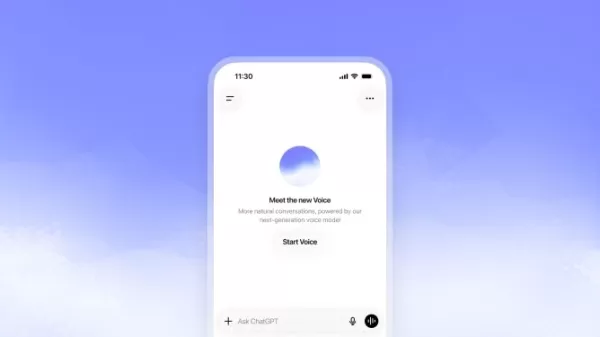 OpenAI, 더욱 자연스러운 실시간 대화를 위한 첨단 음성 모델 공개
OpenAI는 더 자연스러운 음성을 제공하고 대화 순서를 보다 효과적으로 관리하도록 설계된 새로운 대화형 모델인 GPT-Live-1과 GPT-Live-1 mini를 출시했습니다. 이 전이중(full-duplex) 모델은 말하고 듣는 작업을 동시에 수행할 수 있어, 사용자가 자연스럽게 말을 끊을 수 있을 뿐만 아니라 실시간 번역과 같은 기능도 지원합니다.또한
 OpenAI, 자사 모델 제품군의 최신 버전인 GPT-5.6을 공개했습니다
오픈AI는 목요일 최신 모델 제품군을 출시하며, 경쟁이 점점 치열해지는 AI 시장에 강력한 새로운 선택지를 선보였다.GPT-5.6은 Sol(주력 모델로 설계됨), Terra(중간급 옵션), Luna(가성비 좋은 선택지)의 세 가지 버전으로 제공된다. 이 모델들은 다양한 분야에서 기능을 확장하며, 회사는 기업 업무, 코딩, 과학 연구 분야에서 뛰어난 성능을

2026년 최신, 최고 평점을 받은 창의적 실험을 위한 AI 스타일 변환 도구! XIX.AI는 실제 테스트와 엄격한 평가를 통해 탁월한 결과를 보여주는, 강력하고 판도를 바꿀 만한 ‘꼭 사용해 봐야 할’ 도구들을 엄선했습니다. 이 최고의 솔루션들은 콘텐츠 제작 속도를 높이고 무한한 창의적 가능성을 열어줌으로써 크리에이터들의 생산성을 크게 높여줍니다. 지금 바로 탐색하여 나에게 딱 맞는 도구를 찾아보고, 오늘 바로 창작을 시작해 보세요!
9 도구
xix.ai

2026년 시각적 스토리텔링을 위한 최신 최고 평점의 AI 대화 풍선 도구가 XIX.AI에 소개됩니다! 이 엄선된 모음집에는 크리에이터들이 생산성을 높이고 창의적인 난관을 극복하는 데 도움을 주는, 강력하고 획기적인 도구들이 포함되어 있습니다. 무료 버전과 유료 버전의 비교 정보를 확인하고, 실제 테스트 결과를 살펴보며, 최신 순위를 통해 매력적인 시각적 이야기를 만드는 데 꼭 필요한 솔루션을 찾아보세요. 지금 바로 탐색하여 여러분에게 딱 맞는 도구를 발견해 보세요!
10 도구
xix.ai

2026년 최신 최고 평점을 받은 최고의 AI 회의 요약 도구로, 명확한 의사 결정 추적과 손쉬운 후속 조치를 실현하세요. 이 엄선된 목록은 회의록 자동화, 핵심 실행 과제 파악, 모든 프로젝트에 걸친 팀 협업 효율화를 통해 생산성을 획기적으로 높여주는 강력하고 혁신적인 솔루션을 소개합니다. 무료 버전과 유료 버전의 비교 정보, 실제 사용 후기, 매주 업데이트되는 순위 정보를 통해 여러분에게 딱 맞는 도구를 찾아보세요. 지금 바로 살펴보고 AI의 힘을 경험해 보세요!
9 도구
xix.ai

2026년 최신의 우수하고 높은 평가를 받는 AI 데이터 정제 도구들로, 누락된 값과 중복 데이터를 신속하게 수정할 수 있습니다. 이 선별된 목록에는 생산성을 획기적으로 향상시켜 주는 강력한 솔루션이 포함되어 있습니다. 각 도구는 신뢰성을 보장하기 위해 엄격한 실제 환경 테스트를 거쳤습니다. 무료 버전과 유료 버전의 비교 정보를 확인하고, 귀하의 요구사항에 가장 적합한 도구를 발견해 보세요. 지금 바로 XIX.AI에서 자세히 알아보시고 AI 분야에서의 경쟁 우위를 확보하세요.
11 도구
xix.ai

2026년 최신 최고 인기 AI 창의적 아이디어 도구들은 XIX.AI가 선별한 것으로, 창작자들이 시각적 장벽을 돌파하고 즉각적으로 창의성을 높일 수 있도록 지원합니다. 이러한 강력한 혁신적 도구들은 실제 테스트 결과, 무료와 유료 버전의 상세 비교, 그리고 매주 업데이트되는 순위표를 제공합니다. 콘텐츠 제작을 가속화하고 AI 경쟁력을 발휘할 수 있는 완벽한 도구를 발견하세요. 지금 바로 탐색하세요!
14 도구
xix.ai

2026년 틱톡 배경 음악, 릴스 오디오, 크리에이터 홍보용 음악을 위한 최신 최고의 AI 비트 메이커! XIX.AI는 모든 콘텐츠 요구 사항에 맞는 완벽한 음악을 제공하기 위해 실제 테스트를 거친, 업계에 혁신을 일으킬 만한 강력한 도구들의 최고 평점 목록을 엄선했습니다. 창의성과 생산성을 높이는 데 도움이 될 상세한 무료 vs 유료 비교 자료, 매주 업데이트되는 순위, 그리고 꼭 시도해 봐야 할 추천 옵션을 확인하실 수 있습니다. 지금 바로 탐색하여 여러분에게 딱 맞는 도구를 찾아보세요!
11 도구
xix.ai

Intéressant de voir Claude 3.5 Sonnet avoir du mal avec le codage créatif. Est-ce qu'on attend trop des IA actuellement ? Après tout, l'intelligence humaine reste unique 🤷♂️
Claude 3.5 Sonnet is pretty good, but it's no match for ChatGPT in coding tests. It's like bringing a knife to a gunfight! 😂 Still, it's an improvement over the last version, so kudos to Anthropic for trying to keep up. Maybe next time, they'll surprise us!
Claude 3.5 Sonnet é bom, mas não chega aos pés do ChatGPT em testes de codificação. É como levar uma faca para uma batalha de armas! 😂 Ainda assim, é uma melhoria em relação à versão anterior, então parabéns à Anthropic por tentar acompanhar. Talvez da próxima vez eles nos surpreendam!
クロード3.5ソネットはコードテストではChatGPTにかなわないですね。まるでナイフを持って銃撃戦に挑むようなものです!😂 でも、前バージョンよりは改善されているので、アントロピックの努力には敬意を表します。次回は驚かせてくれるかも?
Claude 3.5 Sonnet qui galère en codage, c’est un peu décevant vu les promesses d’Anthropic. 😐 ChatGPT garde l’avantage, mais la course à l’IA est fascinante !
클로드 3.5 소넷은 코드 테스트에서 ChatGPT에 비해 많이 부족해요. 마치 칼을 들고 총격전에 나서는 느낌이죠! 😂 그래도 이전 버전보다는 나아졌으니, 앤트로픽의 노력에 박수를 보냅니다. 다음에는 놀라게 해줄지 모르겠네요!












