


 家
手続き的記憶がAIエージェントのコストと複雑さを削減する
浙江大学とアリババ・グループが開発した新しい技術は、大規模言語モデル(LLM)エージェントにダイナミック・メモリーを装備させ、複雑なタスクを処理する効率と効果を高める。Mempと名付けられたこのアプローチは、エージェントが経験を蓄積するにつれて継続的に更新される「手続き記憶」を提供するもので、人間が反復練習を通じて学習する方法を反映している。
Mempは、エージェントが新しいタスクごとにゼロから始める必要がなくなる生涯学習システムを確立する。実世界の環境で新しいシナリオに直面するにつれ、エージェントは着実に向上し、より効率的になる。
AIエージェントにおける手続き記憶の重要性
LLMエージェントは、複雑な複数ステップのビジネスオペレーションを自動化する大きな可能性を示している。しかし、実際には、これらの拡張タスクは失敗しやすい。研究者らは、ネットワークの中断、ユーザーインターフェースの更新、データフォーマットの変更など、予期せぬ問題がワークフロー全体を混乱させる可能性があることを強調している。現状では、このような問題が発生すると、エージェントはその都度最初から作業をやり直さなければならず、作業の遅延とコスト増を招いている。
同時に、多くの複雑なタスクは、表面的には異なるように見えるが、根本的な構造的類似性を共有している。研究者たちが強調するように、エージェントはこうしたパターンを毎回学習し直すのではなく、過去の経験(成功も失敗も含めて)を活用し、再利用する能力を持つべきである。これは、タイピングやサイクリングのようなスキルのための人間の長期記憶に似ている。
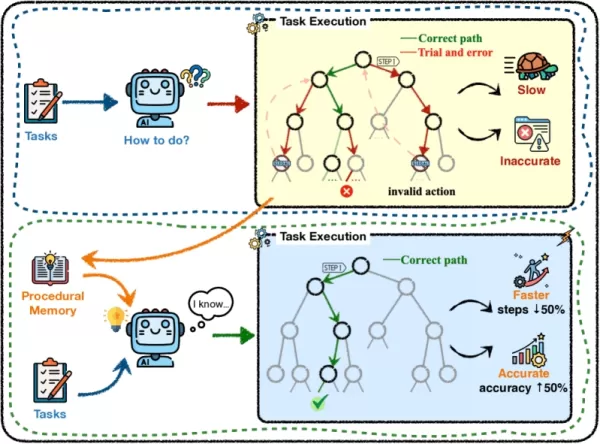
ゼロからのスタート(上)と手続き記憶の使用(下)(出典:arXiv) 現在のほとんどのエージェントシステムには、この機能が欠けている。手続き的知識は通常、開発者が手作業でプログラムするか、柔軟性に欠けるプロンプトテンプレートに格納するか、モデルのパラメータに埋め込んでいる。記憶機能を強化した既存のフレームワークでさえ、大まかな抽象化しか提供せず、エージェントのライフサイクルを通じて、スキルがどのように開発され、インデックス化され、洗練され、管理されるべきかを適切に扱うことができない。
研究者たちが論文で述べているように、"エージェントが手続き的レパートリーをどれだけ効率的に進化させるかを定量化したり、新しい経験がパフォーマンスを低下させるのではなく、むしろ向上させることを保証したりする原理的な方法は存在しない"。
メンプの仕組み
Mempは、タスクにとらわれないフレームワークであり、手続き記憶を最適化可能な基本要素として扱う。Mempは、記憶の構築、検索、更新という連続的なサイクルを形成する3つの中核的な段階を通して動作する。
記憶は、エージェントの過去の経験、すなわち "軌跡 "から構築される。研究チームは、これらの記憶を2つの形で保存することを検討した。正確なステップ・バイ・ステップの行動として保存する方法と、それらの行動をより高度なスクリプトのような抽象的なものに要約して保存する方法である。新しいタスクが提示されると、エージェントは最も関連性の高い過去の経験を記憶から検索する。研究者たちは、新しいタスクの説明を過去のクエリと一致させるためのベクトル検索や、最も近い一致を見つけるためのキーワード抽出など、さまざまな方法をテストした。
更新メカニズムは最も重要な要素である。Mempは、エージェントの記憶を確実に進化させるために、いくつかの戦略を取り入れている。エージェントがより多くのタスクを完了すると、新しい経験を追加したり、成功した結果だけをフィルタリングしたり、最も効果的なのは失敗を分析して元の記憶を修正・改善することによって、記憶を更新することができます。
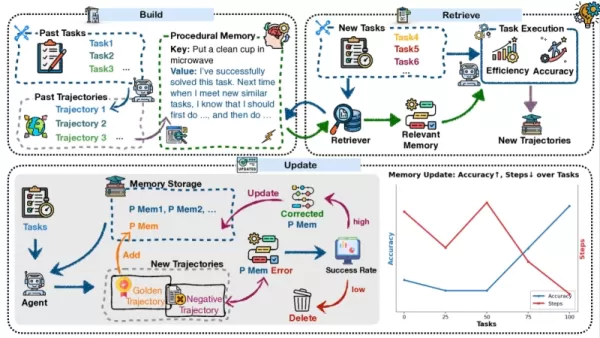
Mempフレームワーク(出典:arXiv) このように動的で適応可能な記憶に重点を置くことで、Mempは、長期的な任務に対するAIエージェントの信頼性を高めることに焦点を当てた、成長中の研究分野に位置づけられる。このプロジェクトは、長時間の会話から重要な情報を抽出し、それを構造化されたファクトと知識グラフに整理して一貫性を維持するMem0などの他の取り組みと一致している。同様に、A-MEMはエージェントが自律的に対話から「記憶ノート」を生成し接続することを可能にし、時間の経過とともに洗練された知識ネットワークを構築する。
しかし、共著者のRunnan Fang氏は、Mempと類似のフレームワークとの決定的な違いを指摘している。
「Mem0やA-MEMは優れた作品ですが、それらは1つの軌跡や会話の中で顕著な内容を記憶することに焦点を当てています」とファング氏はVentureBeatに説明している。基本的には、エージェントが "何が "起こったかを思い出す手助けをする。「Mempは対照的に、軌跡を横断する手続き記憶をターゲットにしている。Mempは、同じようなタスクに適用できる "ハウツー "の知識に集中することで、エージェントが何度も振り出しからやり直す必要がなくなる。
「過去に成功したワークフローを再利用可能な手続きプライアに抽出することで、Mempは成功率を高め、ステップを短縮します。「重要なのは、この手続き的記憶が改善され続けるように、更新メカニズムも導入していることです。
コールドスタートの課題を克服する
過去の経験から学習することは強力なコンセプトだが、現実的な課題もある。完璧な事例がない場合、エージェントはどのようにして初期記憶を開発するのだろうか?研究チームは、この "コールドスタート "の問題に実用的な解決策で取り組んでいる。
ファング氏は、開発者が最初から完璧な「ゴールド」軌道を必要とするのではなく、ロバストな評価指標を定義することから始める方法を説明した。この評価基準は、ルールベースであったり、別のLLMを利用したものであったりするが、エージェントのパフォーマンスの質を評価する。「いったんこの評価基準が整えば、最先端のモデルにエージェントのワークフロー内を探索させ、最も高いスコアを獲得した軌道を保持します」とFang氏は言う。この方法により、貴重な記憶の初期コレクションが迅速に構築され、大規模な手動コーディングなしに、新しいエージェントが熟練できるようになる。
Mempの動作
このフレームワークを評価するため、研究チームはMempをGPT-4o、Claude3.5 Sonnet、Qwen2.5といった主要なLLMと統合し、ALFWorldベンチマークでの家事やTravelPlannerでの情報収集といった負荷の高いタスクでテストした。その結果、手続き記憶を構築しアクセスすることで、エージェントは過去の経験を効果的に要約し再利用できることが明らかになった。
テストでは、Mempを使用したエージェントは高い成功率を達成しただけでなく、はるかに効率的に動作した。非生産的な探索や推測作業を省き、タスクを完了するのに必要なステップ数とトークンの使用量を大幅に削減した。
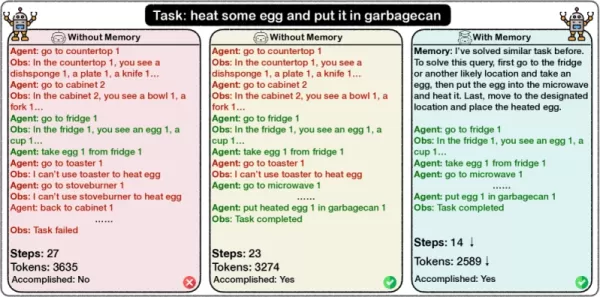
手続き的記憶(右)を使用することで、エージェントはより少ないステップとトークン使用量でタスクを完了できる(出典:arXiv) ビジネス利用において特に注目すべき発見は、手続き型メモリーが転送可能であることだ。あるテストでは、高性能のGPT-4oで作成した手続き記憶を、はるかに小型のモデルQwen2.5-14Bに提供した。その結果、GPT-4oの性能は著しく向上し、成功率が上がり、タスクを達成するのに必要な手順が短縮された。
ファング博士によると、このようなことが可能なのは、小型のモデルは通常、単純なワンステップの動作はうまくこなすが、長期的な計画や推論が苦手だからだという。このギャップを効果的に埋めるのが、より大きなモデルによる手続き記憶である。このことは、一流のモデルを使って知識を収集し、その学習経験の利点を犠牲にすることなく、より小型で予算に見合ったモデルに適用できることを意味している。
完全自律型エージェントへの前進
記憶更新機能を統合することで、Mempフレームワークは、エージェントが実環境で作業しながら、手続き的知識を継続的に開発し、磨くことを可能にする。研究者たちは、これによってエージェントが "継続的で、ほぼ直線的なタスクの習得 "を可能にすることを観察した。
しかし、完全な自律性を達成するためには、もう1つの障害がある。研究報告書を作成するような実世界の多くのタスクには、明確な成功指標がないのだ。改善を続けるためには、エージェントは自分のパフォーマンスが満足のいくものであったかどうかを知る必要がある。ファング氏は、LLMを評価者として採用することで解決できると考えている。
「今日、私たちはしばしば、強力なモデルと手作りのルールを組み合わせて、完了スコアを計算しています。「しかし、手書きのルールは柔軟性に欠け、一般化が難しい。
LLMが裁判官の役割を果たせば、エージェントが複雑で主観的な課題を自己修正するのに必要な、詳細で監督的なフィードバックを提供できる。これにより、学習プロセス全体がよりスケーラブルで弾力的になり、高度なエンタープライズ・オートメーションに不可欠な、耐久性があり、柔軟で、真に自律的なAIワーカーを生み出すための重要な一歩となるだろう。
関連記事
 Base44、独自開発のAIモデルを公開し、Vibeコーディングプラットフォームの防御力を強化
Base44は、わずか1年前にWixによって8,000万ドルで買収された「バイブコーディング」プラットフォームであり、当時チーム8名、設立からわずか6ヶ月という若さであったが、自然言語を用いてアプリケーションを構築するユーザーを支援するため、独自のAIモデルの提供を開始した。この展開は、最先端モデルがすべてのユースケースにおいて最適かどうか、そして外部モデルに依存する企業が長期的な防衛性を維持できるかどうかをめぐってAIコミュニティが議論している時期に到来した。ベイエリアを拠点とするBase4
バイエル、Iambic AIを活用して創薬プロセスを加速
ユルゲン・エックハルト医学博士は、バイエル・ファーマシューティカルズで事業開発・ライセンス担当責任者を務めています。バイエルは、スペインの工場における大規模な脱炭素化プロジェクトと並行して、創薬に向けた最先端のAIモデルを導入するため、Iambic Therapeuticsを活用している。バイエルは、低分子化合物の創薬および新薬開発を加速させるため、科学技術企業であるIambic Therapeu
マルチバース・コンピューティング、無料圧縮生成AIモデルを発表
大規模言語モデルは重大な課題に直面している:その膨大なサイズである。スペインのスタートアップMultiverse Computingは、最先端AIの能力と企業が実用的に導入できる範囲とのギャップを埋めるべく設計された圧縮モデルを開発することでこの問題に取り組んでいる。同社の革新的な技術「CompactifAI」は量子コンピューティング原理に着想を得た圧縮技術であり、バスク地方のこの企業はOpenA
関連特集おすすめ
仕事
 中小企業に最適なAI競合分析ツール
2026年版 中小企業向け最新・最高評価のAI競合分析ツール!XIX.AIは、実環境での厳格なテストと詳細なランキングに基づき、毎週更新される、極めて強力で業界に革命をもたらすツールを厳選しました。無料版と有料版の包括的な比較も掲載されており、生産性を向上させ、競争優位性をもたらす「ぜひ試すべき」ツールを見つけるのに役立ちます。 今すぐチェックして、あなたにぴったりのツールを見つけましょう!
 9 ツール
 xix.ai
画像編集
EC用アパレル向けPhotoshop AIレタッチツール、肌のクレンジング、色の統一
2026年最新版、eコマース用アパレル向けPhotoshop AIリタッチツール、肌補正、色調統一に最適!この高評価の厳選リストは、文章作成の効率化、コンテンツ制作の簡素化、完璧な視覚結果の達成を支援する革新的なソリューションを提供しています。各ツールは週次更新ランキングを通じて実世界でテストされ、無料版と有料版の比較詳細も記載されています。XIX.AIが後援するこのガイドは、AIの優位性を最大限に引き出したい方に必見です。今すぐチェック!
10 ツール
xix.ai
プロンプト
ChatGPTワークフローに最適なAIプロンプトライブラリ
2026年版:あらゆる種類のChatGPTワークフローを最適化するための、最新かつ最高評価のAIプロンプトライブラリ。XIX.AIは、最高のパフォーマンスを保証するために厳格な実環境テストを経た、強力で画期的なコレクションを厳選しました。 無料版と有料版の詳細な比較や専門家によるランキングを参考に、生産性を高め、AIの真の力を引き出す「必試」ツールを選んでください。今すぐチェックしましょう!
11 ツール
xix.ai
教育と学習
教師、チューター、およびコホート型学習プログラム向けのAIクイズビルダープラットフォーム
2026年最新版 教師、チューター、コホート型学習プログラム向けベストAIクイズビルダープラットフォーム!XIX.AIは、実世界のテストを経て正確なランキングを提供する革新的なツールの中から、高評価のリストを厳選しました。これらの必須プラットフォームは、すべての学習シナリオにおいて、作成効率の向上、コンテンツ制作の効率化、クイズ設計の簡素化を支援します。今すぐ探索して、教育におけるAIの優位性を引き出すための完璧なツールを見つけましょう!
13 ツール
xix.ai
コード
リファクタリング、バグ、セキュリティ上の脆弱性を扱うGitHubチーム向けのAIプルリクエストレビューツール
2026年版、GitHubチーム向けの最新・最高のAIプルリクエストレビューツールがXIX.AIに登場!この厳選された高評価リストでは、あらゆるチームワークフローにおいて、リファクタリング、バグ修正、セキュリティ上の脆弱性の検出を効率化する、画期的なソリューションを紹介しています。 無料版と有料版の比較に加え、実環境でのテスト結果や詳細なランキングも掲載されており、生産性を大幅に向上させる最適なツールを見つけるのに役立ちます。今すぐチェックして、AIの力を最大限に活用しましょう!
12 ツール
xix.ai
テキスト読み上げ
自然なナレーションを実現する、おすすめのAIテキスト読み上げツール
2026年最新の、自然なナレーションを実現する高評価のAIテキスト読み上げツールが、XIX.AIに登場!この厳選リストには、実環境でのテストと毎週更新されるランキングに基づいた、あらゆるユースケースでクリアな音声を再生する、強力で画期的なツールが紹介されています。 無料版と有料版の比較情報を確認して、生産性を即座に高める「必試」のソリューションを見つけましょう。今すぐチェックして、AIの力を最大限に活用しましょう!
11 ツール
xix.ai

 コメント (2)
0/500
![DonaldLee]()
Interesting approach! Giving LLMs a memory system could be a game-changer for automating complex workflows. I wonder how the cost savings compare to other optimization methods out there. The collaboration between academia and industry on this is promising. 🧠
![HarperJones]()
이 기술이 LLM 에이전트의 처리 효율을 높여줘서 정말 흥미롭네요! 하지만 실제 서비스에서 이렇게 동적 메모리가 잘 작동할까요? 복잡한 작업에서 성능이 안정적으로 유지되는지 궁금해요. 🤔 AI 비용 절감이 중요한 만큼 더 많은 연구가 필요해 보입니다.
浙江大学とアリババ・グループが開発した新しい技術は、大規模言語モデル(LLM)エージェントにダイナミック・メモリーを装備させ、複雑なタスクを処理する効率と効果を高める。Mempと名付けられたこのアプローチは、エージェントが経験を蓄積するにつれて継続的に更新される「手続き記憶」を提供するもので、人間が反復練習を通じて学習する方法を反映している。
Mempは、エージェントが新しいタスクごとにゼロから始める必要がなくなる生涯学習システムを確立する。実世界の環境で新しいシナリオに直面するにつれ、エージェントは着実に向上し、より効率的になる。
AIエージェントにおける手続き記憶の重要性
LLMエージェントは、複雑な複数ステップのビジネスオペレーションを自動化する大きな可能性を示している。しかし、実際には、これらの拡張タスクは失敗しやすい。研究者らは、ネットワークの中断、ユーザーインターフェースの更新、データフォーマットの変更など、予期せぬ問題がワークフロー全体を混乱させる可能性があることを強調している。現状では、このような問題が発生すると、エージェントはその都度最初から作業をやり直さなければならず、作業の遅延とコスト増を招いている。
同時に、多くの複雑なタスクは、表面的には異なるように見えるが、根本的な構造的類似性を共有している。研究者たちが強調するように、エージェントはこうしたパターンを毎回学習し直すのではなく、過去の経験(成功も失敗も含めて)を活用し、再利用する能力を持つべきである。これは、タイピングやサイクリングのようなスキルのための人間の長期記憶に似ている。
現在のほとんどのエージェントシステムには、この機能が欠けている。手続き的知識は通常、開発者が手作業でプログラムするか、柔軟性に欠けるプロンプトテンプレートに格納するか、モデルのパラメータに埋め込んでいる。記憶機能を強化した既存のフレームワークでさえ、大まかな抽象化しか提供せず、エージェントのライフサイクルを通じて、スキルがどのように開発され、インデックス化され、洗練され、管理されるべきかを適切に扱うことができない。
研究者たちが論文で述べているように、"エージェントが手続き的レパートリーをどれだけ効率的に進化させるかを定量化したり、新しい経験がパフォーマンスを低下させるのではなく、むしろ向上させることを保証したりする原理的な方法は存在しない"。
メンプの仕組み
Mempは、タスクにとらわれないフレームワークであり、手続き記憶を最適化可能な基本要素として扱う。Mempは、記憶の構築、検索、更新という連続的なサイクルを形成する3つの中核的な段階を通して動作する。
記憶は、エージェントの過去の経験、すなわち "軌跡 "から構築される。研究チームは、これらの記憶を2つの形で保存することを検討した。正確なステップ・バイ・ステップの行動として保存する方法と、それらの行動をより高度なスクリプトのような抽象的なものに要約して保存する方法である。新しいタスクが提示されると、エージェントは最も関連性の高い過去の経験を記憶から検索する。研究者たちは、新しいタスクの説明を過去のクエリと一致させるためのベクトル検索や、最も近い一致を見つけるためのキーワード抽出など、さまざまな方法をテストした。
更新メカニズムは最も重要な要素である。Mempは、エージェントの記憶を確実に進化させるために、いくつかの戦略を取り入れている。エージェントがより多くのタスクを完了すると、新しい経験を追加したり、成功した結果だけをフィルタリングしたり、最も効果的なのは失敗を分析して元の記憶を修正・改善することによって、記憶を更新することができます。
このように動的で適応可能な記憶に重点を置くことで、Mempは、長期的な任務に対するAIエージェントの信頼性を高めることに焦点を当てた、成長中の研究分野に位置づけられる。このプロジェクトは、長時間の会話から重要な情報を抽出し、それを構造化されたファクトと知識グラフに整理して一貫性を維持するMem0などの他の取り組みと一致している。同様に、A-MEMはエージェントが自律的に対話から「記憶ノート」を生成し接続することを可能にし、時間の経過とともに洗練された知識ネットワークを構築する。
しかし、共著者のRunnan Fang氏は、Mempと類似のフレームワークとの決定的な違いを指摘している。
「Mem0やA-MEMは優れた作品ですが、それらは1つの軌跡や会話の中で顕著な内容を記憶することに焦点を当てています」とファング氏はVentureBeatに説明している。基本的には、エージェントが "何が "起こったかを思い出す手助けをする。「Mempは対照的に、軌跡を横断する手続き記憶をターゲットにしている。Mempは、同じようなタスクに適用できる "ハウツー "の知識に集中することで、エージェントが何度も振り出しからやり直す必要がなくなる。
「過去に成功したワークフローを再利用可能な手続きプライアに抽出することで、Mempは成功率を高め、ステップを短縮します。「重要なのは、この手続き的記憶が改善され続けるように、更新メカニズムも導入していることです。
コールドスタートの課題を克服する
過去の経験から学習することは強力なコンセプトだが、現実的な課題もある。完璧な事例がない場合、エージェントはどのようにして初期記憶を開発するのだろうか?研究チームは、この "コールドスタート "の問題に実用的な解決策で取り組んでいる。
ファング氏は、開発者が最初から完璧な「ゴールド」軌道を必要とするのではなく、ロバストな評価指標を定義することから始める方法を説明した。この評価基準は、ルールベースであったり、別のLLMを利用したものであったりするが、エージェントのパフォーマンスの質を評価する。「いったんこの評価基準が整えば、最先端のモデルにエージェントのワークフロー内を探索させ、最も高いスコアを獲得した軌道を保持します」とFang氏は言う。この方法により、貴重な記憶の初期コレクションが迅速に構築され、大規模な手動コーディングなしに、新しいエージェントが熟練できるようになる。
Mempの動作
このフレームワークを評価するため、研究チームはMempをGPT-4o、Claude3.5 Sonnet、Qwen2.5といった主要なLLMと統合し、ALFWorldベンチマークでの家事やTravelPlannerでの情報収集といった負荷の高いタスクでテストした。その結果、手続き記憶を構築しアクセスすることで、エージェントは過去の経験を効果的に要約し再利用できることが明らかになった。
テストでは、Mempを使用したエージェントは高い成功率を達成しただけでなく、はるかに効率的に動作した。非生産的な探索や推測作業を省き、タスクを完了するのに必要なステップ数とトークンの使用量を大幅に削減した。
ビジネス利用において特に注目すべき発見は、手続き型メモリーが転送可能であることだ。あるテストでは、高性能のGPT-4oで作成した手続き記憶を、はるかに小型のモデルQwen2.5-14Bに提供した。その結果、GPT-4oの性能は著しく向上し、成功率が上がり、タスクを達成するのに必要な手順が短縮された。
ファング博士によると、このようなことが可能なのは、小型のモデルは通常、単純なワンステップの動作はうまくこなすが、長期的な計画や推論が苦手だからだという。このギャップを効果的に埋めるのが、より大きなモデルによる手続き記憶である。このことは、一流のモデルを使って知識を収集し、その学習経験の利点を犠牲にすることなく、より小型で予算に見合ったモデルに適用できることを意味している。
完全自律型エージェントへの前進
記憶更新機能を統合することで、Mempフレームワークは、エージェントが実環境で作業しながら、手続き的知識を継続的に開発し、磨くことを可能にする。研究者たちは、これによってエージェントが "継続的で、ほぼ直線的なタスクの習得 "を可能にすることを観察した。
しかし、完全な自律性を達成するためには、もう1つの障害がある。研究報告書を作成するような実世界の多くのタスクには、明確な成功指標がないのだ。改善を続けるためには、エージェントは自分のパフォーマンスが満足のいくものであったかどうかを知る必要がある。ファング氏は、LLMを評価者として採用することで解決できると考えている。
「今日、私たちはしばしば、強力なモデルと手作りのルールを組み合わせて、完了スコアを計算しています。「しかし、手書きのルールは柔軟性に欠け、一般化が難しい。
LLMが裁判官の役割を果たせば、エージェントが複雑で主観的な課題を自己修正するのに必要な、詳細で監督的なフィードバックを提供できる。これにより、学習プロセス全体がよりスケーラブルで弾力的になり、高度なエンタープライズ・オートメーションに不可欠な、耐久性があり、柔軟で、真に自律的なAIワーカーを生み出すための重要な一歩となるだろう。








 Base44、独自開発のAIモデルを公開し、Vibeコーディングプラットフォームの防御力を強化
Base44は、わずか1年前にWixによって8,000万ドルで買収された「バイブコーディング」プラットフォームであり、当時チーム8名、設立からわずか6ヶ月という若さであったが、自然言語を用いてアプリケーションを構築するユーザーを支援するため、独自のAIモデルの提供を開始した。この展開は、最先端モデルがすべてのユースケースにおいて最適かどうか、そして外部モデルに依存する企業が長期的な防衛性を維持できるかどうかをめぐってAIコミュニティが議論している時期に到来した。ベイエリアを拠点とするBase4
 バイエル、Iambic AIを活用して創薬プロセスを加速
ユルゲン・エックハルト医学博士は、バイエル・ファーマシューティカルズで事業開発・ライセンス担当責任者を務めています。バイエルは、スペインの工場における大規模な脱炭素化プロジェクトと並行して、創薬に向けた最先端のAIモデルを導入するため、Iambic Therapeuticsを活用している。バイエルは、低分子化合物の創薬および新薬開発を加速させるため、科学技術企業であるIambic Therapeu
 マルチバース・コンピューティング、無料圧縮生成AIモデルを発表
大規模言語モデルは重大な課題に直面している:その膨大なサイズである。スペインのスタートアップMultiverse Computingは、最先端AIの能力と企業が実用的に導入できる範囲とのギャップを埋めるべく設計された圧縮モデルを開発することでこの問題に取り組んでいる。同社の革新的な技術「CompactifAI」は量子コンピューティング原理に着想を得た圧縮技術であり、バスク地方のこの企業はOpenA

2026年版 中小企業向け最新・最高評価のAI競合分析ツール!XIX.AIは、実環境での厳格なテストと詳細なランキングに基づき、毎週更新される、極めて強力で業界に革命をもたらすツールを厳選しました。無料版と有料版の包括的な比較も掲載されており、生産性を向上させ、競争優位性をもたらす「ぜひ試すべき」ツールを見つけるのに役立ちます。 今すぐチェックして、あなたにぴったりのツールを見つけましょう!
9 ツール
xix.ai

2026年最新版、eコマース用アパレル向けPhotoshop AIリタッチツール、肌補正、色調統一に最適!この高評価の厳選リストは、文章作成の効率化、コンテンツ制作の簡素化、完璧な視覚結果の達成を支援する革新的なソリューションを提供しています。各ツールは週次更新ランキングを通じて実世界でテストされ、無料版と有料版の比較詳細も記載されています。XIX.AIが後援するこのガイドは、AIの優位性を最大限に引き出したい方に必見です。今すぐチェック!
10 ツール
xix.ai

2026年版:あらゆる種類のChatGPTワークフローを最適化するための、最新かつ最高評価のAIプロンプトライブラリ。XIX.AIは、最高のパフォーマンスを保証するために厳格な実環境テストを経た、強力で画期的なコレクションを厳選しました。 無料版と有料版の詳細な比較や専門家によるランキングを参考に、生産性を高め、AIの真の力を引き出す「必試」ツールを選んでください。今すぐチェックしましょう!
11 ツール
xix.ai

2026年最新版 教師、チューター、コホート型学習プログラム向けベストAIクイズビルダープラットフォーム!XIX.AIは、実世界のテストを経て正確なランキングを提供する革新的なツールの中から、高評価のリストを厳選しました。これらの必須プラットフォームは、すべての学習シナリオにおいて、作成効率の向上、コンテンツ制作の効率化、クイズ設計の簡素化を支援します。今すぐ探索して、教育におけるAIの優位性を引き出すための完璧なツールを見つけましょう!
13 ツール
xix.ai

2026年版、GitHubチーム向けの最新・最高のAIプルリクエストレビューツールがXIX.AIに登場!この厳選された高評価リストでは、あらゆるチームワークフローにおいて、リファクタリング、バグ修正、セキュリティ上の脆弱性の検出を効率化する、画期的なソリューションを紹介しています。 無料版と有料版の比較に加え、実環境でのテスト結果や詳細なランキングも掲載されており、生産性を大幅に向上させる最適なツールを見つけるのに役立ちます。今すぐチェックして、AIの力を最大限に活用しましょう!
12 ツール
xix.ai

2026年最新の、自然なナレーションを実現する高評価のAIテキスト読み上げツールが、XIX.AIに登場!この厳選リストには、実環境でのテストと毎週更新されるランキングに基づいた、あらゆるユースケースでクリアな音声を再生する、強力で画期的なツールが紹介されています。 無料版と有料版の比較情報を確認して、生産性を即座に高める「必試」のソリューションを見つけましょう。今すぐチェックして、AIの力を最大限に活用しましょう!
11 ツール
xix.ai

Interesting approach! Giving LLMs a memory system could be a game-changer for automating complex workflows. I wonder how the cost savings compare to other optimization methods out there. The collaboration between academia and industry on this is promising. 🧠
이 기술이 LLM 에이전트의 처리 효율을 높여줘서 정말 흥미롭네요! 하지만 실제 서비스에서 이렇게 동적 메모리가 잘 작동할까요? 복잡한 작업에서 성능이 안정적으로 유지되는지 궁금해요. 🤔 AI 비용 절감이 중요한 만큼 더 많은 연구가 필요해 보입니다.












