


 Heim
Prozedurales Gedächtnis senkt Kosten und Komplexität von KI-Agenten
Eine neue Technik, die von der Universität Zhejiang und der Alibaba Group entwickelt wurde, stattet Agenten für große Sprachmodelle (Large Language Model, LLM) mit einem dynamischen Gedächtnis aus und steigert so ihre Effizienz und Effektivität bei der Bewältigung komplexer Aufgaben. Dieser Ansatz mit dem Namen Memp stattet Agenten mit einem "Verfahrensgedächtnis" aus, das sich mit zunehmender Erfahrung ständig aktualisiert und die Art und Weise widerspiegelt, wie Menschen durch wiederholtes Üben lernen.
Memp schafft ein lebenslanges Lernsystem, bei dem die Agenten nicht mehr bei jeder neuen Aufgabe bei Null anfangen müssen. Wenn sie in realen Umgebungen mit neuen Szenarien konfrontiert werden, verbessern sie sich stetig und werden effizienter - ein entscheidendes Merkmal für eine zuverlässige Unternehmensautomatisierung.
Die Bedeutung des prozeduralen Gedächtnisses bei KI-Agenten
LLM-Agenten haben ein großes Potenzial für die Automatisierung komplizierter, mehrstufiger Geschäftsvorgänge. In der Praxis können diese erweiterten Aufgaben jedoch fehleranfällig sein. Die Forscher betonen, dass unerwartete Probleme - wie Netzwerkunterbrechungen, Aktualisierungen der Benutzeroberfläche oder veränderte Datenformate - den gesamten Arbeitsablauf unterbrechen können. Dies zwingt die Agenten derzeit oft dazu, jedes Mal von vorne zu beginnen, was zu Verzögerungen und höheren Kosten führt.
Gleichzeitig haben viele komplexe Aufgaben, auch wenn sie oberflächlich betrachtet unterschiedlich erscheinen, grundlegende strukturelle Ähnlichkeiten. Anstatt diese Muster jedes Mal neu zu erlernen, sollte ein Agent in der Lage sein, aus seinen früheren Erfahrungen - sowohl aus Erfolgen als auch aus Misserfolgen - zu schöpfen und diese wiederzuverwenden, wie die Forscher betonen. Dies erfordert ein spezielles "prozedurales Gedächtnis", ähnlich dem menschlichen Langzeitgedächtnis für Fähigkeiten wie Tippen oder Radfahren, die durch Wiederholung zur zweiten Natur werden.
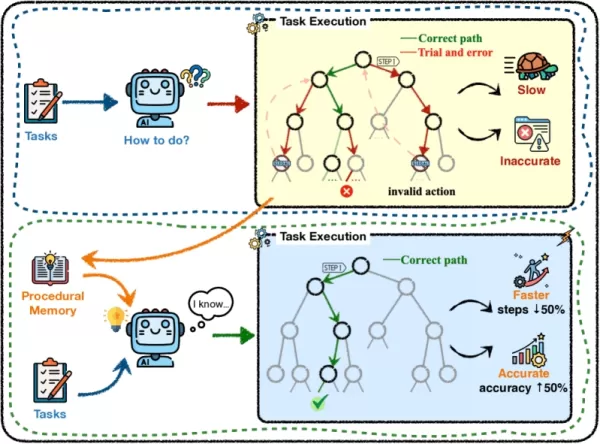
Von Grund auf neu beginnen (oben) vs. prozedurales Gedächtnis verwenden (unten) (Quelle: arXiv) Den meisten aktuellen Agentensystemen fehlt diese Funktionalität. Ihr prozedurales Wissen wird in der Regel von den Entwicklern manuell programmiert, in unflexiblen Eingabeaufforderungsvorlagen gespeichert oder in die Parameter des Modells eingebettet, die sich nur mit hohem Aufwand und langsam ändern lassen. Selbst bestehende Frameworks mit Speichererweiterungen bieten nur grobe Abstraktionen und gehen nicht richtig darauf ein, wie Fähigkeiten entwickelt, indiziert, verfeinert und während des Lebenszyklus eines Agenten verwaltet werden sollten.
Wie die Forscher in ihrem Papier feststellen, "gibt es keinen prinzipiellen Weg, um zu quantifizieren, wie effizient ein Agent sein prozedurales Repertoire entwickelt, oder um zu garantieren, dass neue Erfahrungen die Leistung verbessern und nicht verschlechtern."
Wie Memp funktioniert
Memp ist ein aufgabenunabhängiger Rahmen, der das prozedurale Gedächtnis als eine grundlegende, optimierbare Komponente behandelt. Es arbeitet mit drei Kernphasen, die einen kontinuierlichen Zyklus bilden: Aufbau, Abruf und Aktualisierung des Gedächtnisses.
Erinnerungen werden aus den vergangenen Erfahrungen eines Agenten oder "Trajektorien" aufgebaut. Das Team untersuchte die Speicherung dieser Erinnerungen in zwei Formen: entweder als exakte Schritt-für-Schritt-Aktionen oder durch Zusammenfassung dieser Aktionen in übergeordnete, skriptartige Abstraktionen. Wird dem Agenten eine neue Aufgabe gestellt, sucht er in seinem Gedächtnis nach den relevantesten früheren Erfahrungen. Die Forscher testeten verschiedene Methoden, darunter die Vektorsuche, um die Beschreibung der neuen Aufgabe mit früheren Abfragen abzugleichen, oder die Extraktion von Schlüsselwörtern, um die beste Übereinstimmung zu finden.
Der Aktualisierungsmechanismus ist das wichtigste Element. Memp beinhaltet mehrere Strategien, um sicherzustellen, dass sich das Gedächtnis des Agenten weiterentwickelt. Wenn ein Agent mehr Aufgaben erledigt, kann sein Gedächtnis aktualisiert werden, indem die neuen Erfahrungen hinzugefügt werden, indem nur erfolgreiche Ergebnisse herausgefiltert werden oder - was am effektivsten ist - indem Misserfolge analysiert werden, um das ursprüngliche Gedächtnis zu korrigieren und zu verbessern.
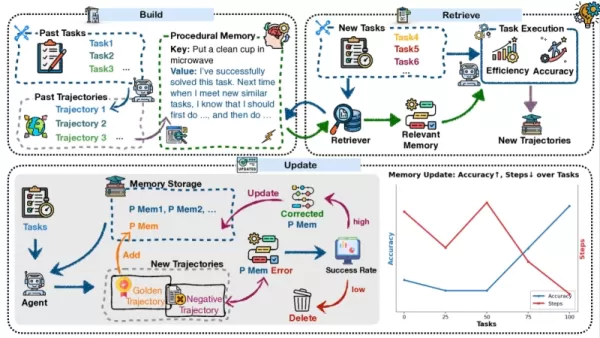
Memp-Rahmenwerk (Quelle: arXiv) Diese Betonung eines dynamischen, anpassungsfähigen Gedächtnisses ordnet Memp in einen wachsenden Forschungsbereich ein, der sich auf die Verbesserung der Zuverlässigkeit von KI-Agenten bei langfristigen Aufgaben konzentriert. Das Projekt steht im Einklang mit anderen Initiativen wie Mem0, das wesentliche Informationen aus langen Gesprächen extrahiert und sie in strukturierten Fakten und Wissensgraphen organisiert, um die Konsistenz zu wahren. In ähnlicher Weise ermöglicht es A-MEM den Agenten, selbstständig "Gedächtnisnotizen" aus ihren Interaktionen zu erstellen und zu verknüpfen und so im Laufe der Zeit ein ausgeklügeltes Wissensnetzwerk aufzubauen.
Die Mitautorin Runnan Fang weist jedoch auf einen entscheidenden Unterschied zwischen Memp und ähnlichen Systemen hin.
"Mem0 und A-MEM sind hervorragende Arbeiten... aber sie konzentrieren sich auf das Erinnern von hervorstechenden Inhalten innerhalb einer einzelnen Trajektorie oder Konversation", erklärt Fang gegenüber VentureBeat. Im Wesentlichen helfen sie einem Agenten, sich zu erinnern, "was" passiert ist. "Memp hingegen zielt auf ein prozedurales Gedächtnis über mehrere Trajektorien hinweg." Es konzentriert sich auf "How-to"-Wissen, das bei vergleichbaren Aufgaben angewendet werden kann, so dass der Agent nicht immer wieder bei Null anfangen muss.
"Durch das Destillieren erfolgreicher Arbeitsabläufe in wiederverwendbare Verfahrensprioritäten erhöht Memp die Erfolgsquote und verkürzt die Arbeitsschritte", so Fang weiter. "Entscheidend ist, dass wir auch einen Aktualisierungsmechanismus einführen, damit dieses Verfahrensgedächtnis immer besser wird - schließlich macht Übung auch für Agenten den Meister."
Überwindung der Herausforderung des Kaltstarts
Das Lernen aus früheren Erfahrungen ist zwar ein leistungsfähiges Konzept, stellt aber eine praktische Herausforderung dar: Wie entwickelt ein Agent sein anfängliches Gedächtnis, wenn keine fehlerfreien Beispiele verfügbar sind? Das Forschungsteam geht dieses Problem des "Kaltstarts" mit einer praktischen Lösung an.
Fang beschrieb, wie Entwickler zunächst eine robuste Bewertungsmetrik definieren können, anstatt von Anfang an eine perfekte "goldene" Flugbahn zu benötigen. Diese Metrik, die regelbasiert oder von einem anderen LLM unterstützt sein kann, bewertet die Qualität der Leistung eines Agenten. "Sobald diese Metrik vorhanden ist, lassen wir hochmoderne Modelle den Arbeitsablauf des Agenten erkunden und behalten die Trajektorien mit den höchsten Punktzahlen bei", so Fang. Mit dieser Methode lässt sich schnell eine erste Sammlung wertvoller Erinnerungen zusammenstellen, so dass ein neuer Agent ohne umfangreiche manuelle Kodierung seine Fähigkeiten verbessern kann.
Memp in Aktion
Um das Framework zu evaluieren, integrierte das Team Memp in führende LLMs wie GPT-4o, Claude 3.5 Sonnet und Qwen2.5 und testete sie bei anspruchsvollen Aufgaben wie Hausarbeiten im ALFWorld-Benchmark und Informationsbeschaffung im TravelPlanner. Die Ergebnisse zeigten, dass ein Agent durch den Aufbau und den Zugriff auf das prozedurale Gedächtnis seine früheren Erfahrungen effektiv zusammenfassen und wiederverwenden kann.
In den Tests erreichten die Agenten, die Memp verwendeten, nicht nur höhere Erfolgsquoten, sondern arbeiteten auch wesentlich effizienter. Sie konnten unproduktive Erkundungen und Vermutungen vermeiden und sowohl die Anzahl der Schritte als auch die Anzahl der Token, die zur Erledigung einer Aufgabe erforderlich sind, erheblich reduzieren.
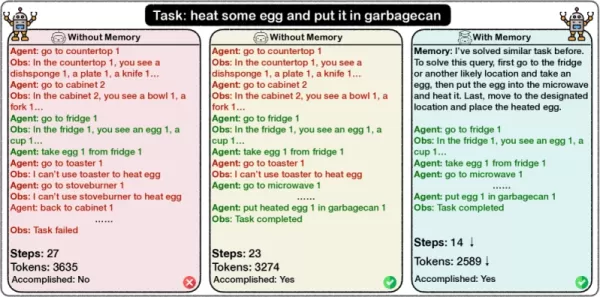
Die Verwendung des prozeduralen Gedächtnisses (rechts) ermöglicht es Agenten, Aufgaben mit weniger Schritten und einem geringeren Token-Verbrauch zu erledigen (Quelle: arXiv) Eine besonders bemerkenswerte Entdeckung für die geschäftliche Nutzung ist, dass das prozedurale Gedächtnis übertragen werden kann. In einem Test wurde der vom leistungsstarken GPT-4o erzeugte prozedurale Speicher einem viel kleineren Modell, Qwen2.5-14B, zur Verfügung gestellt. Die Leistung des kleineren Modells verbesserte sich deutlich, die Erfolgsquote stieg und die zur Bewältigung von Aufgaben erforderlichen Schritte wurden reduziert.
Laut Fang ist dies möglich, weil kleinere Modelle in der Regel einfache, einstufige Handlungen kompetent ausführen, aber Schwierigkeiten mit langfristiger Planung und logischem Denken haben. Das prozedurale Gedächtnis des größeren Modells überbrückt diese Lücke effektiv. Das bedeutet, dass Wissen mit einem Spitzenmodell gesammelt und dann auf kleinere, kostengünstigere Modelle übertragen werden kann, ohne dass die Vorteile dieser Erfahrung verloren gehen.
Auf dem Weg zu vollständig autonomen Agenten
Durch die Integration von Funktionen zur Gedächtnisaktualisierung ermöglicht das Memp-Framework den Agenten, ihr prozedurales Wissen kontinuierlich zu entwickeln und zu verfeinern, während sie in einer realen Umgebung arbeiten. Die Forscher stellten fest, dass dies dem Agenten eine "kontinuierliche, fast lineare Beherrschung der Aufgabe" ermöglicht.
Um vollständige Autonomie zu erreichen, gibt es jedoch noch ein weiteres Hindernis: Für zahlreiche reale Aufgaben, wie die Erstellung eines Forschungsberichts, gibt es keinen eindeutigen Erfolgsindikator. Um sich weiter zu verbessern, muss ein Agent wissen, ob seine Leistung zufriedenstellend war. Fang glaubt, dass die Lösung in der Verwendung von LLMs als Bewerter liegt.
"Heutzutage kombinieren wir oft leistungsstarke Modelle mit handgeschriebenen Regeln, um die Abschlussbewertung zu berechnen", bemerkt er. "Das funktioniert, aber handgeschriebene Regeln sind unflexibel und schwer zu verallgemeinern."
Ein LLM, das als Richter fungiert, könnte das detaillierte, überwachende Feedback bieten, das ein Agent benötigt, um sich bei komplizierten, subjektiven Aufgaben selbst zu korrigieren. Dies würde den gesamten Lernprozess skalierbarer und widerstandsfähiger machen und wäre ein wichtiger Schritt auf dem Weg zu dauerhaften, flexiblen und wirklich autonomen KI-Mitarbeitern, die für eine fortschrittliche Unternehmensautomatisierung unerlässlich sind.
Verwandter Artikel
 Base44 stellt proprietäres KI-Modell vor, um die Abwehrfähigkeit der Vibe-Coding-Plattform zu stärken
Base44, die vor einem Jahr für 80 Millionen US-Dollar von Wix übernommene Vibe-Coding-Plattform, die damals erst sechs Monate alt war und über ein Team von acht Mitarbeitern verfügte, hat damit begonnen, ihr eigenes KI-Modell einzusetzen, um Nutzern
Bayer nutzt Iambic AI, um die Arzneimittelforschung zu beschleunigen
Dr. Jürgen Eckhardt ist Leiter der Abteilung für Geschäftsentwicklung und Lizenzierung bei Bayer Pharmaceuticals.Bayer nutzt Iambic Therapeutics, um innovative KI-Modelle für die Wirkstoffforschung ei
Multiverse Computing bringt kostenloses komprimiertes generatives KI-Modell auf den Markt
Große Sprachmodelle stehen vor einer großen Herausforderung: ihrer immensen Größe. Das spanische Start-up Multiverse Computing geht dieses Problem an, indem es komprimierte Modelle entwickelt, die die
Empfehlungen zu verwandten Spezialthemen
Chatbot
 Die besten KI-Rollenspiel-Chat-Apps für Sprachpraxis, Vorstellungsgesprächsvorbereitung und tägliche Sprechflüssigkeit
2026 Neueste Besten Top-bewerteten KI-Rollenspiel-Chat-Apps für Sprachpraxis, Vorstellungsgesprächsvorbereitung und tägliche Sprachflüssigkeit! XIX.AI kuratiert eine leistungsstarke, spielfeldverändernde Sammlung, die kostenlose gegen kostenpflichtige Vergleiche, reale Tests und wöchentlich aktualisierte Rankings bietet. Diese unbedingt auszuprobierenden Tools helfen Ihnen, Ihre Schreibfähigkeiten zu verbessern, Hürden der Sprachflüssigkeit zu überwinden und die Kommunikationseffizienz in allen alltäglichen Szenarien zu steigern. Entdecken Sie jetzt Ihr perfektes Werkzeug für Ihre Sprachentwicklung!
 10 Tools
 xix.ai
Musikkomposition
KI-Tools zur Stim-Trennung für die Remix-Produktion, die Vorbereitung von Samples und Karaoke-Master
Die besten und am besten bewerteten KI-Tools zur Stem-Trennung des Jahres 2026 – speziell ausgewählt für Remix-Produktionen, die Vorbereitung von Samples und Karaoke-Masters. Diese leistungsstarken, bahnbrechenden Tools haben sich in der Praxis bewährt und bieten präzise Audioisolierung, wodurch die Produktivität erheblich gesteigert wird. XIX.AI stellt einen wöchentlich aktualisierten Vergleichsleitfaden zwischen kostenlosen und kostenpflichtigen Lösungen bereit, der Ihnen hilft, die für Ihre Anforderungen passende Lösung zu finden, die Sie unbedingt ausprobieren sollten. Entdecken Sie ihn jetzt und sichern Sie sich Ihren KI-Vorteil.
8 Tools
xix.ai
Datenanalyse
KI-basierte SQL-Copiloten für Umsatz-Dashboards, Kanalanalysen sowie Produktmetriken
2026: Die neuesten und besten AI-SQL-Copiloten – alle in der Rangliste ganz oben! XIX.AI sammelt eine leistungsstarke Auswahl an Tools, die wöchentlich mit aktualisierten Tests aus der Praxis erweitert wird. Mit diesen unverzichtbaren Werkzeugen können Sie präzise Umsatzübersichten erstellen, Verkaufsprozesse analysieren sowie Produktmetriken schnell überwachen und so Ihre Produktivität erheblich steigern. Entdecken Sie jetzt das perfekte Tool für datenbasierte Entscheidungsfindung! 238 Zeichen
9 Tools
xix.ai
Musikkomposition
Die besten KI-Tools zum Komponieren von Melodien für Songentwürfe
2026 Neueste Besten Top-Bewerteten KI-Melodie-Schreibtools für Songentwürfe! XIX.AI hat eine hochleistungsfähige, bahnbrechende Kollektion zusammengestellt, die strengen Praxistests unterzogen wurde, um das beste Schreiberlebnis zu liefern. Sie finden detaillierte kostenlose versus kostenpflichtige Vergleiche, präzise Ranglisten und unbedingt auszuprobierende Optionen, die darauf ausgelegt sind, Ihnen zu helfen, beeindruckende Songentwürfe mühelos zu erstellen und Ihre kreative Produktivität erheblich zu steigern. Entdecken Sie jetzt Ihr perfektes Tool!
8 Tools
xix.ai
Chatbot
Die besten KI-gestützten Gesprächstrainingstools für Vorstellungsgesprächspraxis
2026 Neueste Besten Top-bewerteten KI-Konversationstrainer-Tools für Vorstellungsgesprächspraxis sind hier auf XIX.AI! Diese kuratierte Sammlung enthält leistungsstarke, bahnbrechende Tools, die strengen Praxistests unterzogen wurden, um präzises Feedback zu liefern. Sie finden einen Vergleich zwischen kostenlosen und kostenpflichtigen Optionen sowie detaillierte Rankings, die Ihnen helfen, die empfehlenswerte Option zu wählen, die Ihr Selbstvertrauen und Ihre Fähigkeiten verbessert. Entdecken Sie jetzt Ihr perfektes Tool für den Erfolg im Vorstellungsgespräch!
12 Tools
xix.ai
Design & Kunst
Die besten KI-Tools für den Stiltransfer für kreative Experimente
Die besten und am besten bewerteten KI-Tools für den Stiltransfer im Jahr 2026 – ideal für kreative Experimente! XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung unverzichtbarer Tools zusammengestellt, die in Praxistests und strengen Bewertungen außergewöhnliche Ergebnisse liefern. Diese Top-Lösungen helfen Kreativen dabei, ihre Produktivität deutlich zu steigern, indem sie die Erstellung von Inhalten beschleunigen und unendliche kreative Möglichkeiten eröffnen. Entdecken Sie jetzt Ihr perfektes Tool und legen Sie noch heute los!
9 Tools
xix.ai

 Kommentare (2)
![DonaldLee]()
Interesting approach! Giving LLMs a memory system could be a game-changer for automating complex workflows. I wonder how the cost savings compare to other optimization methods out there. The collaboration between academia and industry on this is promising. 🧠
![HarperJones]()
이 기술이 LLM 에이전트의 처리 효율을 높여줘서 정말 흥미롭네요! 하지만 실제 서비스에서 이렇게 동적 메모리가 잘 작동할까요? 복잡한 작업에서 성능이 안정적으로 유지되는지 궁금해요. 🤔 AI 비용 절감이 중요한 만큼 더 많은 연구가 필요해 보입니다.
Eine neue Technik, die von der Universität Zhejiang und der Alibaba Group entwickelt wurde, stattet Agenten für große Sprachmodelle (Large Language Model, LLM) mit einem dynamischen Gedächtnis aus und steigert so ihre Effizienz und Effektivität bei der Bewältigung komplexer Aufgaben. Dieser Ansatz mit dem Namen Memp stattet Agenten mit einem "Verfahrensgedächtnis" aus, das sich mit zunehmender Erfahrung ständig aktualisiert und die Art und Weise widerspiegelt, wie Menschen durch wiederholtes Üben lernen.
Memp schafft ein lebenslanges Lernsystem, bei dem die Agenten nicht mehr bei jeder neuen Aufgabe bei Null anfangen müssen. Wenn sie in realen Umgebungen mit neuen Szenarien konfrontiert werden, verbessern sie sich stetig und werden effizienter - ein entscheidendes Merkmal für eine zuverlässige Unternehmensautomatisierung.
Die Bedeutung des prozeduralen Gedächtnisses bei KI-Agenten
LLM-Agenten haben ein großes Potenzial für die Automatisierung komplizierter, mehrstufiger Geschäftsvorgänge. In der Praxis können diese erweiterten Aufgaben jedoch fehleranfällig sein. Die Forscher betonen, dass unerwartete Probleme - wie Netzwerkunterbrechungen, Aktualisierungen der Benutzeroberfläche oder veränderte Datenformate - den gesamten Arbeitsablauf unterbrechen können. Dies zwingt die Agenten derzeit oft dazu, jedes Mal von vorne zu beginnen, was zu Verzögerungen und höheren Kosten führt.
Gleichzeitig haben viele komplexe Aufgaben, auch wenn sie oberflächlich betrachtet unterschiedlich erscheinen, grundlegende strukturelle Ähnlichkeiten. Anstatt diese Muster jedes Mal neu zu erlernen, sollte ein Agent in der Lage sein, aus seinen früheren Erfahrungen - sowohl aus Erfolgen als auch aus Misserfolgen - zu schöpfen und diese wiederzuverwenden, wie die Forscher betonen. Dies erfordert ein spezielles "prozedurales Gedächtnis", ähnlich dem menschlichen Langzeitgedächtnis für Fähigkeiten wie Tippen oder Radfahren, die durch Wiederholung zur zweiten Natur werden.
Den meisten aktuellen Agentensystemen fehlt diese Funktionalität. Ihr prozedurales Wissen wird in der Regel von den Entwicklern manuell programmiert, in unflexiblen Eingabeaufforderungsvorlagen gespeichert oder in die Parameter des Modells eingebettet, die sich nur mit hohem Aufwand und langsam ändern lassen. Selbst bestehende Frameworks mit Speichererweiterungen bieten nur grobe Abstraktionen und gehen nicht richtig darauf ein, wie Fähigkeiten entwickelt, indiziert, verfeinert und während des Lebenszyklus eines Agenten verwaltet werden sollten.
Wie die Forscher in ihrem Papier feststellen, "gibt es keinen prinzipiellen Weg, um zu quantifizieren, wie effizient ein Agent sein prozedurales Repertoire entwickelt, oder um zu garantieren, dass neue Erfahrungen die Leistung verbessern und nicht verschlechtern."
Wie Memp funktioniert
Memp ist ein aufgabenunabhängiger Rahmen, der das prozedurale Gedächtnis als eine grundlegende, optimierbare Komponente behandelt. Es arbeitet mit drei Kernphasen, die einen kontinuierlichen Zyklus bilden: Aufbau, Abruf und Aktualisierung des Gedächtnisses.
Erinnerungen werden aus den vergangenen Erfahrungen eines Agenten oder "Trajektorien" aufgebaut. Das Team untersuchte die Speicherung dieser Erinnerungen in zwei Formen: entweder als exakte Schritt-für-Schritt-Aktionen oder durch Zusammenfassung dieser Aktionen in übergeordnete, skriptartige Abstraktionen. Wird dem Agenten eine neue Aufgabe gestellt, sucht er in seinem Gedächtnis nach den relevantesten früheren Erfahrungen. Die Forscher testeten verschiedene Methoden, darunter die Vektorsuche, um die Beschreibung der neuen Aufgabe mit früheren Abfragen abzugleichen, oder die Extraktion von Schlüsselwörtern, um die beste Übereinstimmung zu finden.
Der Aktualisierungsmechanismus ist das wichtigste Element. Memp beinhaltet mehrere Strategien, um sicherzustellen, dass sich das Gedächtnis des Agenten weiterentwickelt. Wenn ein Agent mehr Aufgaben erledigt, kann sein Gedächtnis aktualisiert werden, indem die neuen Erfahrungen hinzugefügt werden, indem nur erfolgreiche Ergebnisse herausgefiltert werden oder - was am effektivsten ist - indem Misserfolge analysiert werden, um das ursprüngliche Gedächtnis zu korrigieren und zu verbessern.
Diese Betonung eines dynamischen, anpassungsfähigen Gedächtnisses ordnet Memp in einen wachsenden Forschungsbereich ein, der sich auf die Verbesserung der Zuverlässigkeit von KI-Agenten bei langfristigen Aufgaben konzentriert. Das Projekt steht im Einklang mit anderen Initiativen wie Mem0, das wesentliche Informationen aus langen Gesprächen extrahiert und sie in strukturierten Fakten und Wissensgraphen organisiert, um die Konsistenz zu wahren. In ähnlicher Weise ermöglicht es A-MEM den Agenten, selbstständig "Gedächtnisnotizen" aus ihren Interaktionen zu erstellen und zu verknüpfen und so im Laufe der Zeit ein ausgeklügeltes Wissensnetzwerk aufzubauen.
Die Mitautorin Runnan Fang weist jedoch auf einen entscheidenden Unterschied zwischen Memp und ähnlichen Systemen hin.
"Mem0 und A-MEM sind hervorragende Arbeiten... aber sie konzentrieren sich auf das Erinnern von hervorstechenden Inhalten innerhalb einer einzelnen Trajektorie oder Konversation", erklärt Fang gegenüber VentureBeat. Im Wesentlichen helfen sie einem Agenten, sich zu erinnern, "was" passiert ist. "Memp hingegen zielt auf ein prozedurales Gedächtnis über mehrere Trajektorien hinweg." Es konzentriert sich auf "How-to"-Wissen, das bei vergleichbaren Aufgaben angewendet werden kann, so dass der Agent nicht immer wieder bei Null anfangen muss.
"Durch das Destillieren erfolgreicher Arbeitsabläufe in wiederverwendbare Verfahrensprioritäten erhöht Memp die Erfolgsquote und verkürzt die Arbeitsschritte", so Fang weiter. "Entscheidend ist, dass wir auch einen Aktualisierungsmechanismus einführen, damit dieses Verfahrensgedächtnis immer besser wird - schließlich macht Übung auch für Agenten den Meister."
Überwindung der Herausforderung des Kaltstarts
Das Lernen aus früheren Erfahrungen ist zwar ein leistungsfähiges Konzept, stellt aber eine praktische Herausforderung dar: Wie entwickelt ein Agent sein anfängliches Gedächtnis, wenn keine fehlerfreien Beispiele verfügbar sind? Das Forschungsteam geht dieses Problem des "Kaltstarts" mit einer praktischen Lösung an.
Fang beschrieb, wie Entwickler zunächst eine robuste Bewertungsmetrik definieren können, anstatt von Anfang an eine perfekte "goldene" Flugbahn zu benötigen. Diese Metrik, die regelbasiert oder von einem anderen LLM unterstützt sein kann, bewertet die Qualität der Leistung eines Agenten. "Sobald diese Metrik vorhanden ist, lassen wir hochmoderne Modelle den Arbeitsablauf des Agenten erkunden und behalten die Trajektorien mit den höchsten Punktzahlen bei", so Fang. Mit dieser Methode lässt sich schnell eine erste Sammlung wertvoller Erinnerungen zusammenstellen, so dass ein neuer Agent ohne umfangreiche manuelle Kodierung seine Fähigkeiten verbessern kann.
Memp in Aktion
Um das Framework zu evaluieren, integrierte das Team Memp in führende LLMs wie GPT-4o, Claude 3.5 Sonnet und Qwen2.5 und testete sie bei anspruchsvollen Aufgaben wie Hausarbeiten im ALFWorld-Benchmark und Informationsbeschaffung im TravelPlanner. Die Ergebnisse zeigten, dass ein Agent durch den Aufbau und den Zugriff auf das prozedurale Gedächtnis seine früheren Erfahrungen effektiv zusammenfassen und wiederverwenden kann.
In den Tests erreichten die Agenten, die Memp verwendeten, nicht nur höhere Erfolgsquoten, sondern arbeiteten auch wesentlich effizienter. Sie konnten unproduktive Erkundungen und Vermutungen vermeiden und sowohl die Anzahl der Schritte als auch die Anzahl der Token, die zur Erledigung einer Aufgabe erforderlich sind, erheblich reduzieren.
Eine besonders bemerkenswerte Entdeckung für die geschäftliche Nutzung ist, dass das prozedurale Gedächtnis übertragen werden kann. In einem Test wurde der vom leistungsstarken GPT-4o erzeugte prozedurale Speicher einem viel kleineren Modell, Qwen2.5-14B, zur Verfügung gestellt. Die Leistung des kleineren Modells verbesserte sich deutlich, die Erfolgsquote stieg und die zur Bewältigung von Aufgaben erforderlichen Schritte wurden reduziert.
Laut Fang ist dies möglich, weil kleinere Modelle in der Regel einfache, einstufige Handlungen kompetent ausführen, aber Schwierigkeiten mit langfristiger Planung und logischem Denken haben. Das prozedurale Gedächtnis des größeren Modells überbrückt diese Lücke effektiv. Das bedeutet, dass Wissen mit einem Spitzenmodell gesammelt und dann auf kleinere, kostengünstigere Modelle übertragen werden kann, ohne dass die Vorteile dieser Erfahrung verloren gehen.
Auf dem Weg zu vollständig autonomen Agenten
Durch die Integration von Funktionen zur Gedächtnisaktualisierung ermöglicht das Memp-Framework den Agenten, ihr prozedurales Wissen kontinuierlich zu entwickeln und zu verfeinern, während sie in einer realen Umgebung arbeiten. Die Forscher stellten fest, dass dies dem Agenten eine "kontinuierliche, fast lineare Beherrschung der Aufgabe" ermöglicht.
Um vollständige Autonomie zu erreichen, gibt es jedoch noch ein weiteres Hindernis: Für zahlreiche reale Aufgaben, wie die Erstellung eines Forschungsberichts, gibt es keinen eindeutigen Erfolgsindikator. Um sich weiter zu verbessern, muss ein Agent wissen, ob seine Leistung zufriedenstellend war. Fang glaubt, dass die Lösung in der Verwendung von LLMs als Bewerter liegt.
"Heutzutage kombinieren wir oft leistungsstarke Modelle mit handgeschriebenen Regeln, um die Abschlussbewertung zu berechnen", bemerkt er. "Das funktioniert, aber handgeschriebene Regeln sind unflexibel und schwer zu verallgemeinern."
Ein LLM, das als Richter fungiert, könnte das detaillierte, überwachende Feedback bieten, das ein Agent benötigt, um sich bei komplizierten, subjektiven Aufgaben selbst zu korrigieren. Dies würde den gesamten Lernprozess skalierbarer und widerstandsfähiger machen und wäre ein wichtiger Schritt auf dem Weg zu dauerhaften, flexiblen und wirklich autonomen KI-Mitarbeitern, die für eine fortschrittliche Unternehmensautomatisierung unerlässlich sind.








 Base44 stellt proprietäres KI-Modell vor, um die Abwehrfähigkeit der Vibe-Coding-Plattform zu stärken
Base44, die vor einem Jahr für 80 Millionen US-Dollar von Wix übernommene Vibe-Coding-Plattform, die damals erst sechs Monate alt war und über ein Team von acht Mitarbeitern verfügte, hat damit begonnen, ihr eigenes KI-Modell einzusetzen, um Nutzern
 Bayer nutzt Iambic AI, um die Arzneimittelforschung zu beschleunigen
Dr. Jürgen Eckhardt ist Leiter der Abteilung für Geschäftsentwicklung und Lizenzierung bei Bayer Pharmaceuticals.Bayer nutzt Iambic Therapeutics, um innovative KI-Modelle für die Wirkstoffforschung ei
 Multiverse Computing bringt kostenloses komprimiertes generatives KI-Modell auf den Markt
Große Sprachmodelle stehen vor einer großen Herausforderung: ihrer immensen Größe. Das spanische Start-up Multiverse Computing geht dieses Problem an, indem es komprimierte Modelle entwickelt, die die

2026 Neueste Besten Top-bewerteten KI-Rollenspiel-Chat-Apps für Sprachpraxis, Vorstellungsgesprächsvorbereitung und tägliche Sprachflüssigkeit! XIX.AI kuratiert eine leistungsstarke, spielfeldverändernde Sammlung, die kostenlose gegen kostenpflichtige Vergleiche, reale Tests und wöchentlich aktualisierte Rankings bietet. Diese unbedingt auszuprobierenden Tools helfen Ihnen, Ihre Schreibfähigkeiten zu verbessern, Hürden der Sprachflüssigkeit zu überwinden und die Kommunikationseffizienz in allen alltäglichen Szenarien zu steigern. Entdecken Sie jetzt Ihr perfektes Werkzeug für Ihre Sprachentwicklung!
10 Tools
xix.ai

Die besten und am besten bewerteten KI-Tools zur Stem-Trennung des Jahres 2026 – speziell ausgewählt für Remix-Produktionen, die Vorbereitung von Samples und Karaoke-Masters. Diese leistungsstarken, bahnbrechenden Tools haben sich in der Praxis bewährt und bieten präzise Audioisolierung, wodurch die Produktivität erheblich gesteigert wird. XIX.AI stellt einen wöchentlich aktualisierten Vergleichsleitfaden zwischen kostenlosen und kostenpflichtigen Lösungen bereit, der Ihnen hilft, die für Ihre Anforderungen passende Lösung zu finden, die Sie unbedingt ausprobieren sollten. Entdecken Sie ihn jetzt und sichern Sie sich Ihren KI-Vorteil.
8 Tools
xix.ai

2026: Die neuesten und besten AI-SQL-Copiloten – alle in der Rangliste ganz oben! XIX.AI sammelt eine leistungsstarke Auswahl an Tools, die wöchentlich mit aktualisierten Tests aus der Praxis erweitert wird. Mit diesen unverzichtbaren Werkzeugen können Sie präzise Umsatzübersichten erstellen, Verkaufsprozesse analysieren sowie Produktmetriken schnell überwachen und so Ihre Produktivität erheblich steigern. Entdecken Sie jetzt das perfekte Tool für datenbasierte Entscheidungsfindung! 238 Zeichen
9 Tools
xix.ai

2026 Neueste Besten Top-Bewerteten KI-Melodie-Schreibtools für Songentwürfe! XIX.AI hat eine hochleistungsfähige, bahnbrechende Kollektion zusammengestellt, die strengen Praxistests unterzogen wurde, um das beste Schreiberlebnis zu liefern. Sie finden detaillierte kostenlose versus kostenpflichtige Vergleiche, präzise Ranglisten und unbedingt auszuprobierende Optionen, die darauf ausgelegt sind, Ihnen zu helfen, beeindruckende Songentwürfe mühelos zu erstellen und Ihre kreative Produktivität erheblich zu steigern. Entdecken Sie jetzt Ihr perfektes Tool!
8 Tools
xix.ai

2026 Neueste Besten Top-bewerteten KI-Konversationstrainer-Tools für Vorstellungsgesprächspraxis sind hier auf XIX.AI! Diese kuratierte Sammlung enthält leistungsstarke, bahnbrechende Tools, die strengen Praxistests unterzogen wurden, um präzises Feedback zu liefern. Sie finden einen Vergleich zwischen kostenlosen und kostenpflichtigen Optionen sowie detaillierte Rankings, die Ihnen helfen, die empfehlenswerte Option zu wählen, die Ihr Selbstvertrauen und Ihre Fähigkeiten verbessert. Entdecken Sie jetzt Ihr perfektes Tool für den Erfolg im Vorstellungsgespräch!
12 Tools
xix.ai

Die besten und am besten bewerteten KI-Tools für den Stiltransfer im Jahr 2026 – ideal für kreative Experimente! XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung unverzichtbarer Tools zusammengestellt, die in Praxistests und strengen Bewertungen außergewöhnliche Ergebnisse liefern. Diese Top-Lösungen helfen Kreativen dabei, ihre Produktivität deutlich zu steigern, indem sie die Erstellung von Inhalten beschleunigen und unendliche kreative Möglichkeiten eröffnen. Entdecken Sie jetzt Ihr perfektes Tool und legen Sie noch heute los!
9 Tools
xix.ai

Interesting approach! Giving LLMs a memory system could be a game-changer for automating complex workflows. I wonder how the cost savings compare to other optimization methods out there. The collaboration between academia and industry on this is promising. 🧠
이 기술이 LLM 에이전트의 처리 효율을 높여줘서 정말 흥미롭네요! 하지만 실제 서비스에서 이렇게 동적 메모리가 잘 작동할까요? 복잡한 작업에서 성능이 안정적으로 유지되는지 궁금해요. 🤔 AI 비용 절감이 중요한 만큼 더 많은 연구가 필요해 보입니다.












