


 家
私はコーディングテストを介してGPT -4oを入れました、そしてそれはそれらを拡張しました - 1つの奇妙な結果を除いて
技術界をフォローしているなら、OpenAIが最新の大規模言語モデルGPT-4oをリリースしたことをご存知でしょう。"o"は"omni"を意味します。この新モデルはテキスト、グラフィック、音声での汎用性を約束し、私は標準のコーディングテストでその性能を試すのが待ちきれませんでした。これらのテストはさまざまなAIモデルに対して実行され、非常に興味深い結果が得られました。最後まで読んでください、驚くべき展開がありますよ。
自分で実験したい場合は、このガイドをチェックしてください:AIチャットボットのコーディング能力をテストする方法 - あなたもできます。私が使用するすべてのテストと、その仕組みや結果で何を見るべきかの詳細な説明が記載されています。
では、GPT-4oがMicrosoft Copilot、Meta AI、Meta Code Llama、Google Gemini Advanced、ChatGPTの旧バージョンと比較してどうだったか、テストごとの結果を見ていきましょう。
1. WordPressプラグインの作成
GPT-4oのユーザーインターフェースを少し見てみましょう:
興味深いことに、GPT-4oはJavaScriptファイルを含め、両方のフィールドの行数を動的に更新しました。プロンプトでJavaScriptを明確に禁止していなかったため、この創造的なアプローチは予想外で効果的でした。JavaScriptはRandomizeボタンの機能も強化し、ページ全体をリフレッシュせずに複数の結果セットを可能にします。
行は正しく配置され、重複も仕様通りに適切に分離されていました。コードはしっかりしており、1つだけ小さな不満:Randomizeボタンが独立した行に配置されていなかった点ですが、プロンプトで指定していなかったので減点はありません。
これと以前のテストの総合結果は以下の通りです:
- ChatGPT GPT-4o: インターフェース:良好、機能:良好
- Microsoft Copilot: インターフェース:適切、機能:失敗
- Meta AI: インターフェース:適切、機能:失敗
- Meta Code Llama: 完全な失敗
- Google Gemini Advanced: インターフェース:良好、機能:失敗
- ChatGPT 4: インターフェース:良好、機能:良好
- ChatGPT 3.5: インターフェース:良好、機能:良好
2. 文字列関数の書き換え
このテストは、ドルとセントの変換を扱うモデルの能力を評価します。GPT-4oは後続の行で問題を引き起こす可能性のある入力を拒否するコードを書き換え、有効なドルとセントの値のみが処理されるようにしました。
.75のような値に自動で0を付けて0.75に変換しなかった点には少し失望しました。しかし、この機能を明示的に要求していなかったので、AIのミスではありません。AIが機能的なコードを提供しても、正確なニーズを得るにはプロンプトを調整する必要があることを思い出させます。
これと以前のテストの総合結果は以下の通りです:
- ChatGPT GPT-4o: 成功
- Microsoft Copilot: 失敗
- Meta AI: 失敗
- Meta Code Llama: 成功
- Google Gemini Advanced: 失敗
- ChatGPT 4: 成功
- ChatGPT 3.5: 成功
3. 厄介なバグの発見
このテストは、解決策がすぐには明らかでないため興味深いです。私自身がコーディング中にこのエラーで最初は困惑し、最初のChatGPTモデルに助けを求めました。それは即座にエラーを見つけ、当時としては驚くべきことでした。
対照的に、テストした他の3つのLLMはこの問題の誤った方向性を見逃しました。エラーメッセージはコードの1つの部分を指しますが、実際の問題は別の場所にあり、WordPressフレームワークの深い知識が必要です。
幸い、GPT-4oは問題を正確に特定し、修正方法を正確に説明しました。
これと以前のテストの総合結果は以下の通りです:
- ChatGPT GPT-4o: 成功
- Microsoft Copilot: 失敗。壮観に。熱心に。絵文字付きで。
- Meta AI: 成功
- Meta Code Llama: 失敗
- Google Gemini Advanced: 失敗
- ChatGPT 4: 成功
- ChatGPT 3.5: 成功
これまでGPT-4oは3つすべてで成功しています。最後のテストでどうなるか見てみましょう。
4. スクリプトの作成
このテストに対し、GPT-4oは私が求めた以上のものを提供しました。テストでは、Keyboard Maestro、AppleのAppleScript、Chromeのスクリプト動作という珍しいMacスクリプティングツールを使用します。ちなみに、Keyboard Maestroは私にとって革新的で、OSやアプリケーションを再プログラムできるため、Macを生産性の主力にしています。
合格するには、Keyboard Maestroコード、AppleScript、Chrome API機能を組み合わせた解決策を正確に概要する必要があります。
驚くべきことに、GPT-4oは2つの異なるバージョンを提供しました:
両方のバージョンはKeyboard Maestroと正しく連携しましたが、大文字小文字の扱いが異なります。左のバージョンはAppleScriptが「as lowercase」をサポートしないため誤っていました。右のバージョンは「contains」を使用し、大文字小文字を区別せず、問題なく動作しました。
GPT-4oは動作するコードを提供したので、慎重ながら合格とします。しかし、2つの選択肢を返し、その1つが誤っていたため、どれが正しいかを評価するのに余計な作業が必要でした。それは自分でコードを書くのと同じくらい時間がかかったかもしれません。
これと以前のテストの総合結果は以下の通りです:
- ChatGPT GPT-4o: 成功、ただし留保付き
- Microsoft Copilot: 失敗
- Meta AI: 失敗
- Meta Code Llama: 失敗
- Google Gemini Advanced: 成功
- ChatGPT 4: 成功
- ChatGPT 3.5: 失敗
総合結果
4つのテストにおける全モデルの結果は以下の通りです:
- ChatGPT GPT-4o: 4/4成功、ただし1つの奇妙な二択回答あり
- Microsoft Copilot: 0/4成功
- Meta AI: 1/4成功
- Meta Code Llama: 1/4成功
- Google Gemini Advanced: 1/4成功
- ChatGPT 4: 4/4成功
- ChatGPT 3.5: 3/4成功
これまで、ChatGPTはコーディング支援の主力でした。いつも期待に応えてくれます(そうでない場合を除く)。他のAIは私のテストでほとんど失敗しました。しかし、GPT-4oは最後の二択回答で予想外の展開を見せました。このモデル内で何が起こっているのか、なぜそのような不具合が生じたのか疑問に思います。
それでも、GPT-4oは私のコーディングテストで最高のパフォーマーなので、その癖に慣れるために使い続けるでしょう。あるいは、ChatGPT PlusのGPT-3.5やGPT-4に戻るかもしれません。次にChatGPTがモデルを更新したら、4つのテストすべてで正しい回答を一貫して選べるか再テストします。続報をお楽しみに。
これらのAIモデルでコーディングを試したことがありますか?あなたの経験はどうでしたか?以下のコメントで教えてください。
関連記事
 ベクサー、スペースXのロケットを活用して軌道上の半導体工場を建設
宇宙での製造や製品を地球へ持ち帰る方法は、現在、限られた手法に依存しています。具体的には、国際宇宙ステーション(ISS)へのアクセス機会を待つか、軌道上からペイロードを持ち帰ることができる宇宙船を打ち上げる特定のスタートアップ企業と提携するかのいずれかです。しかし、宇宙と地球の間で最も頻繁に往復しているのはスペースXの「ファルコン9」ブースターであり、昨年は163回のミッションを完了し、今年はすで
オープンソースに関する梁文峰の発言:残業なしで6倍の利益、オープンソースに連動して100倍の収益
DeepSeekの投資家向けプラットフォームでの内部議論が最近漏洩したことに続き、創業者の梁文鋒氏は、同社のオープンソース戦略の背景にある意図を明確に説明しました。彼は「我々は間違いなくオープンソース化する。最も強力なモデルも含めて」と断言し、独自モデルをクローズドに保つことは明確な利点をもたらさないと指摘しました。これは、オープンソースの取り組みが商業的成功にどう結びつくかという財務的な根拠を彼が初めて示したものです。オープンソース化は6倍のリターンを維持しつつ、100倍の upside を制
Androidのバッテリー消費に関する一般的な問題を解決する方法は?
あなたのスマートフォンは頻繁に故障します。画面が警告なしに割れます。バッテリー寿命が一晩で尽きます。充電機能全体が停止します。オーディオが突然途切れます。修理費用はすぐに積み重なります。DIY修理で、技術者を雇うことなくほとんどの問題に対処できます。基本的な知識と適切な工具があれば、作業は完了します。開始前に問題を特定するデバイスのどの部分が壊れたか推測しないでください。正確な診断は時間と節約につながります。ソフトウェアの不具合はハードウェアの故障を模倣することがよくあります。動作が遅い電話は、
関連特集おすすめ
デザインとアート
 おすすめのAIイラスト作成ツール:編集用シーンや表紙アートを素早く作成
2026年最新・高評価のAIイラストレーションツール:当サイトが厳選したこのリストには、見事な編集用シーンや人目を引く表紙アートを素早く作成できる、高性能なツールが掲載されています。各ツールは実環境での厳格なテストを経ており、無料版と有料版の比較も掲載されているため、ご自身のワークフローに最適なツールを見つけるのに役立ちます。 今すぐこれらの「必見」ソリューションを試して、AIの力を最大限に活用し、クリエイティブな生産性を高めましょう。XIX.AIで今すぐチェックしてください。
 10 ツール
 xix.ai
教育と学習
試験対策に最適なAIチューター:数学、理科、英語の練習
2026年最新の、試験対策で高評価を得ている最高のAIチューターがXIX.AIに登場!厳選されたこのリストには、無料版と有料版の比較、実戦的なテスト、毎週更新されるランキングなどを提供する、画期的なツールが勢ぞろいしています。これらは、ライティングの効率を高め、複雑なトピックの学習を簡素化し、あなたの学業的な可能性を引き出すのに役立ちます。 今すぐチェックして、あなたにぴったりの試験対策ツールを見つけ、今日から作成を始めて、AIの力を最大限に活用しましょう!
10 ツール
xix.ai
ファイナンス
個人のお金管理のためのAI予算計画ツール
2026年の最新・最高評価のAI予算管理ツールがXIX.AIで登場!この厳選コレクションは、現実的なテストを行い、支出習慣を理解し、生産性を高めるためのパーソナライズされた計画を作成するのに役立つ革新的なソリューションを提供しています。無料版と有料版の比較や詳細なランキングもご用意しています。お金の管理を簡素化し、AIの優位性を引き出すためにぜひ試してほしいツールです。今すぐチェックしましょう!
11 ツール
xix.ai
健康とウェルネス
AI睡眠追跡アシスタント:より良い就寝習慣で回復力を高める
2026年最新かつ最高評価を受けているAI睡眠追跡アシスタントを厳選し、最適な回復を実現できるようご紹介します。完全に更新されたこの週間ガイドには、実際のテスト結果や無料版と有料版の比較、詳細なランキングなど、睡眠の質を向上させてより良い就寝習慣をサポートする最適なソリューションを見つけるのに役立つ強力なツールが掲載されています。今すぐXIX.AIでご覧ください。
10 ツール
xix.ai
データ分析
製品および収益分析のためのAI SQLコパイロット
2026年版 製品・収益分析に最適な、高評価のAI SQLコパイロット最新ランキング! XIX.AIは、毎週更新されるランキングを通じて実環境でのテストを経た、強力で画期的な「ぜひ試すべきツール」を厳選しました。これらのツールは、データ分析を加速させ、複雑なクエリを効率化し、正確なインサイトを生成することで、ユーザーの生産性を大幅に向上させ、より賢明なビジネス意思決定を後押しします。今すぐチェックして、AIの真価を引き出すあなたにぴったりのツールを見つけましょう!
14 ツール
xix.ai
教育と学習
学びを促進する最高のAI宿題支援ツール:答えだけでなく、概念を学べる
2026年最新・最高評価のAI宿題サポートツール。単なる答えだけでなく、核心となる概念を教える、学生にとって強力なツール。ぜひ試してほしい厳選リスト。毎週更新。無料版と有料版の比較、実地テストによる正確なランキングで、あなたの学習能力を最大限に引き出します。今すぐチェックして、よりスマートな学習を実現するあなたにぴったりのツールを見つけましょう。
10 ツール
xix.ai

 コメント (22)
0/500
![RoyMartínez]()
GPT-4o klingt beeindruckend, aber diese 'eine seltsame Ausnahme' macht mich neugierig. Was war das für ein seltsames Ergebnis? Vielleicht ein Hinweis darauf, dass KI bei bestimmten Logikaufgaben immer noch überraschend 'menschlich' scheitern kann? 🤔 Die Omni-Fähigkeiten sind cool, aber ich frage mich, wie stabil die Performance in allen Modi wirklich ist.
![PaulYoung]()
Bon article ! Les tests de programmation sont toujours révélateurs. Je me demande s’il y a des biais selon les langages utilisés pour l'entraînement… Ou peut-être que c’est lié à la façon dont la requête est formulée ? 🤔
![JonathanAllen]()
GPT-4o é impressionante, passando na maioria dos meus testes de codificação! Mas aquele resultado estranho me deixou confuso. Ainda assim, é versátil em texto, gráficos e voz. Se ao menos pudesse explicar aquele resultado estranho, seria perfeito! 🤔
![WillHarris]()
GPT-4o thật ấn tượng, vượt qua hầu hết các bài kiểm tra mã hóa của tôi! Nhưng kết quả lạ đó làm tôi bối rối. Tuy nhiên, nó rất linh hoạt trong văn bản, đồ họa và giọng nói. Giá mà nó có thể giải thích kết quả lạ đó, thì sẽ hoàn hảo! 🤔
![DonaldGonzález]()
GPT-4oは私のコードテストのほとんどを完璧にこなすので感動しました!しかし、その一つの奇妙な結果が気になりました。それでも、テキスト、グラフィック、音声での多様性は素晴らしいです。あの奇妙な結果を説明できれば完璧だったのに!🤔
![JustinAnderson]()
¡El GPT-4o me impresionó con sus habilidades de codificación! Pasó todos mis tests excepto por un resultado extraño que me dejó pensando. Su versatilidad en texto, gráficos y voz es genial! Pero ese fallo, hay que arreglarlo, OpenAI! 😎
技術界をフォローしているなら、OpenAIが最新の大規模言語モデルGPT-4oをリリースしたことをご存知でしょう。"o"は"omni"を意味します。この新モデルはテキスト、グラフィック、音声での汎用性を約束し、私は標準のコーディングテストでその性能を試すのが待ちきれませんでした。これらのテストはさまざまなAIモデルに対して実行され、非常に興味深い結果が得られました。最後まで読んでください、驚くべき展開がありますよ。
自分で実験したい場合は、このガイドをチェックしてください:AIチャットボットのコーディング能力をテストする方法 - あなたもできます。私が使用するすべてのテストと、その仕組みや結果で何を見るべきかの詳細な説明が記載されています。
では、GPT-4oがMicrosoft Copilot、Meta AI、Meta Code Llama、Google Gemini Advanced、ChatGPTの旧バージョンと比較してどうだったか、テストごとの結果を見ていきましょう。
1. WordPressプラグインの作成
GPT-4oのユーザーインターフェースを少し見てみましょう:
興味深いことに、GPT-4oはJavaScriptファイルを含め、両方のフィールドの行数を動的に更新しました。プロンプトでJavaScriptを明確に禁止していなかったため、この創造的なアプローチは予想外で効果的でした。JavaScriptはRandomizeボタンの機能も強化し、ページ全体をリフレッシュせずに複数の結果セットを可能にします。
行は正しく配置され、重複も仕様通りに適切に分離されていました。コードはしっかりしており、1つだけ小さな不満:Randomizeボタンが独立した行に配置されていなかった点ですが、プロンプトで指定していなかったので減点はありません。
これと以前のテストの総合結果は以下の通りです:
- ChatGPT GPT-4o: インターフェース:良好、機能:良好
- Microsoft Copilot: インターフェース:適切、機能:失敗
- Meta AI: インターフェース:適切、機能:失敗
- Meta Code Llama: 完全な失敗
- Google Gemini Advanced: インターフェース:良好、機能:失敗
- ChatGPT 4: インターフェース:良好、機能:良好
- ChatGPT 3.5: インターフェース:良好、機能:良好
2. 文字列関数の書き換え
このテストは、ドルとセントの変換を扱うモデルの能力を評価します。GPT-4oは後続の行で問題を引き起こす可能性のある入力を拒否するコードを書き換え、有効なドルとセントの値のみが処理されるようにしました。
.75のような値に自動で0を付けて0.75に変換しなかった点には少し失望しました。しかし、この機能を明示的に要求していなかったので、AIのミスではありません。AIが機能的なコードを提供しても、正確なニーズを得るにはプロンプトを調整する必要があることを思い出させます。
これと以前のテストの総合結果は以下の通りです:
- ChatGPT GPT-4o: 成功
- Microsoft Copilot: 失敗
- Meta AI: 失敗
- Meta Code Llama: 成功
- Google Gemini Advanced: 失敗
- ChatGPT 4: 成功
- ChatGPT 3.5: 成功
3. 厄介なバグの発見
このテストは、解決策がすぐには明らかでないため興味深いです。私自身がコーディング中にこのエラーで最初は困惑し、最初のChatGPTモデルに助けを求めました。それは即座にエラーを見つけ、当時としては驚くべきことでした。
対照的に、テストした他の3つのLLMはこの問題の誤った方向性を見逃しました。エラーメッセージはコードの1つの部分を指しますが、実際の問題は別の場所にあり、WordPressフレームワークの深い知識が必要です。
幸い、GPT-4oは問題を正確に特定し、修正方法を正確に説明しました。
これと以前のテストの総合結果は以下の通りです:
- ChatGPT GPT-4o: 成功
- Microsoft Copilot: 失敗。壮観に。熱心に。絵文字付きで。
- Meta AI: 成功
- Meta Code Llama: 失敗
- Google Gemini Advanced: 失敗
- ChatGPT 4: 成功
- ChatGPT 3.5: 成功
これまでGPT-4oは3つすべてで成功しています。最後のテストでどうなるか見てみましょう。
4. スクリプトの作成
このテストに対し、GPT-4oは私が求めた以上のものを提供しました。テストでは、Keyboard Maestro、AppleのAppleScript、Chromeのスクリプト動作という珍しいMacスクリプティングツールを使用します。ちなみに、Keyboard Maestroは私にとって革新的で、OSやアプリケーションを再プログラムできるため、Macを生産性の主力にしています。
合格するには、Keyboard Maestroコード、AppleScript、Chrome API機能を組み合わせた解決策を正確に概要する必要があります。
驚くべきことに、GPT-4oは2つの異なるバージョンを提供しました:
両方のバージョンはKeyboard Maestroと正しく連携しましたが、大文字小文字の扱いが異なります。左のバージョンはAppleScriptが「as lowercase」をサポートしないため誤っていました。右のバージョンは「contains」を使用し、大文字小文字を区別せず、問題なく動作しました。
GPT-4oは動作するコードを提供したので、慎重ながら合格とします。しかし、2つの選択肢を返し、その1つが誤っていたため、どれが正しいかを評価するのに余計な作業が必要でした。それは自分でコードを書くのと同じくらい時間がかかったかもしれません。
これと以前のテストの総合結果は以下の通りです:
- ChatGPT GPT-4o: 成功、ただし留保付き
- Microsoft Copilot: 失敗
- Meta AI: 失敗
- Meta Code Llama: 失敗
- Google Gemini Advanced: 成功
- ChatGPT 4: 成功
- ChatGPT 3.5: 失敗
総合結果
4つのテストにおける全モデルの結果は以下の通りです:
- ChatGPT GPT-4o: 4/4成功、ただし1つの奇妙な二択回答あり
- Microsoft Copilot: 0/4成功
- Meta AI: 1/4成功
- Meta Code Llama: 1/4成功
- Google Gemini Advanced: 1/4成功
- ChatGPT 4: 4/4成功
- ChatGPT 3.5: 3/4成功
これまで、ChatGPTはコーディング支援の主力でした。いつも期待に応えてくれます(そうでない場合を除く)。他のAIは私のテストでほとんど失敗しました。しかし、GPT-4oは最後の二択回答で予想外の展開を見せました。このモデル内で何が起こっているのか、なぜそのような不具合が生じたのか疑問に思います。
それでも、GPT-4oは私のコーディングテストで最高のパフォーマーなので、その癖に慣れるために使い続けるでしょう。あるいは、ChatGPT PlusのGPT-3.5やGPT-4に戻るかもしれません。次にChatGPTがモデルを更新したら、4つのテストすべてで正しい回答を一貫して選べるか再テストします。続報をお楽しみに。
これらのAIモデルでコーディングを試したことがありますか?あなたの経験はどうでしたか?以下のコメントで教えてください。








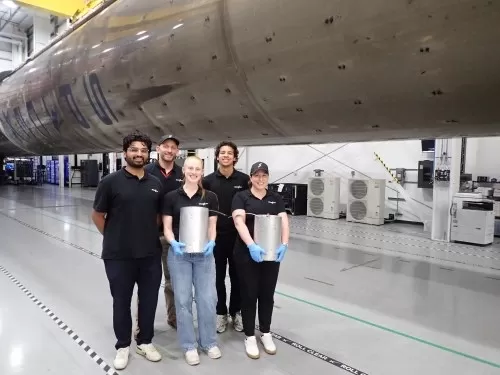 ベクサー、スペースXのロケットを活用して軌道上の半導体工場を建設
宇宙での製造や製品を地球へ持ち帰る方法は、現在、限られた手法に依存しています。具体的には、国際宇宙ステーション(ISS)へのアクセス機会を待つか、軌道上からペイロードを持ち帰ることができる宇宙船を打ち上げる特定のスタートアップ企業と提携するかのいずれかです。しかし、宇宙と地球の間で最も頻繁に往復しているのはスペースXの「ファルコン9」ブースターであり、昨年は163回のミッションを完了し、今年はすで
 オープンソースに関する梁文峰の発言:残業なしで6倍の利益、オープンソースに連動して100倍の収益
DeepSeekの投資家向けプラットフォームでの内部議論が最近漏洩したことに続き、創業者の梁文鋒氏は、同社のオープンソース戦略の背景にある意図を明確に説明しました。彼は「我々は間違いなくオープンソース化する。最も強力なモデルも含めて」と断言し、独自モデルをクローズドに保つことは明確な利点をもたらさないと指摘しました。これは、オープンソースの取り組みが商業的成功にどう結びつくかという財務的な根拠を彼が初めて示したものです。オープンソース化は6倍のリターンを維持しつつ、100倍の upside を制
 Androidのバッテリー消費に関する一般的な問題を解決する方法は?
あなたのスマートフォンは頻繁に故障します。画面が警告なしに割れます。バッテリー寿命が一晩で尽きます。充電機能全体が停止します。オーディオが突然途切れます。修理費用はすぐに積み重なります。DIY修理で、技術者を雇うことなくほとんどの問題に対処できます。基本的な知識と適切な工具があれば、作業は完了します。開始前に問題を特定するデバイスのどの部分が壊れたか推測しないでください。正確な診断は時間と節約につながります。ソフトウェアの不具合はハードウェアの故障を模倣することがよくあります。動作が遅い電話は、

2026年最新・高評価のAIイラストレーションツール:当サイトが厳選したこのリストには、見事な編集用シーンや人目を引く表紙アートを素早く作成できる、高性能なツールが掲載されています。各ツールは実環境での厳格なテストを経ており、無料版と有料版の比較も掲載されているため、ご自身のワークフローに最適なツールを見つけるのに役立ちます。 今すぐこれらの「必見」ソリューションを試して、AIの力を最大限に活用し、クリエイティブな生産性を高めましょう。XIX.AIで今すぐチェックしてください。
10 ツール
xix.ai

2026年最新の、試験対策で高評価を得ている最高のAIチューターがXIX.AIに登場!厳選されたこのリストには、無料版と有料版の比較、実戦的なテスト、毎週更新されるランキングなどを提供する、画期的なツールが勢ぞろいしています。これらは、ライティングの効率を高め、複雑なトピックの学習を簡素化し、あなたの学業的な可能性を引き出すのに役立ちます。 今すぐチェックして、あなたにぴったりの試験対策ツールを見つけ、今日から作成を始めて、AIの力を最大限に活用しましょう!
10 ツール
xix.ai

2026年の最新・最高評価のAI予算管理ツールがXIX.AIで登場!この厳選コレクションは、現実的なテストを行い、支出習慣を理解し、生産性を高めるためのパーソナライズされた計画を作成するのに役立つ革新的なソリューションを提供しています。無料版と有料版の比較や詳細なランキングもご用意しています。お金の管理を簡素化し、AIの優位性を引き出すためにぜひ試してほしいツールです。今すぐチェックしましょう!
11 ツール
xix.ai

2026年最新かつ最高評価を受けているAI睡眠追跡アシスタントを厳選し、最適な回復を実現できるようご紹介します。完全に更新されたこの週間ガイドには、実際のテスト結果や無料版と有料版の比較、詳細なランキングなど、睡眠の質を向上させてより良い就寝習慣をサポートする最適なソリューションを見つけるのに役立つ強力なツールが掲載されています。今すぐXIX.AIでご覧ください。
10 ツール
xix.ai

2026年版 製品・収益分析に最適な、高評価のAI SQLコパイロット最新ランキング! XIX.AIは、毎週更新されるランキングを通じて実環境でのテストを経た、強力で画期的な「ぜひ試すべきツール」を厳選しました。これらのツールは、データ分析を加速させ、複雑なクエリを効率化し、正確なインサイトを生成することで、ユーザーの生産性を大幅に向上させ、より賢明なビジネス意思決定を後押しします。今すぐチェックして、AIの真価を引き出すあなたにぴったりのツールを見つけましょう!
14 ツール
xix.ai

2026年最新・最高評価のAI宿題サポートツール。単なる答えだけでなく、核心となる概念を教える、学生にとって強力なツール。ぜひ試してほしい厳選リスト。毎週更新。無料版と有料版の比較、実地テストによる正確なランキングで、あなたの学習能力を最大限に引き出します。今すぐチェックして、よりスマートな学習を実現するあなたにぴったりのツールを見つけましょう。
10 ツール
xix.ai

GPT-4o klingt beeindruckend, aber diese 'eine seltsame Ausnahme' macht mich neugierig. Was war das für ein seltsames Ergebnis? Vielleicht ein Hinweis darauf, dass KI bei bestimmten Logikaufgaben immer noch überraschend 'menschlich' scheitern kann? 🤔 Die Omni-Fähigkeiten sind cool, aber ich frage mich, wie stabil die Performance in allen Modi wirklich ist.
Bon article ! Les tests de programmation sont toujours révélateurs. Je me demande s’il y a des biais selon les langages utilisés pour l'entraînement… Ou peut-être que c’est lié à la façon dont la requête est formulée ? 🤔
GPT-4o é impressionante, passando na maioria dos meus testes de codificação! Mas aquele resultado estranho me deixou confuso. Ainda assim, é versátil em texto, gráficos e voz. Se ao menos pudesse explicar aquele resultado estranho, seria perfeito! 🤔
GPT-4o thật ấn tượng, vượt qua hầu hết các bài kiểm tra mã hóa của tôi! Nhưng kết quả lạ đó làm tôi bối rối. Tuy nhiên, nó rất linh hoạt trong văn bản, đồ họa và giọng nói. Giá mà nó có thể giải thích kết quả lạ đó, thì sẽ hoàn hảo! 🤔
GPT-4oは私のコードテストのほとんどを完璧にこなすので感動しました!しかし、その一つの奇妙な結果が気になりました。それでも、テキスト、グラフィック、音声での多様性は素晴らしいです。あの奇妙な結果を説明できれば完璧だったのに!🤔
¡El GPT-4o me impresionó con sus habilidades de codificación! Pasó todos mis tests excepto por un resultado extraño que me dejó pensando. Su versatilidad en texto, gráficos y voz es genial! Pero ese fallo, hay que arreglarlo, OpenAI! 😎












