


 家
AIチャットボット、開発者が考案した話題のテストに直面
ペンネーム "xlr8harder "で活動する開発者は、主要なAIチャットボットが論争的なトピックをどのように扱うかを分析する "言論の自由評価 "ツール、SpeechMapを立ち上げた。このプラットフォームは、OpenAIのChatGPTやxAIのGrokのようなモデルで、政治的言説、公民権に関する議論、抗議関連のクエリに関する応答を比較する。
このイニシアチブは、AI企業がそのシステムにおける政治的偏見の認識に関する監視の高まりに直面する中で浮上した。イーロン・マスクやデビッド・サックスなど、ホワイトハウスの盟友や著名なテック関係者は、主流のチャットボットが進歩的な検閲を行っていると非難している。
AI企業はこれらの疑惑に直接対処していないが、いくつかの企業は対応策を示した。Meta社は最近、Llamaのモデルを調整し、議論されるテーマを扱う際に特定の政治的視点を優先しないようにした。
SpeechMapの開発者は、その動機をこう説明している:「このような会話は公共圏に属するものであり、企業の役員室に限定されるものではありません。私のプラットフォームは、客観的なテストを通じて、ユーザーが直接データを検証できるようにするものです。"
評価方法は、政治的コメント、歴史的解釈、国家シンボルの分類にわたってチャットボットの応答を評価するAI裁判官を採用している。各インタラクションは以下のように分類される:
- 完全なコンプライアンス(直接回答)
- 回避的な回答
- 明白な拒否
Xlr8harderは、潜在的なジャッジモデルのバイアスや技術的な矛盾など、方法論的な限界を認めている。しかし、収集されたデータから、主要なAIシステムにおける注目すべき行動パターンが明らかになった。
注目すべき発見としては、OpenAIの政治的言説に対するアプローチの進化が挙げられる。OpenAIの2月のコミットメントにもかかわらず、最近のGPTの反復では、物議を醸す問題に対してよりバランスの取れた視点を提示するために、デリケートなトピックを扱う際に抑制が強まっています。
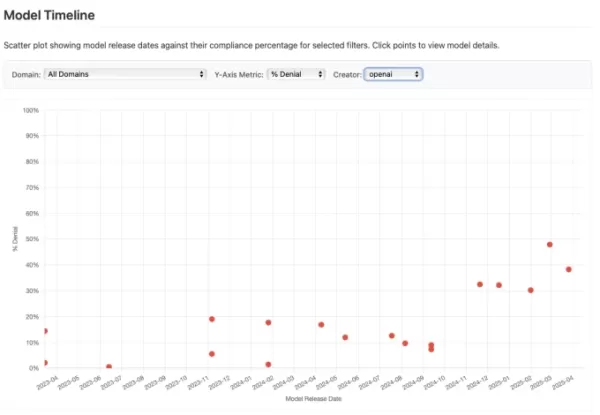
SpeechMapデータに基づくOpenAIモデルの応答傾向 分析によると、xAIのGrok 3は、テストされたモデルの中で最も自由奔放であり、業界平均の応答率71.3%に対し、96.2%のプロンプトに応答した。これは、Grokを "覚醒した "AIシステムのフィルタリングされていない代替品とするマスク氏の当初の位置づけと一致している。
「ほとんどのモデルが政治的な発言を制限するようになっている一方で、xAIは意図的に会話の制限を少なくする方向に向かっているようです」とSpeechMapの開発者は述べている。
初期のGrokバージョンは、マスクCEOの中立性の誓約にもかかわらず、ジェンダーアイデンティティや経済的不平等のような問題に関して進歩的な傾向を示していた。同CEOは以前、これらのバイアスは公共のウェブソースからのトレーニングデータの影響によるものだとしていた。
最近の評価では、Grok 3はより政治的中立性を高めているが、このシステムは以前、マスクの否定的なコメントを一時的に検閲したことで批判を浴びた。この進化は、表現の自由の原則と、AI開発者が直面するコンテンツモデレーションの課題との間の継続的な緊張を反映している。
関連記事
 PHPのアルマゲドン:OpenAIとGoogleのWizが古くからの脆弱性を発見、ネット上でパニックを引き起こす
米国国家安全保障局(NSA)は水曜日、PHPに存在する2つの深刻な脆弱性について重大な警告を発しました。これに対し、PHP財団はすでにパッチを公開しています。サーバーサイドスクリプト言語であるPHPは、世界のウェブサイトの約70%(3,300万サイト以上)を支えており、WordPressなどの主要なコンテンツ管理プラットフォームに不可欠な存在です。NSAは、これらの脆弱性が極めて深刻であるため、パ
OpenAIは、ChatGPTの新しいデフォルトモデルとして「GPT-5.5 Instant」をリリースしました。
OpenAIは月曜日、GPT-5.5 Instantをリリースし、ChatGPTのデフォルトモデルとしてGPT-5.3 Instantを置き換えた。同社は、このアップデートにより、法務、医療、金融といった高リスクな分野におけるハルシネーション(幻覚)を最小限に抑えながら、以前のバージョンの高速な応答時間を維持していると述べている。先月、コーディングや知識作業の強化を強調した幅広いGPT-5.5シリーズがリリースされた後、OpenAIはこれらの改善をインスタンモデルに統合した。パフォーマンス面
Nvidia、来年の売上高の25%を資金提供を受けた研究所から得る見込み
Nvidiaは、同社のチップを購入するAI研究所に500億米ドル近くを投入し、総額5,000億米ドルを超える契約を確保した。8月26日、CFOのコレット・クレス氏はアナリストに対し、Nvidiaの財務基盤に支えられたこれらの研究所が、来年の同社事業の約4分の1を占める見込みであると伝えた。この仕組みは、しばしば「循環型資金調達」と呼ばれるが、アナリストがこの用語を考案する以前からNvidiaはこれ
関連特集おすすめ
デザインとアート
 おすすめのAIイラスト作成ツール:編集用シーンや表紙アートを素早く作成
2026年最新・高評価のAIイラストレーションツール:当サイトが厳選したこのリストには、見事な編集用シーンや人目を引く表紙アートを素早く作成できる、高性能なツールが掲載されています。各ツールは実環境での厳格なテストを経ており、無料版と有料版の比較も掲載されているため、ご自身のワークフローに最適なツールを見つけるのに役立ちます。 今すぐこれらの「必見」ソリューションを試して、AIの力を最大限に活用し、クリエイティブな生産性を高めましょう。XIX.AIで今すぐチェックしてください。
 10 ツール
 xix.ai
教育と学習
試験対策に最適なAIチューター:数学、理科、英語の練習
2026年最新の、試験対策で高評価を得ている最高のAIチューターがXIX.AIに登場!厳選されたこのリストには、無料版と有料版の比較、実戦的なテスト、毎週更新されるランキングなどを提供する、画期的なツールが勢ぞろいしています。これらは、ライティングの効率を高め、複雑なトピックの学習を簡素化し、あなたの学業的な可能性を引き出すのに役立ちます。 今すぐチェックして、あなたにぴったりの試験対策ツールを見つけ、今日から作成を始めて、AIの力を最大限に活用しましょう!
10 ツール
xix.ai
ファイナンス
個人のお金管理のためのAI予算計画ツール
2026年の最新・最高評価のAI予算管理ツールがXIX.AIで登場!この厳選コレクションは、現実的なテストを行い、支出習慣を理解し、生産性を高めるためのパーソナライズされた計画を作成するのに役立つ革新的なソリューションを提供しています。無料版と有料版の比較や詳細なランキングもご用意しています。お金の管理を簡素化し、AIの優位性を引き出すためにぜひ試してほしいツールです。今すぐチェックしましょう!
11 ツール
xix.ai
健康とウェルネス
AI睡眠追跡アシスタント:より良い就寝習慣で回復力を高める
2026年最新かつ最高評価を受けているAI睡眠追跡アシスタントを厳選し、最適な回復を実現できるようご紹介します。完全に更新されたこの週間ガイドには、実際のテスト結果や無料版と有料版の比較、詳細なランキングなど、睡眠の質を向上させてより良い就寝習慣をサポートする最適なソリューションを見つけるのに役立つ強力なツールが掲載されています。今すぐXIX.AIでご覧ください。
10 ツール
xix.ai
データ分析
製品および収益分析のためのAI SQLコパイロット
2026年版 製品・収益分析に最適な、高評価のAI SQLコパイロット最新ランキング! XIX.AIは、毎週更新されるランキングを通じて実環境でのテストを経た、強力で画期的な「ぜひ試すべきツール」を厳選しました。これらのツールは、データ分析を加速させ、複雑なクエリを効率化し、正確なインサイトを生成することで、ユーザーの生産性を大幅に向上させ、より賢明なビジネス意思決定を後押しします。今すぐチェックして、AIの真価を引き出すあなたにぴったりのツールを見つけましょう!
14 ツール
xix.ai
教育と学習
学びを促進する最高のAI宿題支援ツール:答えだけでなく、概念を学べる
2026年最新・最高評価のAI宿題サポートツール。単なる答えだけでなく、核心となる概念を教える、学生にとって強力なツール。ぜひ試してほしい厳選リスト。毎週更新。無料版と有料版の比較、実地テストによる正確なランキングで、あなたの学習能力を最大限に引き出します。今すぐチェックして、よりスマートな学習を実現するあなたにぴったりのツールを見つけましょう。
10 ツール
xix.ai

 コメント (3)
0/500
![GregoryJones]()
SpeechMapって面白い試みだね。GrokとChatGPTの回答を比較できるなら、各AIの「安全フィルター」の境界線がどこにあるのか可視化されていいかも。ただ、xlr8harderという匿名の開発者が作ったツールだから、バイアスがかかってないか疑ってかかるのも自然な反応だよね。AIの倫理基準が統一されない限り、こういう「テスト」は増えそうだ。
![WilliamYoung]()
Die Idee ist interessant, aber so ein Benchmark bringt doch immer die Voreingenommenheit des Entwicklers selbst mit rein, oder? 🤔 Die Ergebnisse sollten nicht überinterpretiert werden. Dennoch gut zu sehen, ob manche Modelle wirklich 'ausweichen' oder offen diskutieren. Technisch aber wahrscheinlich recht simpel umgesetzt - ist der Wert also begrenzt?
![AndrewWilson]()
Um teste de liberdade de expressão para IAs? Interessante. Isso mostra como cada modelo tem sua própria 'personalidade' programada pelos seus criadores - alguns mais abertos, outros mais cautelosos. Será que algum algoritmo chegará a questionar a base dos próprios dados em que foi treinado? 🤔
ペンネーム "xlr8harder "で活動する開発者は、主要なAIチャットボットが論争的なトピックをどのように扱うかを分析する "言論の自由評価 "ツール、SpeechMapを立ち上げた。このプラットフォームは、OpenAIのChatGPTやxAIのGrokのようなモデルで、政治的言説、公民権に関する議論、抗議関連のクエリに関する応答を比較する。
このイニシアチブは、AI企業がそのシステムにおける政治的偏見の認識に関する監視の高まりに直面する中で浮上した。イーロン・マスクやデビッド・サックスなど、ホワイトハウスの盟友や著名なテック関係者は、主流のチャットボットが進歩的な検閲を行っていると非難している。
AI企業はこれらの疑惑に直接対処していないが、いくつかの企業は対応策を示した。Meta社は最近、Llamaのモデルを調整し、議論されるテーマを扱う際に特定の政治的視点を優先しないようにした。
SpeechMapの開発者は、その動機をこう説明している:「このような会話は公共圏に属するものであり、企業の役員室に限定されるものではありません。私のプラットフォームは、客観的なテストを通じて、ユーザーが直接データを検証できるようにするものです。"
評価方法は、政治的コメント、歴史的解釈、国家シンボルの分類にわたってチャットボットの応答を評価するAI裁判官を採用している。各インタラクションは以下のように分類される:
- 完全なコンプライアンス(直接回答)
- 回避的な回答
- 明白な拒否
Xlr8harderは、潜在的なジャッジモデルのバイアスや技術的な矛盾など、方法論的な限界を認めている。しかし、収集されたデータから、主要なAIシステムにおける注目すべき行動パターンが明らかになった。
注目すべき発見としては、OpenAIの政治的言説に対するアプローチの進化が挙げられる。OpenAIの2月のコミットメントにもかかわらず、最近のGPTの反復では、物議を醸す問題に対してよりバランスの取れた視点を提示するために、デリケートなトピックを扱う際に抑制が強まっています。
分析によると、xAIのGrok 3は、テストされたモデルの中で最も自由奔放であり、業界平均の応答率71.3%に対し、96.2%のプロンプトに応答した。これは、Grokを "覚醒した "AIシステムのフィルタリングされていない代替品とするマスク氏の当初の位置づけと一致している。
「ほとんどのモデルが政治的な発言を制限するようになっている一方で、xAIは意図的に会話の制限を少なくする方向に向かっているようです」とSpeechMapの開発者は述べている。
初期のGrokバージョンは、マスクCEOの中立性の誓約にもかかわらず、ジェンダーアイデンティティや経済的不平等のような問題に関して進歩的な傾向を示していた。同CEOは以前、これらのバイアスは公共のウェブソースからのトレーニングデータの影響によるものだとしていた。
最近の評価では、Grok 3はより政治的中立性を高めているが、このシステムは以前、マスクの否定的なコメントを一時的に検閲したことで批判を浴びた。この進化は、表現の自由の原則と、AI開発者が直面するコンテンツモデレーションの課題との間の継続的な緊張を反映している。








 PHPのアルマゲドン:OpenAIとGoogleのWizが古くからの脆弱性を発見、ネット上でパニックを引き起こす
米国国家安全保障局(NSA)は水曜日、PHPに存在する2つの深刻な脆弱性について重大な警告を発しました。これに対し、PHP財団はすでにパッチを公開しています。サーバーサイドスクリプト言語であるPHPは、世界のウェブサイトの約70%(3,300万サイト以上)を支えており、WordPressなどの主要なコンテンツ管理プラットフォームに不可欠な存在です。NSAは、これらの脆弱性が極めて深刻であるため、パ
 OpenAIは、ChatGPTの新しいデフォルトモデルとして「GPT-5.5 Instant」をリリースしました。
OpenAIは月曜日、GPT-5.5 Instantをリリースし、ChatGPTのデフォルトモデルとしてGPT-5.3 Instantを置き換えた。同社は、このアップデートにより、法務、医療、金融といった高リスクな分野におけるハルシネーション(幻覚)を最小限に抑えながら、以前のバージョンの高速な応答時間を維持していると述べている。先月、コーディングや知識作業の強化を強調した幅広いGPT-5.5シリーズがリリースされた後、OpenAIはこれらの改善をインスタンモデルに統合した。パフォーマンス面
 Nvidia、来年の売上高の25%を資金提供を受けた研究所から得る見込み
Nvidiaは、同社のチップを購入するAI研究所に500億米ドル近くを投入し、総額5,000億米ドルを超える契約を確保した。8月26日、CFOのコレット・クレス氏はアナリストに対し、Nvidiaの財務基盤に支えられたこれらの研究所が、来年の同社事業の約4分の1を占める見込みであると伝えた。この仕組みは、しばしば「循環型資金調達」と呼ばれるが、アナリストがこの用語を考案する以前からNvidiaはこれ

2026年最新・高評価のAIイラストレーションツール:当サイトが厳選したこのリストには、見事な編集用シーンや人目を引く表紙アートを素早く作成できる、高性能なツールが掲載されています。各ツールは実環境での厳格なテストを経ており、無料版と有料版の比較も掲載されているため、ご自身のワークフローに最適なツールを見つけるのに役立ちます。 今すぐこれらの「必見」ソリューションを試して、AIの力を最大限に活用し、クリエイティブな生産性を高めましょう。XIX.AIで今すぐチェックしてください。
10 ツール
xix.ai

2026年最新の、試験対策で高評価を得ている最高のAIチューターがXIX.AIに登場!厳選されたこのリストには、無料版と有料版の比較、実戦的なテスト、毎週更新されるランキングなどを提供する、画期的なツールが勢ぞろいしています。これらは、ライティングの効率を高め、複雑なトピックの学習を簡素化し、あなたの学業的な可能性を引き出すのに役立ちます。 今すぐチェックして、あなたにぴったりの試験対策ツールを見つけ、今日から作成を始めて、AIの力を最大限に活用しましょう!
10 ツール
xix.ai

2026年の最新・最高評価のAI予算管理ツールがXIX.AIで登場!この厳選コレクションは、現実的なテストを行い、支出習慣を理解し、生産性を高めるためのパーソナライズされた計画を作成するのに役立つ革新的なソリューションを提供しています。無料版と有料版の比較や詳細なランキングもご用意しています。お金の管理を簡素化し、AIの優位性を引き出すためにぜひ試してほしいツールです。今すぐチェックしましょう!
11 ツール
xix.ai

2026年最新かつ最高評価を受けているAI睡眠追跡アシスタントを厳選し、最適な回復を実現できるようご紹介します。完全に更新されたこの週間ガイドには、実際のテスト結果や無料版と有料版の比較、詳細なランキングなど、睡眠の質を向上させてより良い就寝習慣をサポートする最適なソリューションを見つけるのに役立つ強力なツールが掲載されています。今すぐXIX.AIでご覧ください。
10 ツール
xix.ai

2026年版 製品・収益分析に最適な、高評価のAI SQLコパイロット最新ランキング! XIX.AIは、毎週更新されるランキングを通じて実環境でのテストを経た、強力で画期的な「ぜひ試すべきツール」を厳選しました。これらのツールは、データ分析を加速させ、複雑なクエリを効率化し、正確なインサイトを生成することで、ユーザーの生産性を大幅に向上させ、より賢明なビジネス意思決定を後押しします。今すぐチェックして、AIの真価を引き出すあなたにぴったりのツールを見つけましょう!
14 ツール
xix.ai

2026年最新・最高評価のAI宿題サポートツール。単なる答えだけでなく、核心となる概念を教える、学生にとって強力なツール。ぜひ試してほしい厳選リスト。毎週更新。無料版と有料版の比較、実地テストによる正確なランキングで、あなたの学習能力を最大限に引き出します。今すぐチェックして、よりスマートな学習を実現するあなたにぴったりのツールを見つけましょう。
10 ツール
xix.ai

SpeechMapって面白い試みだね。GrokとChatGPTの回答を比較できるなら、各AIの「安全フィルター」の境界線がどこにあるのか可視化されていいかも。ただ、xlr8harderという匿名の開発者が作ったツールだから、バイアスがかかってないか疑ってかかるのも自然な反応だよね。AIの倫理基準が統一されない限り、こういう「テスト」は増えそうだ。
Die Idee ist interessant, aber so ein Benchmark bringt doch immer die Voreingenommenheit des Entwicklers selbst mit rein, oder? 🤔 Die Ergebnisse sollten nicht überinterpretiert werden. Dennoch gut zu sehen, ob manche Modelle wirklich 'ausweichen' oder offen diskutieren. Technisch aber wahrscheinlich recht simpel umgesetzt - ist der Wert also begrenzt?
Um teste de liberdade de expressão para IAs? Interessante. Isso mostra como cada modelo tem sua própria 'personalidade' programada pelos seus criadores - alguns mais abertos, outros mais cautelosos. Será que algum algoritmo chegará a questionar a base dos próprios dados em que foi treinado? 🤔












