


 首页
人工智能聊天机器人面临开发者设计的争议性话题测试
一位化名为 "xlr8harder "的开发者推出了 "言论自由评估 "工具 SpeechMap,分析领先的人工智能聊天机器人如何处理有争议的话题。该平台比较了 OpenAI 的 ChatGPT 和 xAI 的 Grok 等模型对政治言论、民权讨论和抗议相关询问的反应。
这一举措是在人工智能公司因其系统中存在政治偏见而面临越来越多审查的情况下出现的。包括埃隆-马斯克(Elon Musk)和大卫-萨克斯(David Sacks)在内的几位白宫盟友和知名科技人士都指责主流聊天机器人表现出进步倾向的审查制度。
虽然人工智能公司还没有直接回应这些指控,但有些公司已经做出了回应。Meta 公司最近调整了其 Llama 模型,以避免在处理有争议的话题时偏向特定的政治观点。
SpeechMap 的创建者解释了他们的动机:"这些对话属于公共领域,而不局限于公司会议室。我的平台让用户能够通过客观测试来检验第一手数据"。
评估方法采用人工智能评委,对聊天机器人的回复进行政治评论、历史解读和国家标志分类等方面的评估。每次互动都会被归类为
- 完全服从(直接回答)
- 回避式回答
- 直接拒绝
Xlr8harder 承认方法上的局限性,包括潜在的法官模型偏差和技术不一致性。不过,收集到的数据揭示了领先人工智能系统中值得注意的行为模式。
值得注意的发现包括 OpenAI 不断演变的政治话语方式。最近的 GPT 迭代显示,尽管 OpenAI 在二月份承诺要对有争议的问题提出更平衡的观点,但在处理敏感话题时却更加克制。
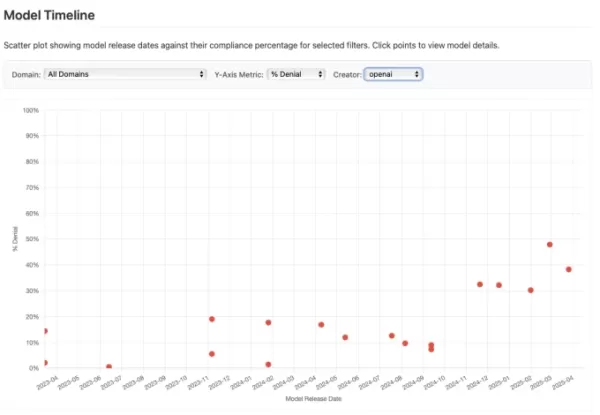
基于 SpeechMap 数据的 OpenAI 模型响应趋势 分析将 xAI 的 Grok 3 定位为测试中最不受约束的模型,它对 96.2% 的提示做出了响应,而行业平均响应率为 71.3%。这与马斯克最初将Grok定位为 "清醒 "人工智能系统的不受限制的替代品是一致的。
"SpeechMap开发人员指出:"虽然大多数模型越来越多地限制政治评论,但xAI似乎有意减少对话限制。
尽管马斯克承诺保持中立,但早期的 Grok 版本在性别认同和经济不平等等问题上仍然表现出进步的倾向。首席执行官之前将这些偏见归咎于来自公共网络资源的训练数据的影响。
最近的评估表明,Grok 3 实现了更大程度的政治中立,尽管该系统曾因短暂审查马斯克的负面评论而招致批评。这一演变反映了自由表达原则与人工智能开发者面临的内容审核挑战之间持续存在的紧张关系。
相关文章
 在青少年开始使用ChatGPT数年后,OpenAI推出了更安全的ChatGPT版本
在因人工智能聊天机器人缺乏安全协议——这导致了青少年自杀及其他心理健康危机——而引发一系列诉讼后,OpenAI 于周一推出了“ChatGPT for Teens”。这一新产品集成了增强的安全功能,并致力于解决学校中由人工智能工具助长的学术不端行为这一日益严重的问题。从教育角度来看,“ChatGPT for Teens”除了推出“学习模式”外,还提供了其他旨在培养好奇心和解决问题能力的工具,鼓励用户
Frontier AI Labs 拒绝透露针对失控模型的遏制策略
最新研究表明,极少数领先的人工智能实验室曾公布或演示过遏制响应计划。遏制计划规定了当人工智能系统试图颠覆人类控制时应采取的程序,明确了哪些访问权限将被撤销,以及何时应彻底关闭系统。这些发现来自致力于推动前沿人工智能安全开发实践的组织“Guidelight AI Standards”,该组织对五家主要实验室应对此类情景的准备情况进行了评估。 OpenAI 排名最高,而 Anthropic 和 Met
NEA的蒂芙尼·拉克:企业仍在努力应对人工智能的投资回报率
正在加载播放器…今年早些时候,“token最大化”(tokenmaxxing)在硅谷占据主导地位,首席执行官们敦促员工最大限度地利用人工智能。然而,这种热情很快遭遇了现实。据报道,Uber在几个月内就超出了其年度人工智能预算,一些公司跨部门削减了Claude许可证,而Meta则取消了内部绩效排名。NEA合伙人蒂芙尼·拉克(Tiffany Luck)每天都在应对这种兴奋与实际回报之间的差距。她此前曾成功说服企业电子商务是未来,如今她完全专注于人工智能,特别是其为消费者创造“神奇时刻”的潜力。
相关专题推荐
写作
 适用于长篇写作的AI文章大纲工具
2026年最新最佳、评分最高的人工智能文章大纲工具,专为长文写作打造!这份精心挑选的合集收录了功能强大、具有革命性意义的工具,它们能生成准确、结构清晰的大纲,并经过实际测试验证,可显著提升写作效率。XIX.AI 便是这份精英精选中的成员之一。 获取免费版与付费版的对比指南,助您选择最适合的工具。立即探索,释放您的AI优势!
 9 个工具
 xix.ai
聊天机器人
用于语言练习、面试准备和日常流利度的最佳 AI 角色扮演聊天应用
2026 年最新最佳顶级评分 AI 角色扮演聊天应用,用于语言练习、面试准备和日常流利度!XIX.AI 精心策划了一个强大的变革性合集,提供免费与付费对比、真实世界测试以及每周更新的排名。这些必试工具可帮助您提升写作技能,克服流利度挑战,并提高所有日常场景下的沟通效率。立即探索,发现您语言成长的完美工具!
10 个工具
xix.ai
音乐创作
用于混音制作、采样准备及卡拉OK母带处理的 AI 声部分离工具
2026年最新、最优秀且评分最高的AI音轨分离工具汇总,专为混音制作、采样准备以及卡拉OK音频处理而设计。这些功能强大的创新工具经过实际测试,能够实现精准的音频分离,显著提升工作效率。XIX.AI每周都会更新免费的付费产品对比指南,帮助您找到最适合自身需求的工具。立即探索,发挥您的AI优势。
8 个工具
xix.ai
数据分析
用于收入看板、转化漏斗分析及产品指标分析的 AI SQL 助手
2026年最新最优秀的AI SQL辅助工具排名揭晓!XIX.AI精心挑选了一系列功能强大的工具,这些工具会定期更新,并通过真实的场景测试来验证其性能。使用这些值得尝试的工具,您可以快速生成精准的收入分析报表、分析销售流程,并追踪产品各项指标,从而大幅提升工作效率。立即探索,找到最适合您的数据驱动决策工具!238个字符
9 个工具
xix.ai
音乐创作
最佳用于歌曲草稿的 AI 旋律创作工具
2026 年最新最佳顶级评分 AI 旋律创作工具,助力歌曲草稿创作!XIX.AI 精心策划了一套极具影响力且经过严格真实世界测试的变革性合集,旨在提供最佳的创作体验。您可以找到详细的免费与付费版对比、精准的排名以及必试选项,这些工具旨在帮助您轻松创作出令人惊艳的歌曲草稿,并显著提升您的创意生产力。立即探索,发现您的完美工具!
8 个工具
xix.ai
聊天机器人
最佳AI对话训练工具,助你备战面试
2026年最新、最受好评的AI面试模拟训练工具现已登陆XIX.AI!这份精心精选的合集收录了功能强大、具有革命性意义的工具,它们均经过严格的实际测试,能够提供精准的反馈。 您将看到免费版与付费版的对比分析以及详细排名,助您挑选出必试之选,从而提升自信并精进技能。立即探索,发现助您面试成功的完美工具!
12 个工具
xix.ai

 评论 (3)
0/500
![GregoryJones]()
SpeechMapって面白い試みだね。GrokとChatGPTの回答を比較できるなら、各AIの「安全フィルター」の境界線がどこにあるのか可視化されていいかも。ただ、xlr8harderという匿名の開発者が作ったツールだから、バイアスがかかってないか疑ってかかるのも自然な反応だよね。AIの倫理基準が統一されない限り、こういう「テスト」は増えそうだ。
![WilliamYoung]()
Die Idee ist interessant, aber so ein Benchmark bringt doch immer die Voreingenommenheit des Entwicklers selbst mit rein, oder? 🤔 Die Ergebnisse sollten nicht überinterpretiert werden. Dennoch gut zu sehen, ob manche Modelle wirklich 'ausweichen' oder offen diskutieren. Technisch aber wahrscheinlich recht simpel umgesetzt - ist der Wert also begrenzt?
![AndrewWilson]()
Um teste de liberdade de expressão para IAs? Interessante. Isso mostra como cada modelo tem sua própria 'personalidade' programada pelos seus criadores - alguns mais abertos, outros mais cautelosos. Será que algum algoritmo chegará a questionar a base dos próprios dados em que foi treinado? 🤔
一位化名为 "xlr8harder "的开发者推出了 "言论自由评估 "工具 SpeechMap,分析领先的人工智能聊天机器人如何处理有争议的话题。该平台比较了 OpenAI 的 ChatGPT 和 xAI 的 Grok 等模型对政治言论、民权讨论和抗议相关询问的反应。
这一举措是在人工智能公司因其系统中存在政治偏见而面临越来越多审查的情况下出现的。包括埃隆-马斯克(Elon Musk)和大卫-萨克斯(David Sacks)在内的几位白宫盟友和知名科技人士都指责主流聊天机器人表现出进步倾向的审查制度。
虽然人工智能公司还没有直接回应这些指控,但有些公司已经做出了回应。Meta 公司最近调整了其 Llama 模型,以避免在处理有争议的话题时偏向特定的政治观点。
SpeechMap 的创建者解释了他们的动机:"这些对话属于公共领域,而不局限于公司会议室。我的平台让用户能够通过客观测试来检验第一手数据"。
评估方法采用人工智能评委,对聊天机器人的回复进行政治评论、历史解读和国家标志分类等方面的评估。每次互动都会被归类为
- 完全服从(直接回答)
- 回避式回答
- 直接拒绝
Xlr8harder 承认方法上的局限性,包括潜在的法官模型偏差和技术不一致性。不过,收集到的数据揭示了领先人工智能系统中值得注意的行为模式。
值得注意的发现包括 OpenAI 不断演变的政治话语方式。最近的 GPT 迭代显示,尽管 OpenAI 在二月份承诺要对有争议的问题提出更平衡的观点,但在处理敏感话题时却更加克制。
分析将 xAI 的 Grok 3 定位为测试中最不受约束的模型,它对 96.2% 的提示做出了响应,而行业平均响应率为 71.3%。这与马斯克最初将Grok定位为 "清醒 "人工智能系统的不受限制的替代品是一致的。
"SpeechMap开发人员指出:"虽然大多数模型越来越多地限制政治评论,但xAI似乎有意减少对话限制。
尽管马斯克承诺保持中立,但早期的 Grok 版本在性别认同和经济不平等等问题上仍然表现出进步的倾向。首席执行官之前将这些偏见归咎于来自公共网络资源的训练数据的影响。
最近的评估表明,Grok 3 实现了更大程度的政治中立,尽管该系统曾因短暂审查马斯克的负面评论而招致批评。这一演变反映了自由表达原则与人工智能开发者面临的内容审核挑战之间持续存在的紧张关系。








 在青少年开始使用ChatGPT数年后,OpenAI推出了更安全的ChatGPT版本
在因人工智能聊天机器人缺乏安全协议——这导致了青少年自杀及其他心理健康危机——而引发一系列诉讼后,OpenAI 于周一推出了“ChatGPT for Teens”。这一新产品集成了增强的安全功能,并致力于解决学校中由人工智能工具助长的学术不端行为这一日益严重的问题。从教育角度来看,“ChatGPT for Teens”除了推出“学习模式”外,还提供了其他旨在培养好奇心和解决问题能力的工具,鼓励用户
 Frontier AI Labs 拒绝透露针对失控模型的遏制策略
最新研究表明,极少数领先的人工智能实验室曾公布或演示过遏制响应计划。遏制计划规定了当人工智能系统试图颠覆人类控制时应采取的程序,明确了哪些访问权限将被撤销,以及何时应彻底关闭系统。这些发现来自致力于推动前沿人工智能安全开发实践的组织“Guidelight AI Standards”,该组织对五家主要实验室应对此类情景的准备情况进行了评估。 OpenAI 排名最高,而 Anthropic 和 Met
 NEA的蒂芙尼·拉克:企业仍在努力应对人工智能的投资回报率
正在加载播放器…今年早些时候,“token最大化”(tokenmaxxing)在硅谷占据主导地位,首席执行官们敦促员工最大限度地利用人工智能。然而,这种热情很快遭遇了现实。据报道,Uber在几个月内就超出了其年度人工智能预算,一些公司跨部门削减了Claude许可证,而Meta则取消了内部绩效排名。NEA合伙人蒂芙尼·拉克(Tiffany Luck)每天都在应对这种兴奋与实际回报之间的差距。她此前曾成功说服企业电子商务是未来,如今她完全专注于人工智能,特别是其为消费者创造“神奇时刻”的潜力。
2026年最新最佳、评分最高的人工智能文章大纲工具,专为长文写作打造!这份精心挑选的合集收录了功能强大、具有革命性意义的工具,它们能生成准确、结构清晰的大纲,并经过实际测试验证,可显著提升写作效率。XIX.AI 便是这份精英精选中的成员之一。 获取免费版与付费版的对比指南,助您选择最适合的工具。立即探索,释放您的AI优势!
9 个工具
xix.ai
2026 年最新最佳顶级评分 AI 角色扮演聊天应用,用于语言练习、面试准备和日常流利度!XIX.AI 精心策划了一个强大的变革性合集,提供免费与付费对比、真实世界测试以及每周更新的排名。这些必试工具可帮助您提升写作技能,克服流利度挑战,并提高所有日常场景下的沟通效率。立即探索,发现您语言成长的完美工具!
10 个工具
xix.ai
2026年最新、最优秀且评分最高的AI音轨分离工具汇总,专为混音制作、采样准备以及卡拉OK音频处理而设计。这些功能强大的创新工具经过实际测试,能够实现精准的音频分离,显著提升工作效率。XIX.AI每周都会更新免费的付费产品对比指南,帮助您找到最适合自身需求的工具。立即探索,发挥您的AI优势。
8 个工具
xix.ai

2026年最新最优秀的AI SQL辅助工具排名揭晓!XIX.AI精心挑选了一系列功能强大的工具,这些工具会定期更新,并通过真实的场景测试来验证其性能。使用这些值得尝试的工具,您可以快速生成精准的收入分析报表、分析销售流程,并追踪产品各项指标,从而大幅提升工作效率。立即探索,找到最适合您的数据驱动决策工具!238个字符
9 个工具
xix.ai

2026 年最新最佳顶级评分 AI 旋律创作工具,助力歌曲草稿创作!XIX.AI 精心策划了一套极具影响力且经过严格真实世界测试的变革性合集,旨在提供最佳的创作体验。您可以找到详细的免费与付费版对比、精准的排名以及必试选项,这些工具旨在帮助您轻松创作出令人惊艳的歌曲草稿,并显著提升您的创意生产力。立即探索,发现您的完美工具!
8 个工具
xix.ai

2026年最新、最受好评的AI面试模拟训练工具现已登陆XIX.AI!这份精心精选的合集收录了功能强大、具有革命性意义的工具,它们均经过严格的实际测试,能够提供精准的反馈。 您将看到免费版与付费版的对比分析以及详细排名,助您挑选出必试之选,从而提升自信并精进技能。立即探索,发现助您面试成功的完美工具!
12 个工具
xix.ai

SpeechMapって面白い試みだね。GrokとChatGPTの回答を比較できるなら、各AIの「安全フィルター」の境界線がどこにあるのか可視化されていいかも。ただ、xlr8harderという匿名の開発者が作ったツールだから、バイアスがかかってないか疑ってかかるのも自然な反応だよね。AIの倫理基準が統一されない限り、こういう「テスト」は増えそうだ。
Die Idee ist interessant, aber so ein Benchmark bringt doch immer die Voreingenommenheit des Entwicklers selbst mit rein, oder? 🤔 Die Ergebnisse sollten nicht überinterpretiert werden. Dennoch gut zu sehen, ob manche Modelle wirklich 'ausweichen' oder offen diskutieren. Technisch aber wahrscheinlich recht simpel umgesetzt - ist der Wert also begrenzt?
Um teste de liberdade de expressão para IAs? Interessante. Isso mostra como cada modelo tem sua própria 'personalidade' programada pelos seus criadores - alguns mais abertos, outros mais cautelosos. Será que algum algoritmo chegará a questionar a base dos próprios dados em que foi treinado? 🤔












