


 家
人類の主張は、AIが失速しておらず、ベンチマークを抜いています
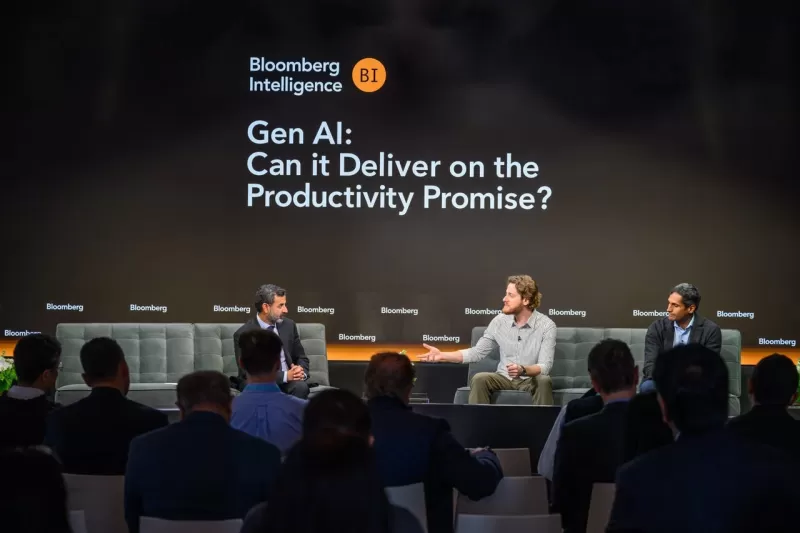
大規模言語モデル(LLM)やその他の生成AI技術は、自己修正において大きな進歩を遂げており、これが「エージェントAI」と呼ばれる新しいアプリケーションへの道を開いていると、主要なAIモデル開発企業であるAnthropicの副社長、マイケル・ガーステンハーバー氏は述べています。
「自己修正や自己推論が非常に優れてきています」と、AnthropicでAPI技術をリードするガーステンハーバー氏は、ニューヨークでのブルームバーグ・インテリジェンスのアヌラグ・ラナ氏とのインタビューで語りました。ClaudeファミリーのLLMを開発したAnthropicは、OpenAIのGPTモデルと直接競合しています。「数か月ごとに新しいモデルをリリースし、LLMの能力を拡張しています」と彼は付け加え、モデル改訂ごとに新たな可能性が開かれる業界のダイナミックな性質を強調しました。
AIモデルの新たな能力
Anthropicの最新モデルは、タスク計画などの能力を導入し、人間がコンピュータ上で行うようなタスク、例えばオンラインでピザを注文することなどを可能にしています。「昨日は実現不可能だった中間ステップの計画が、今では手の届くところにあります」とガーステンハーバー氏は、このステップごとのタスク実行について述べました。
この議論には、AIスタートアップScale AIの主任技術者ビジェイ・カルナムルティ氏も参加し、ブルームバーグ・インテリジェンスが主催する「生成AI:生産性の約束を果たせるか?」という一日会議の一部でした。
AI懐疑論への挑戦
ガーステンハーバー氏の洞察は、生成AIやより広範なAI分野が「壁にぶつかっている」と主張し、各モデルの反復で収益が減少していると考えるAI懐疑論者への挑戦です。例えば、AI学者のゲイリー・マーカス氏は2022年以来、AIモデル(パラメータの増加)の規模を大きくするだけでは性能が比例して向上しないと警告しています。
しかし、ガーステンハーバー氏は、Anthropicが現在のAIベンチマークで測定できる範囲を超えて限界を押し広げていると主張します。「一部の領域で進歩が遅れているように見えても、それは私たちが全く新しい機能を開拓しているからであり、ベンチマークや古いタスクの実行能力が飽和しているだけです」と彼は説明しました。これにより、現在の生成AIモデルが達成できることの全貌を測ることがますます難しくなっています。
スケーリングと学習
ガーステンハーバー氏とカルナムルティ氏は、生成AIモデルのスケーリングが自己修正能力を高めるために重要であると強調しました。「私たちは確実に知能のスケーリングがますます進んでいるのを見ています」とガーステンハーバー氏は述べました。カルナムルティ氏は、「計画や推論で壁にぶつかっていないと信じる理由の一つは、モデルが新しい多様な環境に適応できるようにタスクを構造化する方法をまだ学んでいるからです」と付け加えました。
ガーステンハーバー氏は同意し、「私たちは初期段階にあり、アプリケーション開発者から彼らのニーズやモデルが不足している部分を学び、それを言語モデルに統合しています」と述べました。
リアルタイム学習と適応
ガーステンハーバー氏によると、この進歩の多くは、Anthropicでの基礎研究の急速なペースと、業界からのリアルタイムのフィードバックによる学習によって推進されています。「業界が私たちに必要としていることを適応し、リアルタイムで学んでいます」と彼は述べました。
顧客はしばしば大きなモデルから始め、特定の目的に合わせてよりシンプルなモデルにスケールダウンします。「最初に、モデルがタスクを適切に実行できるほど賢いかどうかを評価し、次にアプリケーションのニーズを満たすほど速いか、そして最後に、可能な限りコスト効率が良いかを評価します」とガーステンハーバー氏は説明しました。
関連記事
 Wan-Streamer v0.2は超低遅延のAIチャットを提供します
現代技術が急速に進歩するにつれ、人間とAIの相互作用はより一般的になっています。従来のビデオ通話では、ラグ、遅延、音声と映像の非同期といった問題にしばしば直面します。Tongyi Labによる最新リリースであるWan-Streamer v0.2は、これらの課題を完全に克服し、わずか550ミリ秒の応答遅延で、真に自然な「対面」コミュニケーションを可能にします。Wan-Streamer v0.2は、新しいエンドツーエンドのマルチモーダル理解および生成モデルです。単一のTransformerモデル内で
MetaはTSMCとMicronの参加を得て、旧型メモリを搭載した新規サーバーを整備する
人工知能の採用が世界中で加速する中、次世代DDR5メモリは深刻な供給不足に直面しています。AIデータセンターの展開における遅延を回避するため、MetaはTSMCやMicronといった業界のリーダーと提携し、画期的な過渡期のソリューションを開発しました。この革新により、従来DDR5専用に設計されていた高度なAIサーバーが、従来のDDR4モジュールとシームレスに動作できるようになりました。「フランケンシュタイン」構成と称されるこのシステムは、実世界のテストで顕著な安定性を示し、現在進行中のサプライチ
時系列データベースがリアルタイムのロボティクスデータをどのように支えるか
タイガー・データのドグ・パグヌッティ。パグヌッティ氏は、タイガー・データで産業用開発者エバンジェリストを務め、実世界の産業システムの構築を支援するチームをサポートしています。石油・ガスおよび製造業の自動化分野で12年以上の経験を持つ彼は、PLC、ロボット、SCADAシステムに取り組み、その後Dell EMCおよびVTScadaでの産業用ソフトウェア開発に移行しました。彼は、大規模なIIoT展開における時系列データインフラストラクチャの課題を自動化エンジニアが解決するのを支援することで、OTとIT
関連特集おすすめ
デザインとアート
 おすすめのAIイラスト作成ツール:編集用シーンや表紙アートを素早く作成
2026年最新・高評価のAIイラストレーションツール:当サイトが厳選したこのリストには、見事な編集用シーンや人目を引く表紙アートを素早く作成できる、高性能なツールが掲載されています。各ツールは実環境での厳格なテストを経ており、無料版と有料版の比較も掲載されているため、ご自身のワークフローに最適なツールを見つけるのに役立ちます。 今すぐこれらの「必見」ソリューションを試して、AIの力を最大限に活用し、クリエイティブな生産性を高めましょう。XIX.AIで今すぐチェックしてください。
 10 ツール
 xix.ai
教育と学習
試験対策に最適なAIチューター:数学、理科、英語の練習
2026年最新の、試験対策で高評価を得ている最高のAIチューターがXIX.AIに登場!厳選されたこのリストには、無料版と有料版の比較、実戦的なテスト、毎週更新されるランキングなどを提供する、画期的なツールが勢ぞろいしています。これらは、ライティングの効率を高め、複雑なトピックの学習を簡素化し、あなたの学業的な可能性を引き出すのに役立ちます。 今すぐチェックして、あなたにぴったりの試験対策ツールを見つけ、今日から作成を始めて、AIの力を最大限に活用しましょう!
10 ツール
xix.ai
ファイナンス
個人のお金管理のためのAI予算計画ツール
2026年の最新・最高評価のAI予算管理ツールがXIX.AIで登場!この厳選コレクションは、現実的なテストを行い、支出習慣を理解し、生産性を高めるためのパーソナライズされた計画を作成するのに役立つ革新的なソリューションを提供しています。無料版と有料版の比較や詳細なランキングもご用意しています。お金の管理を簡素化し、AIの優位性を引き出すためにぜひ試してほしいツールです。今すぐチェックしましょう!
11 ツール
xix.ai
健康とウェルネス
AI睡眠追跡アシスタント:より良い就寝習慣で回復力を高める
2026年最新かつ最高評価を受けているAI睡眠追跡アシスタントを厳選し、最適な回復を実現できるようご紹介します。完全に更新されたこの週間ガイドには、実際のテスト結果や無料版と有料版の比較、詳細なランキングなど、睡眠の質を向上させてより良い就寝習慣をサポートする最適なソリューションを見つけるのに役立つ強力なツールが掲載されています。今すぐXIX.AIでご覧ください。
10 ツール
xix.ai
データ分析
製品および収益分析のためのAI SQLコパイロット
2026年版 製品・収益分析に最適な、高評価のAI SQLコパイロット最新ランキング! XIX.AIは、毎週更新されるランキングを通じて実環境でのテストを経た、強力で画期的な「ぜひ試すべきツール」を厳選しました。これらのツールは、データ分析を加速させ、複雑なクエリを効率化し、正確なインサイトを生成することで、ユーザーの生産性を大幅に向上させ、より賢明なビジネス意思決定を後押しします。今すぐチェックして、AIの真価を引き出すあなたにぴったりのツールを見つけましょう!
14 ツール
xix.ai
教育と学習
学びを促進する最高のAI宿題支援ツール:答えだけでなく、概念を学べる
2026年最新・最高評価のAI宿題サポートツール。単なる答えだけでなく、核心となる概念を教える、学生にとって強力なツール。ぜひ試してほしい厳選リスト。毎週更新。無料版と有料版の比較、実地テストによる正確なランキングで、あなたの学習能力を最大限に引き出します。今すぐチェックして、よりスマートな学習を実現するあなたにぴったりのツールを見つけましょう。
10 ツール
xix.ai

 コメント (8)
0/500
![JoseRoberts]()
This self-correction stuff is wild! 😮 It's like AI is learning to double-check its own homework. Wonder how far this 'agentic AI' will go—could it outsmart us at our own jobs soon?
![WalterAnderson]()
It's wild to think AI can now self-correct! 😮 Makes me wonder how soon we'll see these 'agentic AI' systems running our lives—hope they don’t outsmart us too much!
![RonaldMartinez]()
This article really opened my eyes to how fast AI is evolving! Self-correcting LLMs sound like a game-changer for agentic AI. Can’t wait to see what new apps come out of this! 😄
![WillieJackson]()
La perspectiva de Anthropic sobre que la IA no se estanca sino que supera los benchmarks es bastante genial. Es como si la IA estuviera jugando ajedrez mientras nosotros aún estamos tratando de entender las damas. Lo de la autocorrección suena prometedor, pero aún estoy un poco escéptico. 🤔
![GeorgeWilson]()
Anthropic의 AI가 정체되지 않고 벤치마크를 뛰어넘는다는 생각이 멋지네요. AI는 체스를 하고 있는데, 우리는 아직 체커를 이해하는 단계예요. 자기 교정 이야기는 유망하지만, 아직 조금 회의적이에요. 🤔
![NicholasCarter]()
Anthropic's take on AI not stalling but outsmarting benchmarks is pretty cool. It's like AI is playing chess while we're still figuring out checkers. The self-correction stuff sounds promising, but I'm still a bit skeptical. 🤔
大規模言語モデル(LLM)やその他の生成AI技術は、自己修正において大きな進歩を遂げており、これが「エージェントAI」と呼ばれる新しいアプリケーションへの道を開いていると、主要なAIモデル開発企業であるAnthropicの副社長、マイケル・ガーステンハーバー氏は述べています。
「自己修正や自己推論が非常に優れてきています」と、AnthropicでAPI技術をリードするガーステンハーバー氏は、ニューヨークでのブルームバーグ・インテリジェンスのアヌラグ・ラナ氏とのインタビューで語りました。ClaudeファミリーのLLMを開発したAnthropicは、OpenAIのGPTモデルと直接競合しています。「数か月ごとに新しいモデルをリリースし、LLMの能力を拡張しています」と彼は付け加え、モデル改訂ごとに新たな可能性が開かれる業界のダイナミックな性質を強調しました。
AIモデルの新たな能力
Anthropicの最新モデルは、タスク計画などの能力を導入し、人間がコンピュータ上で行うようなタスク、例えばオンラインでピザを注文することなどを可能にしています。「昨日は実現不可能だった中間ステップの計画が、今では手の届くところにあります」とガーステンハーバー氏は、このステップごとのタスク実行について述べました。
この議論には、AIスタートアップScale AIの主任技術者ビジェイ・カルナムルティ氏も参加し、ブルームバーグ・インテリジェンスが主催する「生成AI:生産性の約束を果たせるか?」という一日会議の一部でした。
AI懐疑論への挑戦
ガーステンハーバー氏の洞察は、生成AIやより広範なAI分野が「壁にぶつかっている」と主張し、各モデルの反復で収益が減少していると考えるAI懐疑論者への挑戦です。例えば、AI学者のゲイリー・マーカス氏は2022年以来、AIモデル(パラメータの増加)の規模を大きくするだけでは性能が比例して向上しないと警告しています。
しかし、ガーステンハーバー氏は、Anthropicが現在のAIベンチマークで測定できる範囲を超えて限界を押し広げていると主張します。「一部の領域で進歩が遅れているように見えても、それは私たちが全く新しい機能を開拓しているからであり、ベンチマークや古いタスクの実行能力が飽和しているだけです」と彼は説明しました。これにより、現在の生成AIモデルが達成できることの全貌を測ることがますます難しくなっています。
スケーリングと学習
ガーステンハーバー氏とカルナムルティ氏は、生成AIモデルのスケーリングが自己修正能力を高めるために重要であると強調しました。「私たちは確実に知能のスケーリングがますます進んでいるのを見ています」とガーステンハーバー氏は述べました。カルナムルティ氏は、「計画や推論で壁にぶつかっていないと信じる理由の一つは、モデルが新しい多様な環境に適応できるようにタスクを構造化する方法をまだ学んでいるからです」と付け加えました。
ガーステンハーバー氏は同意し、「私たちは初期段階にあり、アプリケーション開発者から彼らのニーズやモデルが不足している部分を学び、それを言語モデルに統合しています」と述べました。
リアルタイム学習と適応
ガーステンハーバー氏によると、この進歩の多くは、Anthropicでの基礎研究の急速なペースと、業界からのリアルタイムのフィードバックによる学習によって推進されています。「業界が私たちに必要としていることを適応し、リアルタイムで学んでいます」と彼は述べました。
顧客はしばしば大きなモデルから始め、特定の目的に合わせてよりシンプルなモデルにスケールダウンします。「最初に、モデルがタスクを適切に実行できるほど賢いかどうかを評価し、次にアプリケーションのニーズを満たすほど速いか、そして最後に、可能な限りコスト効率が良いかを評価します」とガーステンハーバー氏は説明しました。








 Wan-Streamer v0.2は超低遅延のAIチャットを提供します
現代技術が急速に進歩するにつれ、人間とAIの相互作用はより一般的になっています。従来のビデオ通話では、ラグ、遅延、音声と映像の非同期といった問題にしばしば直面します。Tongyi Labによる最新リリースであるWan-Streamer v0.2は、これらの課題を完全に克服し、わずか550ミリ秒の応答遅延で、真に自然な「対面」コミュニケーションを可能にします。Wan-Streamer v0.2は、新しいエンドツーエンドのマルチモーダル理解および生成モデルです。単一のTransformerモデル内で
 MetaはTSMCとMicronの参加を得て、旧型メモリを搭載した新規サーバーを整備する
人工知能の採用が世界中で加速する中、次世代DDR5メモリは深刻な供給不足に直面しています。AIデータセンターの展開における遅延を回避するため、MetaはTSMCやMicronといった業界のリーダーと提携し、画期的な過渡期のソリューションを開発しました。この革新により、従来DDR5専用に設計されていた高度なAIサーバーが、従来のDDR4モジュールとシームレスに動作できるようになりました。「フランケンシュタイン」構成と称されるこのシステムは、実世界のテストで顕著な安定性を示し、現在進行中のサプライチ
 時系列データベースがリアルタイムのロボティクスデータをどのように支えるか
タイガー・データのドグ・パグヌッティ。パグヌッティ氏は、タイガー・データで産業用開発者エバンジェリストを務め、実世界の産業システムの構築を支援するチームをサポートしています。石油・ガスおよび製造業の自動化分野で12年以上の経験を持つ彼は、PLC、ロボット、SCADAシステムに取り組み、その後Dell EMCおよびVTScadaでの産業用ソフトウェア開発に移行しました。彼は、大規模なIIoT展開における時系列データインフラストラクチャの課題を自動化エンジニアが解決するのを支援することで、OTとIT

2026年最新・高評価のAIイラストレーションツール:当サイトが厳選したこのリストには、見事な編集用シーンや人目を引く表紙アートを素早く作成できる、高性能なツールが掲載されています。各ツールは実環境での厳格なテストを経ており、無料版と有料版の比較も掲載されているため、ご自身のワークフローに最適なツールを見つけるのに役立ちます。 今すぐこれらの「必見」ソリューションを試して、AIの力を最大限に活用し、クリエイティブな生産性を高めましょう。XIX.AIで今すぐチェックしてください。
10 ツール
xix.ai

2026年最新の、試験対策で高評価を得ている最高のAIチューターがXIX.AIに登場!厳選されたこのリストには、無料版と有料版の比較、実戦的なテスト、毎週更新されるランキングなどを提供する、画期的なツールが勢ぞろいしています。これらは、ライティングの効率を高め、複雑なトピックの学習を簡素化し、あなたの学業的な可能性を引き出すのに役立ちます。 今すぐチェックして、あなたにぴったりの試験対策ツールを見つけ、今日から作成を始めて、AIの力を最大限に活用しましょう!
10 ツール
xix.ai

2026年の最新・最高評価のAI予算管理ツールがXIX.AIで登場!この厳選コレクションは、現実的なテストを行い、支出習慣を理解し、生産性を高めるためのパーソナライズされた計画を作成するのに役立つ革新的なソリューションを提供しています。無料版と有料版の比較や詳細なランキングもご用意しています。お金の管理を簡素化し、AIの優位性を引き出すためにぜひ試してほしいツールです。今すぐチェックしましょう!
11 ツール
xix.ai

2026年最新かつ最高評価を受けているAI睡眠追跡アシスタントを厳選し、最適な回復を実現できるようご紹介します。完全に更新されたこの週間ガイドには、実際のテスト結果や無料版と有料版の比較、詳細なランキングなど、睡眠の質を向上させてより良い就寝習慣をサポートする最適なソリューションを見つけるのに役立つ強力なツールが掲載されています。今すぐXIX.AIでご覧ください。
10 ツール
xix.ai

2026年版 製品・収益分析に最適な、高評価のAI SQLコパイロット最新ランキング! XIX.AIは、毎週更新されるランキングを通じて実環境でのテストを経た、強力で画期的な「ぜひ試すべきツール」を厳選しました。これらのツールは、データ分析を加速させ、複雑なクエリを効率化し、正確なインサイトを生成することで、ユーザーの生産性を大幅に向上させ、より賢明なビジネス意思決定を後押しします。今すぐチェックして、AIの真価を引き出すあなたにぴったりのツールを見つけましょう!
14 ツール
xix.ai

2026年最新・最高評価のAI宿題サポートツール。単なる答えだけでなく、核心となる概念を教える、学生にとって強力なツール。ぜひ試してほしい厳選リスト。毎週更新。無料版と有料版の比較、実地テストによる正確なランキングで、あなたの学習能力を最大限に引き出します。今すぐチェックして、よりスマートな学習を実現するあなたにぴったりのツールを見つけましょう。
10 ツール
xix.ai

This self-correction stuff is wild! 😮 It's like AI is learning to double-check its own homework. Wonder how far this 'agentic AI' will go—could it outsmart us at our own jobs soon?
It's wild to think AI can now self-correct! 😮 Makes me wonder how soon we'll see these 'agentic AI' systems running our lives—hope they don’t outsmart us too much!
This article really opened my eyes to how fast AI is evolving! Self-correcting LLMs sound like a game-changer for agentic AI. Can’t wait to see what new apps come out of this! 😄
La perspectiva de Anthropic sobre que la IA no se estanca sino que supera los benchmarks es bastante genial. Es como si la IA estuviera jugando ajedrez mientras nosotros aún estamos tratando de entender las damas. Lo de la autocorrección suena prometedor, pero aún estoy un poco escéptico. 🤔
Anthropic의 AI가 정체되지 않고 벤치마크를 뛰어넘는다는 생각이 멋지네요. AI는 체스를 하고 있는데, 우리는 아직 체커를 이해하는 단계예요. 자기 교정 이야기는 유망하지만, 아직 조금 회의적이에요. 🤔
Anthropic's take on AI not stalling but outsmarting benchmarks is pretty cool. It's like AI is playing chess while we're still figuring out checkers. The self-correction stuff sounds promising, but I'm still a bit skeptical. 🤔












