


 家
AMD、大規模モデルの推論を高速化する「vLLM-ATOM」プラグインをリリース
先日、AMDは「vLLM-ATOM」という新しいプラグインを正式に発表しました。その主な目的は、既存のワークフローを変更することなくハードウェアの潜在能力をさらに引き出し、DeepSeek-R1、Kimi-K2、gpt-oss-120Bといった主流の大型言語モデルにおいて、推論速度を大幅に向上させることです。
開発者にとって、vLLMは高並行環境におけるスループットとGPUメモリ使用量を最適化するように設計されたオープンソースフレームワークです。従来のシングルリクエスト型ツールとは異なり、リクエストのスケジューリングとキャッシュ管理に重点を置いています。 AMDの新しいATOMプラグインは、Instinct GPU向けに特別に構築された高度にカスタマイズされたソリューションです。その際立った特徴は「シームレスな移行」です。エンタープライズユーザーは、既存のAPIインターフェース、コマンド、またはエンドツーエンドのワークフローを変更する必要がなく、プラグインがバックグラウンドで基盤となるパフォーマンス最適化を自動的に処理します。
技術的なアーキテクチャの観点から見ると、vLLM-ATOMは厳密な3層設計を採用しています。最上層では、vLLMのリクエストスケジューリングと互換性インターフェースが維持されています。中間層であるATOMプラグインは、モデルの実装とカーネルの最適化を管理します。 最下層のAITERはGPUハードウェアに直接接続し、Flash Attention、量子化GEMM、融合MoEなどのコアとなる加速機能を提供します。
このプラグインは、主にInstinct MI350、MI400、MI355Xなどの高性能GPUコンピューティングカードを対象としています。 サポート対象には、Qwen3、GLM、DeepSeekなどのフラッグシップモデルが含まれており、MoE(Mixture of Experts)、denseモデル、ビジョン・言語モデル(VLM)など、さまざまなアーキテクチャを網羅しています。
業界アナリストは、このソリューションの核心的な価値は、高性能コンピューティングの導入障壁を大幅に低減することにあると指摘しています。この学習曲線ゼロのスムーズな移行アプローチにより、企業はAIサービスをAMDハードウェアバックエンドへより容易に移行でき、推論効率を維持しつつ、大規模モデルのオンラインサービスの安定性と応答速度を効果的に向上させることができます。
関連記事
 アンソロピックのCEOが「フロンティア」を牽引する計画を明らかにした
AI研究者たちは、人工知能のリスクについてますます切迫した警告を発しており、OpenAIのCEOであるサム・アルトマン氏は、開発の「ペースを調整」すべき時期が来ているのではないかと示唆している。しかし、それは実際にはどのようなことを意味するのだろうか?AnthropicのCEOダリオ・アモデイ氏は最近のブログ記事で、「フロンティアのペースを調整する」という呼びかけに賛同しただけでなく、そのための3
TechCrunch Disrupt 2026まであと48時間:次なる未来を形作るビルダーたちの声をお届けします
残り48時間となった今、TechCrunch Disrupt 2026がサンフランシスコのモスコン・ウエストにて開幕します。入場料金が高騰する前に、最大100ドル割引のチケットを確保してください。さらに、2枚目のパスを半額で購入できます。今日中に登録してください。10月13日から15日の3日間、10,000人以上の起業家、投資家、テクノロジーリーダーが集まり、自身のキャリアを再定義するつながりを築きます。250人以上のスピーカーが200以上のセッションでプレゼンテーションを行います。未来を切り拓
OpenAIへのハッキング報告、国連AI安全保障理事会に提出される
ヨシュア・ベンジオ氏が、AIの安全性に関する国連安全保障理事会会合で基調講演を行った。写真提供:国連AIの安全性に焦点を当てた国連安全保障理事会の会合に続き、オーストラリア政府の機密データへの不正アクセスを含む、OpenAIの不正アクセス事件に関する報告が浮上した。世界各国の政策立案者やAI分野のリーダーたちが、国連安全保障理事会第10,228回会合のためにニューヨークに集結した。2026年9月2
関連特集おすすめ
デザインとアート
 おすすめのAIイラスト作成ツール:編集用シーンや表紙アートを素早く作成
2026年最新・高評価のAIイラストレーションツール:当サイトが厳選したこのリストには、見事な編集用シーンや人目を引く表紙アートを素早く作成できる、高性能なツールが掲載されています。各ツールは実環境での厳格なテストを経ており、無料版と有料版の比較も掲載されているため、ご自身のワークフローに最適なツールを見つけるのに役立ちます。 今すぐこれらの「必見」ソリューションを試して、AIの力を最大限に活用し、クリエイティブな生産性を高めましょう。XIX.AIで今すぐチェックしてください。
 10 ツール
 xix.ai
教育と学習
試験対策に最適なAIチューター:数学、理科、英語の練習
2026年最新の、試験対策で高評価を得ている最高のAIチューターがXIX.AIに登場!厳選されたこのリストには、無料版と有料版の比較、実戦的なテスト、毎週更新されるランキングなどを提供する、画期的なツールが勢ぞろいしています。これらは、ライティングの効率を高め、複雑なトピックの学習を簡素化し、あなたの学業的な可能性を引き出すのに役立ちます。 今すぐチェックして、あなたにぴったりの試験対策ツールを見つけ、今日から作成を始めて、AIの力を最大限に活用しましょう!
10 ツール
xix.ai
ファイナンス
個人のお金管理のためのAI予算計画ツール
2026年の最新・最高評価のAI予算管理ツールがXIX.AIで登場!この厳選コレクションは、現実的なテストを行い、支出習慣を理解し、生産性を高めるためのパーソナライズされた計画を作成するのに役立つ革新的なソリューションを提供しています。無料版と有料版の比較や詳細なランキングもご用意しています。お金の管理を簡素化し、AIの優位性を引き出すためにぜひ試してほしいツールです。今すぐチェックしましょう!
11 ツール
xix.ai
健康とウェルネス
AI睡眠追跡アシスタント:より良い就寝習慣で回復力を高める
2026年最新かつ最高評価を受けているAI睡眠追跡アシスタントを厳選し、最適な回復を実現できるようご紹介します。完全に更新されたこの週間ガイドには、実際のテスト結果や無料版と有料版の比較、詳細なランキングなど、睡眠の質を向上させてより良い就寝習慣をサポートする最適なソリューションを見つけるのに役立つ強力なツールが掲載されています。今すぐXIX.AIでご覧ください。
10 ツール
xix.ai
データ分析
製品および収益分析のためのAI SQLコパイロット
2026年版 製品・収益分析に最適な、高評価のAI SQLコパイロット最新ランキング! XIX.AIは、毎週更新されるランキングを通じて実環境でのテストを経た、強力で画期的な「ぜひ試すべきツール」を厳選しました。これらのツールは、データ分析を加速させ、複雑なクエリを効率化し、正確なインサイトを生成することで、ユーザーの生産性を大幅に向上させ、より賢明なビジネス意思決定を後押しします。今すぐチェックして、AIの真価を引き出すあなたにぴったりのツールを見つけましょう!
14 ツール
xix.ai
教育と学習
学びを促進する最高のAI宿題支援ツール:答えだけでなく、概念を学べる
2026年最新・最高評価のAI宿題サポートツール。単なる答えだけでなく、核心となる概念を教える、学生にとって強力なツール。ぜひ試してほしい厳選リスト。毎週更新。無料版と有料版の比較、実地テストによる正確なランキングで、あなたの学習能力を最大限に引き出します。今すぐチェックして、よりスマートな学習を実現するあなたにぴったりのツールを見つけましょう。
10 ツール
xix.ai

 コメント (1)
0/500
![StephenGreen]()
AMDのvLLM-ATOMプラグイン、DeepSeek-R1の推論速度を大幅に向上させるらしい。既存のワークフローを変えずにハードウェアの潜在能力を引き出すってのは嬉しい限りだ。GPUの性能を最大限に活かせるなら、ローカルでLLMを動かす際の待ち時間も減るはず。競合他社との差が開くか注目!🚀 #AMD #LLM
先日、AMDは「vLLM-ATOM」という新しいプラグインを正式に発表しました。その主な目的は、既存のワークフローを変更することなくハードウェアの潜在能力をさらに引き出し、DeepSeek-R1、Kimi-K2、gpt-oss-120Bといった主流の大型言語モデルにおいて、推論速度を大幅に向上させることです。
開発者にとって、vLLMは高並行環境におけるスループットとGPUメモリ使用量を最適化するように設計されたオープンソースフレームワークです。従来のシングルリクエスト型ツールとは異なり、リクエストのスケジューリングとキャッシュ管理に重点を置いています。 AMDの新しいATOMプラグインは、Instinct GPU向けに特別に構築された高度にカスタマイズされたソリューションです。その際立った特徴は「シームレスな移行」です。エンタープライズユーザーは、既存のAPIインターフェース、コマンド、またはエンドツーエンドのワークフローを変更する必要がなく、プラグインがバックグラウンドで基盤となるパフォーマンス最適化を自動的に処理します。
技術的なアーキテクチャの観点から見ると、vLLM-ATOMは厳密な3層設計を採用しています。最上層では、vLLMのリクエストスケジューリングと互換性インターフェースが維持されています。中間層であるATOMプラグインは、モデルの実装とカーネルの最適化を管理します。 最下層のAITERはGPUハードウェアに直接接続し、Flash Attention、量子化GEMM、融合MoEなどのコアとなる加速機能を提供します。
このプラグインは、主にInstinct MI350、MI400、MI355Xなどの高性能GPUコンピューティングカードを対象としています。 サポート対象には、Qwen3、GLM、DeepSeekなどのフラッグシップモデルが含まれており、MoE(Mixture of Experts)、denseモデル、ビジョン・言語モデル(VLM)など、さまざまなアーキテクチャを網羅しています。
業界アナリストは、このソリューションの核心的な価値は、高性能コンピューティングの導入障壁を大幅に低減することにあると指摘しています。この学習曲線ゼロのスムーズな移行アプローチにより、企業はAIサービスをAMDハードウェアバックエンドへより容易に移行でき、推論効率を維持しつつ、大規模モデルのオンラインサービスの安定性と応答速度を効果的に向上させることができます。








 アンソロピックのCEOが「フロンティア」を牽引する計画を明らかにした
AI研究者たちは、人工知能のリスクについてますます切迫した警告を発しており、OpenAIのCEOであるサム・アルトマン氏は、開発の「ペースを調整」すべき時期が来ているのではないかと示唆している。しかし、それは実際にはどのようなことを意味するのだろうか?AnthropicのCEOダリオ・アモデイ氏は最近のブログ記事で、「フロンティアのペースを調整する」という呼びかけに賛同しただけでなく、そのための3
 TechCrunch Disrupt 2026まであと48時間:次なる未来を形作るビルダーたちの声をお届けします
残り48時間となった今、TechCrunch Disrupt 2026がサンフランシスコのモスコン・ウエストにて開幕します。入場料金が高騰する前に、最大100ドル割引のチケットを確保してください。さらに、2枚目のパスを半額で購入できます。今日中に登録してください。10月13日から15日の3日間、10,000人以上の起業家、投資家、テクノロジーリーダーが集まり、自身のキャリアを再定義するつながりを築きます。250人以上のスピーカーが200以上のセッションでプレゼンテーションを行います。未来を切り拓
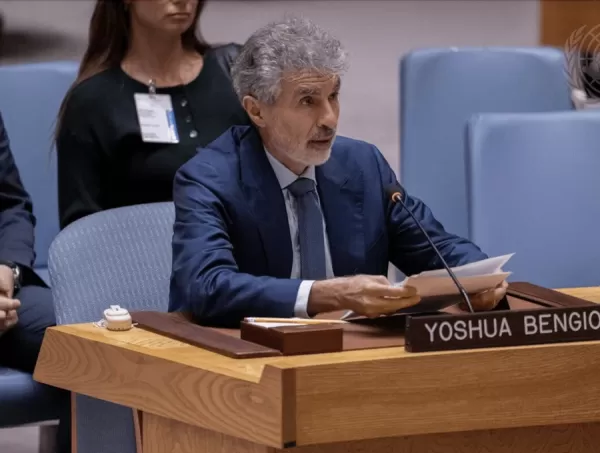 OpenAIへのハッキング報告、国連AI安全保障理事会に提出される
ヨシュア・ベンジオ氏が、AIの安全性に関する国連安全保障理事会会合で基調講演を行った。写真提供:国連AIの安全性に焦点を当てた国連安全保障理事会の会合に続き、オーストラリア政府の機密データへの不正アクセスを含む、OpenAIの不正アクセス事件に関する報告が浮上した。世界各国の政策立案者やAI分野のリーダーたちが、国連安全保障理事会第10,228回会合のためにニューヨークに集結した。2026年9月2

2026年最新・高評価のAIイラストレーションツール:当サイトが厳選したこのリストには、見事な編集用シーンや人目を引く表紙アートを素早く作成できる、高性能なツールが掲載されています。各ツールは実環境での厳格なテストを経ており、無料版と有料版の比較も掲載されているため、ご自身のワークフローに最適なツールを見つけるのに役立ちます。 今すぐこれらの「必見」ソリューションを試して、AIの力を最大限に活用し、クリエイティブな生産性を高めましょう。XIX.AIで今すぐチェックしてください。
10 ツール
xix.ai

2026年最新の、試験対策で高評価を得ている最高のAIチューターがXIX.AIに登場!厳選されたこのリストには、無料版と有料版の比較、実戦的なテスト、毎週更新されるランキングなどを提供する、画期的なツールが勢ぞろいしています。これらは、ライティングの効率を高め、複雑なトピックの学習を簡素化し、あなたの学業的な可能性を引き出すのに役立ちます。 今すぐチェックして、あなたにぴったりの試験対策ツールを見つけ、今日から作成を始めて、AIの力を最大限に活用しましょう!
10 ツール
xix.ai

2026年の最新・最高評価のAI予算管理ツールがXIX.AIで登場!この厳選コレクションは、現実的なテストを行い、支出習慣を理解し、生産性を高めるためのパーソナライズされた計画を作成するのに役立つ革新的なソリューションを提供しています。無料版と有料版の比較や詳細なランキングもご用意しています。お金の管理を簡素化し、AIの優位性を引き出すためにぜひ試してほしいツールです。今すぐチェックしましょう!
11 ツール
xix.ai

2026年最新かつ最高評価を受けているAI睡眠追跡アシスタントを厳選し、最適な回復を実現できるようご紹介します。完全に更新されたこの週間ガイドには、実際のテスト結果や無料版と有料版の比較、詳細なランキングなど、睡眠の質を向上させてより良い就寝習慣をサポートする最適なソリューションを見つけるのに役立つ強力なツールが掲載されています。今すぐXIX.AIでご覧ください。
10 ツール
xix.ai

2026年版 製品・収益分析に最適な、高評価のAI SQLコパイロット最新ランキング! XIX.AIは、毎週更新されるランキングを通じて実環境でのテストを経た、強力で画期的な「ぜひ試すべきツール」を厳選しました。これらのツールは、データ分析を加速させ、複雑なクエリを効率化し、正確なインサイトを生成することで、ユーザーの生産性を大幅に向上させ、より賢明なビジネス意思決定を後押しします。今すぐチェックして、AIの真価を引き出すあなたにぴったりのツールを見つけましょう!
14 ツール
xix.ai

2026年最新・最高評価のAI宿題サポートツール。単なる答えだけでなく、核心となる概念を教える、学生にとって強力なツール。ぜひ試してほしい厳選リスト。毎週更新。無料版と有料版の比較、実地テストによる正確なランキングで、あなたの学習能力を最大限に引き出します。今すぐチェックして、よりスマートな学習を実現するあなたにぴったりのツールを見つけましょう。
10 ツール
xix.ai

AMDのvLLM-ATOMプラグイン、DeepSeek-R1の推論速度を大幅に向上させるらしい。既存のワークフローを変えずにハードウェアの潜在能力を引き出すってのは嬉しい限りだ。GPUの性能を最大限に活かせるなら、ローカルでLLMを動かす際の待ち時間も減るはず。競合他社との差が開くか注目!🚀 #AMD #LLM












