


 Maison
AMD lance le plugin vLLM-ATOM pour accélérer l'inférence des grands modèles
Récemment, AMD a officiellement dévoilé un nouveau plugin baptisé vLLM-ATOM. Son objectif principal est d’exploiter davantage le potentiel du matériel sans modifier les flux de travail existants, tout en offrant des gains de vitesse significatifs en matière d’inférence pour les grands modèles linguistiques grand public tels que DeepSeek-R1, Kimi-K2 et gpt-oss-120B.
Pour les développeurs, vLLM est un framework open source conçu pour optimiser le débit et l’utilisation de la mémoire GPU dans des environnements à forte concurrence. Contrairement aux outils traditionnels à requête unique, il se concentre sur la planification des requêtes et la gestion du cache. Le nouveau plugin ATOM d’AMD est une solution hautement personnalisée, spécialement conçue pour les GPU Instinct. Sa caractéristique phare est la « migration transparente » : les utilisateurs professionnels n’ont pas besoin de modifier les interfaces API, les commandes ou les flux de travail de bout en bout existants ; le plugin gère automatiquement l’optimisation des performances sous-jacentes en arrière-plan.
Du point de vue de l’architecture technique, vLLM-ATOM repose sur une conception précise à trois couches. La couche supérieure conserve la planification des requêtes et l’interface de compatibilité de vLLM. La couche intermédiaire, le plugin ATOM, gère l’implémentation du modèle et l’optimisation du noyau. La couche inférieure, AITER, se connecte directement au matériel GPU, fournissant des capacités d’accélération essentielles telles que Flash Attention, GEMM quantifié et MoE fusionné.
Ce plugin cible principalement les cartes de calcul GPU hautes performances telles que les Instinct MI350, MI400 et MI355X. Sa liste de modèles pris en charge comprend des modèles phares tels que Qwen3, GLM et DeepSeek, et couvre l’ensemble des architectures, y compris MoE (Mixture of Experts), les modèles denses et les modèles vision-langage (VLM).
Les analystes du secteur soulignent que la valeur ajoutée principale de cette solution réside dans la réduction considérable des obstacles au déploiement du calcul haute performance. Grâce à cette approche de migration fluide et sans courbe d’apprentissage, les entreprises peuvent plus facilement transférer leurs services d’IA vers l’infrastructure matérielle AMD, tout en conservant l’efficacité de l’inférence et en améliorant efficacement la stabilité et la vitesse de réponse des services en ligne basés sur des modèles volumineux.
Article connexe
 Le PDG d'Anthropic présente son plan pour ouvrir de nouvelles perspectives
Les chercheurs en IA lancent des avertissements de plus en plus pressants concernant les risques liés à l’intelligence artificielle, le PDG d’OpenAI, Sam Altman, suggérant qu’il est peut-être temps de
48 heures avant TechCrunch Disrupt 2026 : écoutez les créateurs qui façonnent l’avenir
Il reste moins de 48 heures avant le lancement de TechCrunch Disrupt 2026 au Moscone West de San Francisco. Réservez votre billet pour bénéficier d’une réduction allant jusqu’à 100 $ avant que les prix à la porte n’augmentent. De plus, obtenez un deu
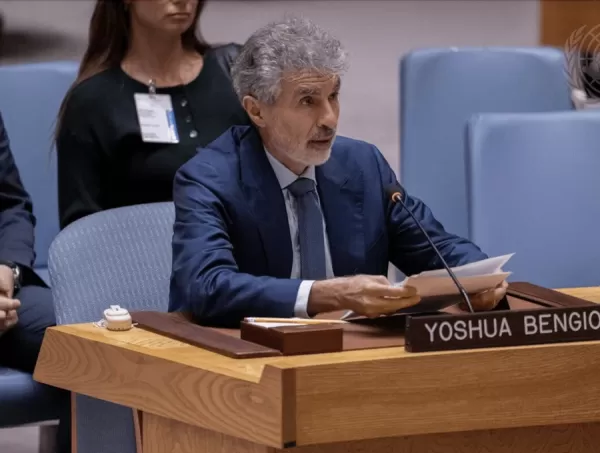
Les signalements de piratage d'OpenAI sont désormais transmis au Conseil des Nations Unies sur la sécurité de l'IA
Yoshua Bengio a prononcé le discours d'ouverture lors d'une séance du Conseil de sécurité de l'ONU consacrée à la sécurité de l'IA. Crédit : ONUDes informations ont fait état d’un incident impliquant
Recommandations de sujets spéciaux liés
Conception et art
 Les meilleurs outils d'illustration basés sur l'IA : créez plus rapidement des scènes éditoriales et des illustrations de couverture
Les meilleurs outils d'illustration IA de 2026 : notre sélection regroupe les outils les plus performants pour créer rapidement de superbes scènes éditoriales et des couvertures accrocheuses. Chaque option a été soumise à des tests rigoureux en conditions réelles ; nous vous proposons une comparaison entre les versions gratuites et payantes afin de vous aider à trouver celle qui correspond le mieux à votre flux de travail. Essayez dès aujourd’hui ces solutions incontournables pour exploiter pleinement le potentiel de l’IA et booster votre productivité créative. Découvrez-les dès maintenant sur XIX.AI.
 10 outils
 xix.ai
Éducation et apprentissage
Les meilleurs professeurs particuliers spécialisés en IA pour la préparation aux examens : entraînez-vous en maths, en sciences et en anglais
Les meilleurs tuteurs IA 2026 les mieux notés pour la préparation aux examens sont disponibles ici, sur XIX.AI ! Notre sélection comprend des outils puissants et révolutionnaires qui proposent une comparaison entre les versions gratuites et payantes, des tests concrets et des classements mis à jour chaque semaine. Ils vous aident à améliorer votre efficacité à l'écrit, à simplifier l'apprentissage de sujets complexes et à libérer votre potentiel académique. Découvrez dès maintenant l'outil de préparation aux examens qui vous convient le mieux et commencez à créer dès aujourd'hui pour exploiter pleinement les avantages de l'IA !
10 outils
xix.ai
Finance
Outils de planification budgétaire par IA pour la gestion personnelle des finances
2026 Derniers Meilleurs Outils de Planification Budgétaire par IA les mieux notés pour la gestion personnelle des finances sont ici sur XIX.AI ! Cette collection soigneusement sélectionnée propose des solutions puissantes et révolutionnaires qui vous aident à réaliser des tests concrets, à comprendre vos habitudes de dépenses et à créer des plans personnalisés pour améliorer votre productivité. Profitez d’une comparaison entre versions gratuites et payantes ainsi que de classements détaillés. Des outils incontournables conçus pour simplifier la gestion financière et exploiter pleinement votre avantage grâce à l’IA. Explorez dès maintenant !
11 outils
xix.ai
Santé et bien-être
Assistants de suivi du sommeil par l’IA : améliorez votre récupération grâce à de meilleures habitudes avant le coucher
2026 : Découvrez les meilleurs assistants de suivi du sommeil basés sur l’IA, hautement notés et récemment mis à jour, conçus pour une récupération optimale. Ce guide hebdomadaire entièrement actualisé présente des outils puissants qui offrent des tests en conditions réelles, des comparaisons entre versions gratuites et payantes, ainsi que des classements détaillés afin de vous aider à trouver la solution idéale pour améliorer la qualité du sommeil et favoriser de meilleures habitudes avant le coucher. Explorez-le dès maintenant sur XIX.AI pour tirer parti des avantages offerts par l’IA.
10 outils
xix.ai
Analyse des données
Copilotes SQL basés sur l'IA pour l'analyse des produits et du chiffre d'affaires
2026 : les meilleurs copilotes SQL IA les mieux notés pour l'analyse des produits et du chiffre d'affaires ! XIX.AI a sélectionné une gamme d’outils puissants et révolutionnaires à essayer absolument, qui sont soumis à des tests en conditions réelles via des classements mis à jour chaque semaine. Ces outils aident les utilisateurs à booster considérablement leur productivité en accélérant l’analyse des données, en simplifiant les requêtes complexes et en générant des informations précises permettant de prendre des décisions commerciales plus éclairées. Explorez-les dès maintenant pour découvrir l’outil idéal qui vous permettra de tirer pleinement parti de l’IA !
14 outils
xix.ai
Éducation et apprentissage
Les meilleurs outils d'aide aux devoirs basés sur l'IA qui enseignent : apprenez les concepts, pas seulement les réponses
2026 : les meilleurs outils d'aide aux devoirs basés sur l'IA, les mieux notés, qui enseignent les concepts fondamentaux et ne se contentent pas de fournir des réponses. Des outils puissants pour les élèves. Une sélection incontournable à ne pas manquer. Mise à jour hebdomadaire. Comparaison entre les versions gratuites et payantes. Tests en conditions réelles. Classements précis pour vous aider à exploiter pleinement votre potentiel d'apprentissage. Explorez dès maintenant pour découvrir l'outil idéal qui vous permettra d'étudier plus efficacement.
10 outils
xix.ai

 commentaires (1)
![StephenGreen]()
AMDのvLLM-ATOMプラグイン、DeepSeek-R1の推論速度を大幅に向上させるらしい。既存のワークフローを変えずにハードウェアの潜在能力を引き出すってのは嬉しい限りだ。GPUの性能を最大限に活かせるなら、ローカルでLLMを動かす際の待ち時間も減るはず。競合他社との差が開くか注目!🚀 #AMD #LLM
Récemment, AMD a officiellement dévoilé un nouveau plugin baptisé vLLM-ATOM. Son objectif principal est d’exploiter davantage le potentiel du matériel sans modifier les flux de travail existants, tout en offrant des gains de vitesse significatifs en matière d’inférence pour les grands modèles linguistiques grand public tels que DeepSeek-R1, Kimi-K2 et gpt-oss-120B.
Pour les développeurs, vLLM est un framework open source conçu pour optimiser le débit et l’utilisation de la mémoire GPU dans des environnements à forte concurrence. Contrairement aux outils traditionnels à requête unique, il se concentre sur la planification des requêtes et la gestion du cache. Le nouveau plugin ATOM d’AMD est une solution hautement personnalisée, spécialement conçue pour les GPU Instinct. Sa caractéristique phare est la « migration transparente » : les utilisateurs professionnels n’ont pas besoin de modifier les interfaces API, les commandes ou les flux de travail de bout en bout existants ; le plugin gère automatiquement l’optimisation des performances sous-jacentes en arrière-plan.
Du point de vue de l’architecture technique, vLLM-ATOM repose sur une conception précise à trois couches. La couche supérieure conserve la planification des requêtes et l’interface de compatibilité de vLLM. La couche intermédiaire, le plugin ATOM, gère l’implémentation du modèle et l’optimisation du noyau. La couche inférieure, AITER, se connecte directement au matériel GPU, fournissant des capacités d’accélération essentielles telles que Flash Attention, GEMM quantifié et MoE fusionné.
Ce plugin cible principalement les cartes de calcul GPU hautes performances telles que les Instinct MI350, MI400 et MI355X. Sa liste de modèles pris en charge comprend des modèles phares tels que Qwen3, GLM et DeepSeek, et couvre l’ensemble des architectures, y compris MoE (Mixture of Experts), les modèles denses et les modèles vision-langage (VLM).
Les analystes du secteur soulignent que la valeur ajoutée principale de cette solution réside dans la réduction considérable des obstacles au déploiement du calcul haute performance. Grâce à cette approche de migration fluide et sans courbe d’apprentissage, les entreprises peuvent plus facilement transférer leurs services d’IA vers l’infrastructure matérielle AMD, tout en conservant l’efficacité de l’inférence et en améliorant efficacement la stabilité et la vitesse de réponse des services en ligne basés sur des modèles volumineux.








 Le PDG d'Anthropic présente son plan pour ouvrir de nouvelles perspectives
Les chercheurs en IA lancent des avertissements de plus en plus pressants concernant les risques liés à l’intelligence artificielle, le PDG d’OpenAI, Sam Altman, suggérant qu’il est peut-être temps de
 48 heures avant TechCrunch Disrupt 2026 : écoutez les créateurs qui façonnent l’avenir
Il reste moins de 48 heures avant le lancement de TechCrunch Disrupt 2026 au Moscone West de San Francisco. Réservez votre billet pour bénéficier d’une réduction allant jusqu’à 100 $ avant que les prix à la porte n’augmentent. De plus, obtenez un deu
 Les signalements de piratage d'OpenAI sont désormais transmis au Conseil des Nations Unies sur la sécurité de l'IA
Yoshua Bengio a prononcé le discours d'ouverture lors d'une séance du Conseil de sécurité de l'ONU consacrée à la sécurité de l'IA. Crédit : ONUDes informations ont fait état d’un incident impliquant

Les meilleurs outils d'illustration IA de 2026 : notre sélection regroupe les outils les plus performants pour créer rapidement de superbes scènes éditoriales et des couvertures accrocheuses. Chaque option a été soumise à des tests rigoureux en conditions réelles ; nous vous proposons une comparaison entre les versions gratuites et payantes afin de vous aider à trouver celle qui correspond le mieux à votre flux de travail. Essayez dès aujourd’hui ces solutions incontournables pour exploiter pleinement le potentiel de l’IA et booster votre productivité créative. Découvrez-les dès maintenant sur XIX.AI.
10 outils
xix.ai

Les meilleurs tuteurs IA 2026 les mieux notés pour la préparation aux examens sont disponibles ici, sur XIX.AI ! Notre sélection comprend des outils puissants et révolutionnaires qui proposent une comparaison entre les versions gratuites et payantes, des tests concrets et des classements mis à jour chaque semaine. Ils vous aident à améliorer votre efficacité à l'écrit, à simplifier l'apprentissage de sujets complexes et à libérer votre potentiel académique. Découvrez dès maintenant l'outil de préparation aux examens qui vous convient le mieux et commencez à créer dès aujourd'hui pour exploiter pleinement les avantages de l'IA !
10 outils
xix.ai

2026 Derniers Meilleurs Outils de Planification Budgétaire par IA les mieux notés pour la gestion personnelle des finances sont ici sur XIX.AI ! Cette collection soigneusement sélectionnée propose des solutions puissantes et révolutionnaires qui vous aident à réaliser des tests concrets, à comprendre vos habitudes de dépenses et à créer des plans personnalisés pour améliorer votre productivité. Profitez d’une comparaison entre versions gratuites et payantes ainsi que de classements détaillés. Des outils incontournables conçus pour simplifier la gestion financière et exploiter pleinement votre avantage grâce à l’IA. Explorez dès maintenant !
11 outils
xix.ai

2026 : Découvrez les meilleurs assistants de suivi du sommeil basés sur l’IA, hautement notés et récemment mis à jour, conçus pour une récupération optimale. Ce guide hebdomadaire entièrement actualisé présente des outils puissants qui offrent des tests en conditions réelles, des comparaisons entre versions gratuites et payantes, ainsi que des classements détaillés afin de vous aider à trouver la solution idéale pour améliorer la qualité du sommeil et favoriser de meilleures habitudes avant le coucher. Explorez-le dès maintenant sur XIX.AI pour tirer parti des avantages offerts par l’IA.
10 outils
xix.ai

2026 : les meilleurs copilotes SQL IA les mieux notés pour l'analyse des produits et du chiffre d'affaires ! XIX.AI a sélectionné une gamme d’outils puissants et révolutionnaires à essayer absolument, qui sont soumis à des tests en conditions réelles via des classements mis à jour chaque semaine. Ces outils aident les utilisateurs à booster considérablement leur productivité en accélérant l’analyse des données, en simplifiant les requêtes complexes et en générant des informations précises permettant de prendre des décisions commerciales plus éclairées. Explorez-les dès maintenant pour découvrir l’outil idéal qui vous permettra de tirer pleinement parti de l’IA !
14 outils
xix.ai

2026 : les meilleurs outils d'aide aux devoirs basés sur l'IA, les mieux notés, qui enseignent les concepts fondamentaux et ne se contentent pas de fournir des réponses. Des outils puissants pour les élèves. Une sélection incontournable à ne pas manquer. Mise à jour hebdomadaire. Comparaison entre les versions gratuites et payantes. Tests en conditions réelles. Classements précis pour vous aider à exploiter pleinement votre potentiel d'apprentissage. Explorez dès maintenant pour découvrir l'outil idéal qui vous permettra d'étudier plus efficacement.
10 outils
xix.ai

AMDのvLLM-ATOMプラグイン、DeepSeek-R1の推論速度を大幅に向上させるらしい。既存のワークフローを変えずにハードウェアの潜在能力を引き出すってのは嬉しい限りだ。GPUの性能を最大限に活かせるなら、ローカルでLLMを動かす際の待ち時間も減るはず。競合他社との差が開くか注目!🚀 #AMD #LLM












