


 Hogar
AMD lanza el complemento vLLM-ATOM para acelerar la inferencia de modelos de gran tamaño
Recientemente, AMD ha presentado oficialmente un nuevo complemento denominado vLLM-ATOM. Su objetivo principal es aprovechar al máximo el potencial del hardware sin alterar los flujos de trabajo existentes, lo que permite una aceleración significativa de la inferencia en modelos de lenguaje a gran escala de uso general, como DeepSeek-R1, Kimi-K2 y gpt-oss-120B.
Para los desarrolladores, vLLM es un marco de código abierto diseñado para optimizar el rendimiento y el uso de la memoria de la GPU en entornos de alta concurrencia. A diferencia de las herramientas tradicionales de solicitud única, se centra en la programación de solicitudes y la gestión de la caché. El nuevo complemento ATOM de AMD es una solución altamente personalizada, creada específicamente para las GPU Instinct. Su característica más destacada es la «migración sin fisuras»: los usuarios empresariales no necesitan modificar las interfaces API, los comandos ni los flujos de trabajo de extremo a extremo existentes; el complemento se encarga automáticamente de la optimización del rendimiento subyacente en segundo plano.
Desde el punto de vista de la arquitectura técnica, vLLM-ATOM emplea un diseño preciso de tres capas. La capa superior conserva la programación de solicitudes y la interfaz de compatibilidad de vLLM. La capa intermedia, el complemento ATOM, gestiona la implementación del modelo y la optimización del kernel. La capa inferior, AITER, se conecta directamente al hardware de la GPU, proporcionando capacidades de aceleración fundamentales como Flash Attention, GEMM cuantificado y MoE fusionado.
Este complemento está destinado principalmente a tarjetas de computación con GPU de alto rendimiento como Instinct MI350, MI400 y MI355X. Su lista de compatibilidad incluye modelos emblemáticos como Qwen3, GLM y DeepSeek, y ofrece una cobertura completa de diversas arquitecturas, entre las que se incluyen MoE (Mixture of Experts), modelos densos y modelos de visión-lenguaje (VLM).
Los analistas del sector señalan que el valor fundamental de esta solución radica en reducir considerablemente las barreras de implementación de la computación de alto rendimiento. Gracias a este enfoque de migración fluida y sin curva de aprendizaje, las empresas pueden trasladar más fácilmente los servicios de IA al backend de hardware de AMD, manteniendo la eficiencia de la inferencia al tiempo que mejoran de forma efectiva la estabilidad y la velocidad de respuesta de los servicios en línea con modelos de gran tamaño.
Artículo relacionado
 El director general de Anthropic esboza un plan para marcar el ritmo en la vanguardia
Los investigadores en IA han lanzado advertencias cada vez más urgentes sobre los riesgos de la inteligencia artificial, y el director ejecutivo de OpenAI, Sam Altman, ha sugerido que quizá sea el mom
48 horas para TechCrunch Disrupt 2026: Escucha a los creadores que están definiendo el futuro
Con menos de 48 horas para el inicio, TechCrunch Disrupt 2026 arranca en el Moscone West de San Francisco. Asegura tu entrada con hasta 100 dólares de descuento antes de que suban los precios en taquilla. Además, obtén una segunda entrada al 50% de d
Los informes sobre ataques informáticos a OpenAI, ahora ante el Consejo de Seguridad de la IA de la ONU
Yoshua Bengio pronunció el discurso de apertura en una sesión del Consejo de Seguridad de la ONU sobre la seguridad de la IA. Crédito: ONUHan salido a la luz informes sobre un incidente relacionado co
Recomendaciones de temas especiales relacionados
Diseño y Arte
 Las mejores herramientas de ilustración con IA: crea escenas editoriales y portadas más rápido
Las mejores herramientas de ilustración con IA de 2026: nuestra lista seleccionada incluye las mejores herramientas, diseñadas con gran potencia, para crear rápidamente impresionantes escenas editoriales y llamativas portadas. Cada opción ha sido sometida a rigurosas pruebas en condiciones reales y ofrece una comparación entre las versiones gratuitas y de pago para ayudarte a encontrar la que mejor se adapte a tu flujo de trabajo. Prueba hoy mismo estas soluciones imprescindibles para sacar el máximo partido a la IA y potenciar tu productividad creativa. Descúbrelas ahora en XIX.AI.
 10 herramientas
 xix.ai
Educación y aprendizaje
Los mejores profesores particulares de IA para la preparación de exámenes: practica matemáticas, ciencias e inglés
¡Ya están aquí, en XIX.AI, los mejores tutores de IA para la preparación de exámenes de 2026, con las mejores valoraciones! Nuestra lista seleccionada incluye potentes herramientas revolucionarias que ofrecen comparativas entre versiones gratuitas y de pago, pruebas reales y clasificaciones actualizadas semanalmente. Te ayudan a mejorar tu eficiencia a la hora de escribir, a simplificar el aprendizaje de temas complejos y a desarrollar todo tu potencial académico. ¡Explora ahora mismo para descubrir tu herramienta perfecta de preparación de exámenes y empieza a crear hoy mismo para sacar partido a tu ventaja con la IA!
10 herramientas
xix.ai
Finanzas
Herramientas de planificación presupuestaria con IA para la gestión personal del dinero
2026 Últimas Mejores Herramientas de Planificación Presupuestaria con IA Mejor Valoradas para la Gestión Personal del Dinero están aquí en XIX.AI. Esta colección seleccionada presenta soluciones poderosas y transformadoras que te ayudan a realizar pruebas en el mundo real, comprender tus hábitos de gasto y crear planes personalizados para aumentar la productividad. Disfruta de una comparación entre versiones gratuitas y de pago junto con clasificaciones detalladas. Herramientas imprescindibles diseñadas para simplificar la gestión del dinero y desbloquear tu ventaja con IA. ¡Explóralas ahora!
11 herramientas
xix.ai
Salud y bienestar
Asistentes de seguimiento del sueño basados en IA: mejora tu recuperación con mejores hábitos a la hora de acostarte
Los mejores asistentes de seguimiento del sueño con IA de 2026, seleccionados para una recuperación óptima. Esta guía semanal totalmente actualizada incluye potentes herramientas que ofrecen pruebas en condiciones reales, comparativas entre opciones gratuitas y de pago, y clasificaciones detalladas para ayudarte a encontrar la solución imprescindible que mejora la calidad del sueño y fomenta mejores hábitos a la hora de acostarse. Descúbrelo ahora en XIX.AI y aprovecha todas las ventajas de la IA.
10 herramientas
xix.ai
Análisis de datos
Copilotos de IA y SQL para el análisis de productos e ingresos
¡Los mejores copilotos de IA para SQL mejor valorados de 2026 para el análisis de productos e ingresos! XIX.AI ha seleccionado una potente colección de herramientas revolucionarias que no te puedes perder y que se someten a pruebas en el mundo real a través de clasificaciones que se actualizan semanalmente. Estas herramientas ayudan a los usuarios a aumentar significativamente su productividad al acelerar el análisis de datos, simplificar consultas complejas y generar información precisa para tomar decisiones empresariales más inteligentes. ¡Explora ahora mismo y descubre la herramienta perfecta para sacar el máximo partido a tu ventaja en IA!
14 herramientas
xix.ai
Educación y aprendizaje
Las mejores herramientas de IA para los deberes que realmente enseñan: aprende conceptos, no solo respuestas
2026: los mejores y más valorados asistentes de deberes con IA que enseñan conceptos básicos, no solo respuestas. Potentes herramientas para estudiantes. Una selección imprescindible que debes probar. Actualización semanal. Comparativa entre opciones gratuitas y de pago. Pruebas en el mundo real. Clasificaciones precisas para ayudarte a desarrollar todo tu potencial de aprendizaje. Explora ahora y descubre la herramienta perfecta para estudiar de forma más inteligente.
10 herramientas
xix.ai

 comentario (1)
0/500
![StephenGreen]()
AMDのvLLM-ATOMプラグイン、DeepSeek-R1の推論速度を大幅に向上させるらしい。既存のワークフローを変えずにハードウェアの潜在能力を引き出すってのは嬉しい限りだ。GPUの性能を最大限に活かせるなら、ローカルでLLMを動かす際の待ち時間も減るはず。競合他社との差が開くか注目!🚀 #AMD #LLM
Recientemente, AMD ha presentado oficialmente un nuevo complemento denominado vLLM-ATOM. Su objetivo principal es aprovechar al máximo el potencial del hardware sin alterar los flujos de trabajo existentes, lo que permite una aceleración significativa de la inferencia en modelos de lenguaje a gran escala de uso general, como DeepSeek-R1, Kimi-K2 y gpt-oss-120B.
Para los desarrolladores, vLLM es un marco de código abierto diseñado para optimizar el rendimiento y el uso de la memoria de la GPU en entornos de alta concurrencia. A diferencia de las herramientas tradicionales de solicitud única, se centra en la programación de solicitudes y la gestión de la caché. El nuevo complemento ATOM de AMD es una solución altamente personalizada, creada específicamente para las GPU Instinct. Su característica más destacada es la «migración sin fisuras»: los usuarios empresariales no necesitan modificar las interfaces API, los comandos ni los flujos de trabajo de extremo a extremo existentes; el complemento se encarga automáticamente de la optimización del rendimiento subyacente en segundo plano.
Desde el punto de vista de la arquitectura técnica, vLLM-ATOM emplea un diseño preciso de tres capas. La capa superior conserva la programación de solicitudes y la interfaz de compatibilidad de vLLM. La capa intermedia, el complemento ATOM, gestiona la implementación del modelo y la optimización del kernel. La capa inferior, AITER, se conecta directamente al hardware de la GPU, proporcionando capacidades de aceleración fundamentales como Flash Attention, GEMM cuantificado y MoE fusionado.
Este complemento está destinado principalmente a tarjetas de computación con GPU de alto rendimiento como Instinct MI350, MI400 y MI355X. Su lista de compatibilidad incluye modelos emblemáticos como Qwen3, GLM y DeepSeek, y ofrece una cobertura completa de diversas arquitecturas, entre las que se incluyen MoE (Mixture of Experts), modelos densos y modelos de visión-lenguaje (VLM).
Los analistas del sector señalan que el valor fundamental de esta solución radica en reducir considerablemente las barreras de implementación de la computación de alto rendimiento. Gracias a este enfoque de migración fluida y sin curva de aprendizaje, las empresas pueden trasladar más fácilmente los servicios de IA al backend de hardware de AMD, manteniendo la eficiencia de la inferencia al tiempo que mejoran de forma efectiva la estabilidad y la velocidad de respuesta de los servicios en línea con modelos de gran tamaño.








 El director general de Anthropic esboza un plan para marcar el ritmo en la vanguardia
Los investigadores en IA han lanzado advertencias cada vez más urgentes sobre los riesgos de la inteligencia artificial, y el director ejecutivo de OpenAI, Sam Altman, ha sugerido que quizá sea el mom
 48 horas para TechCrunch Disrupt 2026: Escucha a los creadores que están definiendo el futuro
Con menos de 48 horas para el inicio, TechCrunch Disrupt 2026 arranca en el Moscone West de San Francisco. Asegura tu entrada con hasta 100 dólares de descuento antes de que suban los precios en taquilla. Además, obtén una segunda entrada al 50% de d
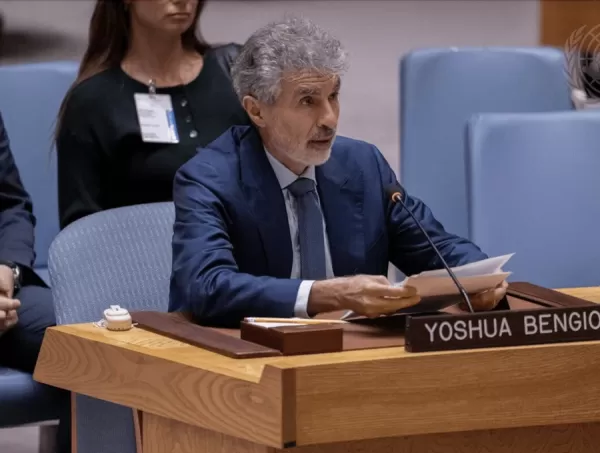 Los informes sobre ataques informáticos a OpenAI, ahora ante el Consejo de Seguridad de la IA de la ONU
Yoshua Bengio pronunció el discurso de apertura en una sesión del Consejo de Seguridad de la ONU sobre la seguridad de la IA. Crédito: ONUHan salido a la luz informes sobre un incidente relacionado co

Las mejores herramientas de ilustración con IA de 2026: nuestra lista seleccionada incluye las mejores herramientas, diseñadas con gran potencia, para crear rápidamente impresionantes escenas editoriales y llamativas portadas. Cada opción ha sido sometida a rigurosas pruebas en condiciones reales y ofrece una comparación entre las versiones gratuitas y de pago para ayudarte a encontrar la que mejor se adapte a tu flujo de trabajo. Prueba hoy mismo estas soluciones imprescindibles para sacar el máximo partido a la IA y potenciar tu productividad creativa. Descúbrelas ahora en XIX.AI.
10 herramientas
xix.ai

¡Ya están aquí, en XIX.AI, los mejores tutores de IA para la preparación de exámenes de 2026, con las mejores valoraciones! Nuestra lista seleccionada incluye potentes herramientas revolucionarias que ofrecen comparativas entre versiones gratuitas y de pago, pruebas reales y clasificaciones actualizadas semanalmente. Te ayudan a mejorar tu eficiencia a la hora de escribir, a simplificar el aprendizaje de temas complejos y a desarrollar todo tu potencial académico. ¡Explora ahora mismo para descubrir tu herramienta perfecta de preparación de exámenes y empieza a crear hoy mismo para sacar partido a tu ventaja con la IA!
10 herramientas
xix.ai

2026 Últimas Mejores Herramientas de Planificación Presupuestaria con IA Mejor Valoradas para la Gestión Personal del Dinero están aquí en XIX.AI. Esta colección seleccionada presenta soluciones poderosas y transformadoras que te ayudan a realizar pruebas en el mundo real, comprender tus hábitos de gasto y crear planes personalizados para aumentar la productividad. Disfruta de una comparación entre versiones gratuitas y de pago junto con clasificaciones detalladas. Herramientas imprescindibles diseñadas para simplificar la gestión del dinero y desbloquear tu ventaja con IA. ¡Explóralas ahora!
11 herramientas
xix.ai

Los mejores asistentes de seguimiento del sueño con IA de 2026, seleccionados para una recuperación óptima. Esta guía semanal totalmente actualizada incluye potentes herramientas que ofrecen pruebas en condiciones reales, comparativas entre opciones gratuitas y de pago, y clasificaciones detalladas para ayudarte a encontrar la solución imprescindible que mejora la calidad del sueño y fomenta mejores hábitos a la hora de acostarse. Descúbrelo ahora en XIX.AI y aprovecha todas las ventajas de la IA.
10 herramientas
xix.ai

¡Los mejores copilotos de IA para SQL mejor valorados de 2026 para el análisis de productos e ingresos! XIX.AI ha seleccionado una potente colección de herramientas revolucionarias que no te puedes perder y que se someten a pruebas en el mundo real a través de clasificaciones que se actualizan semanalmente. Estas herramientas ayudan a los usuarios a aumentar significativamente su productividad al acelerar el análisis de datos, simplificar consultas complejas y generar información precisa para tomar decisiones empresariales más inteligentes. ¡Explora ahora mismo y descubre la herramienta perfecta para sacar el máximo partido a tu ventaja en IA!
14 herramientas
xix.ai

2026: los mejores y más valorados asistentes de deberes con IA que enseñan conceptos básicos, no solo respuestas. Potentes herramientas para estudiantes. Una selección imprescindible que debes probar. Actualización semanal. Comparativa entre opciones gratuitas y de pago. Pruebas en el mundo real. Clasificaciones precisas para ayudarte a desarrollar todo tu potencial de aprendizaje. Explora ahora y descubre la herramienta perfecta para estudiar de forma más inteligente.
10 herramientas
xix.ai

AMDのvLLM-ATOMプラグイン、DeepSeek-R1の推論速度を大幅に向上させるらしい。既存のワークフローを変えずにハードウェアの潜在能力を引き出すってのは嬉しい限りだ。GPUの性能を最大限に活かせるなら、ローカルでLLMを動かす際の待ち時間も減るはず。競合他社との差が開くか注目!🚀 #AMD #LLM












