


 Maison
Xiaohongshu, l'Université de Pékin et l'Université Jiao Tong de Shanghai dévoilent HYPIC pour réduire la latence du premier jeton par un facteur de 3,25 dans les modèles à attention hybride
L'objectif principal des services de grands modèles évolue vers des conversations à tour unique au profit de la réponse aux questions par récupération d'information (RAG), de la synthèse de documents multiples et d'agents à longue portée. Ces nouvelles charges de travail partagent une caractéristique clé : le prompt d'une seule requête comprend souvent des dizaines à des centaines de segments sémantiquement indépendants, incluant des documents récupérés, des descriptions de compétences, des fichiers de mémoire et des tours de conversation précédents, le tout assemblé dans des contextes ultra-longs allant de dizaines de milliers à plusieurs centaines de milliers de tokens. À cette échelle, la phase de préremplissage (prefill) domine le coût de calcul par requête, devenant la dépense la plus visible pour les fournisseurs de services. Plus critique encore, les erreurs de cache peuvent faire exploser le délai jusqu'au premier token (TTFT) jusqu'à plusieurs secondes, dégradant sévèrement l'expérience utilisateur.
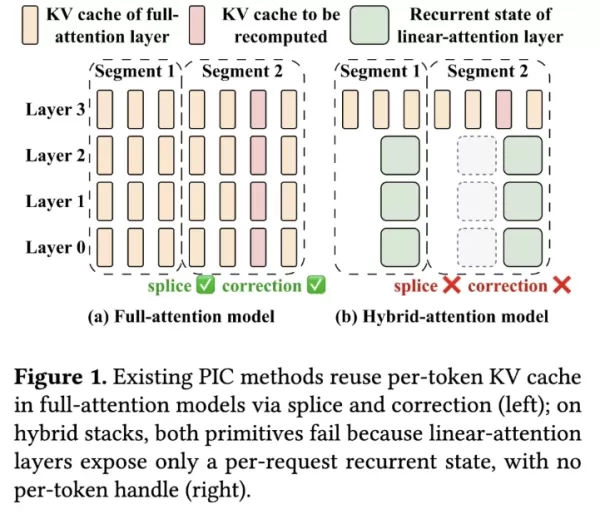
L'industrie a adopté deux stratégies de réduction des coûts. La première est la mise en cache agnostique à la position (PIC), qui assouplit les contraintes strictes de préfixe, permettant à chaque segment sémantiquement indépendant d'être mis en cache une fois, puis assemblé dans n'importe quel préfixe, s'alignant parfaitement avec la composition des prompts de RAG et des agents. Ses mécanismes clés sont l'assemblage (splice), qui concatène directement le long de l'axe des tokens, et la correction, qui recalculer quelques tokens pour restaurer le contexte inter-segments. La deuxième approche est le modèle d'attention hybride, qui remplace la plupart des couches d'attention complète par une attention linéaire, réduisant la complexité quadratique à linéaire et compressant l'historique non borné dans un état cyclique de taille fixe. Des modèles de production récents comme MiniMax-M1, Ring-2.5, Qwen3.5 et Kimi-Linear linéarisent plus de 75 % de leurs couches, ne conservant que quelques couches d'attention complète, formant ainsi la conception hybride dominante. Par exemple, Qwen3.5-35B-A3B comporte 30 couches linéaires sur 40 au total.
La contradiction fondamentale réside ici : le PIC existant fonctionne sur des caches de clés-valeurs (KV) par token, tandis que les couches d'attention linéaire n'exposent qu'un état cyclique par requête, manquant d'accroches par token pour l'assemblage ou la correction. Par conséquent, la plupart des couches des modèles hybrides échappent aux capacités des systèmes PIC existants. Jusqu'à présent, aucun système ne fournissait de mise en cache agnostique à la position pour les grands modèles d'attention hybride.
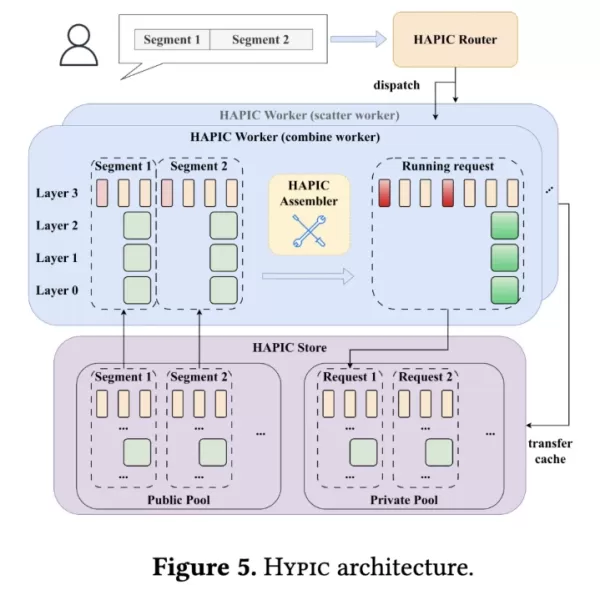
Développé par l'équipe d'inférence de grands modèles de Xiaohongshu en collaboration avec l'Université de Pékin et l'Université Jiao Tong de Shanghai, HYPIC est le premier système de service à implémenter le PIC sur les grands modèles d'attention hybride. Des tests sur quatre modèles d'attention hybride de niveau production et cinq charges de travail montrent que HYPIC réduit le délai du premier token en moyenne par 3,25 fois et augmente le QPS durable de 1,66 fois dans les mêmes conditions de SLA, avec une qualité de tâche ne différant que de 1,71 points par rapport au recalcul complet. L'idée centrale du système est de traiter les couches linéaires et les couches d'attention complète séparément au sein du modèle hybride, accélérant les requêtes à froid grâce au parallélisme au niveau des couches via trois mécanismes interdépendants.
Pour les couches linéaires, HYPIC met en cache des « opérateurs de transition », permettant une combinaison d'états en temps constant. La solution la plus simple de PIC serait d'additionner directement les états finaux de deux segments ayant des valeurs initiales nulles — valide dans l'attention linéaire naïve mais échouant dans l'attention linéaire avancée avec décroissance, porte (gating) ou effacement delta (par exemple, RetNet, Mamba2, GLA, DeltaNet, GDN, KDA). La quantité critique manquante est l'opérateur de transition accumulé T_C d'un segment, c'est-à-dire le produit de toutes les matrices de transition de tokens au sein de celui-ci. L'état final réel devrait être S(C1·C2) = T(C2) · S(C1) + S(C2), tandis que l'addition simple omet le terme T(C2), causant une erreur structurelle. Les tests ont montré que la tête à décroissance lente dans RetNet présentait une erreur de 22 % de la norme d'état à 256 tokens. La clé de HYPIC est que T_C et l'état final à état initial nul S(C|0) sont déterminés uniquement par les tokens internes d'un segment, indépendamment du préfixe. Ainsi, lors du premier préremplissage d'un segment, HYPIC met en cache la paire (T_C, S(C|0)), et lors de sa réutilisation, applique la multiplication à gauche par T_C suivie d'une addition pour reconstruire presque exactement l'état final sous n'importe quel préfixe, couvrant naturellement toute la famille de l'attention linéaire. Des tests sur Qwen3.5-35B-A3B ont montré que les états combinés différaient du recalcul complet de seulement 6×10⁻⁵, dans le bruit FP16. Pour les variantes avec convolution causale ou RoPE, HYPIC utilise deux correctifs — réchauffement de l'état de convolution et ré-rotation de l'état — pour atteindre une alignement strict.
Pour les couches d'attention complète, HYPIC utilise des « fenêtres de jonction » pour corriger l'attention inter-segments. Bien que quelques couches d'attention complète nécessitent encore le PIC dans les modèles hybrides, la recalcul sélectif précédent ne peut pas être directement migré car les couches linéaires en aval ne conservent que l'état final, rendant impossible le passage des tokens non terminaux vers le haut à travers la couche d'attention complète. Stocker l'état cyclique par token ou recalculer depuis zéro est irréalisable en raison des contraintes de stockage ou de calcul. L'équipe a observé que le biais après la concaténation KV est fortement concentré au début de chaque segment réutilisé, le reste étant presque inchangé, ce qui est cohérent avec le phénomène de puits d'attention dans les modèles d'attention complète, ce qui s'applique également aux modèles d'attention hybride. Sur cette base, HYPIC construit une fenêtre de jonction de w tokens au début de chaque segment interne, excluant ces tokens de la mise en cache. Lors de la réutilisation, ils sont recalculés sous le préfixe complet pour réparer l'attention inter-segments, avec w=8 par défaut ; comme la longueur réelle du segment est généralement supérieure à 512 tokens, la fenêtre de jonction constitue une très petite partie, rendant le coût de recalcul gérable. Pour supporter le recalcul du KV initial, les couches d'attention linéaire calculent T et S de la fenêtre de jonction lors de la réutilisation, faisant avancer l'état de fonctionnement tout en transmettant les sorties par couche de chaque token de jonction à la couche d'attention complète supérieure.
La troisième composante est le parallélisme au niveau des segments, transformant les « longues requêtes à froid » en charges de travail accélérées. Les erreurs de cache sont inévitables en raison des mises à jour continues du corpus et des suppressions de documents à faible fréquence, les longues requêtes à froid étant la principale cause de latence en queue. Les systèmes existants traitent l'intégralité du prompt comme une entité unique, préremplissant sériellement tous les segments froids sur une seule instance, avec un TTFT croissant comme O(n·|C|) ; bien que le parallélisme de tenseur et d'autres parallélismes intra-instance puissent accélérer les passes avant individuelles, leur évolutivité est limitée, une requête de 100k tokens sur TP-8 prenant toujours 17,7 secondes. Cependant, le PIC a déjà rendu chaque segment auto-contenu — ses résultats de préremplissage dépendent uniquement de ses tokens internes. HYPIC propose un parallélisme inter-instance au niveau des segments : le Routeur détecte si chaque segment touche le cache, puis distribue les segments froids en parallèle à plusieurs travailleurs de dispersion (scatter workers), et un travailneur d'assemblage (combine worker) assemble les résultats de chaque segment dans un état de fonctionnement complet, réduisant le temps de préremplissage à froid de O(n·|C|) à O(⌈n/m⌉·|C|+c). Pour utiliser pleinement ce chemin, HYPIC utilise une stratégie LPT (Longest Processing Time) gourmande pour équilibrer la charge de travail entre les travailleurs, et chevauche le calcul et la transmission de chaque segment pour éviter que le travailneur d'assemblage ne soit retardé par des pics de transmission synchrones ; le parallélisme au niveau des segments et le parallélisme intra-instance (TP/DP/SP) opèrent sur des axes orthogonaux et peuvent être combinés sans couture.
Ce système a été implémenté sur SGLang, avec environ 14 000 lignes de code Python et Triton. Il a été évalué sur huit nœuds H20 en utilisant quatre modèles d'attention hybride de niveau production (Ring-mini/flash-linear-2.0, Qwen3.5-35B-A3B/122B-A10B), quatre ensembles de données publics (HotpotQA, TriviaQA, MultiNews, GovReport) et une trace RAG de production. Après un préchauffage complet, comparé à Prefix Cache, HYPIC réduit le TTFT p50 en moyenne par 3,25 fois (de 2,77× à 4,05×), avec presque aucune perte de qualité — 16 unités « modèle × ensemble de données » n'étaient en moyenne que de 1,71 points derrière le recalcul complet, et même l'ont dépassé de 0,47 points sur Qwen3.5-35B. À titre de comparaison, une addition naïve sans mise en cache des opérateurs de transition a perdu 66,9 % du score, confirmant la nécessité de T_C. Sur la trace RAG de production, dans les mêmes conditions de SLA de TTFT de 1 seconde, HYPIC a augmenté le QPS durable de 1,66 fois (de 1,49× à 1,85×), et le débit de pointe par carte a augmenté d'environ 1,3 à 1,5 fois. Sur le chemin pur de miss à froid, le TTFT d'une requête de 32k tokens est passé de 2,83 secondes sur un seul travailleur à 0,49 seconde sur huit travailleurs, atteignant une accélération de 5,7×, avec presque tous les gains provenant de l'étape de dispersion évolutible. Contre le partitionnement inégal, LPT a réduit le TTFT de 1,26 seconde à 0,84 seconde (3,6× vs. 2,4×). La surcharge est également gérable : le coût unique de construction de (T_C, S(C|0)) n'est que de 5,2 % à 6,7 % de la passe avant principale dans le modèle de transfert dense le plus lourd, et ce coût peut être amorti en le réutilisant plusieurs fois.
HYPIC apporte pour la première fois la mise en cache agnostique à la position aux grands modèles d'attention hybride : il permet une combinaison d'états en temps constant pour les couches linéaires en utilisant des opérateurs de transition accumulés par segment mis en cache, corrige l'alignement inter-segments pour les couches d'attention complète avec de petites fenêtres de jonction, et transforme les longues requêtes à froid en charges de travail accélérées en utilisant le parallélisme au niveau des segments. Cela permet aux services à contexte long comme RAG et aux agents de bénéficier de la réutilisation du cache au niveau des segments tout en adoptant des architectures hybrides efficaces. L'équipe a déclaré que les travaux futurs se concentreront sur l'exploration de la gestion et de l'ordonnancement du PIC distribué, ainsi que sur la gestion de hiérarchies de cache multi-niveaux, faisant davantage avancer l'inférence des grands modèles vers des solutions plus rapides, plus économiques et plus évolutibles.
Article connexe
 WeChat WeMM-Embedding renforce la recherche dans Moments et les vidéos à la une avec 1 milliard d’appels quotidiens
Le 4 septembre, WeChat AI a annoncé la mise à disposition en open source de son modèle d’embedding multimodal général, WeMM-Embedding. Disponible en versions 2B, 4B et 9B, le modèle prend en charge les textes, les images, les vidéos, les documents vi
ChatGPT dévoile des autocollants personnalisés parfaitement compatibles avec les principales plateformes de réseaux sociaux
OpenAI a officiellement introduit une nouvelle fonctionnalité de stickers personnalisés pour ChatGPT, repoussant les limites de l’IA dans la création de contenus sociaux à grande échelle.Les utilisateurs peuvent créer des stickers personnalisés grâc
Anthropic lance des tests discrets en nuances de gris pour Claude Opus 5.2 et le modèle interne 2
Le dernier modèle phare d’Anthropic, Opus 5.2, est entré discrètement en phase de tests précoces au sein de Claude Code ce matin. Les développeurs ont noté une divergence marquée des performances entre les appels API et l’interface web. L’analyse des
Recommandations de sujets spéciaux liés
Conception et art
 Les meilleurs outils d'illustration basés sur l'IA : créez plus rapidement des scènes éditoriales et des illustrations de couverture
Les meilleurs outils d'illustration IA de 2026 : notre sélection regroupe les outils les plus performants pour créer rapidement de superbes scènes éditoriales et des couvertures accrocheuses. Chaque option a été soumise à des tests rigoureux en conditions réelles ; nous vous proposons une comparaison entre les versions gratuites et payantes afin de vous aider à trouver celle qui correspond le mieux à votre flux de travail. Essayez dès aujourd’hui ces solutions incontournables pour exploiter pleinement le potentiel de l’IA et booster votre productivité créative. Découvrez-les dès maintenant sur XIX.AI.
 10 outils
 xix.ai
Éducation et apprentissage
Les meilleurs professeurs particuliers spécialisés en IA pour la préparation aux examens : entraînez-vous en maths, en sciences et en anglais
Les meilleurs tuteurs IA 2026 les mieux notés pour la préparation aux examens sont disponibles ici, sur XIX.AI ! Notre sélection comprend des outils puissants et révolutionnaires qui proposent une comparaison entre les versions gratuites et payantes, des tests concrets et des classements mis à jour chaque semaine. Ils vous aident à améliorer votre efficacité à l'écrit, à simplifier l'apprentissage de sujets complexes et à libérer votre potentiel académique. Découvrez dès maintenant l'outil de préparation aux examens qui vous convient le mieux et commencez à créer dès aujourd'hui pour exploiter pleinement les avantages de l'IA !
10 outils
xix.ai
Finance
Outils de planification budgétaire par IA pour la gestion personnelle des finances
2026 Derniers Meilleurs Outils de Planification Budgétaire par IA les mieux notés pour la gestion personnelle des finances sont ici sur XIX.AI ! Cette collection soigneusement sélectionnée propose des solutions puissantes et révolutionnaires qui vous aident à réaliser des tests concrets, à comprendre vos habitudes de dépenses et à créer des plans personnalisés pour améliorer votre productivité. Profitez d’une comparaison entre versions gratuites et payantes ainsi que de classements détaillés. Des outils incontournables conçus pour simplifier la gestion financière et exploiter pleinement votre avantage grâce à l’IA. Explorez dès maintenant !
11 outils
xix.ai
Santé et bien-être
Assistants de suivi du sommeil par l’IA : améliorez votre récupération grâce à de meilleures habitudes avant le coucher
2026 : Découvrez les meilleurs assistants de suivi du sommeil basés sur l’IA, hautement notés et récemment mis à jour, conçus pour une récupération optimale. Ce guide hebdomadaire entièrement actualisé présente des outils puissants qui offrent des tests en conditions réelles, des comparaisons entre versions gratuites et payantes, ainsi que des classements détaillés afin de vous aider à trouver la solution idéale pour améliorer la qualité du sommeil et favoriser de meilleures habitudes avant le coucher. Explorez-le dès maintenant sur XIX.AI pour tirer parti des avantages offerts par l’IA.
10 outils
xix.ai
Analyse des données
Copilotes SQL basés sur l'IA pour l'analyse des produits et du chiffre d'affaires
2026 : les meilleurs copilotes SQL IA les mieux notés pour l'analyse des produits et du chiffre d'affaires ! XIX.AI a sélectionné une gamme d’outils puissants et révolutionnaires à essayer absolument, qui sont soumis à des tests en conditions réelles via des classements mis à jour chaque semaine. Ces outils aident les utilisateurs à booster considérablement leur productivité en accélérant l’analyse des données, en simplifiant les requêtes complexes et en générant des informations précises permettant de prendre des décisions commerciales plus éclairées. Explorez-les dès maintenant pour découvrir l’outil idéal qui vous permettra de tirer pleinement parti de l’IA !
14 outils
xix.ai
Éducation et apprentissage
Les meilleurs outils d'aide aux devoirs basés sur l'IA qui enseignent : apprenez les concepts, pas seulement les réponses
2026 : les meilleurs outils d'aide aux devoirs basés sur l'IA, les mieux notés, qui enseignent les concepts fondamentaux et ne se contentent pas de fournir des réponses. Des outils puissants pour les élèves. Une sélection incontournable à ne pas manquer. Mise à jour hebdomadaire. Comparaison entre les versions gratuites et payantes. Tests en conditions réelles. Classements précis pour vous aider à exploiter pleinement votre potentiel d'apprentissage. Explorez dès maintenant pour découvrir l'outil idéal qui vous permettra d'étudier plus efficacement.
10 outils
xix.ai

 commentaires (0)
L'objectif principal des services de grands modèles évolue vers des conversations à tour unique au profit de la réponse aux questions par récupération d'information (RAG), de la synthèse de documents multiples et d'agents à longue portée. Ces nouvelles charges de travail partagent une caractéristique clé : le prompt d'une seule requête comprend souvent des dizaines à des centaines de segments sémantiquement indépendants, incluant des documents récupérés, des descriptions de compétences, des fichiers de mémoire et des tours de conversation précédents, le tout assemblé dans des contextes ultra-longs allant de dizaines de milliers à plusieurs centaines de milliers de tokens. À cette échelle, la phase de préremplissage (prefill) domine le coût de calcul par requête, devenant la dépense la plus visible pour les fournisseurs de services. Plus critique encore, les erreurs de cache peuvent faire exploser le délai jusqu'au premier token (TTFT) jusqu'à plusieurs secondes, dégradant sévèrement l'expérience utilisateur.
L'industrie a adopté deux stratégies de réduction des coûts. La première est la mise en cache agnostique à la position (PIC), qui assouplit les contraintes strictes de préfixe, permettant à chaque segment sémantiquement indépendant d'être mis en cache une fois, puis assemblé dans n'importe quel préfixe, s'alignant parfaitement avec la composition des prompts de RAG et des agents. Ses mécanismes clés sont l'assemblage (splice), qui concatène directement le long de l'axe des tokens, et la correction, qui recalculer quelques tokens pour restaurer le contexte inter-segments. La deuxième approche est le modèle d'attention hybride, qui remplace la plupart des couches d'attention complète par une attention linéaire, réduisant la complexité quadratique à linéaire et compressant l'historique non borné dans un état cyclique de taille fixe. Des modèles de production récents comme MiniMax-M1, Ring-2.5, Qwen3.5 et Kimi-Linear linéarisent plus de 75 % de leurs couches, ne conservant que quelques couches d'attention complète, formant ainsi la conception hybride dominante. Par exemple, Qwen3.5-35B-A3B comporte 30 couches linéaires sur 40 au total.
La contradiction fondamentale réside ici : le PIC existant fonctionne sur des caches de clés-valeurs (KV) par token, tandis que les couches d'attention linéaire n'exposent qu'un état cyclique par requête, manquant d'accroches par token pour l'assemblage ou la correction. Par conséquent, la plupart des couches des modèles hybrides échappent aux capacités des systèmes PIC existants. Jusqu'à présent, aucun système ne fournissait de mise en cache agnostique à la position pour les grands modèles d'attention hybride.
Développé par l'équipe d'inférence de grands modèles de Xiaohongshu en collaboration avec l'Université de Pékin et l'Université Jiao Tong de Shanghai, HYPIC est le premier système de service à implémenter le PIC sur les grands modèles d'attention hybride. Des tests sur quatre modèles d'attention hybride de niveau production et cinq charges de travail montrent que HYPIC réduit le délai du premier token en moyenne par 3,25 fois et augmente le QPS durable de 1,66 fois dans les mêmes conditions de SLA, avec une qualité de tâche ne différant que de 1,71 points par rapport au recalcul complet. L'idée centrale du système est de traiter les couches linéaires et les couches d'attention complète séparément au sein du modèle hybride, accélérant les requêtes à froid grâce au parallélisme au niveau des couches via trois mécanismes interdépendants.
Pour les couches linéaires, HYPIC met en cache des « opérateurs de transition », permettant une combinaison d'états en temps constant. La solution la plus simple de PIC serait d'additionner directement les états finaux de deux segments ayant des valeurs initiales nulles — valide dans l'attention linéaire naïve mais échouant dans l'attention linéaire avancée avec décroissance, porte (gating) ou effacement delta (par exemple, RetNet, Mamba2, GLA, DeltaNet, GDN, KDA). La quantité critique manquante est l'opérateur de transition accumulé T_C d'un segment, c'est-à-dire le produit de toutes les matrices de transition de tokens au sein de celui-ci. L'état final réel devrait être S(C1·C2) = T(C2) · S(C1) + S(C2), tandis que l'addition simple omet le terme T(C2), causant une erreur structurelle. Les tests ont montré que la tête à décroissance lente dans RetNet présentait une erreur de 22 % de la norme d'état à 256 tokens. La clé de HYPIC est que T_C et l'état final à état initial nul S(C|0) sont déterminés uniquement par les tokens internes d'un segment, indépendamment du préfixe. Ainsi, lors du premier préremplissage d'un segment, HYPIC met en cache la paire (T_C, S(C|0)), et lors de sa réutilisation, applique la multiplication à gauche par T_C suivie d'une addition pour reconstruire presque exactement l'état final sous n'importe quel préfixe, couvrant naturellement toute la famille de l'attention linéaire. Des tests sur Qwen3.5-35B-A3B ont montré que les états combinés différaient du recalcul complet de seulement 6×10⁻⁵, dans le bruit FP16. Pour les variantes avec convolution causale ou RoPE, HYPIC utilise deux correctifs — réchauffement de l'état de convolution et ré-rotation de l'état — pour atteindre une alignement strict.
Pour les couches d'attention complète, HYPIC utilise des « fenêtres de jonction » pour corriger l'attention inter-segments. Bien que quelques couches d'attention complète nécessitent encore le PIC dans les modèles hybrides, la recalcul sélectif précédent ne peut pas être directement migré car les couches linéaires en aval ne conservent que l'état final, rendant impossible le passage des tokens non terminaux vers le haut à travers la couche d'attention complète. Stocker l'état cyclique par token ou recalculer depuis zéro est irréalisable en raison des contraintes de stockage ou de calcul. L'équipe a observé que le biais après la concaténation KV est fortement concentré au début de chaque segment réutilisé, le reste étant presque inchangé, ce qui est cohérent avec le phénomène de puits d'attention dans les modèles d'attention complète, ce qui s'applique également aux modèles d'attention hybride. Sur cette base, HYPIC construit une fenêtre de jonction de w tokens au début de chaque segment interne, excluant ces tokens de la mise en cache. Lors de la réutilisation, ils sont recalculés sous le préfixe complet pour réparer l'attention inter-segments, avec w=8 par défaut ; comme la longueur réelle du segment est généralement supérieure à 512 tokens, la fenêtre de jonction constitue une très petite partie, rendant le coût de recalcul gérable. Pour supporter le recalcul du KV initial, les couches d'attention linéaire calculent T et S de la fenêtre de jonction lors de la réutilisation, faisant avancer l'état de fonctionnement tout en transmettant les sorties par couche de chaque token de jonction à la couche d'attention complète supérieure.
La troisième composante est le parallélisme au niveau des segments, transformant les « longues requêtes à froid » en charges de travail accélérées. Les erreurs de cache sont inévitables en raison des mises à jour continues du corpus et des suppressions de documents à faible fréquence, les longues requêtes à froid étant la principale cause de latence en queue. Les systèmes existants traitent l'intégralité du prompt comme une entité unique, préremplissant sériellement tous les segments froids sur une seule instance, avec un TTFT croissant comme O(n·|C|) ; bien que le parallélisme de tenseur et d'autres parallélismes intra-instance puissent accélérer les passes avant individuelles, leur évolutivité est limitée, une requête de 100k tokens sur TP-8 prenant toujours 17,7 secondes. Cependant, le PIC a déjà rendu chaque segment auto-contenu — ses résultats de préremplissage dépendent uniquement de ses tokens internes. HYPIC propose un parallélisme inter-instance au niveau des segments : le Routeur détecte si chaque segment touche le cache, puis distribue les segments froids en parallèle à plusieurs travailleurs de dispersion (scatter workers), et un travailneur d'assemblage (combine worker) assemble les résultats de chaque segment dans un état de fonctionnement complet, réduisant le temps de préremplissage à froid de O(n·|C|) à O(⌈n/m⌉·|C|+c). Pour utiliser pleinement ce chemin, HYPIC utilise une stratégie LPT (Longest Processing Time) gourmande pour équilibrer la charge de travail entre les travailleurs, et chevauche le calcul et la transmission de chaque segment pour éviter que le travailneur d'assemblage ne soit retardé par des pics de transmission synchrones ; le parallélisme au niveau des segments et le parallélisme intra-instance (TP/DP/SP) opèrent sur des axes orthogonaux et peuvent être combinés sans couture.
Ce système a été implémenté sur SGLang, avec environ 14 000 lignes de code Python et Triton. Il a été évalué sur huit nœuds H20 en utilisant quatre modèles d'attention hybride de niveau production (Ring-mini/flash-linear-2.0, Qwen3.5-35B-A3B/122B-A10B), quatre ensembles de données publics (HotpotQA, TriviaQA, MultiNews, GovReport) et une trace RAG de production. Après un préchauffage complet, comparé à Prefix Cache, HYPIC réduit le TTFT p50 en moyenne par 3,25 fois (de 2,77× à 4,05×), avec presque aucune perte de qualité — 16 unités « modèle × ensemble de données » n'étaient en moyenne que de 1,71 points derrière le recalcul complet, et même l'ont dépassé de 0,47 points sur Qwen3.5-35B. À titre de comparaison, une addition naïve sans mise en cache des opérateurs de transition a perdu 66,9 % du score, confirmant la nécessité de T_C. Sur la trace RAG de production, dans les mêmes conditions de SLA de TTFT de 1 seconde, HYPIC a augmenté le QPS durable de 1,66 fois (de 1,49× à 1,85×), et le débit de pointe par carte a augmenté d'environ 1,3 à 1,5 fois. Sur le chemin pur de miss à froid, le TTFT d'une requête de 32k tokens est passé de 2,83 secondes sur un seul travailleur à 0,49 seconde sur huit travailleurs, atteignant une accélération de 5,7×, avec presque tous les gains provenant de l'étape de dispersion évolutible. Contre le partitionnement inégal, LPT a réduit le TTFT de 1,26 seconde à 0,84 seconde (3,6× vs. 2,4×). La surcharge est également gérable : le coût unique de construction de (T_C, S(C|0)) n'est que de 5,2 % à 6,7 % de la passe avant principale dans le modèle de transfert dense le plus lourd, et ce coût peut être amorti en le réutilisant plusieurs fois.
HYPIC apporte pour la première fois la mise en cache agnostique à la position aux grands modèles d'attention hybride : il permet une combinaison d'états en temps constant pour les couches linéaires en utilisant des opérateurs de transition accumulés par segment mis en cache, corrige l'alignement inter-segments pour les couches d'attention complète avec de petites fenêtres de jonction, et transforme les longues requêtes à froid en charges de travail accélérées en utilisant le parallélisme au niveau des segments. Cela permet aux services à contexte long comme RAG et aux agents de bénéficier de la réutilisation du cache au niveau des segments tout en adoptant des architectures hybrides efficaces. L'équipe a déclaré que les travaux futurs se concentreront sur l'exploration de la gestion et de l'ordonnancement du PIC distribué, ainsi que sur la gestion de hiérarchies de cache multi-niveaux, faisant davantage avancer l'inférence des grands modèles vers des solutions plus rapides, plus économiques et plus évolutibles.








 WeChat WeMM-Embedding renforce la recherche dans Moments et les vidéos à la une avec 1 milliard d’appels quotidiens
Le 4 septembre, WeChat AI a annoncé la mise à disposition en open source de son modèle d’embedding multimodal général, WeMM-Embedding. Disponible en versions 2B, 4B et 9B, le modèle prend en charge les textes, les images, les vidéos, les documents vi
 ChatGPT dévoile des autocollants personnalisés parfaitement compatibles avec les principales plateformes de réseaux sociaux
OpenAI a officiellement introduit une nouvelle fonctionnalité de stickers personnalisés pour ChatGPT, repoussant les limites de l’IA dans la création de contenus sociaux à grande échelle.Les utilisateurs peuvent créer des stickers personnalisés grâc
 Anthropic lance des tests discrets en nuances de gris pour Claude Opus 5.2 et le modèle interne 2
Le dernier modèle phare d’Anthropic, Opus 5.2, est entré discrètement en phase de tests précoces au sein de Claude Code ce matin. Les développeurs ont noté une divergence marquée des performances entre les appels API et l’interface web. L’analyse des

Les meilleurs outils d'illustration IA de 2026 : notre sélection regroupe les outils les plus performants pour créer rapidement de superbes scènes éditoriales et des couvertures accrocheuses. Chaque option a été soumise à des tests rigoureux en conditions réelles ; nous vous proposons une comparaison entre les versions gratuites et payantes afin de vous aider à trouver celle qui correspond le mieux à votre flux de travail. Essayez dès aujourd’hui ces solutions incontournables pour exploiter pleinement le potentiel de l’IA et booster votre productivité créative. Découvrez-les dès maintenant sur XIX.AI.
10 outils
xix.ai

Les meilleurs tuteurs IA 2026 les mieux notés pour la préparation aux examens sont disponibles ici, sur XIX.AI ! Notre sélection comprend des outils puissants et révolutionnaires qui proposent une comparaison entre les versions gratuites et payantes, des tests concrets et des classements mis à jour chaque semaine. Ils vous aident à améliorer votre efficacité à l'écrit, à simplifier l'apprentissage de sujets complexes et à libérer votre potentiel académique. Découvrez dès maintenant l'outil de préparation aux examens qui vous convient le mieux et commencez à créer dès aujourd'hui pour exploiter pleinement les avantages de l'IA !
10 outils
xix.ai

2026 Derniers Meilleurs Outils de Planification Budgétaire par IA les mieux notés pour la gestion personnelle des finances sont ici sur XIX.AI ! Cette collection soigneusement sélectionnée propose des solutions puissantes et révolutionnaires qui vous aident à réaliser des tests concrets, à comprendre vos habitudes de dépenses et à créer des plans personnalisés pour améliorer votre productivité. Profitez d’une comparaison entre versions gratuites et payantes ainsi que de classements détaillés. Des outils incontournables conçus pour simplifier la gestion financière et exploiter pleinement votre avantage grâce à l’IA. Explorez dès maintenant !
11 outils
xix.ai

2026 : Découvrez les meilleurs assistants de suivi du sommeil basés sur l’IA, hautement notés et récemment mis à jour, conçus pour une récupération optimale. Ce guide hebdomadaire entièrement actualisé présente des outils puissants qui offrent des tests en conditions réelles, des comparaisons entre versions gratuites et payantes, ainsi que des classements détaillés afin de vous aider à trouver la solution idéale pour améliorer la qualité du sommeil et favoriser de meilleures habitudes avant le coucher. Explorez-le dès maintenant sur XIX.AI pour tirer parti des avantages offerts par l’IA.
10 outils
xix.ai

2026 : les meilleurs copilotes SQL IA les mieux notés pour l'analyse des produits et du chiffre d'affaires ! XIX.AI a sélectionné une gamme d’outils puissants et révolutionnaires à essayer absolument, qui sont soumis à des tests en conditions réelles via des classements mis à jour chaque semaine. Ces outils aident les utilisateurs à booster considérablement leur productivité en accélérant l’analyse des données, en simplifiant les requêtes complexes et en générant des informations précises permettant de prendre des décisions commerciales plus éclairées. Explorez-les dès maintenant pour découvrir l’outil idéal qui vous permettra de tirer pleinement parti de l’IA !
14 outils
xix.ai

2026 : les meilleurs outils d'aide aux devoirs basés sur l'IA, les mieux notés, qui enseignent les concepts fondamentaux et ne se contentent pas de fournir des réponses. Des outils puissants pour les élèves. Une sélection incontournable à ne pas manquer. Mise à jour hebdomadaire. Comparaison entre les versions gratuites et payantes. Tests en conditions réelles. Classements précis pour vous aider à exploiter pleinement votre potentiel d'apprentissage. Explorez dès maintenant pour découvrir l'outil idéal qui vous permettra d'étudier plus efficacement.
10 outils
xix.ai












