


 Lar
Xiaohongshu, Universidade de Pequim e Universidade Jiao Tong de Xangai revelam o HYPIC para reduzir a latência do primeiro token em 3,25x em modelos de atenção híbrida
O foco principal dos serviços de grandes modelos está mudando de conversas de turno único para perguntas e respostas com recuperação aumentada (RAG), resumo de múltiplos documentos e agentes de longo alcance. Essas cargas de trabalho emergentes compartilham uma característica chave: o prompt de uma única solicitação frequentemente consiste em dezenas a centenas de segmentos semanticamente independentes, incluindo documentos recuperados, descrições de habilidades, arquivos de memória e rodadas de conversa anteriores, todos montados em contextos ultra-longos que variam de dezenas de milhares a centenas de milhares de tokens. Nessa escala, a fase de pré-preenchimento (prefill) domina o custo computacional por solicitação, tornando-se a despesa mais visível para os provedores de serviço. Mais criticamente, os erros de cache podem fazer com que o atraso do primeiro token (TTFT) aumente para vários segundos, degradando severamente a experiência do usuário.
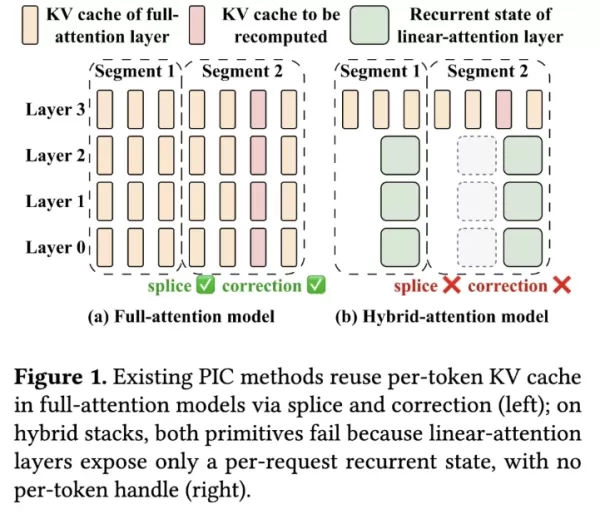
A indústria adotou duas estratégias de redução de custos. A primeira é o cache agnóstico à posição (PIC), que relaxa as restrições estritas de prefixo, permitindo que cada segmento semanticamente independente seja armazenado em cache uma vez e, em seguida, concatenado a qualquer prefixo, alinhando-se perfeitamente com a composição de prompts do RAG e de agentes. Seus mecanismos centrais são a concatenação (splice), que concatena diretamente ao longo do eixo do token, e a correção, que recalcula alguns tokens para restaurar o contexto entre segmentos. A segunda abordagem é o modelo de atenção híbrida, que substitui a maioria das camadas de atenção completa por atenção linear, reduzindo a complexidade quadrática para linear e comprimindo um histórico ilimitado em um estado cíclico de tamanho fixo. Modelos de produção recentes, como MiniMax-M1, Ring-2.5, Qwen3.5 e Kimi-Linear, linearizam mais de 75% de suas camadas, retendo apenas algumas camadas de atenção completa, formando o design híbrido predominante. Por exemplo, o Qwen3.5-35B-A3B possui 30 camadas lineares de um total de 40.
A contradição central reside aqui: o PIC existente opera em caches de chave-valor (KV) por token, enquanto as camadas de atenção linear expõem apenas um estado cíclico por solicitação, sem ganchos por token para concatenação ou correção. Consequentemente, a maioria das camadas em modelos híbridos fica fora das capacidades dos sistemas PIC existentes. Até agora, nenhum sistema forneceu cache agnóstico à posição para grandes modelos de atenção híbrida.
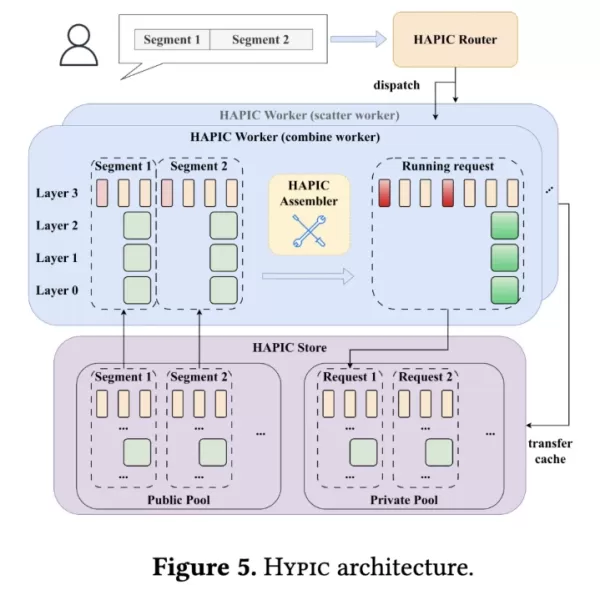
Desenvolvido pela equipe de inferência de grandes modelos da Xiaohongshu em colaboração com a Universidade de Pequim e a Universidade de Xangai Jiao Tong, o HYPIC é o primeiro sistema de serviço a implementar o PIC em grandes modelos de atenção híbrida. Testes em quatro modelos de atenção híbrida de nível de produção e cinco cargas de trabalho mostram que o HYPIC reduz o atraso do primeiro token em uma média de 3,25 vezes e aumenta o QPS sustentável em 1,66 vezes sob o mesmo SLO, com a qualidade da tarefa diferindo apenas em 1,71 pontos da recomputação completa. A ideia central do sistema é lidar com as camadas lineares e de atenção completa separadamente dentro do modelo híbrido, acelerando as solicitações frias por meio de paralelismo em nível de camada através de três mecanismos interligados.
Para as camadas lineares, o HYPIC armazena em cache "operadores de transição", permitindo a combinação de estados em tempo constante. A solução mais direta para o PIC seria adicionar diretamente os estados finais de dois segmentos com valores iniciais zero — válido na atenção linear ingênua, mas falho na atenção linear avançada com decaimento, portão ou eliminação delta (por exemplo, RetNet, Mamba2, GLA, DeltaNet, GDN, KDA). A quantidade crítica ausente é o operador de transição acumulado $T_C$ de um segmento, ou seja, o produto de todas as matrizes de transição de tokens dentro dele. O estado final real deve ser $S(C1 \cdot C2) = T(C2) \cdot S(C1) + S(C2)$, enquanto a adição simples omite o termo $T(C2)$, causando erro estrutural. Os testes mostraram que a cabeça de decaimento lenta no RetNet apresentou um erro de 22% da norma do estado em 256 tokens. A ideia chave do HYPIC é que o $T_C$ e o estado final de estado inicial zero $S(C|0)$ são determinados exclusivamente pelos tokens internos de um segmento, independentes do prefixo. Assim, durante o primeiro pré-preenchimento de um segmento, o HYPIC armazena em cache o par $(T_C, S(C|0))$ e, ao reutilizar, aplica a multiplicação à esquerda por $T_C$ seguida de adição para reconstruir quase exatamente o estado final sob qualquer prefixo, cobrindo naturalmente toda a família de atenção linear. Testes no Qwen3.5-35B-A3B mostraram que os estados combinados diferiram da recomputação completa em apenas $6 \times 10^{-5}$, dentro do ruído FP16. Para variantes com convolução causal ou RoPE, o HYPIC usa dois patches — aquecimento do estado de convolução e re-rotação do estado — para alcançar alinhamento estrito.
Para as camadas de atenção completa, o HYPIC usa "janelas de costura" para corrigir a atenção entre segmentos. Embora algumas camadas de atenção completa ainda exijam PIC em modelos híbridos, a recomputação seletiva anterior não pode ser migrada diretamente porque as camadas lineares subsequentes retêm apenas o estado final, tornando impossível para os tokens não terminais passarem para cima através da camada de atenção completa. Armazenar o estado cíclico por token ou recomputar do zero é inviável devido a restrições de armazenamento ou computação. A equipe observou que o viés após a concatenação KV é altamente concentrado no início de cada segmento reutilizado, com o resto quase inalterado, consistente com o fenômeno do poço de atenção em modelos de atenção completa, o que também se mantém em modelos de atenção híbrida. Com base nisso, o HYPIC constrói uma janela de costura de $w$ tokens no início de cada segmento interno, excluindo esses tokens do cache. Ao reutilizar, eles são recomputados sob o prefixo completo para reparar a atenção entre segmentos, com $w=8$ por padrão; como o comprimento real do segmento geralmente é maior que 512 tokens, a janela de costura constitui uma parte muito pequena, tornando o custo da recomputação gerenciável. Para suportar a recomputação do KV inicial, as camadas de atenção linear calculam o $T$ e o $S$ da janela de costura durante a reutilização, avançando o estado em execução enquanto encaminham as saídas por camada de cada token da costura para a camada superior de atenção completa.
O terceiro componente é o paralelismo em nível de segmento, transformando "longas solicitações frias" em cargas de trabalho aceleradas. Erros de cache são inevitáveis devido a atualizações contínuas do corpus e remoções de documentos de baixa frequência, sendo as longas solicitações frias a principal causa de latência na cauda. Sistemas existentes tratam o prompt inteiro como uma única entidade, pré-preenchendo serialmente todos os segmentos frios em uma única instância, com o TTFT crescendo como $O(n \cdot |C|)$; embora o paralelismo de tensor e outros paralelismos intra-instância possam acelerar passes individuais para frente, sua escalabilidade é limitada, com uma solicitação de 100k tokens no TP-8 ainda levando 17,7 segundos. No entanto, o PIC já tornou cada segmento autocontido — seus resultados de pré-preenchimento dependem apenas de seus tokens internos. O HYPIC propõe paralelismo em nível de segmento entre instâncias: o Router detecta se cada segmento acerta o cache e, em seguida, distribui segmentos frios em paralelo para vários trabalhadores dispersos (scatter workers), e um trabalhador de combinação (combine worker) monta os resultados de cada segmento em um estado em execução completo, reduzindo o tempo de pré-preenchimento frio de $O(n \cdot |C|)$ para $O(\lceil n/m \rceil \cdot |C| + c)$. Para utilizar totalmente este caminho, o HYPIC usa uma estratégia gulosa LPT (Longest Processing Time) para equilibrar a carga de trabalho entre os trabalhadores e sobrepõe a computação e a transmissão de cada segmento para evitar que o trabalhador de combinação seja retido por rajadas de transmissão síncrona; o paralelismo em nível de segmento e o paralelismo intra-instância (TP/DP/SP) operam em eixos ortogonais e podem ser combinados sem problemas.
Este sistema foi implementado no SGLang, com aproximadamente 14.000 linhas de código Python e Triton. Foi avaliado em oito nós H20 usando quatro modelos de atenção híbrida de nível de produção (Ring-mini/flash-linear-2.0, Qwen3.5-35B-A3B/122B-A10B), quatro conjuntos de dados públicos (HotpotQA, TriviaQA, MultiNews, GovReport) e um rastro de RAG de produção. Após o aquecimento completo, em comparação com o Prefix Cache, o HYPIC reduz o TTFT p50 em uma média de 3,25 vezes (de 2,77× para 4,05×), com perda de qualidade quase nula — 16 unidades "modelo × conjunto de dados" ficaram em média apenas 1,71 pontos atrás da recomputação completa, e até superaram a recomputação em 0,47 pontos no Qwen3.5-35B. Como comparação, uma adição ingênua sem armazenar em cache os operadores de transição perdeu 66,9% da pontuação, confirmando a necessidade do $T_C$. No rastro de RAG de produção, sob o mesmo SLO de TTFT de 1 segundo, o HYPIC aumentou o QPS sustentável em 1,66 vezes (de 1,49× para 1,85×), e a taxa de transferência de pico por placa aumentou em cerca de 1,3 a 1,5 vezes. No caminho puro de erro de cache frio, o TTFT de uma solicitação de 32k tokens caiu de 2,83 segundos em um único trabalhador para 0,49 segundos em oito trabalhadores, alcançando uma aceleração de 5,7×, com quase todos os ganhos provenientes da etapa dispersa escalável. Contra o particionamento desigual, o LPT reduziu o TTFT de 1,26 segundos para 0,84 segundos (3,6× vs. 2,4×). A sobrecarga também é gerenciável: o custo único de construir $(T_C, S(C|0))$ é apenas de 5,2% a 6,7% do passo principal para frente no modelo denso de transferência mais pesado, e esse custo pode ser amortizado ao reutilizá-lo várias vezes.
O HYPIC traz o cache agnóstico à posição para grandes modelos de atenção híbrida pela primeira vez: ele permite a combinação de estados em tempo constante para camadas lineares usando operadores de transição acumulados por segmento armazenados em cache, corrige o alinhamento entre segmentos para camadas de atenção completa com pequenas janelas de costura e transforma longas solicitações frias em cargas de trabalho aceleradas usando paralelismo em nível de segmento. Isso permite que serviços de contexto longo, como RAG e agentes, aproveitem os benefícios da reutilização de cache em nível de segmento enquanto abraçam arquiteturas híbridas eficientes. A equipe afirmou que o trabalho futuro se concentrará na exploração do gerenciamento e agendamento distribuído de PIC e no gerenciamento de hierarquia de cache de múltiplos níveis, avançando ainda mais a inferência de grandes modelos em direção a soluções mais rápidas, mais econômicas e mais escaláveis.
Artigo relacionado
 WeChat WeMM-Embedding Potencializa a Pesquisa no Moments e os Destaques de Vídeo com 1 Bilhão de Chamadas Diárias
Em 4 de setembro, o WeChat AI anunciou o lançamento de código aberto de seu modelo de incorporação multimodal geral, o WeMM-Embedding. Disponível nas versões 2B, 4B e 9B, o modelo suporta texto, imagens, vídeos, documentos visuais e qualquer entrada
O ChatGPT revela adesivos personalizados perfeitamente compatíveis com as principais plataformas de mídia social
A OpenAI apresentou oficialmente um novo recurso de adesivos personalizados para o ChatGPT, ampliando os limites da inteligência artificial na criação de conteúdo social em massa.Os usuários podem criar adesivos personalizados por meio de métodos in
A Anthropic lança testes discretos em escala cinza para o Claude Opus 5.2 e o Modelo Interno 2
O mais recente modelo principal da Anthropic, o Opus 5.2, entrou discretamente em testes iniciais dentro do Claude Code esta manhã. Os desenvolvedores notaram uma divergência significativa de desempenho entre as chamadas de API e a interface web. A a
Recomendações de tópicos especiais relacionados
Design e Arte
 As melhores ferramentas de ilustração com IA: crie cenas editoriais e capas de forma mais rápida
As melhores ferramentas de ilustração com IA de 2026: nossa lista selecionada apresenta as melhores ferramentas, com design robusto, para criar rapidamente cenas editoriais impressionantes e capas atraentes. Cada opção passou por rigorosos testes práticos, oferecendo uma comparação entre versões gratuitas e pagas para ajudar você a encontrar a opção perfeita para o seu fluxo de trabalho. Experimente hoje mesmo essas soluções imperdíveis para aproveitar ao máximo as vantagens da IA e impulsionar sua produtividade criativa. Explore agora no XIX.AI.
 10 ferramentas
 xix.ai
Educação e Aprendizagem
Os melhores professores particulares especializados em IA para preparação para exames: pratique matemática, ciências e inglês
Os melhores tutores de IA para preparação para exames de 2026, com as melhores avaliações, estão aqui no XIX.AI! Nossa lista cuidadosamente selecionada apresenta ferramentas poderosas e revolucionárias que oferecem comparação entre versões gratuitas e pagas, testes práticos e rankings atualizados semanalmente. Elas ajudam a aumentar sua eficiência na redação, simplificar o aprendizado de tópicos complexos e liberar seu potencial acadêmico. Explore agora para descobrir sua ferramenta perfeita de preparação para exames e comece a criar hoje mesmo para aproveitar toda a vantagem da IA!
10 ferramentas
xix.ai
Financiar
Ferramentas de planejamento orçamentário com IA para gestão financeira pessoal
As melhores e mais bem avaliadas ferramentas de planejamento orçamentário com IA para gestão financeira pessoal de 2026 estão aqui no XIX.AI! Esta seleção especial apresenta soluções poderosas e revolucionárias que ajudam você a realizar testes na prática, entender hábitos de consumo e criar planos personalizados para aumentar a produtividade. Confira uma comparação entre versões gratuitas e pagas, além de rankings detalhados. Ferramentas imperdíveis, projetadas para simplificar a gestão financeira e explorar o potencial da IA. Explore agora!
11 ferramentas
xix.ai
Saúde e Bem-Estar
Assistentes de rastreamento do sono com IA: melhore sua recuperação adotando hábitos mais adequados antes de dormir
2026 – Os melhores assistentes de rastreamento do sono com inteligência artificial mais bem avaliados, selecionados para proporcionar uma recuperação máxima. Este guia semanal completamente atualizado apresenta ferramentas poderosas que incluem testes reais, comparações entre versões gratuitas e pagas, além de classificações detalhadas, visando ajudá-lo a encontrar a solução ideal para melhorar a qualidade do sono e fomentar hábitos noturnos mais saudáveis. Explore agora em XIX.AI e aproveite todas as vantagens oferecidas pela inteligência artificial.
10 ferramentas
xix.ai
Análise de dados
Copilotos de IA em SQL para análise de produtos e receitas
2026: Os melhores e mais bem avaliados copilotos de IA para SQL em análise de produtos e receitas! A XIX.AI selecionou um conjunto poderoso e revolucionário de ferramentas imperdíveis, que passam por testes práticos por meio de rankings atualizados semanalmente. Essas ferramentas ajudam os usuários a aumentar significativamente a produtividade, acelerando a análise de dados, simplificando consultas complexas e gerando insights precisos para impulsionar decisões de negócios mais inteligentes. Explore agora e descubra a ferramenta perfeita para aproveitar ao máximo o potencial da IA!
14 ferramentas
xix.ai
Educação e Aprendizagem
Os melhores auxiliares de tarefas escolares com IA que ensinam: aprenda conceitos, não apenas respostas
2026: Os melhores e mais bem avaliados auxiliares de tarefas com IA que ensinam conceitos fundamentais, não apenas respostas. Ferramentas poderosas para estudantes. Lista selecionada que você não pode deixar de conferir. Atualizada semanalmente. Comparação entre versões gratuitas e pagas. Testes em situações reais. Rankings precisos para ajudar você a atingir todo o seu potencial de aprendizado. Explore agora e descubra a ferramenta perfeita para estudar de forma mais inteligente.
10 ferramentas
xix.ai

 Comentários (0)
O foco principal dos serviços de grandes modelos está mudando de conversas de turno único para perguntas e respostas com recuperação aumentada (RAG), resumo de múltiplos documentos e agentes de longo alcance. Essas cargas de trabalho emergentes compartilham uma característica chave: o prompt de uma única solicitação frequentemente consiste em dezenas a centenas de segmentos semanticamente independentes, incluindo documentos recuperados, descrições de habilidades, arquivos de memória e rodadas de conversa anteriores, todos montados em contextos ultra-longos que variam de dezenas de milhares a centenas de milhares de tokens. Nessa escala, a fase de pré-preenchimento (prefill) domina o custo computacional por solicitação, tornando-se a despesa mais visível para os provedores de serviço. Mais criticamente, os erros de cache podem fazer com que o atraso do primeiro token (TTFT) aumente para vários segundos, degradando severamente a experiência do usuário.
A indústria adotou duas estratégias de redução de custos. A primeira é o cache agnóstico à posição (PIC), que relaxa as restrições estritas de prefixo, permitindo que cada segmento semanticamente independente seja armazenado em cache uma vez e, em seguida, concatenado a qualquer prefixo, alinhando-se perfeitamente com a composição de prompts do RAG e de agentes. Seus mecanismos centrais são a concatenação (splice), que concatena diretamente ao longo do eixo do token, e a correção, que recalcula alguns tokens para restaurar o contexto entre segmentos. A segunda abordagem é o modelo de atenção híbrida, que substitui a maioria das camadas de atenção completa por atenção linear, reduzindo a complexidade quadrática para linear e comprimindo um histórico ilimitado em um estado cíclico de tamanho fixo. Modelos de produção recentes, como MiniMax-M1, Ring-2.5, Qwen3.5 e Kimi-Linear, linearizam mais de 75% de suas camadas, retendo apenas algumas camadas de atenção completa, formando o design híbrido predominante. Por exemplo, o Qwen3.5-35B-A3B possui 30 camadas lineares de um total de 40.
A contradição central reside aqui: o PIC existente opera em caches de chave-valor (KV) por token, enquanto as camadas de atenção linear expõem apenas um estado cíclico por solicitação, sem ganchos por token para concatenação ou correção. Consequentemente, a maioria das camadas em modelos híbridos fica fora das capacidades dos sistemas PIC existentes. Até agora, nenhum sistema forneceu cache agnóstico à posição para grandes modelos de atenção híbrida.
Desenvolvido pela equipe de inferência de grandes modelos da Xiaohongshu em colaboração com a Universidade de Pequim e a Universidade de Xangai Jiao Tong, o HYPIC é o primeiro sistema de serviço a implementar o PIC em grandes modelos de atenção híbrida. Testes em quatro modelos de atenção híbrida de nível de produção e cinco cargas de trabalho mostram que o HYPIC reduz o atraso do primeiro token em uma média de 3,25 vezes e aumenta o QPS sustentável em 1,66 vezes sob o mesmo SLO, com a qualidade da tarefa diferindo apenas em 1,71 pontos da recomputação completa. A ideia central do sistema é lidar com as camadas lineares e de atenção completa separadamente dentro do modelo híbrido, acelerando as solicitações frias por meio de paralelismo em nível de camada através de três mecanismos interligados.
Para as camadas lineares, o HYPIC armazena em cache "operadores de transição", permitindo a combinação de estados em tempo constante. A solução mais direta para o PIC seria adicionar diretamente os estados finais de dois segmentos com valores iniciais zero — válido na atenção linear ingênua, mas falho na atenção linear avançada com decaimento, portão ou eliminação delta (por exemplo, RetNet, Mamba2, GLA, DeltaNet, GDN, KDA). A quantidade crítica ausente é o operador de transição acumulado $T_C$ de um segmento, ou seja, o produto de todas as matrizes de transição de tokens dentro dele. O estado final real deve ser $S(C1 \cdot C2) = T(C2) \cdot S(C1) + S(C2)$, enquanto a adição simples omite o termo $T(C2)$, causando erro estrutural. Os testes mostraram que a cabeça de decaimento lenta no RetNet apresentou um erro de 22% da norma do estado em 256 tokens. A ideia chave do HYPIC é que o $T_C$ e o estado final de estado inicial zero $S(C|0)$ são determinados exclusivamente pelos tokens internos de um segmento, independentes do prefixo. Assim, durante o primeiro pré-preenchimento de um segmento, o HYPIC armazena em cache o par $(T_C, S(C|0))$ e, ao reutilizar, aplica a multiplicação à esquerda por $T_C$ seguida de adição para reconstruir quase exatamente o estado final sob qualquer prefixo, cobrindo naturalmente toda a família de atenção linear. Testes no Qwen3.5-35B-A3B mostraram que os estados combinados diferiram da recomputação completa em apenas $6 \times 10^{-5}$, dentro do ruído FP16. Para variantes com convolução causal ou RoPE, o HYPIC usa dois patches — aquecimento do estado de convolução e re-rotação do estado — para alcançar alinhamento estrito.
Para as camadas de atenção completa, o HYPIC usa "janelas de costura" para corrigir a atenção entre segmentos. Embora algumas camadas de atenção completa ainda exijam PIC em modelos híbridos, a recomputação seletiva anterior não pode ser migrada diretamente porque as camadas lineares subsequentes retêm apenas o estado final, tornando impossível para os tokens não terminais passarem para cima através da camada de atenção completa. Armazenar o estado cíclico por token ou recomputar do zero é inviável devido a restrições de armazenamento ou computação. A equipe observou que o viés após a concatenação KV é altamente concentrado no início de cada segmento reutilizado, com o resto quase inalterado, consistente com o fenômeno do poço de atenção em modelos de atenção completa, o que também se mantém em modelos de atenção híbrida. Com base nisso, o HYPIC constrói uma janela de costura de $w$ tokens no início de cada segmento interno, excluindo esses tokens do cache. Ao reutilizar, eles são recomputados sob o prefixo completo para reparar a atenção entre segmentos, com $w=8$ por padrão; como o comprimento real do segmento geralmente é maior que 512 tokens, a janela de costura constitui uma parte muito pequena, tornando o custo da recomputação gerenciável. Para suportar a recomputação do KV inicial, as camadas de atenção linear calculam o $T$ e o $S$ da janela de costura durante a reutilização, avançando o estado em execução enquanto encaminham as saídas por camada de cada token da costura para a camada superior de atenção completa.
O terceiro componente é o paralelismo em nível de segmento, transformando "longas solicitações frias" em cargas de trabalho aceleradas. Erros de cache são inevitáveis devido a atualizações contínuas do corpus e remoções de documentos de baixa frequência, sendo as longas solicitações frias a principal causa de latência na cauda. Sistemas existentes tratam o prompt inteiro como uma única entidade, pré-preenchendo serialmente todos os segmentos frios em uma única instância, com o TTFT crescendo como $O(n \cdot |C|)$; embora o paralelismo de tensor e outros paralelismos intra-instância possam acelerar passes individuais para frente, sua escalabilidade é limitada, com uma solicitação de 100k tokens no TP-8 ainda levando 17,7 segundos. No entanto, o PIC já tornou cada segmento autocontido — seus resultados de pré-preenchimento dependem apenas de seus tokens internos. O HYPIC propõe paralelismo em nível de segmento entre instâncias: o Router detecta se cada segmento acerta o cache e, em seguida, distribui segmentos frios em paralelo para vários trabalhadores dispersos (scatter workers), e um trabalhador de combinação (combine worker) monta os resultados de cada segmento em um estado em execução completo, reduzindo o tempo de pré-preenchimento frio de $O(n \cdot |C|)$ para $O(\lceil n/m \rceil \cdot |C| + c)$. Para utilizar totalmente este caminho, o HYPIC usa uma estratégia gulosa LPT (Longest Processing Time) para equilibrar a carga de trabalho entre os trabalhadores e sobrepõe a computação e a transmissão de cada segmento para evitar que o trabalhador de combinação seja retido por rajadas de transmissão síncrona; o paralelismo em nível de segmento e o paralelismo intra-instância (TP/DP/SP) operam em eixos ortogonais e podem ser combinados sem problemas.
Este sistema foi implementado no SGLang, com aproximadamente 14.000 linhas de código Python e Triton. Foi avaliado em oito nós H20 usando quatro modelos de atenção híbrida de nível de produção (Ring-mini/flash-linear-2.0, Qwen3.5-35B-A3B/122B-A10B), quatro conjuntos de dados públicos (HotpotQA, TriviaQA, MultiNews, GovReport) e um rastro de RAG de produção. Após o aquecimento completo, em comparação com o Prefix Cache, o HYPIC reduz o TTFT p50 em uma média de 3,25 vezes (de 2,77× para 4,05×), com perda de qualidade quase nula — 16 unidades "modelo × conjunto de dados" ficaram em média apenas 1,71 pontos atrás da recomputação completa, e até superaram a recomputação em 0,47 pontos no Qwen3.5-35B. Como comparação, uma adição ingênua sem armazenar em cache os operadores de transição perdeu 66,9% da pontuação, confirmando a necessidade do $T_C$. No rastro de RAG de produção, sob o mesmo SLO de TTFT de 1 segundo, o HYPIC aumentou o QPS sustentável em 1,66 vezes (de 1,49× para 1,85×), e a taxa de transferência de pico por placa aumentou em cerca de 1,3 a 1,5 vezes. No caminho puro de erro de cache frio, o TTFT de uma solicitação de 32k tokens caiu de 2,83 segundos em um único trabalhador para 0,49 segundos em oito trabalhadores, alcançando uma aceleração de 5,7×, com quase todos os ganhos provenientes da etapa dispersa escalável. Contra o particionamento desigual, o LPT reduziu o TTFT de 1,26 segundos para 0,84 segundos (3,6× vs. 2,4×). A sobrecarga também é gerenciável: o custo único de construir $(T_C, S(C|0))$ é apenas de 5,2% a 6,7% do passo principal para frente no modelo denso de transferência mais pesado, e esse custo pode ser amortizado ao reutilizá-lo várias vezes.
O HYPIC traz o cache agnóstico à posição para grandes modelos de atenção híbrida pela primeira vez: ele permite a combinação de estados em tempo constante para camadas lineares usando operadores de transição acumulados por segmento armazenados em cache, corrige o alinhamento entre segmentos para camadas de atenção completa com pequenas janelas de costura e transforma longas solicitações frias em cargas de trabalho aceleradas usando paralelismo em nível de segmento. Isso permite que serviços de contexto longo, como RAG e agentes, aproveitem os benefícios da reutilização de cache em nível de segmento enquanto abraçam arquiteturas híbridas eficientes. A equipe afirmou que o trabalho futuro se concentrará na exploração do gerenciamento e agendamento distribuído de PIC e no gerenciamento de hierarquia de cache de múltiplos níveis, avançando ainda mais a inferência de grandes modelos em direção a soluções mais rápidas, mais econômicas e mais escaláveis.








 WeChat WeMM-Embedding Potencializa a Pesquisa no Moments e os Destaques de Vídeo com 1 Bilhão de Chamadas Diárias
Em 4 de setembro, o WeChat AI anunciou o lançamento de código aberto de seu modelo de incorporação multimodal geral, o WeMM-Embedding. Disponível nas versões 2B, 4B e 9B, o modelo suporta texto, imagens, vídeos, documentos visuais e qualquer entrada
 O ChatGPT revela adesivos personalizados perfeitamente compatíveis com as principais plataformas de mídia social
A OpenAI apresentou oficialmente um novo recurso de adesivos personalizados para o ChatGPT, ampliando os limites da inteligência artificial na criação de conteúdo social em massa.Os usuários podem criar adesivos personalizados por meio de métodos in
 A Anthropic lança testes discretos em escala cinza para o Claude Opus 5.2 e o Modelo Interno 2
O mais recente modelo principal da Anthropic, o Opus 5.2, entrou discretamente em testes iniciais dentro do Claude Code esta manhã. Os desenvolvedores notaram uma divergência significativa de desempenho entre as chamadas de API e a interface web. A a

As melhores ferramentas de ilustração com IA de 2026: nossa lista selecionada apresenta as melhores ferramentas, com design robusto, para criar rapidamente cenas editoriais impressionantes e capas atraentes. Cada opção passou por rigorosos testes práticos, oferecendo uma comparação entre versões gratuitas e pagas para ajudar você a encontrar a opção perfeita para o seu fluxo de trabalho. Experimente hoje mesmo essas soluções imperdíveis para aproveitar ao máximo as vantagens da IA e impulsionar sua produtividade criativa. Explore agora no XIX.AI.
10 ferramentas
xix.ai

Os melhores tutores de IA para preparação para exames de 2026, com as melhores avaliações, estão aqui no XIX.AI! Nossa lista cuidadosamente selecionada apresenta ferramentas poderosas e revolucionárias que oferecem comparação entre versões gratuitas e pagas, testes práticos e rankings atualizados semanalmente. Elas ajudam a aumentar sua eficiência na redação, simplificar o aprendizado de tópicos complexos e liberar seu potencial acadêmico. Explore agora para descobrir sua ferramenta perfeita de preparação para exames e comece a criar hoje mesmo para aproveitar toda a vantagem da IA!
10 ferramentas
xix.ai

As melhores e mais bem avaliadas ferramentas de planejamento orçamentário com IA para gestão financeira pessoal de 2026 estão aqui no XIX.AI! Esta seleção especial apresenta soluções poderosas e revolucionárias que ajudam você a realizar testes na prática, entender hábitos de consumo e criar planos personalizados para aumentar a produtividade. Confira uma comparação entre versões gratuitas e pagas, além de rankings detalhados. Ferramentas imperdíveis, projetadas para simplificar a gestão financeira e explorar o potencial da IA. Explore agora!
11 ferramentas
xix.ai

2026 – Os melhores assistentes de rastreamento do sono com inteligência artificial mais bem avaliados, selecionados para proporcionar uma recuperação máxima. Este guia semanal completamente atualizado apresenta ferramentas poderosas que incluem testes reais, comparações entre versões gratuitas e pagas, além de classificações detalhadas, visando ajudá-lo a encontrar a solução ideal para melhorar a qualidade do sono e fomentar hábitos noturnos mais saudáveis. Explore agora em XIX.AI e aproveite todas as vantagens oferecidas pela inteligência artificial.
10 ferramentas
xix.ai

2026: Os melhores e mais bem avaliados copilotos de IA para SQL em análise de produtos e receitas! A XIX.AI selecionou um conjunto poderoso e revolucionário de ferramentas imperdíveis, que passam por testes práticos por meio de rankings atualizados semanalmente. Essas ferramentas ajudam os usuários a aumentar significativamente a produtividade, acelerando a análise de dados, simplificando consultas complexas e gerando insights precisos para impulsionar decisões de negócios mais inteligentes. Explore agora e descubra a ferramenta perfeita para aproveitar ao máximo o potencial da IA!
14 ferramentas
xix.ai

2026: Os melhores e mais bem avaliados auxiliares de tarefas com IA que ensinam conceitos fundamentais, não apenas respostas. Ferramentas poderosas para estudantes. Lista selecionada que você não pode deixar de conferir. Atualizada semanalmente. Comparação entre versões gratuitas e pagas. Testes em situações reais. Rankings precisos para ajudar você a atingir todo o seu potencial de aprendizado. Explore agora e descubra a ferramenta perfeita para estudar de forma mais inteligente.
10 ferramentas
xix.ai












