


 Heim
Xiaohongshu, die Peking-Universität und die Shanghai Jiao Tong University stellen HYPIC vor, um die Latenzzeit des ersten Tokens in hybriden Aufmerksamkeitsmodellen um das 3,25-Fache zu reduzieren.
Der Hauptfokus von Large-Model-Diensten verschiebt sich von einseitigen Gesprächen hin zu abfrageergänzter Fragebeantwortung (Retrieval-Augmented Question Answering), der Zusammenfassung mehrerer Dokumente und langreichweitigen Agenten. Diese neuartigen Arbeitslasten teilen eine wesentliche Eigenschaft: Der Prompt einer einzelnen Anfrage besteht oft aus Dutzenden bis Hunderten semantisch unabhängiger Segmente, einschließlich abgerufenen Dokumenten, Fähigkeitsbeschreibungen, Gedächtnisdateien und vorherigen Gesprächsrunden, die alle zu extrem langen Kontexten mit einer Länge von Zehntausenden bis Hunderttausenden von Token zusammengeführt werden. In diesem Maßstab dominiert die Prefill-Phase die Rechenkosten pro Anfrage und wird zur sichtbarsten Ausgabe für Diensteanbieter. Noch kritischer ist, dass Cache-Misses dazu führen können, dass die Verzögerung bis zum ersten Token (Time to First Token, TTFT) auf mehrere Sekunden ansteigt, was die Benutzererfahrung erheblich verschlechtert.
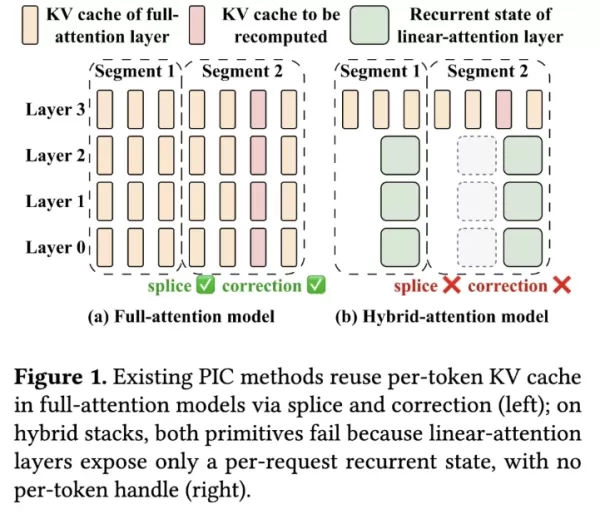
Die Industrie hat zwei Strategien zur Kostensenkung angewendet. Die erste ist das positionsunabhängige Caching (Position-Agnostic Caching, PIC), das strenge Präfixbeschränkungen lockert und es ermöglicht, jedes semantisch unabhängige Segment einmal zu zwischenspeichern und dann in jedes beliebige Präfix einzufügen, was perfekt zur Prompt-Zusammensetzung von RAG und Agenten passt. Seine Kernmechanismen sind das Verketten (Splice), das direkt entlang der Token-Achse konkateniert, und die Korrektur (Correction), bei der einige Token neu berechnet werden, um den kontextuellen Zusammenhang zwischen den Segmenten wiederherzustellen. Der zweite Ansatz ist das Hybrid-Aufmerksamkeitsmodell (Hybrid Attention Model), das die meisten vollständigen Aufmerksamkeitsschichten durch lineare Aufmerksamkeit ersetzt, die quadratische Komplexität auf Linearität reduziert und unbegrenzte Historie in einen zyklischen Zustand fester Größe komprimiert. Aktuelle Produktionsmodelle wie MiniMax-M1, Ring-2.5, Qwen3.5 und Kimi-Linear linearisieren über 75 % ihrer Schichten und behalten nur wenige vollständige Aufmerksamkeitsschichten bei, was den Mainstream-Hybridentwurf bildet. Zum Beispiel verfügt Qwen3.5-35B-A3B über 30 lineare Schichten von insgesamt 40.
Der Kernwiderspruch liegt hier: Bestehendes PIC operiert auf pro-Token-Key-Value-(KV)-Caches, während lineare Aufmerksamkeitslayer nur einen pro-Anfrage-zyklischen Zustand offenlegen und keine pro-Token-Hooks für Verketten oder Korrektur bieten. Folglich fallen die meisten Schichten in Hybridmodellen außerhalb der Fähigkeiten bestehender PIC-Systeme. Bis jetzt bot kein System positionsunabhängiges Caching für Hybrid-Aufmerksamheits-Large-Models.
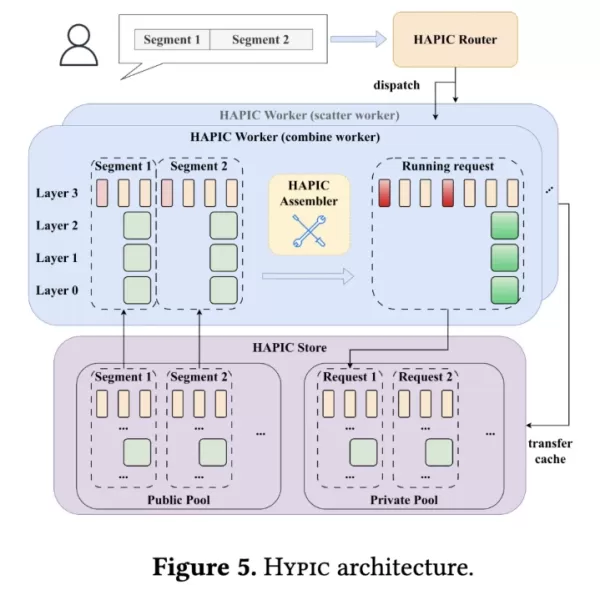
HYPIC, entwickelt vom Xiaohongshu-Large-Model-Inferenzteam in Zusammenarbeit mit der Peking-Universität und der Shanghai Jiao Tong University, ist das erste Dienstsysteem, das PIC auf Hybrid-Aufmerksamheits-Large-Models implementiert. Tests über vier Hybrid-Aufmerksamheitsmodelle auf Produktionsniveau und fünf Arbeitslasten zeigen, dass HYPIC die Verzögerung bis zum ersten Token im Durchschnitt um das 3,25-Fache reduziert und die nachhaltige QPS (Queries Per Second) unter derselben SLO (Service Level Objective) um das 1,66-Fache erhöht, wobei sich die Aufgabenqualität nur um 1,71 Punkte von der vollständigen Neuberechnung unterscheidet. Die Kernidee des Systems besteht darin, lineare und vollständige Aufmerksamkeitslayer innerhalb des Hybridmodells separat zu behandeln und kalte Anfragen durch Layer-Parallelität über drei ineinandergreifende Mechanismen zu beschleunigen.
Für lineare Layer zwischenspeichert HYPIC „Übergangsoperatoren“, was eine Kombination der Zustände in konstanter Zeit ermöglicht. Die naheliegendste PIC-Strohmannlösung besteht darin, die Endzustände zweier Segmente mit nullinitialen Werten direkt zu addieren – gültig bei naiver linearer Aufmerksamkeit, aber fehlerhaft bei fortschrittlicher linearer Aufmerksamkeit mit Verfall, Torung oder Delta-Löschung (z. B. RetNet, Mamba2, GLA, DeltaNet, GDN, KDA). Die kritische fehlende Größe ist der akkumulierte Übergangsoperator T_C eines Segments, d. h. das Produkt aller Token-Übergangsmatrizen innerhalb dieses Segments. Der tatsächliche Endzustand sollte S(C1·C2) = T(C2) · S(C1) + S(C2) sein, während die einfache Addition den T(C2)-Term auslässt und somit einen strukturellen Fehler verursacht. Tests zeigten, dass der langsam abklingende Kopf in RetNet bei 256 Token einen Fehler von 22 % der Zustandsnorm aufwies. Die zentrale Erkenntnis von HYPIC ist, dass T_C und der Endzustand S(C|0) bei Nullinitialisierung ausschließlich von den internen Token eines Segments bestimmt werden und unabhängig vom Präfix sind. Daher zwischenspeichert HYPIC während des ersten Prefills eines Segments das Paar (T_C, S(C|0)) und wendet bei Wiederverwendung die Linksmultiplikation von T_C gefolgt von der Addition an, um den Endzustand unter jedem beliebigen Präfix nahezu exakt zu rekonstruieren, was natürlich die gesamte Familie der linearen Aufmerksamkeit abdeckt. Tests an Qwen3.5-35B-A3B zeigten, dass kombinierte Zustände nur um 6×10⁻⁵ von der vollständigen Neuberechnung abwichen, was innerhalb des FP16-Rauschens liegt. Für Varianten mit kausaler Faltung oder RoPE verwendet HYPIC zwei Patches – Faltungszustands-Aufwärmung und Zustands-Neurotation – um eine strikte Ausrichtung zu erreichen.
Für vollständige Aufmerksamkeitslayer verwendet HYPIC „Nahtfenster“ (Seam Windows), um die segmentübergreifende Aufmerksamkeit zu korrigieren. Obwohl einige wenige vollständige Aufmerksamkeitslayer in Hybridmodellen weiterhin PIC erfordern, können frühere selektive Neuberechnungen nicht direkt migriert werden, da nachgelagerte lineare Layer nur den Endzustand behalten, was es nichtterminalen Token unmöglich macht, durch den vollständigen Aufmerksamkeitslayer nach oben zu gelangen. Das Speichern zyklischer Zustände pro Token oder das Neuberechnen von Grund auf ist aufgrund von Speicher- oder Berechnungseinschränkungen nicht praktikabel. Das Team stellte fest, dass die Verzerrung nach der KV-Konkatenation stark am Anfang jedes wiederverwendeten Segments konzentriert ist, während der Rest fast unbeeinflusst bleibt, was konsistent mit dem Aufmerksamkeits-Senken-Phänomen in vollständigen Aufmerksamkeitsmodellen ist, was auch in Hybrid-Aufmerksamkeitsmodellen gilt. Basierend darauf konstruiert HYPIC ein Nahtfenster aus w Token am Anfang jedes internen Segments und schließt diese Token vom Zwischenspeichern aus. Bei Wiederverwendung werden sie unter dem vollständigen Präfix neu berechnet, um die segmentübergreifende Aufmerksamkeit zu reparieren, wobei w standardmäßig 8 beträgt; da die tatsächliche Segmentlänge normalerweise größer als 512 Token ist, macht das Nahtfenster einen sehr kleinen Teil aus, sodass die Berechnungskosten handhabbar bleiben. Um die Neuberechnung des initialen KV zu unterstützen, berechnen lineare Aufmerksamkeitslayer während der Wiederverwendung T und S des Nahtfensters, setzen den laufenden Zustand fort und leiten die pro-Layer-Ausgaben jedes Naht-Tokens an den oberen vollständigen Aufmerksamkeitslayer weiter.
Die dritte Komponente ist die Segmentparallelität auf Ebene der Segmente, die „lange kalte Anfragen“ in beschleunigte Arbeitslasten verwandelt. Cache-Misses sind unvermeidlich aufgrund kontinuierlicher Korpusaktualisierungen und der Entfernung seltener Dokumente, wobei lange kalte Anfragen die Hauptursache für Latenz im Schwanz sind. Bestehende Systeme behandeln das gesamte Prompt als einzelne Einheit und führen den Prefill aller kalten Segmente auf einer einzelnen Instanz seriell durch, wobei TTFT mit O(n·|C|) wächst; obwohl Tensorparallelität und andere instanzinterne Parallelitäten einzelne Vorwärtsdurchläufe beschleunigen können, ist ihre Skalierbarkeit begrenzt, wobei eine Anfrage mit 100k Token auf TP-8 immer noch 17,7 Sekunden dauert. Da PIC jedoch jedes Segment bereits eigenständig gemacht hat – seine Prefill-Ergebnisse hängen nur von seinen internen Token ab – schlägt HYPIC eine instanzübergreifende Segmentparallelität vor: Der Router erkennt, ob jedes Segment den Cache trifft, verteilt dann kalte Segmente parallel an mehrere Scatter-Arbeiter, und ein Combine-Arbeiter fügt die Ergebnisse jedes Segments zu einem vollständigen laufenden Zustand zusammen, wodurch die kalte Prefill-Zeit von O(n·|C|) auf O(⌈n/m⌉·|C|+c) reduziert wird. Um diesen Pfad vollständig zu nutzen, verwendet HYPIC eine gierige LPT-Strategie (Longest Processing Time), um die Arbeitslast auf den Arbeitern auszugleichen, und überlappt die Berechnung und Übertragung jedes Segments, um zu vermeiden, dass der Combine-Arbeiter durch synchrone Übertragungsstöße blockiert wird; Segmentparallelität und instanzinterne Parallelität (TP/DP/SP) operieren auf orthogonalen Achsen und können nahtlos kombiniert werden.
Dieses System wurde auf SGLang implementiert, mit etwa 14.000 Zeilen Python- und Triton-Code. Es wurde auf acht H20-Knoten unter Verwendung von vier Hybrid-Aufmerksamkeitsmodellen auf Produktionsniveau (Ring-mini/flash-linear-2.0, Qwen3.5-35B-A3B/122B-A10B), vier öffentlichen Datensätzen (HotpotQA, TriviaQA, MultiNews, GovReport) und einer Produktions-RAG-Trace evaluiert. Nach vollständiger Vorwärmung reduziert HYPIC im Vergleich zu Prefix Cache den p50-TTFT im Durchschnitt um das 3,25-Fache (von 2,77× auf 4,05×), mit fast keinem Qualitätsverlust – 16 „Modell × Datensatz“-Einheiten lagen im Durchschnitt nur um 1,71 Punkte hinter der vollständigen Neuberechnung, und bei Qwen3.5-35B übertrafen sie diese sogar um 0,47 Punkte. Zum Vergleich verlor eine naive Addition ohne Zwischenspeichern von Übergangsoperatoren 66,9 % der Punktzahl, was die Notwendigkeit von T_C bestätigt. Auf der Produktions-RAG-Trace erhöhte HYPIC unter derselben 1-Sekunden-TTFT-SLO die nachhaltige QPS um das 1,66-Fache (von 1,49× auf 1,85×), und der Spitzen-Durchsatz pro Karte stieg um etwa 1,3 bis 1,5 Mal. Auf dem reinen kalten Miss-Pfad sank der TTFT einer Anfrage mit 32k Token von 2,83 Sekunden auf einem einzelnen Arbeiter auf 0,49 Sekunden auf acht Arbeitern, was eine 5,7-fache Beschleunigung erreichte, wobei fast alle Gewinne aus der skalierbaren Scatter-Phase stammten. Gegen ungleiche Sharding reduzierte LPT den TTFT von 1,26 Sekunden auf 0,84 Sekunden (3,6× vs. 2,4×). Die Overhead-Kosten sind ebenfalls handhabbar: Die einmalige Kosten für den Aufbau von (T_C, S(C|0)) betragen nur 5,2 % bis 6,7 % des Hauptvorwärtsdurchlaufs im dichtesten Transfermodell, und diese Kosten können durch mehrfache Wiederverteilung amortisiert werden.
HYPIC bringt positionsunabhängiges Caching zum ersten Mal auf Hybrid-Aufmerksamheits-Large-Models: Es ermöglicht eine zeitkonstante Zustandskombination für lineare Layer unter Verwendung zwischengespeicherter segmentweiser akkumulierter Übergangsoperatoren, korrigiert die segmentübergreifende Ausrichtung für vollständige Aufmerksamkeitslayer mit kleinen Nahtfenstern und verwandelt lange kalte Anfragen in beschleunigte Arbeitslasten unter Verwendung von Segmentparallelität. Dies ermöglicht es Langkontextdiensten wie RAG und Agenten, die Vorteile der segmentweisen Cache-Wiederverwendung zu nutzen, während sie effiziente Hybridarchitekturen umarmen. Das Team erklärte, dass zukünftige Arbeiten darauf abzielen werden, verteiltes PIC-Management und -Scheduling sowie mehrstufiges Cache-Hierarchiemanagement zu erforschen, was die Large-Model-Inferenz weiter in Richtung schnellerer, kostengünstigerer und skalierbarerer Lösungen vorantreiben wird.
Verwandter Artikel
 WeChat WeMM-Embedding ermöglicht die Suche in Moments und hebt Videos mit einer Milliarde täglichen Aufrufen hervor
Am 4. September kündigte WeChat AI die Open-Source-Veröffentlichung seines allgemeinen multimodalen Einbettungsmodells WeMM-Embedding an. Das Modell ist in den Versionen 2B, 4B und 9B verfügbar und unterstützt Text, Bilder, Videos, visuelle Dokumente
ChatGPT stellt benutzerdefinierte Sticker vor, die nahtlos mit den führenden Social-Media-Plattformen kompatibel sind
OpenAI hat offiziell eine neue Funktion für benutzerdefinierte Aufkleber für ChatGPT eingeführt und damit die Grenzen der KI in der massenhaften Erstellung sozialer Inhalte erweitert.Nutzer können personalisierte Aufkleber durch intuitive Methoden er
Anthropic führt unauffällige Graustufen-Tests für Claude Opus 5.2 und das interne Modell 2 ein
Anthropes neuestes Flaggschiff-Modell, Opus 5.2, ist heute Morgen still in die frühen Testphasen innerhalb von Claude Code eingetreten. Entwickler haben eine deutliche Leistungsdivergenz zwischen den API-Aufrufen und der Webschnittstelle festgestellt
Empfehlungen zu verwandten Spezialthemen
Design & Kunst
 Die besten KI-Illustrationstools: Redaktionelle Szenen und Cover-Grafiken schneller erstellen
Die besten und am besten bewerteten KI-Illustrationstools 2026: Unsere sorgfältig zusammengestellte Liste enthält die leistungsstärksten Tools, mit denen Sie im Handumdrehen atemberaubende redaktionelle Szenen und auffällige Cover-Grafiken erstellen können. Jede Option wurde strengen Praxistests unterzogen und wird im Vergleich zwischen kostenlosen und kostenpflichtigen Versionen vorgestellt, damit Sie die perfekte Lösung für Ihren Arbeitsablauf finden können. Probieren Sie diese unverzichtbaren Lösungen noch heute aus, um Ihren KI-Vorteil zu nutzen und Ihre kreative Produktivität zu steigern. Entdecken Sie sie jetzt auf XIX.AI.
 10 Tools
 xix.ai
Bildung und Lernen
Die besten KI-Nachhilfelehrer für die Prüfungsvorbereitung: Üben Sie Mathematik, Naturwissenschaften und Englisch
Die besten und am besten bewerteten KI-Nachhilfetools für die Prüfungsvorbereitung des Jahres 2026 finden Sie hier auf XIX.AI! Unsere sorgfältig zusammengestellte Liste enthält leistungsstarke, bahnbrechende Tools, die einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, Tests aus der Praxis sowie wöchentlich aktualisierte Rankings bieten. Sie helfen Ihnen dabei, Ihre Schreibeffizienz zu steigern, das Erlernen komplexer Themen zu vereinfachen und Ihr akademisches Potenzial voll auszuschöpfen. Entdecken Sie jetzt Ihr perfektes Tool zur Prüfungsvorbereitung und legen Sie noch heute los, um Ihren KI-Vorteil zu nutzen!
10 Tools
xix.ai
Finanzen
KI-Budgetplanungstools für das persönliche Geldmanagement
2026 Neueste Besten Top-Bewertete KI-Budgetplanungs-Tools für persönliches Geldmanagement sind hier auf XIX.AI! Diese kuratierte Sammlung bietet leistungsstarke, revolutionäre Lösungen, die Ihnen helfen, reale Tests durchzuführen, Ausgaben Gewohnheiten zu verstehen und personalisierte Pläne zu erstellen, um die Produktivität zu steigern. Genießen Sie einen kostenlosen vs. bezahlten Vergleich sowie detaillierte Rankings. Unbedingt auszuprobierende Tools, die darauf ausgelegt sind, das Geldmanagement zu vereinfachen und Ihre KI-Vorteile freizuschalten. Entdecken Sie jetzt!
11 Tools
xix.ai
Gesundheit Wellness
KI-gestützte Schlafüberwachungsassistenten: Verbessern Sie Ihre Erholung durch bessere Gewohnheiten vor dem Schlafengehen
2026 – Die neuesten, besten und am höchsten bewerteten AI-Geräte zur Schlafüberwachung, sorgfältig ausgewählt für eine optimale Erholung. Dieser vollständig aktualisierte wöchentliche Leitfaden präsentiert leistungsstarke Tools mit praktischen Tests, einem Vergleich von kostenlosen und kostenpflichtigen Optionen sowie detaillierten Ranglisten, um Ihnen die beste Lösung zu zeigen, die die Schlafqualität verbessert und bessere Gewohnheiten zum Zubettgehen fördert. Entdecken Sie ihn jetzt auf XIX.AI, um Ihren Vorteil durch KI zu nutzen.
10 Tools
xix.ai
Datenanalyse
KI-gestützte SQL-Copilots für Produkt- und Umsatzanalysen
Die besten und am besten bewerteten KI-SQL-Copilots für Produkt- und Umsatzanalysen im Jahr 2026! XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung unverzichtbarer Tools zusammengestellt, die anhand wöchentlich aktualisierter Rankings in der Praxis getestet werden. Diese Tools helfen Anwendern dabei, ihre Produktivität erheblich zu steigern, indem sie die Datenanalyse beschleunigen, komplexe Abfragen optimieren und präzise Erkenntnisse liefern, um intelligentere Geschäftsentscheidungen zu ermöglichen. Entdecken Sie jetzt das perfekte Tool, um Ihren KI-Vorteil voll auszuschöpfen!
14 Tools
xix.ai
Bildung und Lernen
Die besten KI-Hausaufgabenhelfer, die wirklich etwas vermitteln: Lerne Konzepte, nicht nur Antworten
2026: Die aktuell besten und am besten bewerteten KI-Hausaufgabenhelfer, die nicht nur Antworten liefern, sondern auch Kernkonzepte vermitteln – leistungsstarke Tools für Schüler und Studenten. Eine kuratierte Liste, die Sie unbedingt ausprobieren sollten. Wöchentlich aktualisiert. Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten. Praxistests. Genaue Rankings, die Ihnen helfen, Ihr volles Lernpotenzial auszuschöpfen. Entdecken Sie jetzt das perfekte Tool für intelligenteres Lernen.
10 Tools
xix.ai

 Kommentare (0)
Der Hauptfokus von Large-Model-Diensten verschiebt sich von einseitigen Gesprächen hin zu abfrageergänzter Fragebeantwortung (Retrieval-Augmented Question Answering), der Zusammenfassung mehrerer Dokumente und langreichweitigen Agenten. Diese neuartigen Arbeitslasten teilen eine wesentliche Eigenschaft: Der Prompt einer einzelnen Anfrage besteht oft aus Dutzenden bis Hunderten semantisch unabhängiger Segmente, einschließlich abgerufenen Dokumenten, Fähigkeitsbeschreibungen, Gedächtnisdateien und vorherigen Gesprächsrunden, die alle zu extrem langen Kontexten mit einer Länge von Zehntausenden bis Hunderttausenden von Token zusammengeführt werden. In diesem Maßstab dominiert die Prefill-Phase die Rechenkosten pro Anfrage und wird zur sichtbarsten Ausgabe für Diensteanbieter. Noch kritischer ist, dass Cache-Misses dazu führen können, dass die Verzögerung bis zum ersten Token (Time to First Token, TTFT) auf mehrere Sekunden ansteigt, was die Benutzererfahrung erheblich verschlechtert.
Die Industrie hat zwei Strategien zur Kostensenkung angewendet. Die erste ist das positionsunabhängige Caching (Position-Agnostic Caching, PIC), das strenge Präfixbeschränkungen lockert und es ermöglicht, jedes semantisch unabhängige Segment einmal zu zwischenspeichern und dann in jedes beliebige Präfix einzufügen, was perfekt zur Prompt-Zusammensetzung von RAG und Agenten passt. Seine Kernmechanismen sind das Verketten (Splice), das direkt entlang der Token-Achse konkateniert, und die Korrektur (Correction), bei der einige Token neu berechnet werden, um den kontextuellen Zusammenhang zwischen den Segmenten wiederherzustellen. Der zweite Ansatz ist das Hybrid-Aufmerksamkeitsmodell (Hybrid Attention Model), das die meisten vollständigen Aufmerksamkeitsschichten durch lineare Aufmerksamkeit ersetzt, die quadratische Komplexität auf Linearität reduziert und unbegrenzte Historie in einen zyklischen Zustand fester Größe komprimiert. Aktuelle Produktionsmodelle wie MiniMax-M1, Ring-2.5, Qwen3.5 und Kimi-Linear linearisieren über 75 % ihrer Schichten und behalten nur wenige vollständige Aufmerksamkeitsschichten bei, was den Mainstream-Hybridentwurf bildet. Zum Beispiel verfügt Qwen3.5-35B-A3B über 30 lineare Schichten von insgesamt 40.
Der Kernwiderspruch liegt hier: Bestehendes PIC operiert auf pro-Token-Key-Value-(KV)-Caches, während lineare Aufmerksamkeitslayer nur einen pro-Anfrage-zyklischen Zustand offenlegen und keine pro-Token-Hooks für Verketten oder Korrektur bieten. Folglich fallen die meisten Schichten in Hybridmodellen außerhalb der Fähigkeiten bestehender PIC-Systeme. Bis jetzt bot kein System positionsunabhängiges Caching für Hybrid-Aufmerksamheits-Large-Models.
HYPIC, entwickelt vom Xiaohongshu-Large-Model-Inferenzteam in Zusammenarbeit mit der Peking-Universität und der Shanghai Jiao Tong University, ist das erste Dienstsysteem, das PIC auf Hybrid-Aufmerksamheits-Large-Models implementiert. Tests über vier Hybrid-Aufmerksamheitsmodelle auf Produktionsniveau und fünf Arbeitslasten zeigen, dass HYPIC die Verzögerung bis zum ersten Token im Durchschnitt um das 3,25-Fache reduziert und die nachhaltige QPS (Queries Per Second) unter derselben SLO (Service Level Objective) um das 1,66-Fache erhöht, wobei sich die Aufgabenqualität nur um 1,71 Punkte von der vollständigen Neuberechnung unterscheidet. Die Kernidee des Systems besteht darin, lineare und vollständige Aufmerksamkeitslayer innerhalb des Hybridmodells separat zu behandeln und kalte Anfragen durch Layer-Parallelität über drei ineinandergreifende Mechanismen zu beschleunigen.
Für lineare Layer zwischenspeichert HYPIC „Übergangsoperatoren“, was eine Kombination der Zustände in konstanter Zeit ermöglicht. Die naheliegendste PIC-Strohmannlösung besteht darin, die Endzustände zweier Segmente mit nullinitialen Werten direkt zu addieren – gültig bei naiver linearer Aufmerksamkeit, aber fehlerhaft bei fortschrittlicher linearer Aufmerksamkeit mit Verfall, Torung oder Delta-Löschung (z. B. RetNet, Mamba2, GLA, DeltaNet, GDN, KDA). Die kritische fehlende Größe ist der akkumulierte Übergangsoperator T_C eines Segments, d. h. das Produkt aller Token-Übergangsmatrizen innerhalb dieses Segments. Der tatsächliche Endzustand sollte S(C1·C2) = T(C2) · S(C1) + S(C2) sein, während die einfache Addition den T(C2)-Term auslässt und somit einen strukturellen Fehler verursacht. Tests zeigten, dass der langsam abklingende Kopf in RetNet bei 256 Token einen Fehler von 22 % der Zustandsnorm aufwies. Die zentrale Erkenntnis von HYPIC ist, dass T_C und der Endzustand S(C|0) bei Nullinitialisierung ausschließlich von den internen Token eines Segments bestimmt werden und unabhängig vom Präfix sind. Daher zwischenspeichert HYPIC während des ersten Prefills eines Segments das Paar (T_C, S(C|0)) und wendet bei Wiederverwendung die Linksmultiplikation von T_C gefolgt von der Addition an, um den Endzustand unter jedem beliebigen Präfix nahezu exakt zu rekonstruieren, was natürlich die gesamte Familie der linearen Aufmerksamkeit abdeckt. Tests an Qwen3.5-35B-A3B zeigten, dass kombinierte Zustände nur um 6×10⁻⁵ von der vollständigen Neuberechnung abwichen, was innerhalb des FP16-Rauschens liegt. Für Varianten mit kausaler Faltung oder RoPE verwendet HYPIC zwei Patches – Faltungszustands-Aufwärmung und Zustands-Neurotation – um eine strikte Ausrichtung zu erreichen.
Für vollständige Aufmerksamkeitslayer verwendet HYPIC „Nahtfenster“ (Seam Windows), um die segmentübergreifende Aufmerksamkeit zu korrigieren. Obwohl einige wenige vollständige Aufmerksamkeitslayer in Hybridmodellen weiterhin PIC erfordern, können frühere selektive Neuberechnungen nicht direkt migriert werden, da nachgelagerte lineare Layer nur den Endzustand behalten, was es nichtterminalen Token unmöglich macht, durch den vollständigen Aufmerksamkeitslayer nach oben zu gelangen. Das Speichern zyklischer Zustände pro Token oder das Neuberechnen von Grund auf ist aufgrund von Speicher- oder Berechnungseinschränkungen nicht praktikabel. Das Team stellte fest, dass die Verzerrung nach der KV-Konkatenation stark am Anfang jedes wiederverwendeten Segments konzentriert ist, während der Rest fast unbeeinflusst bleibt, was konsistent mit dem Aufmerksamkeits-Senken-Phänomen in vollständigen Aufmerksamkeitsmodellen ist, was auch in Hybrid-Aufmerksamkeitsmodellen gilt. Basierend darauf konstruiert HYPIC ein Nahtfenster aus w Token am Anfang jedes internen Segments und schließt diese Token vom Zwischenspeichern aus. Bei Wiederverwendung werden sie unter dem vollständigen Präfix neu berechnet, um die segmentübergreifende Aufmerksamkeit zu reparieren, wobei w standardmäßig 8 beträgt; da die tatsächliche Segmentlänge normalerweise größer als 512 Token ist, macht das Nahtfenster einen sehr kleinen Teil aus, sodass die Berechnungskosten handhabbar bleiben. Um die Neuberechnung des initialen KV zu unterstützen, berechnen lineare Aufmerksamkeitslayer während der Wiederverwendung T und S des Nahtfensters, setzen den laufenden Zustand fort und leiten die pro-Layer-Ausgaben jedes Naht-Tokens an den oberen vollständigen Aufmerksamkeitslayer weiter.
Die dritte Komponente ist die Segmentparallelität auf Ebene der Segmente, die „lange kalte Anfragen“ in beschleunigte Arbeitslasten verwandelt. Cache-Misses sind unvermeidlich aufgrund kontinuierlicher Korpusaktualisierungen und der Entfernung seltener Dokumente, wobei lange kalte Anfragen die Hauptursache für Latenz im Schwanz sind. Bestehende Systeme behandeln das gesamte Prompt als einzelne Einheit und führen den Prefill aller kalten Segmente auf einer einzelnen Instanz seriell durch, wobei TTFT mit O(n·|C|) wächst; obwohl Tensorparallelität und andere instanzinterne Parallelitäten einzelne Vorwärtsdurchläufe beschleunigen können, ist ihre Skalierbarkeit begrenzt, wobei eine Anfrage mit 100k Token auf TP-8 immer noch 17,7 Sekunden dauert. Da PIC jedoch jedes Segment bereits eigenständig gemacht hat – seine Prefill-Ergebnisse hängen nur von seinen internen Token ab – schlägt HYPIC eine instanzübergreifende Segmentparallelität vor: Der Router erkennt, ob jedes Segment den Cache trifft, verteilt dann kalte Segmente parallel an mehrere Scatter-Arbeiter, und ein Combine-Arbeiter fügt die Ergebnisse jedes Segments zu einem vollständigen laufenden Zustand zusammen, wodurch die kalte Prefill-Zeit von O(n·|C|) auf O(⌈n/m⌉·|C|+c) reduziert wird. Um diesen Pfad vollständig zu nutzen, verwendet HYPIC eine gierige LPT-Strategie (Longest Processing Time), um die Arbeitslast auf den Arbeitern auszugleichen, und überlappt die Berechnung und Übertragung jedes Segments, um zu vermeiden, dass der Combine-Arbeiter durch synchrone Übertragungsstöße blockiert wird; Segmentparallelität und instanzinterne Parallelität (TP/DP/SP) operieren auf orthogonalen Achsen und können nahtlos kombiniert werden.
Dieses System wurde auf SGLang implementiert, mit etwa 14.000 Zeilen Python- und Triton-Code. Es wurde auf acht H20-Knoten unter Verwendung von vier Hybrid-Aufmerksamkeitsmodellen auf Produktionsniveau (Ring-mini/flash-linear-2.0, Qwen3.5-35B-A3B/122B-A10B), vier öffentlichen Datensätzen (HotpotQA, TriviaQA, MultiNews, GovReport) und einer Produktions-RAG-Trace evaluiert. Nach vollständiger Vorwärmung reduziert HYPIC im Vergleich zu Prefix Cache den p50-TTFT im Durchschnitt um das 3,25-Fache (von 2,77× auf 4,05×), mit fast keinem Qualitätsverlust – 16 „Modell × Datensatz“-Einheiten lagen im Durchschnitt nur um 1,71 Punkte hinter der vollständigen Neuberechnung, und bei Qwen3.5-35B übertrafen sie diese sogar um 0,47 Punkte. Zum Vergleich verlor eine naive Addition ohne Zwischenspeichern von Übergangsoperatoren 66,9 % der Punktzahl, was die Notwendigkeit von T_C bestätigt. Auf der Produktions-RAG-Trace erhöhte HYPIC unter derselben 1-Sekunden-TTFT-SLO die nachhaltige QPS um das 1,66-Fache (von 1,49× auf 1,85×), und der Spitzen-Durchsatz pro Karte stieg um etwa 1,3 bis 1,5 Mal. Auf dem reinen kalten Miss-Pfad sank der TTFT einer Anfrage mit 32k Token von 2,83 Sekunden auf einem einzelnen Arbeiter auf 0,49 Sekunden auf acht Arbeitern, was eine 5,7-fache Beschleunigung erreichte, wobei fast alle Gewinne aus der skalierbaren Scatter-Phase stammten. Gegen ungleiche Sharding reduzierte LPT den TTFT von 1,26 Sekunden auf 0,84 Sekunden (3,6× vs. 2,4×). Die Overhead-Kosten sind ebenfalls handhabbar: Die einmalige Kosten für den Aufbau von (T_C, S(C|0)) betragen nur 5,2 % bis 6,7 % des Hauptvorwärtsdurchlaufs im dichtesten Transfermodell, und diese Kosten können durch mehrfache Wiederverteilung amortisiert werden.
HYPIC bringt positionsunabhängiges Caching zum ersten Mal auf Hybrid-Aufmerksamheits-Large-Models: Es ermöglicht eine zeitkonstante Zustandskombination für lineare Layer unter Verwendung zwischengespeicherter segmentweiser akkumulierter Übergangsoperatoren, korrigiert die segmentübergreifende Ausrichtung für vollständige Aufmerksamkeitslayer mit kleinen Nahtfenstern und verwandelt lange kalte Anfragen in beschleunigte Arbeitslasten unter Verwendung von Segmentparallelität. Dies ermöglicht es Langkontextdiensten wie RAG und Agenten, die Vorteile der segmentweisen Cache-Wiederverwendung zu nutzen, während sie effiziente Hybridarchitekturen umarmen. Das Team erklärte, dass zukünftige Arbeiten darauf abzielen werden, verteiltes PIC-Management und -Scheduling sowie mehrstufiges Cache-Hierarchiemanagement zu erforschen, was die Large-Model-Inferenz weiter in Richtung schnellerer, kostengünstigerer und skalierbarerer Lösungen vorantreiben wird.








 WeChat WeMM-Embedding ermöglicht die Suche in Moments und hebt Videos mit einer Milliarde täglichen Aufrufen hervor
Am 4. September kündigte WeChat AI die Open-Source-Veröffentlichung seines allgemeinen multimodalen Einbettungsmodells WeMM-Embedding an. Das Modell ist in den Versionen 2B, 4B und 9B verfügbar und unterstützt Text, Bilder, Videos, visuelle Dokumente
 ChatGPT stellt benutzerdefinierte Sticker vor, die nahtlos mit den führenden Social-Media-Plattformen kompatibel sind
OpenAI hat offiziell eine neue Funktion für benutzerdefinierte Aufkleber für ChatGPT eingeführt und damit die Grenzen der KI in der massenhaften Erstellung sozialer Inhalte erweitert.Nutzer können personalisierte Aufkleber durch intuitive Methoden er
 Anthropic führt unauffällige Graustufen-Tests für Claude Opus 5.2 und das interne Modell 2 ein
Anthropes neuestes Flaggschiff-Modell, Opus 5.2, ist heute Morgen still in die frühen Testphasen innerhalb von Claude Code eingetreten. Entwickler haben eine deutliche Leistungsdivergenz zwischen den API-Aufrufen und der Webschnittstelle festgestellt

Die besten und am besten bewerteten KI-Illustrationstools 2026: Unsere sorgfältig zusammengestellte Liste enthält die leistungsstärksten Tools, mit denen Sie im Handumdrehen atemberaubende redaktionelle Szenen und auffällige Cover-Grafiken erstellen können. Jede Option wurde strengen Praxistests unterzogen und wird im Vergleich zwischen kostenlosen und kostenpflichtigen Versionen vorgestellt, damit Sie die perfekte Lösung für Ihren Arbeitsablauf finden können. Probieren Sie diese unverzichtbaren Lösungen noch heute aus, um Ihren KI-Vorteil zu nutzen und Ihre kreative Produktivität zu steigern. Entdecken Sie sie jetzt auf XIX.AI.
10 Tools
xix.ai

Die besten und am besten bewerteten KI-Nachhilfetools für die Prüfungsvorbereitung des Jahres 2026 finden Sie hier auf XIX.AI! Unsere sorgfältig zusammengestellte Liste enthält leistungsstarke, bahnbrechende Tools, die einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, Tests aus der Praxis sowie wöchentlich aktualisierte Rankings bieten. Sie helfen Ihnen dabei, Ihre Schreibeffizienz zu steigern, das Erlernen komplexer Themen zu vereinfachen und Ihr akademisches Potenzial voll auszuschöpfen. Entdecken Sie jetzt Ihr perfektes Tool zur Prüfungsvorbereitung und legen Sie noch heute los, um Ihren KI-Vorteil zu nutzen!
10 Tools
xix.ai

2026 Neueste Besten Top-Bewertete KI-Budgetplanungs-Tools für persönliches Geldmanagement sind hier auf XIX.AI! Diese kuratierte Sammlung bietet leistungsstarke, revolutionäre Lösungen, die Ihnen helfen, reale Tests durchzuführen, Ausgaben Gewohnheiten zu verstehen und personalisierte Pläne zu erstellen, um die Produktivität zu steigern. Genießen Sie einen kostenlosen vs. bezahlten Vergleich sowie detaillierte Rankings. Unbedingt auszuprobierende Tools, die darauf ausgelegt sind, das Geldmanagement zu vereinfachen und Ihre KI-Vorteile freizuschalten. Entdecken Sie jetzt!
11 Tools
xix.ai

2026 – Die neuesten, besten und am höchsten bewerteten AI-Geräte zur Schlafüberwachung, sorgfältig ausgewählt für eine optimale Erholung. Dieser vollständig aktualisierte wöchentliche Leitfaden präsentiert leistungsstarke Tools mit praktischen Tests, einem Vergleich von kostenlosen und kostenpflichtigen Optionen sowie detaillierten Ranglisten, um Ihnen die beste Lösung zu zeigen, die die Schlafqualität verbessert und bessere Gewohnheiten zum Zubettgehen fördert. Entdecken Sie ihn jetzt auf XIX.AI, um Ihren Vorteil durch KI zu nutzen.
10 Tools
xix.ai

Die besten und am besten bewerteten KI-SQL-Copilots für Produkt- und Umsatzanalysen im Jahr 2026! XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung unverzichtbarer Tools zusammengestellt, die anhand wöchentlich aktualisierter Rankings in der Praxis getestet werden. Diese Tools helfen Anwendern dabei, ihre Produktivität erheblich zu steigern, indem sie die Datenanalyse beschleunigen, komplexe Abfragen optimieren und präzise Erkenntnisse liefern, um intelligentere Geschäftsentscheidungen zu ermöglichen. Entdecken Sie jetzt das perfekte Tool, um Ihren KI-Vorteil voll auszuschöpfen!
14 Tools
xix.ai

2026: Die aktuell besten und am besten bewerteten KI-Hausaufgabenhelfer, die nicht nur Antworten liefern, sondern auch Kernkonzepte vermitteln – leistungsstarke Tools für Schüler und Studenten. Eine kuratierte Liste, die Sie unbedingt ausprobieren sollten. Wöchentlich aktualisiert. Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten. Praxistests. Genaue Rankings, die Ihnen helfen, Ihr volles Lernpotenzial auszuschöpfen. Entdecken Sie jetzt das perfekte Tool für intelligenteres Lernen.
10 Tools
xix.ai












