


 Maison
L'exécution des modèles d'IA devient un défi en matière de mémoire
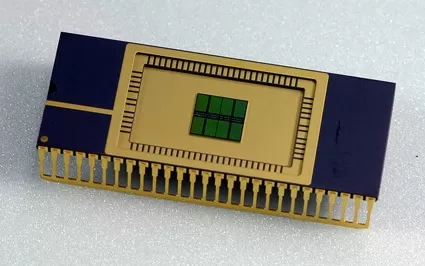
Les débats sur les coûts liés à l'infrastructure de l'IA tournent souvent autour de Nvidia et des GPU, mais la mémoire devient un élément essentiel du puzzle. Alors que les hyperscalers investissent des milliards dans de nouveaux centres de données, les prix des puces DRAM ont été multipliés par sept environ au cours de l'année écoulée.
Parallèlement, une discipline en plein essor se concentre sur l'orchestration de cette mémoire afin de garantir que les bonnes données parviennent au bon agent IA au bon moment. Les entreprises qui excellent dans ce domaine peuvent exécuter les mêmes requêtes en utilisant moins de tokens — une différence qui peut être déterminante pour leur survie sur un marché concurrentiel.
L'analyste en semi-conducteurs Dan O'Laughlin offre une perspective convaincante sur l'importance des puces mémoire dans son Substack, où il publie une conversation avec Val Bercovici, directeur de l'IA chez Weka. Les deux experts ont une formation en semi-conducteurs, leur discussion s'oriente donc vers le matériel, bien que les implications pour les logiciels d'IA soient tout aussi importantes.
Un passage retient particulièrement l’attention, dans lequel Bercovici commente la complexité croissante de la documentation d’Anthropic sur la mise en cache des prompts :
L'indice se trouve sur la page de tarification de la mise en cache des prompts d'Anthropic. Il y a six ou sept mois, notamment au moment du lancement de Claude Code, c'était une page simple qui disait en substance : « Utilisez la mise en cache, c'est moins cher. » Aujourd'hui, elle ressemble à une encyclopédie de conseils sur le nombre d'écritures en cache à préacheter. On y trouve les paliers courants du secteur, comme des fenêtres de 5 minutes et d’une heure, mais rien de plus long. C’est un détail révélateur. Ensuite, bien sûr, il existe diverses opportunités d’arbitrage autour de la tarification de la lecture du cache en fonction du nombre d’écritures en cache que vous avez achetées à l’avance.
La question centrale est de savoir combien de temps Claude conserve votre prompt en mémoire cache. Vous pouvez payer pour une fenêtre de 5 minutes ou une fenêtre d’une heure, plus coûteuse. L’accès aux données encore présentes dans le cache est bien moins cher, donc une gestion efficace peut permettre de réaliser des économies substantielles. Il y a toutefois un hic : chaque nouvelle donnée ajoutée à une requête risque de supplanter une autre donnée du cache.
Si les détails sont complexes, la conclusion est simple : la gestion de la mémoire au sein des modèles d'IA sera un facteur majeur pour l'avenir de l'IA. Les entreprises qui la maîtriseront bénéficieront d'un avantage concurrentiel significatif.
Il existe une marge de progression considérable dans ce domaine émergent. En octobre dernier, j'ai écrit un article sur une start-up appelée TensorMesh, qui travaille sur une couche de la pile connue sous le nom d'optimisation du cache.
Événement TechCrunchTechCrunch Founder Summit 2026 : billets en vente
Le 23 juin à Boston, plus de 1 100 fondateurs se réuniront au TechCrunch Founder Summit 2026 pour une journée entière consacrée à la croissance, à l'exécution et à la mise à l'échelle dans le monde réel. Apprenez auprès de fondateurs et d'investisseurs qui ont façonné le secteur. Rencontrez des pairs qui traversent des phases de croissance similaires. Repartez avec des stratégies que vous pourrez appliquer immédiatement
Économisez jusqu'à 300 $ sur votre pass ou jusqu'à 30 % avec des billets de groupe pour les équipes de quatre personnes ou plus.
TechCrunch Founder Summit : billets en vente
Le 23 juin à Boston, plus de 1 100 fondateurs se réuniront au TechCrunch Founder Summit 2026 pour une journée entière consacrée à la croissance, à la mise en œuvre et à la mise à l'échelle dans le monde réel. Apprenez auprès de fondateurs et d'investisseurs qui ont façonné le secteur. Rencontrez des pairs qui traversent des phases de croissance similaires. Repartez avec des stratégies que vous pourrez mettre en œuvre immédiatement
Économisez jusqu'à 300 $ sur votre pass ou jusqu'à 30 % avec des billets de groupe pour les équipes de quatre personnes ou plus.
Boston, MA | 23 juin 2026 INSCRIVEZ-VOUS MAINTENANTDes opportunités existent également ailleurs dans la pile. Plus bas, par exemple, se pose la question de savoir comment les centres de données utilisent leurs différents types de mémoire. (L'interview comprend une discussion éclairante sur le moment où utiliser des puces DRAM plutôt que HBM, bien que cela devienne assez technique.) Plus haut dans la pile, les utilisateurs finaux apprennent à structurer leurs essaims de modèles pour exploiter efficacement les caches partagés.
À mesure que les entreprises s'améliorent en matière d'orchestration de la mémoire, elles consommeront moins de tokens, ce qui rendra l'inférence moins coûteuse. Parallèlement, les modèles deviennent plus efficaces dans le traitement de chaque token, ce qui réduit encore davantage les coûts. À mesure que les dépenses liées aux serveurs diminueront, de nombreuses applications actuellement jugées non viables commenceront à se rapprocher de la rentabilité.
Article connexe
 La plateforme d'échange de cryptomonnaies OKX souhaite permettre à des agents IA de s'embaucher et de se rémunérer mutuellement
À mesure que les agents IA commencent à offrir leurs services aux particuliers et à collaborer entre eux, ils ont besoin de mécanismes permettant de trouver des tâches, de se faire rémunérer pour leur
Une start-up soutenue par Thiel affirme que l'IA est capable d'évaluer le journalisme, malgré les risques pour les lanceurs d'alerte
À la suite de son implication dans le procès qui a conduit à la faillite de Gawker, Aron D’Souza a mis en évidence une faille majeure dans le paysage médiatique américain : les personnes lésées par la
Prentis, nouveau laboratoire d’IA cofondé par Reid Hoffman et Marc Pincus, en pourparlers pour lever 100 millions de dollars
Prentis, un laboratoire de recherche en IA émergent spécialisé dans les modèles d’utilisation des ordinateurs, est cofondé par l’entrepreneur à succès Ritankar Das, aux côtés de leaders de l’industrie technologique Reid Hoffman et Marc Pincus. Selon
Recommandations de sujets spéciaux liés
Conception et art
 Les meilleurs outils de transfert de style basés sur l'IA pour des expériences créatives
Les meilleurs outils de transfert de style par IA de 2026, les mieux notés, pour des expériences créatives ! XIX.AI a sélectionné une collection d’outils puissants et révolutionnaires à essayer absolument, qui offrent des résultats exceptionnels grâce à des tests en conditions réelles et à un classement rigoureux. Ces solutions de pointe aident les créatifs à booster considérablement leur productivité en accélérant la création de contenu et en ouvrant la voie à des possibilités créatives infinies. Découvrez-les dès maintenant pour trouver l'outil qui vous convient le mieux et commencez à créer dès aujourd'hui !
 9 outils
 xix.ai
Création de bande dessinée
Les meilleurs outils d'IA pour créer des bulles de dialogue destinés à la narration visuelle
Les meilleurs outils de 2026 pour la création de bulles de dialogue IA, les mieux notés pour la narration visuelle, sont disponibles ici sur XIX.AI ! Cette sélection regroupe des outils puissants et révolutionnaires qui aident les créateurs à booster leur productivité et à surmonter les blocages créatifs. Consultez un comparatif entre les versions gratuites et payantes, découvrez des tests en conditions réelles et consultez les derniers classements pour trouver les solutions incontournables, parfaites pour créer des récits visuels captivants. Explorez dès maintenant pour découvrir l'outil qui vous convient le mieux !
10 outils
xix.ai
Assistante de réunion
Les meilleurs outils de synthèse de réunions basés sur l'IA : suivez clairement les décisions et les actions à mener
2026 : les meilleurs outils d'IA pour la synthèse de réunions, les mieux notés, pour un suivi clair des décisions et des relances sans effort. Cette sélection présente des solutions puissantes et révolutionnaires qui boostent considérablement la productivité en automatisant la prise de notes lors des réunions, en identifiant les actions clés et en rationalisant la coordination des équipes sur l'ensemble des projets. Profitez d'une comparaison entre les versions gratuites et payantes, ainsi que de tests en conditions réelles et de classements mis à jour chaque semaine pour vous aider à trouver l'outil idéal. Découvrez-les dès maintenant pour tirer pleinement parti de l'IA !
9 outils
xix.ai
Analyse des données
Meilleurs outils de nettoyage de données IA : corrigez rapidement les valeurs manquantes et les doublons
2026 : Les meilleures outils de nettoyage de données IA les plus récents et hautement notés pour corriger rapidement les valeurs manquantes et les doublons. Cette liste rigoureusement sélectionnée met en avant des solutions puissantes capables d’améliorer considérablement la productivité. Chaque outil a été soumis à des tests approfondis dans des conditions réelles afin de garantir sa fiabilité. Obtenez une comparaison gratuite et payante pour découvrir l’outil qu’il vous faut le mieux, adapté à vos besoins. Explorez dès maintenant XIX.AI pour tirer parti au maximum des capacités de l’IA.
11 outils
xix.ai
Conception et art
Meilleurs outils d’idéation créative par IA pour les artistes : surmonter les blocages visuels
2026 Derniers Meilleurs Outils d’Idéation Créative par IA les Mieux Notés pour les Artistes sont sélectionnés par XIX.AI pour aider les créateurs à surmonner les blocages visuels et stimuler instantanément leur créativité. Ces outils puissants et révolutionnaires offrent des tests concrets, une comparaison détaillée entre les versions gratuites et payantes, ainsi que des classements mis à jour chaque semaine. Découvrez l’outil parfait pour accélérer la création de contenu et débloquer votre avantage IA dès aujourd’hui. Explorez maintenant !
14 outils
xix.ai
Composition musicale
Créateurs de musique par IA pour les pistes d'accompagnement TikTok, les fichiers audio Reels et la musique promotionnelle des créateurs
Les meilleurs générateurs de rythmes IA de 2026 pour les musiques de fond TikTok, les Reels et les morceaux promotionnels des créateurs ! XIX.AI a sélectionné une liste des outils les mieux notés, véritables révolutionnaires qui ont fait leurs preuves dans la pratique pour offrir une musique irréprochable, quel que soit votre besoin en matière de contenu. Vous y trouverez des comparaisons détaillées entre les versions gratuites et payantes, des classements mis à jour chaque semaine, ainsi que des options incontournables pour vous aider à stimuler votre créativité et votre productivité. Explorez-la dès maintenant pour découvrir l'outil qui vous convient le mieux !
11 outils
xix.ai

 commentaires (1)
![NicholasNelson]()
這篇文章點出了AI發展中常被忽略的記憶體瓶頸,挺有意思的。大家都在搶GPU,但DRAM價格一年漲七倍也太誇張了吧!這會不會讓小公司更難玩得起AI啊?🤔
Les débats sur les coûts liés à l'infrastructure de l'IA tournent souvent autour de Nvidia et des GPU, mais la mémoire devient un élément essentiel du puzzle. Alors que les hyperscalers investissent des milliards dans de nouveaux centres de données, les prix des puces DRAM ont été multipliés par sept environ au cours de l'année écoulée.
Parallèlement, une discipline en plein essor se concentre sur l'orchestration de cette mémoire afin de garantir que les bonnes données parviennent au bon agent IA au bon moment. Les entreprises qui excellent dans ce domaine peuvent exécuter les mêmes requêtes en utilisant moins de tokens — une différence qui peut être déterminante pour leur survie sur un marché concurrentiel.
L'analyste en semi-conducteurs Dan O'Laughlin offre une perspective convaincante sur l'importance des puces mémoire dans son Substack, où il publie une conversation avec Val Bercovici, directeur de l'IA chez Weka. Les deux experts ont une formation en semi-conducteurs, leur discussion s'oriente donc vers le matériel, bien que les implications pour les logiciels d'IA soient tout aussi importantes.
Un passage retient particulièrement l’attention, dans lequel Bercovici commente la complexité croissante de la documentation d’Anthropic sur la mise en cache des prompts :
L'indice se trouve sur la page de tarification de la mise en cache des prompts d'Anthropic. Il y a six ou sept mois, notamment au moment du lancement de Claude Code, c'était une page simple qui disait en substance : « Utilisez la mise en cache, c'est moins cher. » Aujourd'hui, elle ressemble à une encyclopédie de conseils sur le nombre d'écritures en cache à préacheter. On y trouve les paliers courants du secteur, comme des fenêtres de 5 minutes et d’une heure, mais rien de plus long. C’est un détail révélateur. Ensuite, bien sûr, il existe diverses opportunités d’arbitrage autour de la tarification de la lecture du cache en fonction du nombre d’écritures en cache que vous avez achetées à l’avance.
La question centrale est de savoir combien de temps Claude conserve votre prompt en mémoire cache. Vous pouvez payer pour une fenêtre de 5 minutes ou une fenêtre d’une heure, plus coûteuse. L’accès aux données encore présentes dans le cache est bien moins cher, donc une gestion efficace peut permettre de réaliser des économies substantielles. Il y a toutefois un hic : chaque nouvelle donnée ajoutée à une requête risque de supplanter une autre donnée du cache.
Si les détails sont complexes, la conclusion est simple : la gestion de la mémoire au sein des modèles d'IA sera un facteur majeur pour l'avenir de l'IA. Les entreprises qui la maîtriseront bénéficieront d'un avantage concurrentiel significatif.
Il existe une marge de progression considérable dans ce domaine émergent. En octobre dernier, j'ai écrit un article sur une start-up appelée TensorMesh, qui travaille sur une couche de la pile connue sous le nom d'optimisation du cache.
Événement TechCrunchTechCrunch Founder Summit 2026 : billets en vente
Le 23 juin à Boston, plus de 1 100 fondateurs se réuniront au TechCrunch Founder Summit 2026 pour une journée entière consacrée à la croissance, à l'exécution et à la mise à l'échelle dans le monde réel. Apprenez auprès de fondateurs et d'investisseurs qui ont façonné le secteur. Rencontrez des pairs qui traversent des phases de croissance similaires. Repartez avec des stratégies que vous pourrez appliquer immédiatement
Économisez jusqu'à 300 $ sur votre pass ou jusqu'à 30 % avec des billets de groupe pour les équipes de quatre personnes ou plus.
TechCrunch Founder Summit : billets en vente
Le 23 juin à Boston, plus de 1 100 fondateurs se réuniront au TechCrunch Founder Summit 2026 pour une journée entière consacrée à la croissance, à la mise en œuvre et à la mise à l'échelle dans le monde réel. Apprenez auprès de fondateurs et d'investisseurs qui ont façonné le secteur. Rencontrez des pairs qui traversent des phases de croissance similaires. Repartez avec des stratégies que vous pourrez mettre en œuvre immédiatement
Économisez jusqu'à 300 $ sur votre pass ou jusqu'à 30 % avec des billets de groupe pour les équipes de quatre personnes ou plus.
Boston, MA | 23 juin 2026 INSCRIVEZ-VOUS MAINTENANTDes opportunités existent également ailleurs dans la pile. Plus bas, par exemple, se pose la question de savoir comment les centres de données utilisent leurs différents types de mémoire. (L'interview comprend une discussion éclairante sur le moment où utiliser des puces DRAM plutôt que HBM, bien que cela devienne assez technique.) Plus haut dans la pile, les utilisateurs finaux apprennent à structurer leurs essaims de modèles pour exploiter efficacement les caches partagés.
À mesure que les entreprises s'améliorent en matière d'orchestration de la mémoire, elles consommeront moins de tokens, ce qui rendra l'inférence moins coûteuse. Parallèlement, les modèles deviennent plus efficaces dans le traitement de chaque token, ce qui réduit encore davantage les coûts. À mesure que les dépenses liées aux serveurs diminueront, de nombreuses applications actuellement jugées non viables commenceront à se rapprocher de la rentabilité.








 La plateforme d'échange de cryptomonnaies OKX souhaite permettre à des agents IA de s'embaucher et de se rémunérer mutuellement
À mesure que les agents IA commencent à offrir leurs services aux particuliers et à collaborer entre eux, ils ont besoin de mécanismes permettant de trouver des tâches, de se faire rémunérer pour leur
 Une start-up soutenue par Thiel affirme que l'IA est capable d'évaluer le journalisme, malgré les risques pour les lanceurs d'alerte
À la suite de son implication dans le procès qui a conduit à la faillite de Gawker, Aron D’Souza a mis en évidence une faille majeure dans le paysage médiatique américain : les personnes lésées par la
 Prentis, nouveau laboratoire d’IA cofondé par Reid Hoffman et Marc Pincus, en pourparlers pour lever 100 millions de dollars
Prentis, un laboratoire de recherche en IA émergent spécialisé dans les modèles d’utilisation des ordinateurs, est cofondé par l’entrepreneur à succès Ritankar Das, aux côtés de leaders de l’industrie technologique Reid Hoffman et Marc Pincus. Selon

Les meilleurs outils de transfert de style par IA de 2026, les mieux notés, pour des expériences créatives ! XIX.AI a sélectionné une collection d’outils puissants et révolutionnaires à essayer absolument, qui offrent des résultats exceptionnels grâce à des tests en conditions réelles et à un classement rigoureux. Ces solutions de pointe aident les créatifs à booster considérablement leur productivité en accélérant la création de contenu et en ouvrant la voie à des possibilités créatives infinies. Découvrez-les dès maintenant pour trouver l'outil qui vous convient le mieux et commencez à créer dès aujourd'hui !
9 outils
xix.ai

Les meilleurs outils de 2026 pour la création de bulles de dialogue IA, les mieux notés pour la narration visuelle, sont disponibles ici sur XIX.AI ! Cette sélection regroupe des outils puissants et révolutionnaires qui aident les créateurs à booster leur productivité et à surmonter les blocages créatifs. Consultez un comparatif entre les versions gratuites et payantes, découvrez des tests en conditions réelles et consultez les derniers classements pour trouver les solutions incontournables, parfaites pour créer des récits visuels captivants. Explorez dès maintenant pour découvrir l'outil qui vous convient le mieux !
10 outils
xix.ai

2026 : les meilleurs outils d'IA pour la synthèse de réunions, les mieux notés, pour un suivi clair des décisions et des relances sans effort. Cette sélection présente des solutions puissantes et révolutionnaires qui boostent considérablement la productivité en automatisant la prise de notes lors des réunions, en identifiant les actions clés et en rationalisant la coordination des équipes sur l'ensemble des projets. Profitez d'une comparaison entre les versions gratuites et payantes, ainsi que de tests en conditions réelles et de classements mis à jour chaque semaine pour vous aider à trouver l'outil idéal. Découvrez-les dès maintenant pour tirer pleinement parti de l'IA !
9 outils
xix.ai

2026 : Les meilleures outils de nettoyage de données IA les plus récents et hautement notés pour corriger rapidement les valeurs manquantes et les doublons. Cette liste rigoureusement sélectionnée met en avant des solutions puissantes capables d’améliorer considérablement la productivité. Chaque outil a été soumis à des tests approfondis dans des conditions réelles afin de garantir sa fiabilité. Obtenez une comparaison gratuite et payante pour découvrir l’outil qu’il vous faut le mieux, adapté à vos besoins. Explorez dès maintenant XIX.AI pour tirer parti au maximum des capacités de l’IA.
11 outils
xix.ai

2026 Derniers Meilleurs Outils d’Idéation Créative par IA les Mieux Notés pour les Artistes sont sélectionnés par XIX.AI pour aider les créateurs à surmonner les blocages visuels et stimuler instantanément leur créativité. Ces outils puissants et révolutionnaires offrent des tests concrets, une comparaison détaillée entre les versions gratuites et payantes, ainsi que des classements mis à jour chaque semaine. Découvrez l’outil parfait pour accélérer la création de contenu et débloquer votre avantage IA dès aujourd’hui. Explorez maintenant !
14 outils
xix.ai

Les meilleurs générateurs de rythmes IA de 2026 pour les musiques de fond TikTok, les Reels et les morceaux promotionnels des créateurs ! XIX.AI a sélectionné une liste des outils les mieux notés, véritables révolutionnaires qui ont fait leurs preuves dans la pratique pour offrir une musique irréprochable, quel que soit votre besoin en matière de contenu. Vous y trouverez des comparaisons détaillées entre les versions gratuites et payantes, des classements mis à jour chaque semaine, ainsi que des options incontournables pour vous aider à stimuler votre créativité et votre productivité. Explorez-la dès maintenant pour découvrir l'outil qui vous convient le mieux !
11 outils
xix.ai

這篇文章點出了AI發展中常被忽略的記憶體瓶頸,挺有意思的。大家都在搶GPU,但DRAM價格一年漲七倍也太誇張了吧!這會不會讓小公司更難玩得起AI啊?🤔












