


 Maison
Ant Group lance LingBot-Depth 2.0, un modèle de perception spatiale qui fait progresser la vision robotique.
Le 7 juillet, Lingbo Technology, une société spécialisée dans l’intelligence incarnée appartenant au groupe Ant, a lancé le modèle de perception spatiale LingBot-Depth 2.0. Entraîné sur un ensemble de données de 150 millions d’échantillons, il apporte des améliorations significatives en matière de netteté des contours, de reconnaissance d’objets fins, d’estimation de la profondeur à longue portée et de robustesse dans des scénarios complexes.
LingBot-Depth est un modèle de perception spatiale développé en interne par Lingbo, qui sert d’« yeux » aux robots dans le monde physique. La première version répondait aux défis de perception spatiale dans des scénarios difficiles, tels que les surfaces transparentes et réfléchissantes. Par rapport à la version 1.0, l’ensemble de données d’entraînement de LingBot-Depth 2.0 est passé de 3 millions à 150 millions d’échantillons, ce qui s’est traduit par des gains de performances globaux : il a décroché 12 premières places sur 16 critères d’évaluation dans les tests de référence de complétion de profondeur. Dans le scénario intérieur le plus difficile, caractérisé par des lacunes de profondeur à grande échelle, l’erreur de profondeur a été réduite de moitié par rapport à la génération précédente (le RMSE est passé de 0,132 à 0,062). Il affiche des performances particulièrement bonnes dans des situations où les caméras de profondeur traditionnelles échouent souvent, comme face au verre, aux miroirs et aux objets transparents.
Parallèlement, LingBot-Depth 2.0 a introduit son modèle de base visuel, LingBot-Vision, établissant ainsi une chaîne de capacités allant de la « compréhension » à la « perception précise ». L’objectif est de relever les principaux défis de la vision robotique, notamment la perception spatiale, la reconnaissance fine et l’adaptation à des environnements complexes.
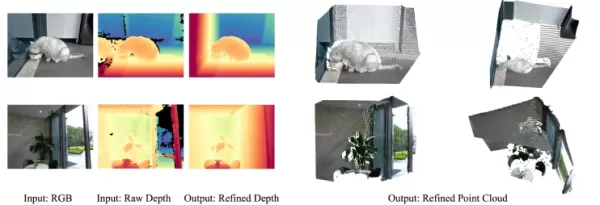
(Figure 1 : LingBot-Depth 2.0 reconstitue une structure 3D complète et plane dans des scénarios difficiles tels que les miroirs et le verre)
La percée de LingBot-Depth 2.0 repose sur les capacités exceptionnelles de représentation visuelle de LingBot-Vision. En tant que modèle visuel polyvalent, LingBot-Vision est le premier modèle de base visuel du secteur à utiliser la « structure des contours » comme objectif de pré-entraînement, réalisant ainsi une avancée majeure dans le paradigme d’entraînement à la perception spatiale. Il offre un positionnement des contours au niveau sous-pixel et une compréhension de la structure spatiale, garantissant une perception spatiale plus précise et plus stable.
Le corpus de pré-entraînement de LingBot-Vision ne comprend que 160 millions d’images, soit un ordre de grandeur inférieur à celui de DINOv3, mais sa précision d’estimation de la profondeur surpasse celle de DINOv3. De plus, l’évaluation des limites des objets par LingBot-Vision est suffisamment stable pour permettre un suivi continu des limites dans les vidéos. Cette version comprend quatre variantes : ViT-G, ViT-L, ViT-B et ViT-S.
D’après les informations disponibles, LingBot-Vision prend non seulement en charge l’entraînement de LingBot-Depth 2.0, mais peut également être utilisé de multiples autres façons.
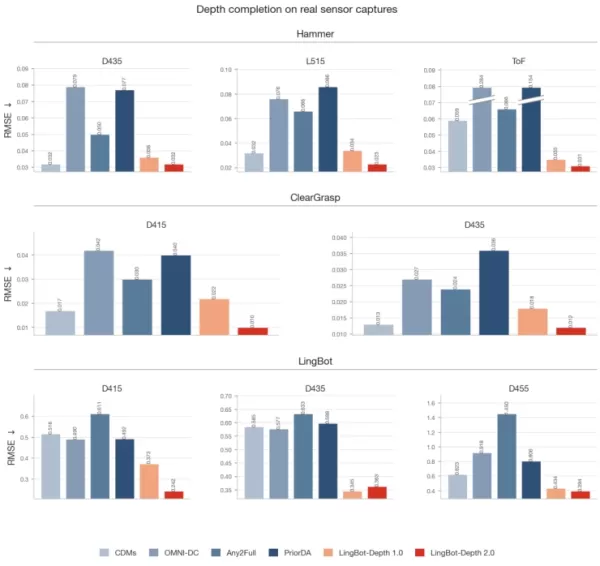
(Figure 2 : LingBot-Depth 2.0 affiche de bonnes performances lors de tests de complétion de profondeur à partir de capteurs réels)
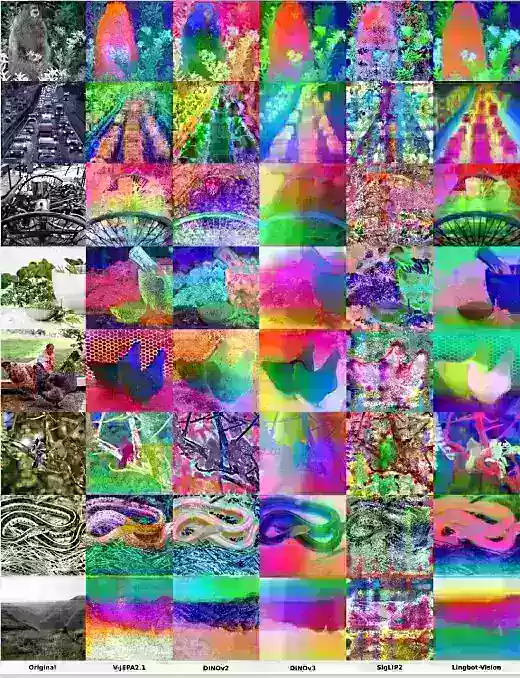
(Figure 3 : par rapport aux modèles de base visuels courants, LingBot-Vision identifie les contours des objets et les structures spatiales de manière plus claire et plus stable)
À l’heure actuelle, LingBot-Depth 2.0 a obtenu la certification professionnelle de l’Orbbec Depth Vision Lab. Des tests en conditions réelles montrent que, grâce aux données brutes 3D au niveau de la puce fournies par la caméra 3D stéréoscopique de la série Gemini330 d’Orbbec, LingBot-Depth 2.0 améliore considérablement la netteté des contours, l’intégrité des contours des objets, la reconnaissance des objets fins, l’estimation de la profondeur à longue portée, ainsi que la robustesse dans des conditions d’éclairage et de matériaux complexes.
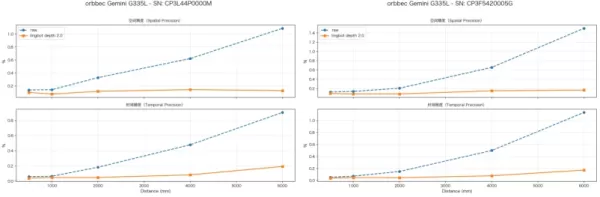
(Figure 4 : LingBot Depth 2.0 a passé avec succès l’évaluation professionnelle de l’Orbbec Depth Vision Lab, démontrant une précision et une stabilité extrêmement élevées dans les tâches d’estimation de la profondeur spatiale et temporelle sur plusieurs types de capteurs)
En matière de commercialisation, Ant Lingbo a engagé une coopération approfondie avec Orbbec dans de nombreux domaines. Selon les informations disponibles, la dernière version RVB-D de l’appareil EGO, issue de la nouvelle gamme de produits d’acquisition de données « no-body » d’Orbbec, sera adaptée à la version LingBot-Depth optimisée par Lingbo pour les scénarios d’acquisition de données. À l’avenir, elle intégrera davantage de versions commerciales de niveau supérieur, comblera en continu les lacunes en matière de profondeur, optimisera les contours des objets et les détails de la structure spatiale, et fournira des bases de données du monde réel plus précises, plus stables et plus exploitables pour l’entraînement des modèles d’intelligence incarnée.
De plus, Orbbec lancera un kit de développement logiciel (SDK) intégrant les dernières capacités du modèle LingBot-Depth, accessible aux clients du secteur de la robotique en périphérie, ce qui permettra aux robots équipés de caméras de la série Gemini330 d’obtenir de meilleurs effets de profondeur. L’entreprise prévoit également de lancer d’ici la fin de l’année une caméra intégrant la version commerciale de LingBot-Depth, concrétisant ainsi l’association « caméra 3D + capacités de perception spatiale ». Avec la sortie de ces deux modèles, leur collaboration devrait s’étendre à davantage de domaines.
Article connexe
 PDG de DeepMind, Hassabis : Je dors six heures par jour et je me sens généralement plein d’énergie vers 1 h du matin.
Fortune a récemment publié une interview avec Demis Hassabis, PDG de Google DeepMind, révélant son approche non conventionnelle du repos et de la productivité. Hassabis a divulgué qu’il dort très peu, structurant ses heures d’éveil en deux blocs de t
OpenAI et Anthropic se disputent des parts de marché malgré des résultats en deçà des attentes
Bien que des informations récentes laissent entendre qu’OpenAI n’aurait pas atteint ses objectifs de chiffre d’affaires, ce qui a pesé sur les valeurs technologiques ce mardi, les investisseurs privés
Conformité des véhicules autonomes en Californie : une nouvelle ère marquée par les amendes, les zones de géolocalisation et 1 million de miles
Guident exploite une navette AuveTech dans le sud de la Floride, gérant un parcours de quatre miles à West Palm Beach et un parcours d’un mile à Boca Raton grâce à sa technologie de surveillance à dis
Recommandations de sujets spéciaux liés
chatbot
 Meilleures applications de chat de jeu de rôle par IA pour la pratique des langues, la préparation aux entretiens et la fluidité quotidienne
2026 Dernières Meilleures Applications de Chat IA pour le Jeu de Rôle, les plus bien notées pour la Pratique des Langues, la Préparation aux Entretiens et la Fluidité Quotidienne ! XIX.AI sélectionne une collection puissante et révolutionnaire qui propose une comparaison gratuit vs payant, des tests en conditions réelles et des classements mis à jour chaque semaine. Ces outils à essayer absolument vous aident à améliorer vos compétences en écriture, à surmonter les défis de fluidité et à optimiser l’efficacité de la communication dans tous les scénarios quotidiens. Explorez dès maintenant pour découvrir l’outil parfait pour votre progression linguistique !
 10 outils
 xix.ai
Composition musicale
Outils de séparation des pistes audio par IA pour la production de remix, la préparation de samples et les masters de karaoké
2026 : Les meilleures et plus récentes outils de séparation des pistes audio par IA, hautement notés, sélectionnés spécialement pour la production de remix, la préparation de samples et l’enregistrement de karaokés. Ces outils puissants et révolutionnaires, éprouvés dans des conditions réelles, permettent une isolation audio précise, ce qui améliore considérablement la productivité. XIX.AI propose un guide de comparaison gratuit mis à jour chaque semaine entre les versions payantes et gratuites, afin de vous aider à trouver la solution idéale adaptée à vos besoins. Découvrez-les dès maintenant pour tirer parti des avantages offerts par l’IA.
8 outils
xix.ai
Analyse des données
Copilotes SQL basés sur l’IA pour les tableaux de bord de chiffre d’affaires, l’analyse des funnels et les indicateurs de produits
2026 : Les meilleurs copilotes AI SQL actuels, classés parmi les plus performants ! XIX.AI a sélectionné une collection puissante et révolutionnaire, mise à jour chaque semaine grâce à des tests concrets. Ces outils indispensables vous aident à créer des tableaux de bord financiers précis, à analyser les canaux de vente et à suivre en temps réel les indicateurs produits, ce qui améliore considérablement votre productivité. Découvrez-les dès maintenant pour trouver l’outil idéal pour des décisions basées sur les données ! 238 caractères
9 outils
xix.ai
Composition musicale
Meilleurs outils d’écriture de mélodies par IA pour les ébauches de chansons
2026 Derniers Meilleurs Outils d’Écriture de Mélodie par IA les Mieux Notés pour des Ébauches de Chansons ! XIX.AI a sélectionné une collection hautement puissante et révolutionnaire, soumise à des tests rigoureux en conditions réelles, afin d’offrir la meilleure expérience d’écriture. Vous pouvez y trouver des comparaisons détaillées entre versions gratuites et payantes, des classements précis, ainsi que des options incontournables conçues pour vous aider à créer sans effort des ébauches de chansons remarquables et à booster significativement votre productivité créative. Explorez dès maintenant pour découvrir l’outil qui vous correspond parfaitement !
8 outils
xix.ai
chatbot
Meilleurs outils d’entraînement à la conversation par IA pour la préparation aux entretiens
Les derniers outils de formation à la conversation par IA les mieux notés pour 2026 sont disponibles sur XIX.AI ! Cette sélection rigoureuse propose des outils puissants et révolutionnaires, testés rigoureusement dans des conditions réelles pour fournir des retours précis. Vous y trouverez une comparaison entre les versions gratuites et payantes, ainsi que des classements détaillés pour vous aider à choisir l’option incontournable qui renforce votre confiance et vos compétences. Explorez dès maintenant pour découvrir l’outil parfait pour réussir vos entretiens !
12 outils
xix.ai
Conception et art
Les meilleurs outils de transfert de style basés sur l'IA pour des expériences créatives
Les meilleurs outils de transfert de style par IA de 2026, les mieux notés, pour des expériences créatives ! XIX.AI a sélectionné une collection d’outils puissants et révolutionnaires à essayer absolument, qui offrent des résultats exceptionnels grâce à des tests en conditions réelles et à un classement rigoureux. Ces solutions de pointe aident les créatifs à booster considérablement leur productivité en accélérant la création de contenu et en ouvrant la voie à des possibilités créatives infinies. Découvrez-les dès maintenant pour trouver l'outil qui vous convient le mieux et commencez à créer dès aujourd'hui !
9 outils
xix.ai

 commentaires (0)
Le 7 juillet, Lingbo Technology, une société spécialisée dans l’intelligence incarnée appartenant au groupe Ant, a lancé le modèle de perception spatiale LingBot-Depth 2.0. Entraîné sur un ensemble de données de 150 millions d’échantillons, il apporte des améliorations significatives en matière de netteté des contours, de reconnaissance d’objets fins, d’estimation de la profondeur à longue portée et de robustesse dans des scénarios complexes.
LingBot-Depth est un modèle de perception spatiale développé en interne par Lingbo, qui sert d’« yeux » aux robots dans le monde physique. La première version répondait aux défis de perception spatiale dans des scénarios difficiles, tels que les surfaces transparentes et réfléchissantes. Par rapport à la version 1.0, l’ensemble de données d’entraînement de LingBot-Depth 2.0 est passé de 3 millions à 150 millions d’échantillons, ce qui s’est traduit par des gains de performances globaux : il a décroché 12 premières places sur 16 critères d’évaluation dans les tests de référence de complétion de profondeur. Dans le scénario intérieur le plus difficile, caractérisé par des lacunes de profondeur à grande échelle, l’erreur de profondeur a été réduite de moitié par rapport à la génération précédente (le RMSE est passé de 0,132 à 0,062). Il affiche des performances particulièrement bonnes dans des situations où les caméras de profondeur traditionnelles échouent souvent, comme face au verre, aux miroirs et aux objets transparents.
Parallèlement, LingBot-Depth 2.0 a introduit son modèle de base visuel, LingBot-Vision, établissant ainsi une chaîne de capacités allant de la « compréhension » à la « perception précise ». L’objectif est de relever les principaux défis de la vision robotique, notamment la perception spatiale, la reconnaissance fine et l’adaptation à des environnements complexes.
(Figure 1 : LingBot-Depth 2.0 reconstitue une structure 3D complète et plane dans des scénarios difficiles tels que les miroirs et le verre)
La percée de LingBot-Depth 2.0 repose sur les capacités exceptionnelles de représentation visuelle de LingBot-Vision. En tant que modèle visuel polyvalent, LingBot-Vision est le premier modèle de base visuel du secteur à utiliser la « structure des contours » comme objectif de pré-entraînement, réalisant ainsi une avancée majeure dans le paradigme d’entraînement à la perception spatiale. Il offre un positionnement des contours au niveau sous-pixel et une compréhension de la structure spatiale, garantissant une perception spatiale plus précise et plus stable.
Le corpus de pré-entraînement de LingBot-Vision ne comprend que 160 millions d’images, soit un ordre de grandeur inférieur à celui de DINOv3, mais sa précision d’estimation de la profondeur surpasse celle de DINOv3. De plus, l’évaluation des limites des objets par LingBot-Vision est suffisamment stable pour permettre un suivi continu des limites dans les vidéos. Cette version comprend quatre variantes : ViT-G, ViT-L, ViT-B et ViT-S.
D’après les informations disponibles, LingBot-Vision prend non seulement en charge l’entraînement de LingBot-Depth 2.0, mais peut également être utilisé de multiples autres façons.
(Figure 2 : LingBot-Depth 2.0 affiche de bonnes performances lors de tests de complétion de profondeur à partir de capteurs réels)
(Figure 3 : par rapport aux modèles de base visuels courants, LingBot-Vision identifie les contours des objets et les structures spatiales de manière plus claire et plus stable)
À l’heure actuelle, LingBot-Depth 2.0 a obtenu la certification professionnelle de l’Orbbec Depth Vision Lab. Des tests en conditions réelles montrent que, grâce aux données brutes 3D au niveau de la puce fournies par la caméra 3D stéréoscopique de la série Gemini330 d’Orbbec, LingBot-Depth 2.0 améliore considérablement la netteté des contours, l’intégrité des contours des objets, la reconnaissance des objets fins, l’estimation de la profondeur à longue portée, ainsi que la robustesse dans des conditions d’éclairage et de matériaux complexes.
(Figure 4 : LingBot Depth 2.0 a passé avec succès l’évaluation professionnelle de l’Orbbec Depth Vision Lab, démontrant une précision et une stabilité extrêmement élevées dans les tâches d’estimation de la profondeur spatiale et temporelle sur plusieurs types de capteurs)
En matière de commercialisation, Ant Lingbo a engagé une coopération approfondie avec Orbbec dans de nombreux domaines. Selon les informations disponibles, la dernière version RVB-D de l’appareil EGO, issue de la nouvelle gamme de produits d’acquisition de données « no-body » d’Orbbec, sera adaptée à la version LingBot-Depth optimisée par Lingbo pour les scénarios d’acquisition de données. À l’avenir, elle intégrera davantage de versions commerciales de niveau supérieur, comblera en continu les lacunes en matière de profondeur, optimisera les contours des objets et les détails de la structure spatiale, et fournira des bases de données du monde réel plus précises, plus stables et plus exploitables pour l’entraînement des modèles d’intelligence incarnée.
De plus, Orbbec lancera un kit de développement logiciel (SDK) intégrant les dernières capacités du modèle LingBot-Depth, accessible aux clients du secteur de la robotique en périphérie, ce qui permettra aux robots équipés de caméras de la série Gemini330 d’obtenir de meilleurs effets de profondeur. L’entreprise prévoit également de lancer d’ici la fin de l’année une caméra intégrant la version commerciale de LingBot-Depth, concrétisant ainsi l’association « caméra 3D + capacités de perception spatiale ». Avec la sortie de ces deux modèles, leur collaboration devrait s’étendre à davantage de domaines.








 PDG de DeepMind, Hassabis : Je dors six heures par jour et je me sens généralement plein d’énergie vers 1 h du matin.
Fortune a récemment publié une interview avec Demis Hassabis, PDG de Google DeepMind, révélant son approche non conventionnelle du repos et de la productivité. Hassabis a divulgué qu’il dort très peu, structurant ses heures d’éveil en deux blocs de t
 OpenAI et Anthropic se disputent des parts de marché malgré des résultats en deçà des attentes
Bien que des informations récentes laissent entendre qu’OpenAI n’aurait pas atteint ses objectifs de chiffre d’affaires, ce qui a pesé sur les valeurs technologiques ce mardi, les investisseurs privés
Conformité des véhicules autonomes en Californie : une nouvelle ère marquée par les amendes, les zones de géolocalisation et 1 million de miles
Guident exploite une navette AuveTech dans le sud de la Floride, gérant un parcours de quatre miles à West Palm Beach et un parcours d’un mile à Boca Raton grâce à sa technologie de surveillance à dis

2026 Dernières Meilleures Applications de Chat IA pour le Jeu de Rôle, les plus bien notées pour la Pratique des Langues, la Préparation aux Entretiens et la Fluidité Quotidienne ! XIX.AI sélectionne une collection puissante et révolutionnaire qui propose une comparaison gratuit vs payant, des tests en conditions réelles et des classements mis à jour chaque semaine. Ces outils à essayer absolument vous aident à améliorer vos compétences en écriture, à surmonter les défis de fluidité et à optimiser l’efficacité de la communication dans tous les scénarios quotidiens. Explorez dès maintenant pour découvrir l’outil parfait pour votre progression linguistique !
10 outils
xix.ai

2026 : Les meilleures et plus récentes outils de séparation des pistes audio par IA, hautement notés, sélectionnés spécialement pour la production de remix, la préparation de samples et l’enregistrement de karaokés. Ces outils puissants et révolutionnaires, éprouvés dans des conditions réelles, permettent une isolation audio précise, ce qui améliore considérablement la productivité. XIX.AI propose un guide de comparaison gratuit mis à jour chaque semaine entre les versions payantes et gratuites, afin de vous aider à trouver la solution idéale adaptée à vos besoins. Découvrez-les dès maintenant pour tirer parti des avantages offerts par l’IA.
8 outils
xix.ai

2026 : Les meilleurs copilotes AI SQL actuels, classés parmi les plus performants ! XIX.AI a sélectionné une collection puissante et révolutionnaire, mise à jour chaque semaine grâce à des tests concrets. Ces outils indispensables vous aident à créer des tableaux de bord financiers précis, à analyser les canaux de vente et à suivre en temps réel les indicateurs produits, ce qui améliore considérablement votre productivité. Découvrez-les dès maintenant pour trouver l’outil idéal pour des décisions basées sur les données ! 238 caractères
9 outils
xix.ai

2026 Derniers Meilleurs Outils d’Écriture de Mélodie par IA les Mieux Notés pour des Ébauches de Chansons ! XIX.AI a sélectionné une collection hautement puissante et révolutionnaire, soumise à des tests rigoureux en conditions réelles, afin d’offrir la meilleure expérience d’écriture. Vous pouvez y trouver des comparaisons détaillées entre versions gratuites et payantes, des classements précis, ainsi que des options incontournables conçues pour vous aider à créer sans effort des ébauches de chansons remarquables et à booster significativement votre productivité créative. Explorez dès maintenant pour découvrir l’outil qui vous correspond parfaitement !
8 outils
xix.ai

Les derniers outils de formation à la conversation par IA les mieux notés pour 2026 sont disponibles sur XIX.AI ! Cette sélection rigoureuse propose des outils puissants et révolutionnaires, testés rigoureusement dans des conditions réelles pour fournir des retours précis. Vous y trouverez une comparaison entre les versions gratuites et payantes, ainsi que des classements détaillés pour vous aider à choisir l’option incontournable qui renforce votre confiance et vos compétences. Explorez dès maintenant pour découvrir l’outil parfait pour réussir vos entretiens !
12 outils
xix.ai

Les meilleurs outils de transfert de style par IA de 2026, les mieux notés, pour des expériences créatives ! XIX.AI a sélectionné une collection d’outils puissants et révolutionnaires à essayer absolument, qui offrent des résultats exceptionnels grâce à des tests en conditions réelles et à un classement rigoureux. Ces solutions de pointe aident les créatifs à booster considérablement leur productivité en accélérant la création de contenu et en ouvrant la voie à des possibilités créatives infinies. Découvrez-les dès maintenant pour trouver l'outil qui vous convient le mieux et commencez à créer dès aujourd'hui !
9 outils
xix.ai












