


 Maison
LOGOS, le modèle scientifique open source d'Aliyun, surpasse Microsoft avec 1/56e du nombre de paramètres
ATH-Token Foundry, filiale d'Alibaba, en collaboration avec l'Institut Gaoqiang d'intelligence artificielle de l'Université Renmin de Chine, a annoncé la mise à disposition en open source de LOGOS. Il s'agit du premier modèle de base génératif scientifique multidomaine reposant sur une syntaxe scientifique unifiée, qui, grâce à la modélisation pure des séquences, égale ou surpasse systématiquement les méthodes traditionnelles spécifiques à chaque domaine dans six tâches scientifiques représentatives.
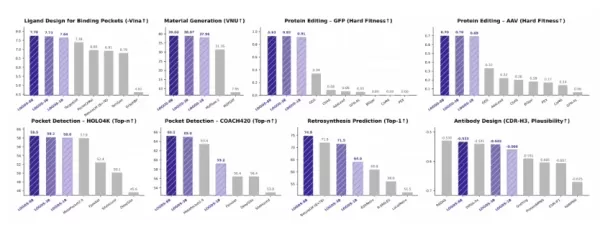
Ce qui ressort particulièrement, c’est l’exceptionnelle efficacité des paramètres du modèle. Avec seulement 1 milliard de paramètres, LOGOS-1B surpasse NatureLM de Microsoft (qui compte 8 × 7 milliards de paramètres) sur plusieurs tâches clés.
Une syntaxe scientifique unifiée pionnière pour des objets hétérogènes
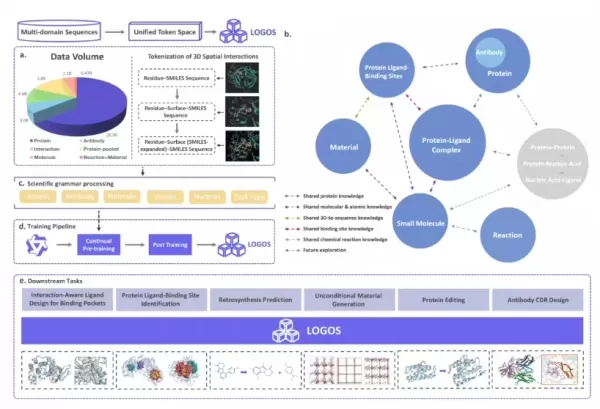
LOGOS utilise un vaste corpus de pré-entraînement couvrant sept modalités — macromolécules biologiques, entités chimiques et interactions d’interface — totalisant 44,87 milliards de tokens. Grâce à un vocabulaire partagé, il encode des objets auparavant hétérogènes, tels que les protéines et les petites molécules, en une séquence unifiée de tokens discrets.
Cette syntaxe scientifique distinctive permet aux grands modèles d’interpréter de manière autorégressive différents objets scientifiques au sein d’un espace de génération partagé. Elle introduit même une « méthode de description textuelle » qui permet de conceptualiser des règles d’interaction spatiales complexes sans saisir de coordonnées 3D compliquées, en s’appuyant uniquement sur la prédiction de séquences.
Combler le fossé entre le pré-entraînement et l’application
Dans les contextes de recherche classiques, le passage d’un modèle à un autre entre les différentes étapes nécessite souvent un réglage fin approfondi lors du déploiement. LOGOS assure une forte cohérence tant au niveau de la forme que de la finalité, car le format de séquence des données de pré-entraînement correspond aux formats d’entrée et de sortie des tâches en aval.
Cet alignement élimine efficacement la fracture entre le pré-entraînement et les applications concrètes, permettant des capacités génératives directes sans couches d’adaptation complexes. Alibaba a désormais entièrement open-sourcé les poids du modèle, le code d’inférence et le rapport technique relatifs à ce modèle de grande envergure.
Article connexe
 SAS lance un outil de gouvernance de l’IA d’entreprise pour gérer les entités intelligentes et atténuer les risques liés à l’IA occulte
Lors de la récente conférence SAS Innovate, le leader de l’analyse SAS a dévoilé une suite d’outils de gouvernance conçus pour l’IA agentique. Ces solutions permettent aux organisations de créer des écosystèmes automatisés transparents et sécurisés,
La mise à jour de MacWhisper 14 permet désormais de modifier directement les transcriptions et corrige le problème de consommation excessive du processeur
Jodi Bruijn, la développeuse indépendante à l’origine de MacWhisper, a publié hier la version 14.0, qui met l’accent sur l’amélioration des performances de transcription et introduit un éditeur dédié.
Qwen3.5-Max Preview en tête du LMArena alors que les modèles d'IA chinois atteignent le premier rang mondial
Le 20 mars, les derniers classements de la plateforme d’évaluation aveugle des grands modèles d’autorité LMArena ont révélé que le tout dernier modèle phare de la série Qwen d’Alibaba, Qwen3.5-Max-Preview, a offert des performances exceptionnelles. A
Recommandations de sujets spéciaux liés
Conception et art
 Les meilleurs outils d'illustration basés sur l'IA : créez plus rapidement des scènes éditoriales et des illustrations de couverture
Les meilleurs outils d'illustration IA de 2026 : notre sélection regroupe les outils les plus performants pour créer rapidement de superbes scènes éditoriales et des couvertures accrocheuses. Chaque option a été soumise à des tests rigoureux en conditions réelles ; nous vous proposons une comparaison entre les versions gratuites et payantes afin de vous aider à trouver celle qui correspond le mieux à votre flux de travail. Essayez dès aujourd’hui ces solutions incontournables pour exploiter pleinement le potentiel de l’IA et booster votre productivité créative. Découvrez-les dès maintenant sur XIX.AI.
 10 outils
 xix.ai
Éducation et apprentissage
Les meilleurs professeurs particuliers spécialisés en IA pour la préparation aux examens : entraînez-vous en maths, en sciences et en anglais
Les meilleurs tuteurs IA 2026 les mieux notés pour la préparation aux examens sont disponibles ici, sur XIX.AI ! Notre sélection comprend des outils puissants et révolutionnaires qui proposent une comparaison entre les versions gratuites et payantes, des tests concrets et des classements mis à jour chaque semaine. Ils vous aident à améliorer votre efficacité à l'écrit, à simplifier l'apprentissage de sujets complexes et à libérer votre potentiel académique. Découvrez dès maintenant l'outil de préparation aux examens qui vous convient le mieux et commencez à créer dès aujourd'hui pour exploiter pleinement les avantages de l'IA !
10 outils
xix.ai
Finance
Outils de planification budgétaire par IA pour la gestion personnelle des finances
2026 Derniers Meilleurs Outils de Planification Budgétaire par IA les mieux notés pour la gestion personnelle des finances sont ici sur XIX.AI ! Cette collection soigneusement sélectionnée propose des solutions puissantes et révolutionnaires qui vous aident à réaliser des tests concrets, à comprendre vos habitudes de dépenses et à créer des plans personnalisés pour améliorer votre productivité. Profitez d’une comparaison entre versions gratuites et payantes ainsi que de classements détaillés. Des outils incontournables conçus pour simplifier la gestion financière et exploiter pleinement votre avantage grâce à l’IA. Explorez dès maintenant !
11 outils
xix.ai
Santé et bien-être
Assistants de suivi du sommeil par l’IA : améliorez votre récupération grâce à de meilleures habitudes avant le coucher
2026 : Découvrez les meilleurs assistants de suivi du sommeil basés sur l’IA, hautement notés et récemment mis à jour, conçus pour une récupération optimale. Ce guide hebdomadaire entièrement actualisé présente des outils puissants qui offrent des tests en conditions réelles, des comparaisons entre versions gratuites et payantes, ainsi que des classements détaillés afin de vous aider à trouver la solution idéale pour améliorer la qualité du sommeil et favoriser de meilleures habitudes avant le coucher. Explorez-le dès maintenant sur XIX.AI pour tirer parti des avantages offerts par l’IA.
10 outils
xix.ai
Analyse des données
Copilotes SQL basés sur l'IA pour l'analyse des produits et du chiffre d'affaires
2026 : les meilleurs copilotes SQL IA les mieux notés pour l'analyse des produits et du chiffre d'affaires ! XIX.AI a sélectionné une gamme d’outils puissants et révolutionnaires à essayer absolument, qui sont soumis à des tests en conditions réelles via des classements mis à jour chaque semaine. Ces outils aident les utilisateurs à booster considérablement leur productivité en accélérant l’analyse des données, en simplifiant les requêtes complexes et en générant des informations précises permettant de prendre des décisions commerciales plus éclairées. Explorez-les dès maintenant pour découvrir l’outil idéal qui vous permettra de tirer pleinement parti de l’IA !
14 outils
xix.ai
Éducation et apprentissage
Les meilleurs outils d'aide aux devoirs basés sur l'IA qui enseignent : apprenez les concepts, pas seulement les réponses
2026 : les meilleurs outils d'aide aux devoirs basés sur l'IA, les mieux notés, qui enseignent les concepts fondamentaux et ne se contentent pas de fournir des réponses. Des outils puissants pour les élèves. Une sélection incontournable à ne pas manquer. Mise à jour hebdomadaire. Comparaison entre les versions gratuites et payantes. Tests en conditions réelles. Classements précis pour vous aider à exploiter pleinement votre potentiel d'apprentissage. Explorez dès maintenant pour découvrir l'outil idéal qui vous permettra d'étudier plus efficacement.
10 outils
xix.ai

 commentaires (0)
ATH-Token Foundry, filiale d'Alibaba, en collaboration avec l'Institut Gaoqiang d'intelligence artificielle de l'Université Renmin de Chine, a annoncé la mise à disposition en open source de LOGOS. Il s'agit du premier modèle de base génératif scientifique multidomaine reposant sur une syntaxe scientifique unifiée, qui, grâce à la modélisation pure des séquences, égale ou surpasse systématiquement les méthodes traditionnelles spécifiques à chaque domaine dans six tâches scientifiques représentatives.
Ce qui ressort particulièrement, c’est l’exceptionnelle efficacité des paramètres du modèle. Avec seulement 1 milliard de paramètres, LOGOS-1B surpasse NatureLM de Microsoft (qui compte 8 × 7 milliards de paramètres) sur plusieurs tâches clés.
Une syntaxe scientifique unifiée pionnière pour des objets hétérogènes
LOGOS utilise un vaste corpus de pré-entraînement couvrant sept modalités — macromolécules biologiques, entités chimiques et interactions d’interface — totalisant 44,87 milliards de tokens. Grâce à un vocabulaire partagé, il encode des objets auparavant hétérogènes, tels que les protéines et les petites molécules, en une séquence unifiée de tokens discrets.
Cette syntaxe scientifique distinctive permet aux grands modèles d’interpréter de manière autorégressive différents objets scientifiques au sein d’un espace de génération partagé. Elle introduit même une « méthode de description textuelle » qui permet de conceptualiser des règles d’interaction spatiales complexes sans saisir de coordonnées 3D compliquées, en s’appuyant uniquement sur la prédiction de séquences.
Combler le fossé entre le pré-entraînement et l’application
Dans les contextes de recherche classiques, le passage d’un modèle à un autre entre les différentes étapes nécessite souvent un réglage fin approfondi lors du déploiement. LOGOS assure une forte cohérence tant au niveau de la forme que de la finalité, car le format de séquence des données de pré-entraînement correspond aux formats d’entrée et de sortie des tâches en aval.
Cet alignement élimine efficacement la fracture entre le pré-entraînement et les applications concrètes, permettant des capacités génératives directes sans couches d’adaptation complexes. Alibaba a désormais entièrement open-sourcé les poids du modèle, le code d’inférence et le rapport technique relatifs à ce modèle de grande envergure.







 SAS lance un outil de gouvernance de l’IA d’entreprise pour gérer les entités intelligentes et atténuer les risques liés à l’IA occulte
Lors de la récente conférence SAS Innovate, le leader de l’analyse SAS a dévoilé une suite d’outils de gouvernance conçus pour l’IA agentique. Ces solutions permettent aux organisations de créer des écosystèmes automatisés transparents et sécurisés,
 La mise à jour de MacWhisper 14 permet désormais de modifier directement les transcriptions et corrige le problème de consommation excessive du processeur
Jodi Bruijn, la développeuse indépendante à l’origine de MacWhisper, a publié hier la version 14.0, qui met l’accent sur l’amélioration des performances de transcription et introduit un éditeur dédié.
 Qwen3.5-Max Preview en tête du LMArena alors que les modèles d'IA chinois atteignent le premier rang mondial
Le 20 mars, les derniers classements de la plateforme d’évaluation aveugle des grands modèles d’autorité LMArena ont révélé que le tout dernier modèle phare de la série Qwen d’Alibaba, Qwen3.5-Max-Preview, a offert des performances exceptionnelles. A

Les meilleurs outils d'illustration IA de 2026 : notre sélection regroupe les outils les plus performants pour créer rapidement de superbes scènes éditoriales et des couvertures accrocheuses. Chaque option a été soumise à des tests rigoureux en conditions réelles ; nous vous proposons une comparaison entre les versions gratuites et payantes afin de vous aider à trouver celle qui correspond le mieux à votre flux de travail. Essayez dès aujourd’hui ces solutions incontournables pour exploiter pleinement le potentiel de l’IA et booster votre productivité créative. Découvrez-les dès maintenant sur XIX.AI.
10 outils
xix.ai

Les meilleurs tuteurs IA 2026 les mieux notés pour la préparation aux examens sont disponibles ici, sur XIX.AI ! Notre sélection comprend des outils puissants et révolutionnaires qui proposent une comparaison entre les versions gratuites et payantes, des tests concrets et des classements mis à jour chaque semaine. Ils vous aident à améliorer votre efficacité à l'écrit, à simplifier l'apprentissage de sujets complexes et à libérer votre potentiel académique. Découvrez dès maintenant l'outil de préparation aux examens qui vous convient le mieux et commencez à créer dès aujourd'hui pour exploiter pleinement les avantages de l'IA !
10 outils
xix.ai

2026 Derniers Meilleurs Outils de Planification Budgétaire par IA les mieux notés pour la gestion personnelle des finances sont ici sur XIX.AI ! Cette collection soigneusement sélectionnée propose des solutions puissantes et révolutionnaires qui vous aident à réaliser des tests concrets, à comprendre vos habitudes de dépenses et à créer des plans personnalisés pour améliorer votre productivité. Profitez d’une comparaison entre versions gratuites et payantes ainsi que de classements détaillés. Des outils incontournables conçus pour simplifier la gestion financière et exploiter pleinement votre avantage grâce à l’IA. Explorez dès maintenant !
11 outils
xix.ai

2026 : Découvrez les meilleurs assistants de suivi du sommeil basés sur l’IA, hautement notés et récemment mis à jour, conçus pour une récupération optimale. Ce guide hebdomadaire entièrement actualisé présente des outils puissants qui offrent des tests en conditions réelles, des comparaisons entre versions gratuites et payantes, ainsi que des classements détaillés afin de vous aider à trouver la solution idéale pour améliorer la qualité du sommeil et favoriser de meilleures habitudes avant le coucher. Explorez-le dès maintenant sur XIX.AI pour tirer parti des avantages offerts par l’IA.
10 outils
xix.ai

2026 : les meilleurs copilotes SQL IA les mieux notés pour l'analyse des produits et du chiffre d'affaires ! XIX.AI a sélectionné une gamme d’outils puissants et révolutionnaires à essayer absolument, qui sont soumis à des tests en conditions réelles via des classements mis à jour chaque semaine. Ces outils aident les utilisateurs à booster considérablement leur productivité en accélérant l’analyse des données, en simplifiant les requêtes complexes et en générant des informations précises permettant de prendre des décisions commerciales plus éclairées. Explorez-les dès maintenant pour découvrir l’outil idéal qui vous permettra de tirer pleinement parti de l’IA !
14 outils
xix.ai

2026 : les meilleurs outils d'aide aux devoirs basés sur l'IA, les mieux notés, qui enseignent les concepts fondamentaux et ne se contentent pas de fournir des réponses. Des outils puissants pour les élèves. Une sélection incontournable à ne pas manquer. Mise à jour hebdomadaire. Comparaison entre les versions gratuites et payantes. Tests en conditions réelles. Classements précis pour vous aider à exploiter pleinement votre potentiel d'apprentissage. Explorez dès maintenant pour découvrir l'outil idéal qui vous permettra d'étudier plus efficacement.
10 outils
xix.ai












