


 Hogar
LOGOS, el modelo científico de código abierto de Aliyun, supera a Microsoft con una 56.ª parte de los parámetros
ATH-Token Foundry, de Alibaba, en colaboración con el Instituto Gaoqiang de Inteligencia Artificial de la Universidad Renmin de China, ha anunciado el lanzamiento de LOGOS como software de código abierto. Se trata del primer modelo generativo científico multidominio construido sobre una sintaxis científica unificada, que iguala o supera de forma sistemática a los métodos tradicionales específicos de cada dominio en seis tareas científicas representativas mediante el modelado de secuencias puras.
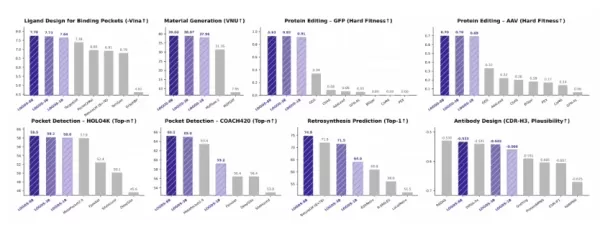
Lo que más destaca es la excepcional eficiencia de los parámetros del modelo. Con solo 1 000 millones de parámetros, LOGOS-1B supera a NatureLM de Microsoft (que cuenta con 8 × 7 000 millones de parámetros) en varias tareas clave.
Sintaxis científica unificada pionera para objetos heterogéneos
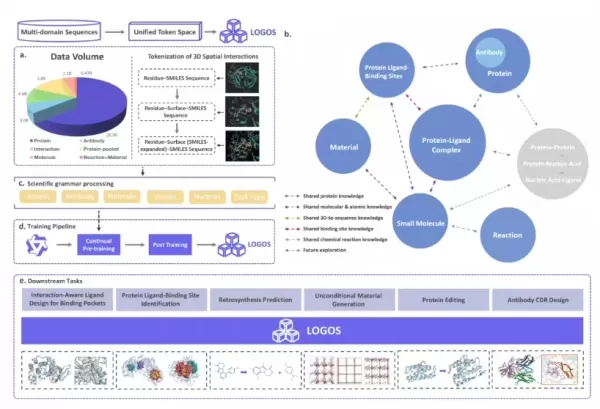
LOGOS utiliza un amplio corpus de preentrenamiento que abarca siete modalidades —macromoléculas biológicas, entidades químicas e interacciones de interfaz— y que suma un total de 44 870 millones de tokens. A través de un vocabulario compartido, codifica objetos que antes eran heterogéneos, como proteínas y moléculas pequeñas, en una secuencia unificada de tokens discretos.
Esta sintaxis científica distintiva permite a los modelos de gran tamaño interpretar de forma autorregresiva diferentes objetos científicos dentro de un espacio de generación compartido. Incluso introduce un «método de descripción textual» que permite conceptualizar reglas complejas de interacción espacial sin necesidad de introducir coordenadas 3D intrincadas, basándose exclusivamente en la predicción de secuencias.
Salvar la brecha entre el preentrenamiento y la aplicación
En entornos de investigación convencionales, el cambio de modelo entre etapas suele requerir un ajuste exhaustivo en el momento de la implementación. LOGOS logra una gran coherencia tanto en la forma como en la finalidad, ya que el formato de secuencia de los datos de preentrenamiento coincide con los formatos de entrada y salida de las tareas posteriores.
Esta alineación elimina de forma efectiva la brecha entre el preentrenamiento y las aplicaciones del mundo real, lo que permite capacidades generativas directas sin necesidad de complejas capas de adaptación. Alibaba ha publicado ahora en código abierto los pesos del modelo, el código de inferencia y el informe técnico de este modelo a gran escala.
Artículo relacionado
 SAS lanza una herramienta de gobernanza de IA empresarial para gestionar entidades inteligentes y mitigar los riesgos de la IA en las sombras
Durante la reciente conferencia SAS Innovate, el líder en analítica SAS presentó una serie de herramientas de gobernanza diseñadas para la IA Agéntica. Estas soluciones permiten a las organizaciones crear ecosistemas automatizados transparentes y seg
La actualización de MacWhisper 14 permite editar directamente las transcripciones y soluciona el elevado consumo de CPU
Jodi Bruijn, la desarrolladora independiente responsable de MacWhisper, lanzó ayer la versión 14.0, en la que se ha dado prioridad a la mejora del rendimiento de la transcripción y se ha introducido u
La vista previa de Qwen3.5-Max lidera LMArena, mientras los modelos de inteligencia artificial de China alcanzan el primer nivel global
El 20 de marzo, las últimas clasificaciones de la plataforma autorizada de pruebas a ciegas de modelos grandes, LMArena, revelaron que el último modelo insignia de vista previa de la serie Qwen de Alibaba, Qwen3.5-Max-Preview, ofreció un rendimiento
Recomendaciones de temas especiales relacionados
Diseño y Arte
 Las mejores herramientas de ilustración con IA: crea escenas editoriales y portadas más rápido
Las mejores herramientas de ilustración con IA de 2026: nuestra lista seleccionada incluye las mejores herramientas, diseñadas con gran potencia, para crear rápidamente impresionantes escenas editoriales y llamativas portadas. Cada opción ha sido sometida a rigurosas pruebas en condiciones reales y ofrece una comparación entre las versiones gratuitas y de pago para ayudarte a encontrar la que mejor se adapte a tu flujo de trabajo. Prueba hoy mismo estas soluciones imprescindibles para sacar el máximo partido a la IA y potenciar tu productividad creativa. Descúbrelas ahora en XIX.AI.
 10 herramientas
 xix.ai
Educación y aprendizaje
Los mejores profesores particulares de IA para la preparación de exámenes: practica matemáticas, ciencias e inglés
¡Ya están aquí, en XIX.AI, los mejores tutores de IA para la preparación de exámenes de 2026, con las mejores valoraciones! Nuestra lista seleccionada incluye potentes herramientas revolucionarias que ofrecen comparativas entre versiones gratuitas y de pago, pruebas reales y clasificaciones actualizadas semanalmente. Te ayudan a mejorar tu eficiencia a la hora de escribir, a simplificar el aprendizaje de temas complejos y a desarrollar todo tu potencial académico. ¡Explora ahora mismo para descubrir tu herramienta perfecta de preparación de exámenes y empieza a crear hoy mismo para sacar partido a tu ventaja con la IA!
10 herramientas
xix.ai
Finanzas
Herramientas de planificación presupuestaria con IA para la gestión personal del dinero
2026 Últimas Mejores Herramientas de Planificación Presupuestaria con IA Mejor Valoradas para la Gestión Personal del Dinero están aquí en XIX.AI. Esta colección seleccionada presenta soluciones poderosas y transformadoras que te ayudan a realizar pruebas en el mundo real, comprender tus hábitos de gasto y crear planes personalizados para aumentar la productividad. Disfruta de una comparación entre versiones gratuitas y de pago junto con clasificaciones detalladas. Herramientas imprescindibles diseñadas para simplificar la gestión del dinero y desbloquear tu ventaja con IA. ¡Explóralas ahora!
11 herramientas
xix.ai
Salud y bienestar
Asistentes de seguimiento del sueño basados en IA: mejora tu recuperación con mejores hábitos a la hora de acostarte
Los mejores asistentes de seguimiento del sueño con IA de 2026, seleccionados para una recuperación óptima. Esta guía semanal totalmente actualizada incluye potentes herramientas que ofrecen pruebas en condiciones reales, comparativas entre opciones gratuitas y de pago, y clasificaciones detalladas para ayudarte a encontrar la solución imprescindible que mejora la calidad del sueño y fomenta mejores hábitos a la hora de acostarse. Descúbrelo ahora en XIX.AI y aprovecha todas las ventajas de la IA.
10 herramientas
xix.ai
Análisis de datos
Copilotos de IA y SQL para el análisis de productos e ingresos
¡Los mejores copilotos de IA para SQL mejor valorados de 2026 para el análisis de productos e ingresos! XIX.AI ha seleccionado una potente colección de herramientas revolucionarias que no te puedes perder y que se someten a pruebas en el mundo real a través de clasificaciones que se actualizan semanalmente. Estas herramientas ayudan a los usuarios a aumentar significativamente su productividad al acelerar el análisis de datos, simplificar consultas complejas y generar información precisa para tomar decisiones empresariales más inteligentes. ¡Explora ahora mismo y descubre la herramienta perfecta para sacar el máximo partido a tu ventaja en IA!
14 herramientas
xix.ai
Educación y aprendizaje
Las mejores herramientas de IA para los deberes que realmente enseñan: aprende conceptos, no solo respuestas
2026: los mejores y más valorados asistentes de deberes con IA que enseñan conceptos básicos, no solo respuestas. Potentes herramientas para estudiantes. Una selección imprescindible que debes probar. Actualización semanal. Comparativa entre opciones gratuitas y de pago. Pruebas en el mundo real. Clasificaciones precisas para ayudarte a desarrollar todo tu potencial de aprendizaje. Explora ahora y descubre la herramienta perfecta para estudiar de forma más inteligente.
10 herramientas
xix.ai

 comentario (0)
0/500
ATH-Token Foundry, de Alibaba, en colaboración con el Instituto Gaoqiang de Inteligencia Artificial de la Universidad Renmin de China, ha anunciado el lanzamiento de LOGOS como software de código abierto. Se trata del primer modelo generativo científico multidominio construido sobre una sintaxis científica unificada, que iguala o supera de forma sistemática a los métodos tradicionales específicos de cada dominio en seis tareas científicas representativas mediante el modelado de secuencias puras.
Lo que más destaca es la excepcional eficiencia de los parámetros del modelo. Con solo 1 000 millones de parámetros, LOGOS-1B supera a NatureLM de Microsoft (que cuenta con 8 × 7 000 millones de parámetros) en varias tareas clave.
Sintaxis científica unificada pionera para objetos heterogéneos
LOGOS utiliza un amplio corpus de preentrenamiento que abarca siete modalidades —macromoléculas biológicas, entidades químicas e interacciones de interfaz— y que suma un total de 44 870 millones de tokens. A través de un vocabulario compartido, codifica objetos que antes eran heterogéneos, como proteínas y moléculas pequeñas, en una secuencia unificada de tokens discretos.
Esta sintaxis científica distintiva permite a los modelos de gran tamaño interpretar de forma autorregresiva diferentes objetos científicos dentro de un espacio de generación compartido. Incluso introduce un «método de descripción textual» que permite conceptualizar reglas complejas de interacción espacial sin necesidad de introducir coordenadas 3D intrincadas, basándose exclusivamente en la predicción de secuencias.
Salvar la brecha entre el preentrenamiento y la aplicación
En entornos de investigación convencionales, el cambio de modelo entre etapas suele requerir un ajuste exhaustivo en el momento de la implementación. LOGOS logra una gran coherencia tanto en la forma como en la finalidad, ya que el formato de secuencia de los datos de preentrenamiento coincide con los formatos de entrada y salida de las tareas posteriores.
Esta alineación elimina de forma efectiva la brecha entre el preentrenamiento y las aplicaciones del mundo real, lo que permite capacidades generativas directas sin necesidad de complejas capas de adaptación. Alibaba ha publicado ahora en código abierto los pesos del modelo, el código de inferencia y el informe técnico de este modelo a gran escala.







 SAS lanza una herramienta de gobernanza de IA empresarial para gestionar entidades inteligentes y mitigar los riesgos de la IA en las sombras
Durante la reciente conferencia SAS Innovate, el líder en analítica SAS presentó una serie de herramientas de gobernanza diseñadas para la IA Agéntica. Estas soluciones permiten a las organizaciones crear ecosistemas automatizados transparentes y seg
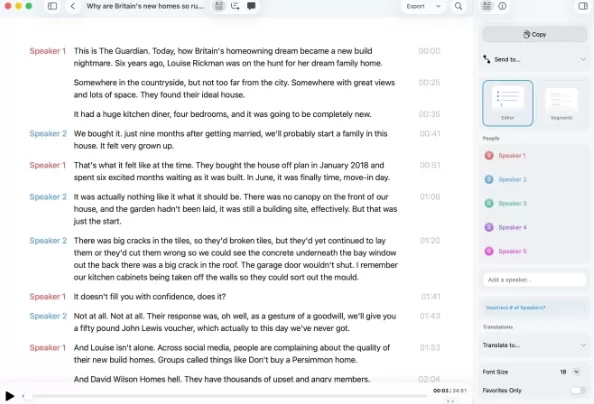 La actualización de MacWhisper 14 permite editar directamente las transcripciones y soluciona el elevado consumo de CPU
Jodi Bruijn, la desarrolladora independiente responsable de MacWhisper, lanzó ayer la versión 14.0, en la que se ha dado prioridad a la mejora del rendimiento de la transcripción y se ha introducido u
 La vista previa de Qwen3.5-Max lidera LMArena, mientras los modelos de inteligencia artificial de China alcanzan el primer nivel global
El 20 de marzo, las últimas clasificaciones de la plataforma autorizada de pruebas a ciegas de modelos grandes, LMArena, revelaron que el último modelo insignia de vista previa de la serie Qwen de Alibaba, Qwen3.5-Max-Preview, ofreció un rendimiento

Las mejores herramientas de ilustración con IA de 2026: nuestra lista seleccionada incluye las mejores herramientas, diseñadas con gran potencia, para crear rápidamente impresionantes escenas editoriales y llamativas portadas. Cada opción ha sido sometida a rigurosas pruebas en condiciones reales y ofrece una comparación entre las versiones gratuitas y de pago para ayudarte a encontrar la que mejor se adapte a tu flujo de trabajo. Prueba hoy mismo estas soluciones imprescindibles para sacar el máximo partido a la IA y potenciar tu productividad creativa. Descúbrelas ahora en XIX.AI.
10 herramientas
xix.ai

¡Ya están aquí, en XIX.AI, los mejores tutores de IA para la preparación de exámenes de 2026, con las mejores valoraciones! Nuestra lista seleccionada incluye potentes herramientas revolucionarias que ofrecen comparativas entre versiones gratuitas y de pago, pruebas reales y clasificaciones actualizadas semanalmente. Te ayudan a mejorar tu eficiencia a la hora de escribir, a simplificar el aprendizaje de temas complejos y a desarrollar todo tu potencial académico. ¡Explora ahora mismo para descubrir tu herramienta perfecta de preparación de exámenes y empieza a crear hoy mismo para sacar partido a tu ventaja con la IA!
10 herramientas
xix.ai

2026 Últimas Mejores Herramientas de Planificación Presupuestaria con IA Mejor Valoradas para la Gestión Personal del Dinero están aquí en XIX.AI. Esta colección seleccionada presenta soluciones poderosas y transformadoras que te ayudan a realizar pruebas en el mundo real, comprender tus hábitos de gasto y crear planes personalizados para aumentar la productividad. Disfruta de una comparación entre versiones gratuitas y de pago junto con clasificaciones detalladas. Herramientas imprescindibles diseñadas para simplificar la gestión del dinero y desbloquear tu ventaja con IA. ¡Explóralas ahora!
11 herramientas
xix.ai

Los mejores asistentes de seguimiento del sueño con IA de 2026, seleccionados para una recuperación óptima. Esta guía semanal totalmente actualizada incluye potentes herramientas que ofrecen pruebas en condiciones reales, comparativas entre opciones gratuitas y de pago, y clasificaciones detalladas para ayudarte a encontrar la solución imprescindible que mejora la calidad del sueño y fomenta mejores hábitos a la hora de acostarse. Descúbrelo ahora en XIX.AI y aprovecha todas las ventajas de la IA.
10 herramientas
xix.ai

¡Los mejores copilotos de IA para SQL mejor valorados de 2026 para el análisis de productos e ingresos! XIX.AI ha seleccionado una potente colección de herramientas revolucionarias que no te puedes perder y que se someten a pruebas en el mundo real a través de clasificaciones que se actualizan semanalmente. Estas herramientas ayudan a los usuarios a aumentar significativamente su productividad al acelerar el análisis de datos, simplificar consultas complejas y generar información precisa para tomar decisiones empresariales más inteligentes. ¡Explora ahora mismo y descubre la herramienta perfecta para sacar el máximo partido a tu ventaja en IA!
14 herramientas
xix.ai

2026: los mejores y más valorados asistentes de deberes con IA que enseñan conceptos básicos, no solo respuestas. Potentes herramientas para estudiantes. Una selección imprescindible que debes probar. Actualización semanal. Comparativa entre opciones gratuitas y de pago. Pruebas en el mundo real. Clasificaciones precisas para ayudarte a desarrollar todo tu potencial de aprendizaje. Explora ahora y descubre la herramienta perfecta para estudiar de forma más inteligente.
10 herramientas
xix.ai












