


 Maison
Ali’s Black Tech : modèle de 0,6 milliard de paramètres amélioré à 17 milliards de MoE avec 5 % de paramètres actifs, fonctionnant sur un processeur à une vitesse de 30 jetons par seconde
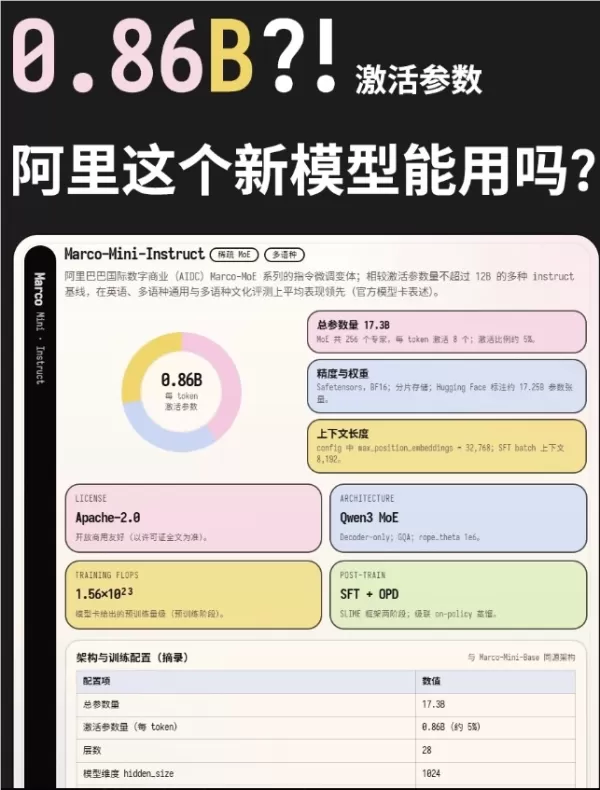
L'équipe d'Ali International Digital Commerce a dévoilé Marco-Mini-Instruct, le dernier-né de la série Marco-MoE, démontrant ainsi que « les petites échelles peuvent donner de grands résultats ». Sur un total de 17,3 milliards de paramètres, seuls 0,86 milliard sont actifs (soit environ 5 %), ce qui permet une vitesse d’inférence exceptionnelle, garantissant un fonctionnement fluide même sur des processeurs standard.
Ultra-léger : optimisé pour les performances des processeurs
Selon les données officielles, en utilisant une quantification sur 8 bits avec quatre modules de mémoire DDR4 2400, le modèle atteint une vitesse d’inférence d’environ 30 tokens par seconde. Cette efficacité rend l’architecture Mixture-of-Experts (MoE) plus accessible au grand public, réduisant considérablement les obstacles au déploiement local.
Innovation clé : la technologie de surcyclage transforme le potentiel
La caractéristique remarquable de Marco-Mini-Instruct n’est ni sa taille ni sa vitesse, mais sa méthode de création unique. Au lieu d’être entraîné à partir de zéro, ce modèle a été développé à partir du modèle Qwen3-0.6B-Base à l’aide de la technologie d’« upcycling ».
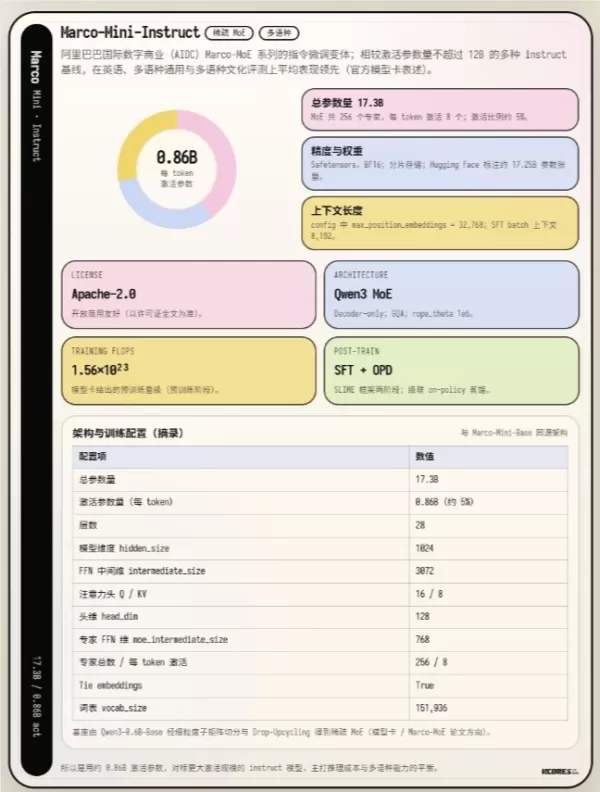
Ce processus consiste à diviser ou à copier les composants d’un petit modèle dense en plusieurs experts, en introduisant un mécanisme de routage. Il intègre également un partitionnement fin des sous-matrices et des stratégies de « Drop-Upcycling » — consistant à écarter aléatoirement certains experts ou chemins de routage pendant l’entraînement afin d’ajouter de la régularisation et d’améliorer la robustesse. Cette approche permet de transformer avec succès un modèle « Dense » pur en une architecture MoE, offrant ainsi au secteur une nouvelle voie, économique et efficace, pour l’entraînement MoE.
Longueur du contexte et configuration de l’entraînement
La configuration du modèle étend max_position_embeddings à 32K, bien que la phase de réglage fin supervisé (SFT) utilise un contexte de 8192 tokens. Par conséquent, la longueur de contexte par défaut est bien adaptée à la plupart des scénarios d’application pratiques.
Percée post-entraînement : distillation « on-policy » en cascade
La phase post-entraînement est tout aussi impressionnante : elle commence par un préchauffage SFT, suivi d’une stratégie de distillation « on-policy » en cascade. Au départ, la distillation utilise Qwen3-30B-A3B-Instruct comme modèle « enseignant », puis passe au modèle plus puissant Qwen3-Next-80B-A3B-Instruct. Les données de distillation couvrent le suivi d’instructions, le raisonnement complexe, la sécurité de l’alignement et les capacités mathématiques, garantissant ainsi que le modèle conserve son efficacité tout en renforçant considérablement son intelligence globale.
Résultats des tests de performance : 0,86 milliard de paramètres actifs surpassent des modèles denses de 4 milliards
Le modèle final Marco-Mini-Instruct surpasse de nombreux modèles denses, tels que Qwen3-4B, dans la plupart des benchmarks courants. Avec seulement 0,86 milliard de paramètres actifs, il confirme pleinement le vaste potentiel de l’architecture MoE à offrir des performances « modestes mais puissantes ».
Impact sur le secteur : un nouveau paradigme open source pour l’entraînement des modèles MoE
AIbase estime que la plus grande valeur de cette avancée réside dans les nouvelles opportunités qu’elle offre aux développeurs. Il n’est plus nécessaire de former des modèles MoE à grande échelle à partir de zéro ; les équipes peuvent désormais sélectionner un petit modèle dense adapté et reproduire fidèlement les processus d’upcycling et de Drop-Upcycling décrits dans l’article. Le coût total de l’entraînement reste gérable : la phase SFT nécessite 64 GPU pendant 24 heures, et la phase de distillation nécessite 64 GPU pendant 110 heures, ce qui abaisse considérablement le seuil d’accès pour les équipes de petite et moyenne taille souhaitant expérimenter le MoE.
La dernière « modification » d’Alibaba prouve une fois de plus que les avancées en matière d’efficacité des modèles ne reposent pas nécessairement sur l’empilement de paramètres ; des paradigmes d’entraînement innovants peuvent également entraîner des bonds qualitatifs. La sortie de Marco-Mini-Instruct accélérera sans aucun doute l’adoption de la technologie MoE dans les appareils en périphérie et les scénarios de développement personnel, ce qui en fait une avancée majeure à suivre pour l’ensemble du secteur.
Article connexe
 PDG de DeepMind, Hassabis : Je dors six heures par jour et je me sens généralement plein d’énergie vers 1 h du matin.
Fortune a récemment publié une interview avec Demis Hassabis, PDG de Google DeepMind, révélant son approche non conventionnelle du repos et de la productivité. Hassabis a divulgué qu’il dort très peu, structurant ses heures d’éveil en deux blocs de t
OpenAI et Anthropic se disputent des parts de marché malgré des résultats en deçà des attentes
Bien que des informations récentes laissent entendre qu’OpenAI n’aurait pas atteint ses objectifs de chiffre d’affaires, ce qui a pesé sur les valeurs technologiques ce mardi, les investisseurs privés
Conformité des véhicules autonomes en Californie : une nouvelle ère marquée par les amendes, les zones de géolocalisation et 1 million de miles
Guident exploite une navette AuveTech dans le sud de la Floride, gérant un parcours de quatre miles à West Palm Beach et un parcours d’un mile à Boca Raton grâce à sa technologie de surveillance à dis
Recommandations de sujets spéciaux liés
chatbot
 Meilleures applications de chat de jeu de rôle par IA pour la pratique des langues, la préparation aux entretiens et la fluidité quotidienne
2026 Dernières Meilleures Applications de Chat IA pour le Jeu de Rôle, les plus bien notées pour la Pratique des Langues, la Préparation aux Entretiens et la Fluidité Quotidienne ! XIX.AI sélectionne une collection puissante et révolutionnaire qui propose une comparaison gratuit vs payant, des tests en conditions réelles et des classements mis à jour chaque semaine. Ces outils à essayer absolument vous aident à améliorer vos compétences en écriture, à surmonter les défis de fluidité et à optimiser l’efficacité de la communication dans tous les scénarios quotidiens. Explorez dès maintenant pour découvrir l’outil parfait pour votre progression linguistique !
 10 outils
 xix.ai
Composition musicale
Outils de séparation des pistes audio par IA pour la production de remix, la préparation de samples et les masters de karaoké
2026 : Les meilleures et plus récentes outils de séparation des pistes audio par IA, hautement notés, sélectionnés spécialement pour la production de remix, la préparation de samples et l’enregistrement de karaokés. Ces outils puissants et révolutionnaires, éprouvés dans des conditions réelles, permettent une isolation audio précise, ce qui améliore considérablement la productivité. XIX.AI propose un guide de comparaison gratuit mis à jour chaque semaine entre les versions payantes et gratuites, afin de vous aider à trouver la solution idéale adaptée à vos besoins. Découvrez-les dès maintenant pour tirer parti des avantages offerts par l’IA.
8 outils
xix.ai
Analyse des données
Copilotes SQL basés sur l’IA pour les tableaux de bord de chiffre d’affaires, l’analyse des funnels et les indicateurs de produits
2026 : Les meilleurs copilotes AI SQL actuels, classés parmi les plus performants ! XIX.AI a sélectionné une collection puissante et révolutionnaire, mise à jour chaque semaine grâce à des tests concrets. Ces outils indispensables vous aident à créer des tableaux de bord financiers précis, à analyser les canaux de vente et à suivre en temps réel les indicateurs produits, ce qui améliore considérablement votre productivité. Découvrez-les dès maintenant pour trouver l’outil idéal pour des décisions basées sur les données ! 238 caractères
9 outils
xix.ai
Composition musicale
Meilleurs outils d’écriture de mélodies par IA pour les ébauches de chansons
2026 Derniers Meilleurs Outils d’Écriture de Mélodie par IA les Mieux Notés pour des Ébauches de Chansons ! XIX.AI a sélectionné une collection hautement puissante et révolutionnaire, soumise à des tests rigoureux en conditions réelles, afin d’offrir la meilleure expérience d’écriture. Vous pouvez y trouver des comparaisons détaillées entre versions gratuites et payantes, des classements précis, ainsi que des options incontournables conçues pour vous aider à créer sans effort des ébauches de chansons remarquables et à booster significativement votre productivité créative. Explorez dès maintenant pour découvrir l’outil qui vous correspond parfaitement !
8 outils
xix.ai
chatbot
Meilleurs outils d’entraînement à la conversation par IA pour la préparation aux entretiens
Les derniers outils de formation à la conversation par IA les mieux notés pour 2026 sont disponibles sur XIX.AI ! Cette sélection rigoureuse propose des outils puissants et révolutionnaires, testés rigoureusement dans des conditions réelles pour fournir des retours précis. Vous y trouverez une comparaison entre les versions gratuites et payantes, ainsi que des classements détaillés pour vous aider à choisir l’option incontournable qui renforce votre confiance et vos compétences. Explorez dès maintenant pour découvrir l’outil parfait pour réussir vos entretiens !
12 outils
xix.ai
Conception et art
Les meilleurs outils de transfert de style basés sur l'IA pour des expériences créatives
Les meilleurs outils de transfert de style par IA de 2026, les mieux notés, pour des expériences créatives ! XIX.AI a sélectionné une collection d’outils puissants et révolutionnaires à essayer absolument, qui offrent des résultats exceptionnels grâce à des tests en conditions réelles et à un classement rigoureux. Ces solutions de pointe aident les créatifs à booster considérablement leur productivité en accélérant la création de contenu et en ouvrant la voie à des possibilités créatives infinies. Découvrez-les dès maintenant pour trouver l'outil qui vous convient le mieux et commencez à créer dès aujourd'hui !
9 outils
xix.ai

 commentaires (0)
L'équipe d'Ali International Digital Commerce a dévoilé Marco-Mini-Instruct, le dernier-né de la série Marco-MoE, démontrant ainsi que « les petites échelles peuvent donner de grands résultats ». Sur un total de 17,3 milliards de paramètres, seuls 0,86 milliard sont actifs (soit environ 5 %), ce qui permet une vitesse d’inférence exceptionnelle, garantissant un fonctionnement fluide même sur des processeurs standard.
Ultra-léger : optimisé pour les performances des processeurs
Selon les données officielles, en utilisant une quantification sur 8 bits avec quatre modules de mémoire DDR4 2400, le modèle atteint une vitesse d’inférence d’environ 30 tokens par seconde. Cette efficacité rend l’architecture Mixture-of-Experts (MoE) plus accessible au grand public, réduisant considérablement les obstacles au déploiement local.
Innovation clé : la technologie de surcyclage transforme le potentiel
La caractéristique remarquable de Marco-Mini-Instruct n’est ni sa taille ni sa vitesse, mais sa méthode de création unique. Au lieu d’être entraîné à partir de zéro, ce modèle a été développé à partir du modèle Qwen3-0.6B-Base à l’aide de la technologie d’« upcycling ».
Ce processus consiste à diviser ou à copier les composants d’un petit modèle dense en plusieurs experts, en introduisant un mécanisme de routage. Il intègre également un partitionnement fin des sous-matrices et des stratégies de « Drop-Upcycling » — consistant à écarter aléatoirement certains experts ou chemins de routage pendant l’entraînement afin d’ajouter de la régularisation et d’améliorer la robustesse. Cette approche permet de transformer avec succès un modèle « Dense » pur en une architecture MoE, offrant ainsi au secteur une nouvelle voie, économique et efficace, pour l’entraînement MoE.
Longueur du contexte et configuration de l’entraînement
La configuration du modèle étend max_position_embeddings à 32K, bien que la phase de réglage fin supervisé (SFT) utilise un contexte de 8192 tokens. Par conséquent, la longueur de contexte par défaut est bien adaptée à la plupart des scénarios d’application pratiques.
Percée post-entraînement : distillation « on-policy » en cascade
La phase post-entraînement est tout aussi impressionnante : elle commence par un préchauffage SFT, suivi d’une stratégie de distillation « on-policy » en cascade. Au départ, la distillation utilise Qwen3-30B-A3B-Instruct comme modèle « enseignant », puis passe au modèle plus puissant Qwen3-Next-80B-A3B-Instruct. Les données de distillation couvrent le suivi d’instructions, le raisonnement complexe, la sécurité de l’alignement et les capacités mathématiques, garantissant ainsi que le modèle conserve son efficacité tout en renforçant considérablement son intelligence globale.
Résultats des tests de performance : 0,86 milliard de paramètres actifs surpassent des modèles denses de 4 milliards
Le modèle final Marco-Mini-Instruct surpasse de nombreux modèles denses, tels que Qwen3-4B, dans la plupart des benchmarks courants. Avec seulement 0,86 milliard de paramètres actifs, il confirme pleinement le vaste potentiel de l’architecture MoE à offrir des performances « modestes mais puissantes ».
Impact sur le secteur : un nouveau paradigme open source pour l’entraînement des modèles MoE
AIbase estime que la plus grande valeur de cette avancée réside dans les nouvelles opportunités qu’elle offre aux développeurs. Il n’est plus nécessaire de former des modèles MoE à grande échelle à partir de zéro ; les équipes peuvent désormais sélectionner un petit modèle dense adapté et reproduire fidèlement les processus d’upcycling et de Drop-Upcycling décrits dans l’article. Le coût total de l’entraînement reste gérable : la phase SFT nécessite 64 GPU pendant 24 heures, et la phase de distillation nécessite 64 GPU pendant 110 heures, ce qui abaisse considérablement le seuil d’accès pour les équipes de petite et moyenne taille souhaitant expérimenter le MoE.
La dernière « modification » d’Alibaba prouve une fois de plus que les avancées en matière d’efficacité des modèles ne reposent pas nécessairement sur l’empilement de paramètres ; des paradigmes d’entraînement innovants peuvent également entraîner des bonds qualitatifs. La sortie de Marco-Mini-Instruct accélérera sans aucun doute l’adoption de la technologie MoE dans les appareils en périphérie et les scénarios de développement personnel, ce qui en fait une avancée majeure à suivre pour l’ensemble du secteur.








 PDG de DeepMind, Hassabis : Je dors six heures par jour et je me sens généralement plein d’énergie vers 1 h du matin.
Fortune a récemment publié une interview avec Demis Hassabis, PDG de Google DeepMind, révélant son approche non conventionnelle du repos et de la productivité. Hassabis a divulgué qu’il dort très peu, structurant ses heures d’éveil en deux blocs de t
 OpenAI et Anthropic se disputent des parts de marché malgré des résultats en deçà des attentes
Bien que des informations récentes laissent entendre qu’OpenAI n’aurait pas atteint ses objectifs de chiffre d’affaires, ce qui a pesé sur les valeurs technologiques ce mardi, les investisseurs privés
Conformité des véhicules autonomes en Californie : une nouvelle ère marquée par les amendes, les zones de géolocalisation et 1 million de miles
Guident exploite une navette AuveTech dans le sud de la Floride, gérant un parcours de quatre miles à West Palm Beach et un parcours d’un mile à Boca Raton grâce à sa technologie de surveillance à dis

2026 Dernières Meilleures Applications de Chat IA pour le Jeu de Rôle, les plus bien notées pour la Pratique des Langues, la Préparation aux Entretiens et la Fluidité Quotidienne ! XIX.AI sélectionne une collection puissante et révolutionnaire qui propose une comparaison gratuit vs payant, des tests en conditions réelles et des classements mis à jour chaque semaine. Ces outils à essayer absolument vous aident à améliorer vos compétences en écriture, à surmonter les défis de fluidité et à optimiser l’efficacité de la communication dans tous les scénarios quotidiens. Explorez dès maintenant pour découvrir l’outil parfait pour votre progression linguistique !
10 outils
xix.ai

2026 : Les meilleures et plus récentes outils de séparation des pistes audio par IA, hautement notés, sélectionnés spécialement pour la production de remix, la préparation de samples et l’enregistrement de karaokés. Ces outils puissants et révolutionnaires, éprouvés dans des conditions réelles, permettent une isolation audio précise, ce qui améliore considérablement la productivité. XIX.AI propose un guide de comparaison gratuit mis à jour chaque semaine entre les versions payantes et gratuites, afin de vous aider à trouver la solution idéale adaptée à vos besoins. Découvrez-les dès maintenant pour tirer parti des avantages offerts par l’IA.
8 outils
xix.ai

2026 : Les meilleurs copilotes AI SQL actuels, classés parmi les plus performants ! XIX.AI a sélectionné une collection puissante et révolutionnaire, mise à jour chaque semaine grâce à des tests concrets. Ces outils indispensables vous aident à créer des tableaux de bord financiers précis, à analyser les canaux de vente et à suivre en temps réel les indicateurs produits, ce qui améliore considérablement votre productivité. Découvrez-les dès maintenant pour trouver l’outil idéal pour des décisions basées sur les données ! 238 caractères
9 outils
xix.ai

2026 Derniers Meilleurs Outils d’Écriture de Mélodie par IA les Mieux Notés pour des Ébauches de Chansons ! XIX.AI a sélectionné une collection hautement puissante et révolutionnaire, soumise à des tests rigoureux en conditions réelles, afin d’offrir la meilleure expérience d’écriture. Vous pouvez y trouver des comparaisons détaillées entre versions gratuites et payantes, des classements précis, ainsi que des options incontournables conçues pour vous aider à créer sans effort des ébauches de chansons remarquables et à booster significativement votre productivité créative. Explorez dès maintenant pour découvrir l’outil qui vous correspond parfaitement !
8 outils
xix.ai

Les derniers outils de formation à la conversation par IA les mieux notés pour 2026 sont disponibles sur XIX.AI ! Cette sélection rigoureuse propose des outils puissants et révolutionnaires, testés rigoureusement dans des conditions réelles pour fournir des retours précis. Vous y trouverez une comparaison entre les versions gratuites et payantes, ainsi que des classements détaillés pour vous aider à choisir l’option incontournable qui renforce votre confiance et vos compétences. Explorez dès maintenant pour découvrir l’outil parfait pour réussir vos entretiens !
12 outils
xix.ai

Les meilleurs outils de transfert de style par IA de 2026, les mieux notés, pour des expériences créatives ! XIX.AI a sélectionné une collection d’outils puissants et révolutionnaires à essayer absolument, qui offrent des résultats exceptionnels grâce à des tests en conditions réelles et à un classement rigoureux. Ces solutions de pointe aident les créatifs à booster considérablement leur productivité en accélérant la création de contenu et en ouvrant la voie à des possibilités créatives infinies. Découvrez-les dès maintenant pour trouver l'outil qui vous convient le mieux et commencez à créer dès aujourd'hui !
9 outils
xix.ai












