


 Heim
Alis Black Tech: 0,6-Milliarden-Modell auf 17 Milliarden MoE mit 5 % aktiven Parametern aufgerüstet, läuft auf der CPU mit 30 Token pro Sekunde
Das Team von Ali International Digital Commerce hat „Marco-Mini-Instruct“ vorgestellt, das neueste Mitglied der Marco-MoE-Reihe, und damit gezeigt, wie „kleinere Maßstäbe große Ergebnisse liefern können“. Von insgesamt 17,3 Milliarden Parametern sind nur 0,86 Milliarden aktiv (etwa 5 %), was eine außergewöhnliche Inferenzgeschwindigkeit ermöglicht, sodass das Modell sogar auf Standard-CPUs reibungslos läuft.
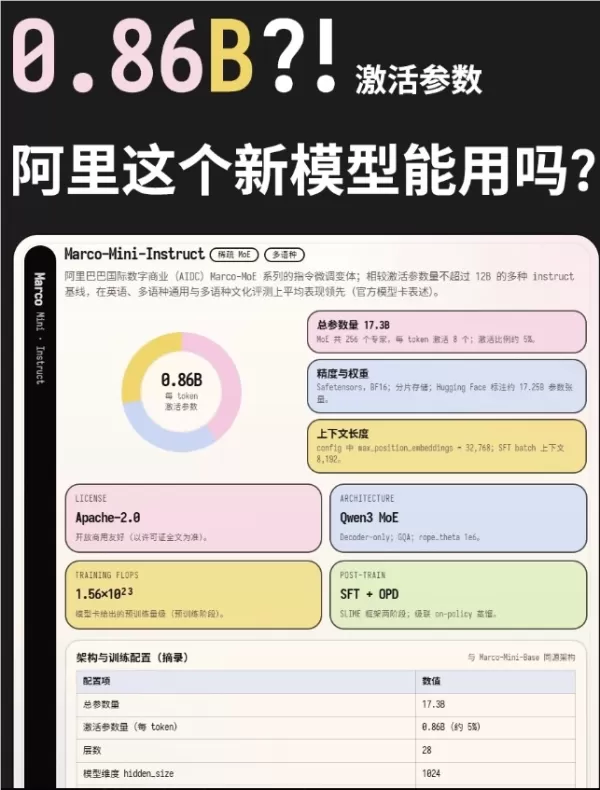
Ultraleicht: Optimiert für CPU-Leistung
Offiziellen Angaben zufolge erreicht das Modell bei Verwendung einer 8-Bit-Quantisierung mit vier DDR4-2400-Speichermodulen eine Inferenzgeschwindigkeit von etwa 30 Tokens pro Sekunde. Diese Effizienz bringt die Mixture-of-Experts (MoE)-Architektur näher an die allgemeine Nutzbarkeit heran und senkt die Hürden für den lokalen Einsatz erheblich.
Wichtige Innovation: Upcycling-Technologie verwandelt Potenzial
Das herausragende Merkmal von Marco-Mini-Instruct ist nicht seine Größe oder Geschwindigkeit, sondern seine einzigartige Entstehungsweise. Anstatt von Grund auf trainiert zu werden, wurde dieses Modell mithilfe von Upcycling-Technologie aus dem Qwen3-0.6B-Base-Modell weiterentwickelt.
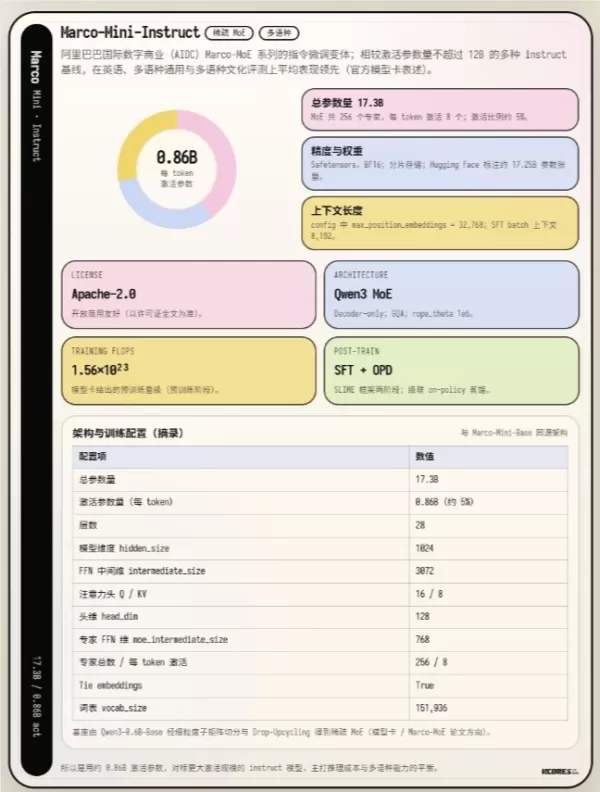
Dieser Prozess umfasst das Aufteilen oder Kopieren von Komponenten eines dichten kleinen Modells in mehrere Experten sowie die Einführung eines Routing-Mechanismus. Zudem integriert er eine feinkörnige Submatrix-Partitionierung und „Drop-Upcycling“-Strategien – das zufällige Verwerfen bestimmter Experten oder Routing-Pfade während des Trainings, um Regularisierung hinzuzufügen und die Robustheit zu verbessern. Dieser Ansatz wandelt ein reines Dense-Modell erfolgreich in eine MoE-Architektur um und bietet der Branche einen neuen, kostengünstigen und effizienten Weg für das MoE-Training.
Kontextlänge und Trainingskonfiguration
Die Modellkonfiguration erweitert „max_position_embeddings“ auf 32K, wobei die Phase des überwachten Feinabstimmens (Supervised Fine-Tuning, SFT) einen Kontext von 8192 Token nutzt. Folglich ist die Standard-Kontextlänge für die meisten praktischen Anwendungsszenarien gut geeignet.
Durchbruch nach dem Training: Kaskadierte On-Policy-Distillation
Die Phase nach dem Training ist ebenso beeindruckend: Sie beginnt mit einem SFT-Preheating, gefolgt von einer kaskadierten On-Policy-Distillation -Strategie. Zunächst nutzt die Destillation „Qwen3-30B-A3B-Instruct“ als Lehrmodell und wechselt anschließend zum leistungsstärkeren „Qwen3-Next-80B-A3B-Instruct“. Die Distillationsdaten umfassen das Befolgen von Anweisungen, komplexes logisches Denken, Sicherheitsausrichtung und mathematische Fähigkeiten, wodurch sichergestellt wird, dass das Modell seine Effizienz beibehält und gleichzeitig die allgemeine Intelligenz deutlich gesteigert wird.
Benchmark-Ergebnisse: 0,86 Mrd. aktive Parameter schlagen 4 Mrd. dichte Modelle
Das endgültige „Marco-Mini-Instruct“-Modell übertrifft in den meisten gängigen Benchmarks viele dichte Modelle wie beispielsweise „Qwen3-4B“. Mit nur 0,86 Milliarden aktiven Parametern bestätigt es eindrucksvoll das enorme Potenzial der MoE-Architektur, „kleine, aber leistungsstarke“ Ergebnisse zu liefern.
Auswirkungen auf die Branche: Ein neues Open-Source-Paradigma für das MoE-Training
AIbase ist der Ansicht, dass der größte Wert dieser Errungenschaft darin liegt, Entwicklern neue Möglichkeiten zu eröffnen. Es ist nicht mehr notwendig, groß angelegte MoE-Modelle von Grund auf neu zu trainieren; stattdessen können Teams ein geeignetes kleines Dense-Modell auswählen und die in der Veröffentlichung beschriebenen Upcycling- und Drop-Upcycling-Prozesse genau nachbilden. Der gesamte Trainingsaufwand bleibt überschaubar: Die SFT-Phase erfordert 64 GPUs für 24 Stunden, und die Destillationsphase benötigt 64 GPUs für 110 Stunden, was die Hürde für kleine und mittelgroße Teams, mit MoE zu experimentieren, erheblich senkt.
Alibabas neueste „Modifikation“ beweist einmal mehr, dass Durchbrüche bei der Modelleffizienz nicht zwangsläufig auf der Stapelung von Parametern beruhen; auch innovative Trainingsparadigmen können qualitative Sprünge bewirken. Die Veröffentlichung von Marco-Mini-Instruct wird zweifellos die Einführung der MoE-Technologie in Edge-Geräten und in persönlichen Entwickler-Szenarien beschleunigen und ist damit eine wichtige Entwicklung, die die gesamte Branche im Auge behalten sollte.
Verwandter Artikel
 DeepMind-CEO Hassabis: Ich schlafe sechs Stunden pro Tag und fühle mich normalerweise gegen 1 Uhr nachts energiegeladen.
Fortune hat kürzlich ein Interview mit Demis Hassabis, dem CEO von Google DeepMind, veröffentlicht, das seinen unkonventionellen Ansatz zu Erholung und Produktivität offenbart. Hassabis gab bekannt, dass er sehr wenig schläft und seine wachen Stunden
OpenAI und Anthropic kämpfen trotz Umsatzrückgängen um Marktanteile
Obwohl jüngste Berichte darauf hindeuten, dass OpenAI seine Umsatzziele verfehlt hat, was an diesem Dienstag Druck auf die Technologieaktien ausübte, zeigen sich private Investoren in KI-Labore weiter
Einhaltung der Vorschriften für autonome Fahrzeuge in Kalifornien: Eine neue Ära von Bußgeldern, Geofences und 1 Million Meilen
Guident betreibt einen AuveTech-Shuttle in Südflorida und verwaltet mithilfe seiner Fernüberwachungstechnologie eine vier Meilen lange Strecke in West Palm Beach sowie eine eine Meile lange Strecke in
Empfehlungen zu verwandten Spezialthemen
Chatbot
 Die besten KI-Rollenspiel-Chat-Apps für Sprachpraxis, Vorstellungsgesprächsvorbereitung und tägliche Sprechflüssigkeit
2026 Neueste Besten Top-bewerteten KI-Rollenspiel-Chat-Apps für Sprachpraxis, Vorstellungsgesprächsvorbereitung und tägliche Sprachflüssigkeit! XIX.AI kuratiert eine leistungsstarke, spielfeldverändernde Sammlung, die kostenlose gegen kostenpflichtige Vergleiche, reale Tests und wöchentlich aktualisierte Rankings bietet. Diese unbedingt auszuprobierenden Tools helfen Ihnen, Ihre Schreibfähigkeiten zu verbessern, Hürden der Sprachflüssigkeit zu überwinden und die Kommunikationseffizienz in allen alltäglichen Szenarien zu steigern. Entdecken Sie jetzt Ihr perfektes Werkzeug für Ihre Sprachentwicklung!
 10 Tools
 xix.ai
Musikkomposition
KI-Tools zur Stim-Trennung für die Remix-Produktion, die Vorbereitung von Samples und Karaoke-Master
Die besten und am besten bewerteten KI-Tools zur Stem-Trennung des Jahres 2026 – speziell ausgewählt für Remix-Produktionen, die Vorbereitung von Samples und Karaoke-Masters. Diese leistungsstarken, bahnbrechenden Tools haben sich in der Praxis bewährt und bieten präzise Audioisolierung, wodurch die Produktivität erheblich gesteigert wird. XIX.AI stellt einen wöchentlich aktualisierten Vergleichsleitfaden zwischen kostenlosen und kostenpflichtigen Lösungen bereit, der Ihnen hilft, die für Ihre Anforderungen passende Lösung zu finden, die Sie unbedingt ausprobieren sollten. Entdecken Sie ihn jetzt und sichern Sie sich Ihren KI-Vorteil.
8 Tools
xix.ai
Datenanalyse
KI-basierte SQL-Copiloten für Umsatz-Dashboards, Kanalanalysen sowie Produktmetriken
2026: Die neuesten und besten AI-SQL-Copiloten – alle in der Rangliste ganz oben! XIX.AI sammelt eine leistungsstarke Auswahl an Tools, die wöchentlich mit aktualisierten Tests aus der Praxis erweitert wird. Mit diesen unverzichtbaren Werkzeugen können Sie präzise Umsatzübersichten erstellen, Verkaufsprozesse analysieren sowie Produktmetriken schnell überwachen und so Ihre Produktivität erheblich steigern. Entdecken Sie jetzt das perfekte Tool für datenbasierte Entscheidungsfindung! 238 Zeichen
9 Tools
xix.ai
Musikkomposition
Die besten KI-Tools zum Komponieren von Melodien für Songentwürfe
2026 Neueste Besten Top-Bewerteten KI-Melodie-Schreibtools für Songentwürfe! XIX.AI hat eine hochleistungsfähige, bahnbrechende Kollektion zusammengestellt, die strengen Praxistests unterzogen wurde, um das beste Schreiberlebnis zu liefern. Sie finden detaillierte kostenlose versus kostenpflichtige Vergleiche, präzise Ranglisten und unbedingt auszuprobierende Optionen, die darauf ausgelegt sind, Ihnen zu helfen, beeindruckende Songentwürfe mühelos zu erstellen und Ihre kreative Produktivität erheblich zu steigern. Entdecken Sie jetzt Ihr perfektes Tool!
8 Tools
xix.ai
Chatbot
Die besten KI-gestützten Gesprächstrainingstools für Vorstellungsgesprächspraxis
2026 Neueste Besten Top-bewerteten KI-Konversationstrainer-Tools für Vorstellungsgesprächspraxis sind hier auf XIX.AI! Diese kuratierte Sammlung enthält leistungsstarke, bahnbrechende Tools, die strengen Praxistests unterzogen wurden, um präzises Feedback zu liefern. Sie finden einen Vergleich zwischen kostenlosen und kostenpflichtigen Optionen sowie detaillierte Rankings, die Ihnen helfen, die empfehlenswerte Option zu wählen, die Ihr Selbstvertrauen und Ihre Fähigkeiten verbessert. Entdecken Sie jetzt Ihr perfektes Tool für den Erfolg im Vorstellungsgespräch!
12 Tools
xix.ai
Design & Kunst
Die besten KI-Tools für den Stiltransfer für kreative Experimente
Die besten und am besten bewerteten KI-Tools für den Stiltransfer im Jahr 2026 – ideal für kreative Experimente! XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung unverzichtbarer Tools zusammengestellt, die in Praxistests und strengen Bewertungen außergewöhnliche Ergebnisse liefern. Diese Top-Lösungen helfen Kreativen dabei, ihre Produktivität deutlich zu steigern, indem sie die Erstellung von Inhalten beschleunigen und unendliche kreative Möglichkeiten eröffnen. Entdecken Sie jetzt Ihr perfektes Tool und legen Sie noch heute los!
9 Tools
xix.ai

 Kommentare (0)
Das Team von Ali International Digital Commerce hat „Marco-Mini-Instruct“ vorgestellt, das neueste Mitglied der Marco-MoE-Reihe, und damit gezeigt, wie „kleinere Maßstäbe große Ergebnisse liefern können“. Von insgesamt 17,3 Milliarden Parametern sind nur 0,86 Milliarden aktiv (etwa 5 %), was eine außergewöhnliche Inferenzgeschwindigkeit ermöglicht, sodass das Modell sogar auf Standard-CPUs reibungslos läuft.
Ultraleicht: Optimiert für CPU-Leistung
Offiziellen Angaben zufolge erreicht das Modell bei Verwendung einer 8-Bit-Quantisierung mit vier DDR4-2400-Speichermodulen eine Inferenzgeschwindigkeit von etwa 30 Tokens pro Sekunde. Diese Effizienz bringt die Mixture-of-Experts (MoE)-Architektur näher an die allgemeine Nutzbarkeit heran und senkt die Hürden für den lokalen Einsatz erheblich.
Wichtige Innovation: Upcycling-Technologie verwandelt Potenzial
Das herausragende Merkmal von Marco-Mini-Instruct ist nicht seine Größe oder Geschwindigkeit, sondern seine einzigartige Entstehungsweise. Anstatt von Grund auf trainiert zu werden, wurde dieses Modell mithilfe von Upcycling-Technologie aus dem Qwen3-0.6B-Base-Modell weiterentwickelt.
Dieser Prozess umfasst das Aufteilen oder Kopieren von Komponenten eines dichten kleinen Modells in mehrere Experten sowie die Einführung eines Routing-Mechanismus. Zudem integriert er eine feinkörnige Submatrix-Partitionierung und „Drop-Upcycling“-Strategien – das zufällige Verwerfen bestimmter Experten oder Routing-Pfade während des Trainings, um Regularisierung hinzuzufügen und die Robustheit zu verbessern. Dieser Ansatz wandelt ein reines Dense-Modell erfolgreich in eine MoE-Architektur um und bietet der Branche einen neuen, kostengünstigen und effizienten Weg für das MoE-Training.
Kontextlänge und Trainingskonfiguration
Die Modellkonfiguration erweitert „max_position_embeddings“ auf 32K, wobei die Phase des überwachten Feinabstimmens (Supervised Fine-Tuning, SFT) einen Kontext von 8192 Token nutzt. Folglich ist die Standard-Kontextlänge für die meisten praktischen Anwendungsszenarien gut geeignet.
Durchbruch nach dem Training: Kaskadierte On-Policy-Distillation
Die Phase nach dem Training ist ebenso beeindruckend: Sie beginnt mit einem SFT-Preheating, gefolgt von einer kaskadierten On-Policy-Distillation -Strategie. Zunächst nutzt die Destillation „Qwen3-30B-A3B-Instruct“ als Lehrmodell und wechselt anschließend zum leistungsstärkeren „Qwen3-Next-80B-A3B-Instruct“. Die Distillationsdaten umfassen das Befolgen von Anweisungen, komplexes logisches Denken, Sicherheitsausrichtung und mathematische Fähigkeiten, wodurch sichergestellt wird, dass das Modell seine Effizienz beibehält und gleichzeitig die allgemeine Intelligenz deutlich gesteigert wird.
Benchmark-Ergebnisse: 0,86 Mrd. aktive Parameter schlagen 4 Mrd. dichte Modelle
Das endgültige „Marco-Mini-Instruct“-Modell übertrifft in den meisten gängigen Benchmarks viele dichte Modelle wie beispielsweise „Qwen3-4B“. Mit nur 0,86 Milliarden aktiven Parametern bestätigt es eindrucksvoll das enorme Potenzial der MoE-Architektur, „kleine, aber leistungsstarke“ Ergebnisse zu liefern.
Auswirkungen auf die Branche: Ein neues Open-Source-Paradigma für das MoE-Training
AIbase ist der Ansicht, dass der größte Wert dieser Errungenschaft darin liegt, Entwicklern neue Möglichkeiten zu eröffnen. Es ist nicht mehr notwendig, groß angelegte MoE-Modelle von Grund auf neu zu trainieren; stattdessen können Teams ein geeignetes kleines Dense-Modell auswählen und die in der Veröffentlichung beschriebenen Upcycling- und Drop-Upcycling-Prozesse genau nachbilden. Der gesamte Trainingsaufwand bleibt überschaubar: Die SFT-Phase erfordert 64 GPUs für 24 Stunden, und die Destillationsphase benötigt 64 GPUs für 110 Stunden, was die Hürde für kleine und mittelgroße Teams, mit MoE zu experimentieren, erheblich senkt.
Alibabas neueste „Modifikation“ beweist einmal mehr, dass Durchbrüche bei der Modelleffizienz nicht zwangsläufig auf der Stapelung von Parametern beruhen; auch innovative Trainingsparadigmen können qualitative Sprünge bewirken. Die Veröffentlichung von Marco-Mini-Instruct wird zweifellos die Einführung der MoE-Technologie in Edge-Geräten und in persönlichen Entwickler-Szenarien beschleunigen und ist damit eine wichtige Entwicklung, die die gesamte Branche im Auge behalten sollte.








 DeepMind-CEO Hassabis: Ich schlafe sechs Stunden pro Tag und fühle mich normalerweise gegen 1 Uhr nachts energiegeladen.
Fortune hat kürzlich ein Interview mit Demis Hassabis, dem CEO von Google DeepMind, veröffentlicht, das seinen unkonventionellen Ansatz zu Erholung und Produktivität offenbart. Hassabis gab bekannt, dass er sehr wenig schläft und seine wachen Stunden
 OpenAI und Anthropic kämpfen trotz Umsatzrückgängen um Marktanteile
Obwohl jüngste Berichte darauf hindeuten, dass OpenAI seine Umsatzziele verfehlt hat, was an diesem Dienstag Druck auf die Technologieaktien ausübte, zeigen sich private Investoren in KI-Labore weiter
Einhaltung der Vorschriften für autonome Fahrzeuge in Kalifornien: Eine neue Ära von Bußgeldern, Geofences und 1 Million Meilen
Guident betreibt einen AuveTech-Shuttle in Südflorida und verwaltet mithilfe seiner Fernüberwachungstechnologie eine vier Meilen lange Strecke in West Palm Beach sowie eine eine Meile lange Strecke in

2026 Neueste Besten Top-bewerteten KI-Rollenspiel-Chat-Apps für Sprachpraxis, Vorstellungsgesprächsvorbereitung und tägliche Sprachflüssigkeit! XIX.AI kuratiert eine leistungsstarke, spielfeldverändernde Sammlung, die kostenlose gegen kostenpflichtige Vergleiche, reale Tests und wöchentlich aktualisierte Rankings bietet. Diese unbedingt auszuprobierenden Tools helfen Ihnen, Ihre Schreibfähigkeiten zu verbessern, Hürden der Sprachflüssigkeit zu überwinden und die Kommunikationseffizienz in allen alltäglichen Szenarien zu steigern. Entdecken Sie jetzt Ihr perfektes Werkzeug für Ihre Sprachentwicklung!
10 Tools
xix.ai

Die besten und am besten bewerteten KI-Tools zur Stem-Trennung des Jahres 2026 – speziell ausgewählt für Remix-Produktionen, die Vorbereitung von Samples und Karaoke-Masters. Diese leistungsstarken, bahnbrechenden Tools haben sich in der Praxis bewährt und bieten präzise Audioisolierung, wodurch die Produktivität erheblich gesteigert wird. XIX.AI stellt einen wöchentlich aktualisierten Vergleichsleitfaden zwischen kostenlosen und kostenpflichtigen Lösungen bereit, der Ihnen hilft, die für Ihre Anforderungen passende Lösung zu finden, die Sie unbedingt ausprobieren sollten. Entdecken Sie ihn jetzt und sichern Sie sich Ihren KI-Vorteil.
8 Tools
xix.ai

2026: Die neuesten und besten AI-SQL-Copiloten – alle in der Rangliste ganz oben! XIX.AI sammelt eine leistungsstarke Auswahl an Tools, die wöchentlich mit aktualisierten Tests aus der Praxis erweitert wird. Mit diesen unverzichtbaren Werkzeugen können Sie präzise Umsatzübersichten erstellen, Verkaufsprozesse analysieren sowie Produktmetriken schnell überwachen und so Ihre Produktivität erheblich steigern. Entdecken Sie jetzt das perfekte Tool für datenbasierte Entscheidungsfindung! 238 Zeichen
9 Tools
xix.ai

2026 Neueste Besten Top-Bewerteten KI-Melodie-Schreibtools für Songentwürfe! XIX.AI hat eine hochleistungsfähige, bahnbrechende Kollektion zusammengestellt, die strengen Praxistests unterzogen wurde, um das beste Schreiberlebnis zu liefern. Sie finden detaillierte kostenlose versus kostenpflichtige Vergleiche, präzise Ranglisten und unbedingt auszuprobierende Optionen, die darauf ausgelegt sind, Ihnen zu helfen, beeindruckende Songentwürfe mühelos zu erstellen und Ihre kreative Produktivität erheblich zu steigern. Entdecken Sie jetzt Ihr perfektes Tool!
8 Tools
xix.ai

2026 Neueste Besten Top-bewerteten KI-Konversationstrainer-Tools für Vorstellungsgesprächspraxis sind hier auf XIX.AI! Diese kuratierte Sammlung enthält leistungsstarke, bahnbrechende Tools, die strengen Praxistests unterzogen wurden, um präzises Feedback zu liefern. Sie finden einen Vergleich zwischen kostenlosen und kostenpflichtigen Optionen sowie detaillierte Rankings, die Ihnen helfen, die empfehlenswerte Option zu wählen, die Ihr Selbstvertrauen und Ihre Fähigkeiten verbessert. Entdecken Sie jetzt Ihr perfektes Tool für den Erfolg im Vorstellungsgespräch!
12 Tools
xix.ai

Die besten und am besten bewerteten KI-Tools für den Stiltransfer im Jahr 2026 – ideal für kreative Experimente! XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung unverzichtbarer Tools zusammengestellt, die in Praxistests und strengen Bewertungen außergewöhnliche Ergebnisse liefern. Diese Top-Lösungen helfen Kreativen dabei, ihre Produktivität deutlich zu steigern, indem sie die Erstellung von Inhalten beschleunigen und unendliche kreative Möglichkeiten eröffnen. Entdecken Sie jetzt Ihr perfektes Tool und legen Sie noch heute los!
9 Tools
xix.ai












