


 Heim
WeChat WeMM-Embedding ermöglicht die Suche in Moments und hebt Videos mit einer Milliarde täglichen Aufrufen hervor
Am 4. September kündigte WeChat AI die Open-Source-Veröffentlichung seines allgemeinen multimodalen Einbettungsmodells WeMM-Embedding an. Das Modell ist in den Versionen 2B, 4B und 9B verfügbar und unterstützt Text, Bilder, Videos, visuelle Dokumente sowie beliebige verschachtelte multimodale Eingaben.
Laut WeChat-Mitarbeiter @KeCunXiaoJiang ermöglicht das von der WeChat Visual Team open-sourcede multimodale Modell WeMM-Embedding dem System, Text, Bilder und Videos gleichzeitig zu verstehen, indem es sie in einen gemeinsamen semantischen Raum einordnet, um sie zu vergleichen und abzurufen.
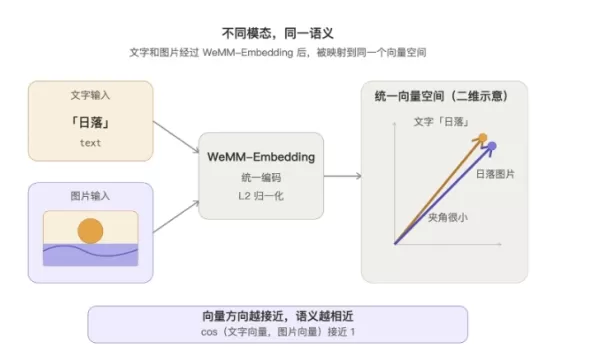
Bereits in Szenarien wie der Suche in Moments und der Videoempfehlung eingesetzt
Er enthüllte, dass dieses Modell innerhalb von WeChat weit verbreitet ist – die Suche in Moments, die Videoempfehlung, die Empfehlung von öffentlichen Konten und der WeChat-E-Commerce nutzen es alle, mit einer täglichen Aufrufzahl von einer Milliarde Mal. Auf dem internationalen Autoritätsbenchmark MMEB-v2 belegte das Modell den ersten Platz und übertraf alle zuvor eingereichten Open-Source- und Closed-Source-Modelle.
Derzeit sind die damit verbundenen Ressourcen von WeMM-Embedding verfügbar: Das Papier wurde auf arXiv veröffentlicht, das Code-Repository wird unter dem Projekt Tencent/WeMM-Embedding auf GitHub gehostet, und der Modellsatz ist ebenfalls auf Hugging Face verfügbar.
Verwandter Artikel
 Xiaohongshu, die Peking-Universität und die Shanghai Jiao Tong University stellen HYPIC vor, um die Latenzzeit des ersten Tokens in hybriden Aufmerksamkeitsmodellen um das 3,25-Fache zu reduzieren.
Der Hauptfokus von Large-Model-Diensten verschiebt sich von einseitigen Gesprächen hin zu abfrageergänzter Fragebeantwortung (Retrieval-Augmented Question Answering), der Zusammenfassung mehrerer Dokumente und langreichweitigen Agenten. Diese neuarti
ChatGPT stellt benutzerdefinierte Sticker vor, die nahtlos mit den führenden Social-Media-Plattformen kompatibel sind
OpenAI hat offiziell eine neue Funktion für benutzerdefinierte Aufkleber für ChatGPT eingeführt und damit die Grenzen der KI in der massenhaften Erstellung sozialer Inhalte erweitert.Nutzer können personalisierte Aufkleber durch intuitive Methoden er
Anthropic führt unauffällige Graustufen-Tests für Claude Opus 5.2 und das interne Modell 2 ein
Anthropes neuestes Flaggschiff-Modell, Opus 5.2, ist heute Morgen still in die frühen Testphasen innerhalb von Claude Code eingetreten. Entwickler haben eine deutliche Leistungsdivergenz zwischen den API-Aufrufen und der Webschnittstelle festgestellt
Empfehlungen zu verwandten Spezialthemen
Design & Kunst
 Die besten KI-Illustrationstools: Redaktionelle Szenen und Cover-Grafiken schneller erstellen
Die besten und am besten bewerteten KI-Illustrationstools 2026: Unsere sorgfältig zusammengestellte Liste enthält die leistungsstärksten Tools, mit denen Sie im Handumdrehen atemberaubende redaktionelle Szenen und auffällige Cover-Grafiken erstellen können. Jede Option wurde strengen Praxistests unterzogen und wird im Vergleich zwischen kostenlosen und kostenpflichtigen Versionen vorgestellt, damit Sie die perfekte Lösung für Ihren Arbeitsablauf finden können. Probieren Sie diese unverzichtbaren Lösungen noch heute aus, um Ihren KI-Vorteil zu nutzen und Ihre kreative Produktivität zu steigern. Entdecken Sie sie jetzt auf XIX.AI.
 10 Tools
 xix.ai
Bildung und Lernen
Die besten KI-Nachhilfelehrer für die Prüfungsvorbereitung: Üben Sie Mathematik, Naturwissenschaften und Englisch
Die besten und am besten bewerteten KI-Nachhilfetools für die Prüfungsvorbereitung des Jahres 2026 finden Sie hier auf XIX.AI! Unsere sorgfältig zusammengestellte Liste enthält leistungsstarke, bahnbrechende Tools, die einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, Tests aus der Praxis sowie wöchentlich aktualisierte Rankings bieten. Sie helfen Ihnen dabei, Ihre Schreibeffizienz zu steigern, das Erlernen komplexer Themen zu vereinfachen und Ihr akademisches Potenzial voll auszuschöpfen. Entdecken Sie jetzt Ihr perfektes Tool zur Prüfungsvorbereitung und legen Sie noch heute los, um Ihren KI-Vorteil zu nutzen!
10 Tools
xix.ai
Finanzen
KI-Budgetplanungstools für das persönliche Geldmanagement
2026 Neueste Besten Top-Bewertete KI-Budgetplanungs-Tools für persönliches Geldmanagement sind hier auf XIX.AI! Diese kuratierte Sammlung bietet leistungsstarke, revolutionäre Lösungen, die Ihnen helfen, reale Tests durchzuführen, Ausgaben Gewohnheiten zu verstehen und personalisierte Pläne zu erstellen, um die Produktivität zu steigern. Genießen Sie einen kostenlosen vs. bezahlten Vergleich sowie detaillierte Rankings. Unbedingt auszuprobierende Tools, die darauf ausgelegt sind, das Geldmanagement zu vereinfachen und Ihre KI-Vorteile freizuschalten. Entdecken Sie jetzt!
11 Tools
xix.ai
Gesundheit Wellness
KI-gestützte Schlafüberwachungsassistenten: Verbessern Sie Ihre Erholung durch bessere Gewohnheiten vor dem Schlafengehen
2026 – Die neuesten, besten und am höchsten bewerteten AI-Geräte zur Schlafüberwachung, sorgfältig ausgewählt für eine optimale Erholung. Dieser vollständig aktualisierte wöchentliche Leitfaden präsentiert leistungsstarke Tools mit praktischen Tests, einem Vergleich von kostenlosen und kostenpflichtigen Optionen sowie detaillierten Ranglisten, um Ihnen die beste Lösung zu zeigen, die die Schlafqualität verbessert und bessere Gewohnheiten zum Zubettgehen fördert. Entdecken Sie ihn jetzt auf XIX.AI, um Ihren Vorteil durch KI zu nutzen.
10 Tools
xix.ai
Datenanalyse
KI-gestützte SQL-Copilots für Produkt- und Umsatzanalysen
Die besten und am besten bewerteten KI-SQL-Copilots für Produkt- und Umsatzanalysen im Jahr 2026! XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung unverzichtbarer Tools zusammengestellt, die anhand wöchentlich aktualisierter Rankings in der Praxis getestet werden. Diese Tools helfen Anwendern dabei, ihre Produktivität erheblich zu steigern, indem sie die Datenanalyse beschleunigen, komplexe Abfragen optimieren und präzise Erkenntnisse liefern, um intelligentere Geschäftsentscheidungen zu ermöglichen. Entdecken Sie jetzt das perfekte Tool, um Ihren KI-Vorteil voll auszuschöpfen!
14 Tools
xix.ai
Bildung und Lernen
Die besten KI-Hausaufgabenhelfer, die wirklich etwas vermitteln: Lerne Konzepte, nicht nur Antworten
2026: Die aktuell besten und am besten bewerteten KI-Hausaufgabenhelfer, die nicht nur Antworten liefern, sondern auch Kernkonzepte vermitteln – leistungsstarke Tools für Schüler und Studenten. Eine kuratierte Liste, die Sie unbedingt ausprobieren sollten. Wöchentlich aktualisiert. Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten. Praxistests. Genaue Rankings, die Ihnen helfen, Ihr volles Lernpotenzial auszuschöpfen. Entdecken Sie jetzt das perfekte Tool für intelligenteres Lernen.
10 Tools
xix.ai

 Kommentare (0)
Am 4. September kündigte WeChat AI die Open-Source-Veröffentlichung seines allgemeinen multimodalen Einbettungsmodells WeMM-Embedding an. Das Modell ist in den Versionen 2B, 4B und 9B verfügbar und unterstützt Text, Bilder, Videos, visuelle Dokumente sowie beliebige verschachtelte multimodale Eingaben.
Laut WeChat-Mitarbeiter @KeCunXiaoJiang ermöglicht das von der WeChat Visual Team open-sourcede multimodale Modell WeMM-Embedding dem System, Text, Bilder und Videos gleichzeitig zu verstehen, indem es sie in einen gemeinsamen semantischen Raum einordnet, um sie zu vergleichen und abzurufen.
Bereits in Szenarien wie der Suche in Moments und der Videoempfehlung eingesetzt
Er enthüllte, dass dieses Modell innerhalb von WeChat weit verbreitet ist – die Suche in Moments, die Videoempfehlung, die Empfehlung von öffentlichen Konten und der WeChat-E-Commerce nutzen es alle, mit einer täglichen Aufrufzahl von einer Milliarde Mal. Auf dem internationalen Autoritätsbenchmark MMEB-v2 belegte das Modell den ersten Platz und übertraf alle zuvor eingereichten Open-Source- und Closed-Source-Modelle.
Derzeit sind die damit verbundenen Ressourcen von WeMM-Embedding verfügbar: Das Papier wurde auf arXiv veröffentlicht, das Code-Repository wird unter dem Projekt Tencent/WeMM-Embedding auf GitHub gehostet, und der Modellsatz ist ebenfalls auf Hugging Face verfügbar.








 Xiaohongshu, die Peking-Universität und die Shanghai Jiao Tong University stellen HYPIC vor, um die Latenzzeit des ersten Tokens in hybriden Aufmerksamkeitsmodellen um das 3,25-Fache zu reduzieren.
Der Hauptfokus von Large-Model-Diensten verschiebt sich von einseitigen Gesprächen hin zu abfrageergänzter Fragebeantwortung (Retrieval-Augmented Question Answering), der Zusammenfassung mehrerer Dokumente und langreichweitigen Agenten. Diese neuarti
 ChatGPT stellt benutzerdefinierte Sticker vor, die nahtlos mit den führenden Social-Media-Plattformen kompatibel sind
OpenAI hat offiziell eine neue Funktion für benutzerdefinierte Aufkleber für ChatGPT eingeführt und damit die Grenzen der KI in der massenhaften Erstellung sozialer Inhalte erweitert.Nutzer können personalisierte Aufkleber durch intuitive Methoden er
 Anthropic führt unauffällige Graustufen-Tests für Claude Opus 5.2 und das interne Modell 2 ein
Anthropes neuestes Flaggschiff-Modell, Opus 5.2, ist heute Morgen still in die frühen Testphasen innerhalb von Claude Code eingetreten. Entwickler haben eine deutliche Leistungsdivergenz zwischen den API-Aufrufen und der Webschnittstelle festgestellt

Die besten und am besten bewerteten KI-Illustrationstools 2026: Unsere sorgfältig zusammengestellte Liste enthält die leistungsstärksten Tools, mit denen Sie im Handumdrehen atemberaubende redaktionelle Szenen und auffällige Cover-Grafiken erstellen können. Jede Option wurde strengen Praxistests unterzogen und wird im Vergleich zwischen kostenlosen und kostenpflichtigen Versionen vorgestellt, damit Sie die perfekte Lösung für Ihren Arbeitsablauf finden können. Probieren Sie diese unverzichtbaren Lösungen noch heute aus, um Ihren KI-Vorteil zu nutzen und Ihre kreative Produktivität zu steigern. Entdecken Sie sie jetzt auf XIX.AI.
10 Tools
xix.ai

Die besten und am besten bewerteten KI-Nachhilfetools für die Prüfungsvorbereitung des Jahres 2026 finden Sie hier auf XIX.AI! Unsere sorgfältig zusammengestellte Liste enthält leistungsstarke, bahnbrechende Tools, die einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, Tests aus der Praxis sowie wöchentlich aktualisierte Rankings bieten. Sie helfen Ihnen dabei, Ihre Schreibeffizienz zu steigern, das Erlernen komplexer Themen zu vereinfachen und Ihr akademisches Potenzial voll auszuschöpfen. Entdecken Sie jetzt Ihr perfektes Tool zur Prüfungsvorbereitung und legen Sie noch heute los, um Ihren KI-Vorteil zu nutzen!
10 Tools
xix.ai

2026 Neueste Besten Top-Bewertete KI-Budgetplanungs-Tools für persönliches Geldmanagement sind hier auf XIX.AI! Diese kuratierte Sammlung bietet leistungsstarke, revolutionäre Lösungen, die Ihnen helfen, reale Tests durchzuführen, Ausgaben Gewohnheiten zu verstehen und personalisierte Pläne zu erstellen, um die Produktivität zu steigern. Genießen Sie einen kostenlosen vs. bezahlten Vergleich sowie detaillierte Rankings. Unbedingt auszuprobierende Tools, die darauf ausgelegt sind, das Geldmanagement zu vereinfachen und Ihre KI-Vorteile freizuschalten. Entdecken Sie jetzt!
11 Tools
xix.ai

2026 – Die neuesten, besten und am höchsten bewerteten AI-Geräte zur Schlafüberwachung, sorgfältig ausgewählt für eine optimale Erholung. Dieser vollständig aktualisierte wöchentliche Leitfaden präsentiert leistungsstarke Tools mit praktischen Tests, einem Vergleich von kostenlosen und kostenpflichtigen Optionen sowie detaillierten Ranglisten, um Ihnen die beste Lösung zu zeigen, die die Schlafqualität verbessert und bessere Gewohnheiten zum Zubettgehen fördert. Entdecken Sie ihn jetzt auf XIX.AI, um Ihren Vorteil durch KI zu nutzen.
10 Tools
xix.ai

Die besten und am besten bewerteten KI-SQL-Copilots für Produkt- und Umsatzanalysen im Jahr 2026! XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung unverzichtbarer Tools zusammengestellt, die anhand wöchentlich aktualisierter Rankings in der Praxis getestet werden. Diese Tools helfen Anwendern dabei, ihre Produktivität erheblich zu steigern, indem sie die Datenanalyse beschleunigen, komplexe Abfragen optimieren und präzise Erkenntnisse liefern, um intelligentere Geschäftsentscheidungen zu ermöglichen. Entdecken Sie jetzt das perfekte Tool, um Ihren KI-Vorteil voll auszuschöpfen!
14 Tools
xix.ai

2026: Die aktuell besten und am besten bewerteten KI-Hausaufgabenhelfer, die nicht nur Antworten liefern, sondern auch Kernkonzepte vermitteln – leistungsstarke Tools für Schüler und Studenten. Eine kuratierte Liste, die Sie unbedingt ausprobieren sollten. Wöchentlich aktualisiert. Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten. Praxistests. Genaue Rankings, die Ihnen helfen, Ihr volles Lernpotenzial auszuschöpfen. Entdecken Sie jetzt das perfekte Tool für intelligenteres Lernen.
10 Tools
xix.ai












