


 Heim
Wie funktionieren Convolutional Neural Networks (CNNs) im Jahr 2025? Ein vollständiger visueller Leitfaden.
Faltungsneuronale Netze (Convolutional Neural Networks, CNNs) haben die Computer Vision verändert und ermöglichen es Maschinen, Bilder mit unglaublicher Präzision zu interpretieren. In diesem detaillierten Handbuch wird die Funktionsweise von CNNs untersucht, wobei Kernel, Faltungsschichten und die Art und Weise, wie diese Systeme Schlussfolgerungen ziehen, erläutert werden. Anhand von praktischen Beispielen und Visualisierungstools werden die Möglichkeiten dieser grundlegenden Technologie aufgezeigt, von der Analyse von Bildern bis hin zur Codierung von Implementierungen.
Wichtige Punkte
CNNs bewahren die zweidimensionale Struktur von Bildern mithilfe von Kerneln.
Kernel fungieren als Filter, die bestimmte Bildmerkmale identifizieren.
Faltungsschichten wenden diese Filter auf Bilder an, um Merkmalskarten zu erstellen.
Mehrere Faltungsschichten werden kombiniert, um komplexe visuelle Muster zu erkennen.
Pooling-Schichten rationalisieren die Merkmalskarten, indem sie ihre Abmessungen reduzieren.
CNN Explainer bietet eine visuelle Demonstration der Funktionsweise dieser Netzwerke.
Keras, das in TensorFlow integriert ist, vereinfacht den Prozess der Kodierung von CNN-Schichten.
Die Verflachung bereitet die Daten für dichte Schichten vor, die die endgültige Klassifizierung übernehmen.
Die Anpassung der Kernelgröße wirkt sich direkt auf die Qualität der Merkmalserkennung aus.
GPUs oder TPUs beschleunigen das CNN-Training für eine bessere Leistung.
Faltungsneuronale Netze enthüllen
Was ist ein Convolutional Neural Network (CNN)?
Convolutional Neural Networks (CNNs) sind spezialisierte künstliche neuronale Netze, die für die Verarbeitung visueller Informationen entwickelt wurden. Im Gegensatz zu konventionellen Netzwerken, die Bilder als flache Pixelarrays behandeln, nutzen CNNs räumliche Beziehungen zwischen Pixeln. Diese Fähigkeit ist für die Klassifizierung von Bildern, die Erkennung von Objekten und die Segmentierung von entscheidender Bedeutung.
CNNs orientieren sich an der Funktionsweise des menschlichen visuellen Kortex. Sie setzen spezialisierte Schichten ein, um schrittweise räumliche Merkmalshierarchien zu erlernen, angefangen bei grundlegenden Elementen wie Kanten und Ecken bis hin zu erweiterten Objektdarstellungen.
Kernkomponenten von CNNs:
- Faltungsschichten: Diese grundlegenden Komponenten verwenden Kernel (oder Filter), um Merkmale in Eingabebildern zu erkennen.
- Pooling-Schichten: Diese Schichten verkleinern die Darstellungsgröße, verringern die Anzahl der Parameter und den Rechenaufwand und sorgen gleichzeitig für Translationsinvarianz.
- Aktivierungsfunktionen: Nichtlineare Funktionen wie ReLU ermöglichen es Netzwerken, komplexe Muster zu erkennen.
- Vollständig verknüpfte Schichten: Diese Schichten befinden sich am Ende des Netzes und führen eine Klassifizierung anhand der von den vorherigen Schichten gesammelten Merkmale durch.
Der Hauptvorteil von CNNs liegt im automatischen Lernen von Merkmalen aus Daten, wodurch manuelle Extraktionsprozesse überflüssig werden. Dies macht sie für verschiedene Computer-Vision-Anwendungen besonders effektiv. Ihre einzigartigen Faltungsschichten unterscheiden sie von anderen neuronalen Netztypen.
Die Wichtigkeit der Beibehaltung von 2D-Informationen
Herkömmliche neuronale Netze wandeln Bilder in der Regel in eindimensionale Pixelarrays um und opfern dabei wichtige zweidimensionale Strukturen und Nachbarschaftsbeziehungen. Stellen Sie sich vor, Sie würden versuchen, ein Gemälde zu verstehen, indem Sie nur die einzelnen Farben der Punkte kennen, ohne ihre Anordnung zu sehen - Sie würden den Kontext und die Gesamtkomposition verpassen.
CNNs beziehen ihre Stärke aus der Beibehaltung dieser 2D-Struktur. Durch den Einsatz von Kerneln, die lokalisierte Bildbereiche scannen, erfasst das Netzwerk räumliche Abhängigkeiten zwischen Pixeln. Dies gewährleistet eine genaue Identifizierung von Kanten, Ecken und Texturen unabhängig von ihrer Bildposition.
Nachteile
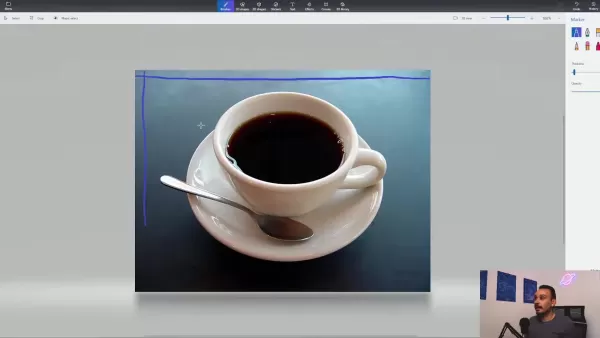
edenfalls eine Kaffeetasse. Unser Gehirn erkennt sie als Kaffeetasse, egal ob sie links oder rechts steht. CNNs ahmen diese Fähigkeit nach. Durch die Beibehaltung von 2D-Informationen sind CNNs widerstandsfähiger gegenüber Änderungen der Objektpositionierung, Skalierung und Ausrichtung. Dieses räumliche Bewusstsein verbessert die Fähigkeit des Netzwerks zur Generalisierung und zur genauen Verarbeitung unbekannter Daten erheblich.Kerne: Die Merkmalsextraktoren
Der Kernel bildet den Kern jeder Faltungsschicht - eine kompakte Gewichtsmatrix, die als Musterdetektor dient. Man kann ihn sich als eine spezielle Linse vorstellen, die sich auf bestimmte Bildmerkmale konzentriert. Jeder Kernel identifiziert bestimmte Merkmale wie Kanten, Ecken oder Texturen.
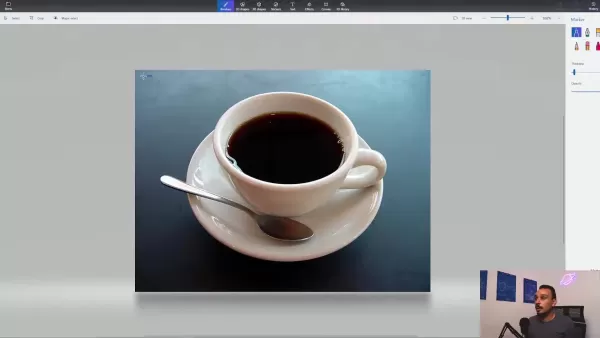
Ein Kernel ist im Grunde eine Gewichtungsmatrix. Jeder Matrixwert enthält eine Gewichtung, die mit den entsprechenden Pixeln des Eingangsbildes multipliziert wird und so die Erfassung der fotografischen 2D-Struktur zur Informationsextraktion ermöglicht.
Der Kernel durchläuft das Eingabebild und führt an jeder Stelle Faltungsoperationen aus. Während dieses Prozesses wird jedes Kernelement mit passenden Pixelwerten in lokalen Bildregionen multipliziert. Diese Produkte summieren sich zu Einzelwerten, die die Ausgangskarte mit den Merkmalen füllen.
Durch genaue Anpassung der Kernelgewichte lernt das Netzwerk, aufgabenrelevante Merkmale zu erkennen. Ein Kernel zur Erkennung horizontaler Kanten enthält beispielsweise positive Gewichte entlang einer horizontalen Linie und negative Gewichte oberhalb und unterhalb dieser Linie.
Die Kernel fungieren also als Filtermechanismen für die Informationsextraktion.
Die Faltungsschicht in Aktion
Die Faltungsschicht wendet Kernel auf das gesamte Eingabebild an. Dieser Ansatz des gleitenden Fensters in Kombination mit der Faltung ermöglicht die Erkennung von Merkmalen im gesamten Bild.
Während sich die Kernel über die Bilder bewegen, erzeugen sie Merkmalskarten, die das Vorhandensein und die Intensität der erkannten Merkmale anzeigen. Jeder Wert der Merkmalskarte entspricht einer Position im Eingabebild, wobei die Größe angibt, wie gut das Muster des Kerns mit dem lokalen Bildinhalt übereinstimmt.
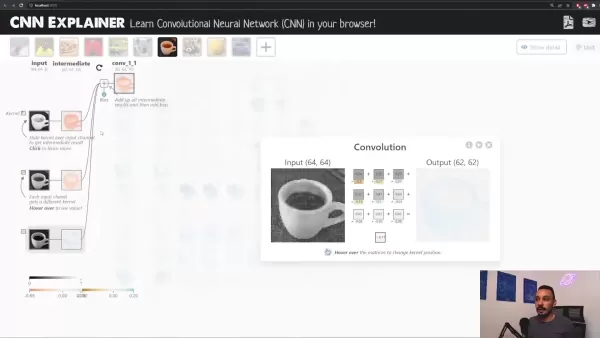
Wir positionieren unseren Kernel an der ersten Ecke des Bildes, die sechs Pixel umfasst. Die Kernel-Gewichte werden mit diesen Pixeln multipliziert, und die Summe wird zu einem einzelnen Pixel im neuen Bild. Dieser Prozess ähnelt der Anwendung von Bildfiltern.
Verschiedene Kernel innerhalb der gleichen Faltungsschicht erkennen unterschiedliche Merkmale. Diese Merkmale ergeben zusammen eine umfassende Bilddarstellung. Durch die Anwendung mehrerer Kernel zur Erzeugung verschiedener Merkmalskarten können CNNs komplizierte visuelle Muster lernen.
Zusammenfassend lässt sich sagen, dass jeder Kernel während des Trainings kanalübergreifend repliziert wird.
Pooling von Schichten: Vereinfachung der Repräsentation
Pooling-Schichten reduzieren die räumlichen Dimensionen der Merkmalskarten von Faltungsschichten entscheidend. Diese Dimensionalitätsreduktion dient mehreren Zwecken:
- Geringere Rechenleistung: Durch die Verkleinerung der Merkmalskartengrößen werden die Parameter und die Berechnungskomplexität drastisch reduziert.
- Translationsinvarianz: Pooling-Schichten helfen den Netzwerken, unempfindlich gegenüber geringfügigen Eingabeverschiebungen zu werden. Beim Max-Pooling werden beispielsweise Maximalwerte aus lokalen Regionen ausgewählt, wodurch die Empfindlichkeit gegenüber der genauen Positionierung von Merkmalen verringert wird.
- Verbesserte Generalisierung: Durch die Zusammenfassung von Informationen über lokale Regionen fördert das Pooling das Erlernen robuster, verallgemeinerbarer Merkmale, die einer Überanpassung widerstehen.

Max-Pooling extrahiert Maximal-, Durchschnitts- oder Minimalwerte aus Pixelgruppen. Bei einer 2x2-Pool-Definition werden vier Pixel auf zwei reduziert, wodurch sich die Pixelanzahl halbiert, während die wesentlichen Informationen erhalten bleiben.
Zu den gängigen Pooling-Varianten gehören Max-, Average- und Min-Pooling. Das Max-Pooling setzt sich vor allem wegen seiner Effektivität bei der Erhaltung wichtiger Merkmale während der Dimensionalitätsreduktion durch. Dadurch wird die Effizienz aufrechterhalten und gleichzeitig werden genaue Darstellungen beibehalten.
Visualisierung von CNNs mit CNN Explainer
Einsatz von CNN Explainer für ein besseres Verständnis
Die internen Prozesse von CNNs zu verstehen, kann eine Herausforderung sein. Glücklicherweise bieten Tools wie CNN Explainer visuelle Schnittstellen, die die Vorgänge im Netzwerk verdeutlichen.

CNN Explainer ermöglicht die Visualisierung der Transformationen der einzelnen Schichten und ist damit ein hervorragendes Lehrmittel für das Verständnis von faltigen neuronalen Netzwerken.
Vorteile der Verwendung von CNN Explainer:
- Visualisierung von Merkmalskarten: Beobachten Sie die Feature-Maps der einzelnen Faltungsschichten, um zu verstehen, welche Muster das Netzwerk lernt.
- Verstehen von Kernel-Operationen: Bewegen Sie den Mauszeiger über die Matrizen, um die Auswirkungen der Kernel auf die Eingabebilder und ihre Beiträge zu den Merkmalskarten zu beobachten.
- Verschiedene Architekturen erforschen: Testen Sie verschiedene CNN-Konfigurationen und beobachten Sie deren Auswirkungen auf die gelernten Merkmale.
Durch seine visuelle, interaktive Oberfläche erleichtert der CNN Explainer ein tieferes Verständnis der CNN-Funktionalität.
Kodierung von CNNs mit Keras
Schritte zur Codierung eines Conv2D-Modells
Die Programmierung von CNNs von Grund auf kann sehr anspruchsvoll sein. Frameworks wie Keras - eng mit TensorFlow integriert - vereinfachen diesen Prozess durch High-Level-APIs für Netzwerkdefinition und Training.
Beginnen Sie mit der Konfiguration von TensorFlow. Fahren Sie dann mit diesen Schritten fort:
- Fügen Sie eine 2D-Faltungsschicht hinzu.
- Legen Sie die gewünschte Filtermenge fest.
- Legen Sie die Anzahl der Filter fest (z.B. 10 für ein Demonstrations-CNN).
- Definieren Sie Kernel-Spezifikationen und Eingangsdimensionen.
Die Verwendung dieser High-Level-APIs ermöglicht die schnelle Entwicklung leistungsstarker CNNs für verschiedene Computer-Vision-Anwendungen.
Vor- und Nachteile der Verwendung von CNN
Vorteile
Automatische Merkmalsextraktion: CNNs lernen selbstständig relevante Merkmale und minimieren so den manuellen Entwicklungsaufwand.
Räumliche Bewusstheit: CNNs behalten die räumlichen Beziehungen zwischen den Pixeln bei und sind somit unempfindlich gegenüber Änderungen der Objektposition, des Maßstabs und der Ausrichtung.
Hohe Genauigkeit: CNNs liefern Spitzenleistungen bei zahlreichen Computer-Vision-Aufgaben wie Bildklassifizierung und Objekterkennung.
Verallgemeinerung: CNNs passen sich effektiv an unbekannte Daten an, was sie für reale Implementierungen praktisch macht.
Nachteile
Rechnerische Komplexität: Das CNN-Training erfordert erhebliche Rechenressourcen, insbesondere bei großen Datensätzen und komplexen Architekturen.
Datenanforderungen: CNNs benötigen im Allgemeinen umfangreiche markierte Daten, um optimale Ergebnisse zu erzielen.
Interpretierbarkeit: Es kann schwierig sein, die Entscheidungsprozesse von CNNs zu verstehen.
Überanpassung: CNNs werden häufig überangepasst, wenn sie auf begrenzten Datensätzen trainiert werden.
Häufig gestellte Fragen
Was sind die Hauptunterschiede zwischen CNNs und herkömmlichen neuronalen Netzen?
CNNs sind auf die Verarbeitung visueller Daten unter Beibehaltung räumlicher 2D-Beziehungen spezialisiert, während herkömmliche Netzwerke Bilder als 1D-Arrays verarbeiten. CNNs automatisieren auch das Lernen von Merkmalen, im Gegensatz zu traditionellen Netzwerken, die oft manuelles Feature Engineering benötigen.
Welche Rolle spielen Aktivierungsfunktionen in CNNs?
Aktivierungsfunktionen führen Nichtlinearität ein und ermöglichen eine komplexe Mustererkennung. Ohne sie würden Netze nur lineare Beziehungen erfassen, was ihr Problemlösungspotenzial einschränkt.
Warum wird Google Colab für das Training von CNNs empfohlen?
Das Training von CNNs erfordert intensive Berechnungen. Google Colab bietet kostenlosen GPU- und TPU-Zugriff und beschleunigt das Training im Vergleich zu Standardprozessoren erheblich.
Verwandte Fragen
Können CNNs auch für andere Aufgaben als die Bilderkennung verwendet werden?
CNNs eignen sich zwar hervorragend für die Bildverarbeitung, können aber auch in anderen Bereichen wie der Verarbeitung natürlicher Sprache und der Audioanalyse eingesetzt werden. Diese Anwendungen wandeln Eingabedaten in gitterartige Strukturen um, die von Faltungsschichten verarbeitet werden können. In der NLP wird der Text beispielsweise zu einer Matrix, in der Zeilen Wörter und Spalten Merkmale wie Worteinbettungen darstellen. Das zugrunde liegende Prinzip bleibt bestehen: CNNs extrahieren in hervorragender Weise Muster aus lokalen Regionen der Eingabedaten. Ihre architektonische Flexibilität macht sie für verschiedene Anwendungen des maschinellen Lernens wertvoll.
Verwandter Artikel
 DeepMind-CEO Hassabis: Ich schlafe sechs Stunden pro Tag und fühle mich normalerweise gegen 1 Uhr nachts energiegeladen.
Fortune hat kürzlich ein Interview mit Demis Hassabis, dem CEO von Google DeepMind, veröffentlicht, das seinen unkonventionellen Ansatz zu Erholung und Produktivität offenbart. Hassabis gab bekannt, dass er sehr wenig schläft und seine wachen Stunden
OpenAI und Anthropic kämpfen trotz Umsatzrückgängen um Marktanteile
Obwohl jüngste Berichte darauf hindeuten, dass OpenAI seine Umsatzziele verfehlt hat, was an diesem Dienstag Druck auf die Technologieaktien ausübte, zeigen sich private Investoren in KI-Labore weiter
Einhaltung der Vorschriften für autonome Fahrzeuge in Kalifornien: Eine neue Ära von Bußgeldern, Geofences und 1 Million Meilen
Guident betreibt einen AuveTech-Shuttle in Südflorida und verwaltet mithilfe seiner Fernüberwachungstechnologie eine vier Meilen lange Strecke in West Palm Beach sowie eine eine Meile lange Strecke in
Empfehlungen zu verwandten Spezialthemen
Musikkomposition
 KI-Tools zur Stim-Trennung für die Remix-Produktion, die Vorbereitung von Samples und Karaoke-Master
Die besten und am besten bewerteten KI-Tools zur Stem-Trennung des Jahres 2026 – speziell ausgewählt für Remix-Produktionen, die Vorbereitung von Samples und Karaoke-Masters. Diese leistungsstarken, bahnbrechenden Tools haben sich in der Praxis bewährt und bieten präzise Audioisolierung, wodurch die Produktivität erheblich gesteigert wird. XIX.AI stellt einen wöchentlich aktualisierten Vergleichsleitfaden zwischen kostenlosen und kostenpflichtigen Lösungen bereit, der Ihnen hilft, die für Ihre Anforderungen passende Lösung zu finden, die Sie unbedingt ausprobieren sollten. Entdecken Sie ihn jetzt und sichern Sie sich Ihren KI-Vorteil.
 8 Tools
 xix.ai
Datenanalyse
KI-basierte SQL-Copiloten für Umsatz-Dashboards, Kanalanalysen sowie Produktmetriken
2026: Die neuesten und besten AI-SQL-Copiloten – alle in der Rangliste ganz oben! XIX.AI sammelt eine leistungsstarke Auswahl an Tools, die wöchentlich mit aktualisierten Tests aus der Praxis erweitert wird. Mit diesen unverzichtbaren Werkzeugen können Sie präzise Umsatzübersichten erstellen, Verkaufsprozesse analysieren sowie Produktmetriken schnell überwachen und so Ihre Produktivität erheblich steigern. Entdecken Sie jetzt das perfekte Tool für datenbasierte Entscheidungsfindung! 238 Zeichen
9 Tools
xix.ai
Musikkomposition
Die besten KI-Tools zum Komponieren von Melodien für Songentwürfe
2026 Neueste Besten Top-Bewerteten KI-Melodie-Schreibtools für Songentwürfe! XIX.AI hat eine hochleistungsfähige, bahnbrechende Kollektion zusammengestellt, die strengen Praxistests unterzogen wurde, um das beste Schreiberlebnis zu liefern. Sie finden detaillierte kostenlose versus kostenpflichtige Vergleiche, präzise Ranglisten und unbedingt auszuprobierende Optionen, die darauf ausgelegt sind, Ihnen zu helfen, beeindruckende Songentwürfe mühelos zu erstellen und Ihre kreative Produktivität erheblich zu steigern. Entdecken Sie jetzt Ihr perfektes Tool!
8 Tools
xix.ai
Chatbot
Die besten KI-gestützten Gesprächstrainingstools für Vorstellungsgesprächspraxis
2026 Neueste Besten Top-bewerteten KI-Konversationstrainer-Tools für Vorstellungsgesprächspraxis sind hier auf XIX.AI! Diese kuratierte Sammlung enthält leistungsstarke, bahnbrechende Tools, die strengen Praxistests unterzogen wurden, um präzises Feedback zu liefern. Sie finden einen Vergleich zwischen kostenlosen und kostenpflichtigen Optionen sowie detaillierte Rankings, die Ihnen helfen, die empfehlenswerte Option zu wählen, die Ihr Selbstvertrauen und Ihre Fähigkeiten verbessert. Entdecken Sie jetzt Ihr perfektes Tool für den Erfolg im Vorstellungsgespräch!
12 Tools
xix.ai
Design & Kunst
Die besten KI-Tools für den Stiltransfer für kreative Experimente
Die besten und am besten bewerteten KI-Tools für den Stiltransfer im Jahr 2026 – ideal für kreative Experimente! XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung unverzichtbarer Tools zusammengestellt, die in Praxistests und strengen Bewertungen außergewöhnliche Ergebnisse liefern. Diese Top-Lösungen helfen Kreativen dabei, ihre Produktivität deutlich zu steigern, indem sie die Erstellung von Inhalten beschleunigen und unendliche kreative Möglichkeiten eröffnen. Entdecken Sie jetzt Ihr perfektes Tool und legen Sie noch heute los!
9 Tools
xix.ai
Comic-Erstellung
Die besten KI-Tools für Sprechblasen zum visuellen Geschichtenerzählen
Die besten und am besten bewerteten KI-Tools für Sprechblasen zum visuellen Storytelling des Jahres 2026 finden Sie hier auf XIX.AI! Diese sorgfältig zusammengestellte Sammlung umfasst leistungsstarke, bahnbrechende Tools, die Kreativen dabei helfen, ihre Produktivität zu steigern und kreative Blockaden zu überwinden. Holen Sie sich einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, sehen Sie sich Praxistests an und werfen Sie einen Blick auf die aktuellen Rankings, um die unverzichtbaren Lösungen zu finden, die sich perfekt für die Gestaltung fesselnder visueller Erzählungen eignen. Stöbern Sie jetzt und entdecken Sie Ihr ideales Tool!
10 Tools
xix.ai

 Kommentare (0)
Faltungsneuronale Netze (Convolutional Neural Networks, CNNs) haben die Computer Vision verändert und ermöglichen es Maschinen, Bilder mit unglaublicher Präzision zu interpretieren. In diesem detaillierten Handbuch wird die Funktionsweise von CNNs untersucht, wobei Kernel, Faltungsschichten und die Art und Weise, wie diese Systeme Schlussfolgerungen ziehen, erläutert werden. Anhand von praktischen Beispielen und Visualisierungstools werden die Möglichkeiten dieser grundlegenden Technologie aufgezeigt, von der Analyse von Bildern bis hin zur Codierung von Implementierungen.
Wichtige Punkte
CNNs bewahren die zweidimensionale Struktur von Bildern mithilfe von Kerneln.
Kernel fungieren als Filter, die bestimmte Bildmerkmale identifizieren.
Faltungsschichten wenden diese Filter auf Bilder an, um Merkmalskarten zu erstellen.
Mehrere Faltungsschichten werden kombiniert, um komplexe visuelle Muster zu erkennen.
Pooling-Schichten rationalisieren die Merkmalskarten, indem sie ihre Abmessungen reduzieren.
CNN Explainer bietet eine visuelle Demonstration der Funktionsweise dieser Netzwerke.
Keras, das in TensorFlow integriert ist, vereinfacht den Prozess der Kodierung von CNN-Schichten.
Die Verflachung bereitet die Daten für dichte Schichten vor, die die endgültige Klassifizierung übernehmen.
Die Anpassung der Kernelgröße wirkt sich direkt auf die Qualität der Merkmalserkennung aus.
GPUs oder TPUs beschleunigen das CNN-Training für eine bessere Leistung.
Faltungsneuronale Netze enthüllen
Was ist ein Convolutional Neural Network (CNN)?
Convolutional Neural Networks (CNNs) sind spezialisierte künstliche neuronale Netze, die für die Verarbeitung visueller Informationen entwickelt wurden. Im Gegensatz zu konventionellen Netzwerken, die Bilder als flache Pixelarrays behandeln, nutzen CNNs räumliche Beziehungen zwischen Pixeln. Diese Fähigkeit ist für die Klassifizierung von Bildern, die Erkennung von Objekten und die Segmentierung von entscheidender Bedeutung.
CNNs orientieren sich an der Funktionsweise des menschlichen visuellen Kortex. Sie setzen spezialisierte Schichten ein, um schrittweise räumliche Merkmalshierarchien zu erlernen, angefangen bei grundlegenden Elementen wie Kanten und Ecken bis hin zu erweiterten Objektdarstellungen.
Kernkomponenten von CNNs:
- Faltungsschichten: Diese grundlegenden Komponenten verwenden Kernel (oder Filter), um Merkmale in Eingabebildern zu erkennen.
- Pooling-Schichten: Diese Schichten verkleinern die Darstellungsgröße, verringern die Anzahl der Parameter und den Rechenaufwand und sorgen gleichzeitig für Translationsinvarianz.
- Aktivierungsfunktionen: Nichtlineare Funktionen wie ReLU ermöglichen es Netzwerken, komplexe Muster zu erkennen.
- Vollständig verknüpfte Schichten: Diese Schichten befinden sich am Ende des Netzes und führen eine Klassifizierung anhand der von den vorherigen Schichten gesammelten Merkmale durch.
Der Hauptvorteil von CNNs liegt im automatischen Lernen von Merkmalen aus Daten, wodurch manuelle Extraktionsprozesse überflüssig werden. Dies macht sie für verschiedene Computer-Vision-Anwendungen besonders effektiv. Ihre einzigartigen Faltungsschichten unterscheiden sie von anderen neuronalen Netztypen.
Die Wichtigkeit der Beibehaltung von 2D-Informationen
Herkömmliche neuronale Netze wandeln Bilder in der Regel in eindimensionale Pixelarrays um und opfern dabei wichtige zweidimensionale Strukturen und Nachbarschaftsbeziehungen. Stellen Sie sich vor, Sie würden versuchen, ein Gemälde zu verstehen, indem Sie nur die einzelnen Farben der Punkte kennen, ohne ihre Anordnung zu sehen - Sie würden den Kontext und die Gesamtkomposition verpassen.
CNNs beziehen ihre Stärke aus der Beibehaltung dieser 2D-Struktur. Durch den Einsatz von Kerneln, die lokalisierte Bildbereiche scannen, erfasst das Netzwerk räumliche Abhängigkeiten zwischen Pixeln. Dies gewährleistet eine genaue Identifizierung von Kanten, Ecken und Texturen unabhängig von ihrer Bildposition.
Nachteile
edenfalls eine Kaffeetasse. Unser Gehirn erkennt sie als Kaffeetasse, egal ob sie links oder rechts steht. CNNs ahmen diese Fähigkeit nach. Durch die Beibehaltung von 2D-Informationen sind CNNs widerstandsfähiger gegenüber Änderungen der Objektpositionierung, Skalierung und Ausrichtung. Dieses räumliche Bewusstsein verbessert die Fähigkeit des Netzwerks zur Generalisierung und zur genauen Verarbeitung unbekannter Daten erheblich.Kerne: Die Merkmalsextraktoren
Der Kernel bildet den Kern jeder Faltungsschicht - eine kompakte Gewichtsmatrix, die als Musterdetektor dient. Man kann ihn sich als eine spezielle Linse vorstellen, die sich auf bestimmte Bildmerkmale konzentriert. Jeder Kernel identifiziert bestimmte Merkmale wie Kanten, Ecken oder Texturen.
Ein Kernel ist im Grunde eine Gewichtungsmatrix. Jeder Matrixwert enthält eine Gewichtung, die mit den entsprechenden Pixeln des Eingangsbildes multipliziert wird und so die Erfassung der fotografischen 2D-Struktur zur Informationsextraktion ermöglicht.
Der Kernel durchläuft das Eingabebild und führt an jeder Stelle Faltungsoperationen aus. Während dieses Prozesses wird jedes Kernelement mit passenden Pixelwerten in lokalen Bildregionen multipliziert. Diese Produkte summieren sich zu Einzelwerten, die die Ausgangskarte mit den Merkmalen füllen.
Durch genaue Anpassung der Kernelgewichte lernt das Netzwerk, aufgabenrelevante Merkmale zu erkennen. Ein Kernel zur Erkennung horizontaler Kanten enthält beispielsweise positive Gewichte entlang einer horizontalen Linie und negative Gewichte oberhalb und unterhalb dieser Linie.
Die Kernel fungieren also als Filtermechanismen für die Informationsextraktion.
Die Faltungsschicht in Aktion
Die Faltungsschicht wendet Kernel auf das gesamte Eingabebild an. Dieser Ansatz des gleitenden Fensters in Kombination mit der Faltung ermöglicht die Erkennung von Merkmalen im gesamten Bild.
Während sich die Kernel über die Bilder bewegen, erzeugen sie Merkmalskarten, die das Vorhandensein und die Intensität der erkannten Merkmale anzeigen. Jeder Wert der Merkmalskarte entspricht einer Position im Eingabebild, wobei die Größe angibt, wie gut das Muster des Kerns mit dem lokalen Bildinhalt übereinstimmt.
Wir positionieren unseren Kernel an der ersten Ecke des Bildes, die sechs Pixel umfasst. Die Kernel-Gewichte werden mit diesen Pixeln multipliziert, und die Summe wird zu einem einzelnen Pixel im neuen Bild. Dieser Prozess ähnelt der Anwendung von Bildfiltern.
Verschiedene Kernel innerhalb der gleichen Faltungsschicht erkennen unterschiedliche Merkmale. Diese Merkmale ergeben zusammen eine umfassende Bilddarstellung. Durch die Anwendung mehrerer Kernel zur Erzeugung verschiedener Merkmalskarten können CNNs komplizierte visuelle Muster lernen.
Zusammenfassend lässt sich sagen, dass jeder Kernel während des Trainings kanalübergreifend repliziert wird.
Pooling von Schichten: Vereinfachung der Repräsentation
Pooling-Schichten reduzieren die räumlichen Dimensionen der Merkmalskarten von Faltungsschichten entscheidend. Diese Dimensionalitätsreduktion dient mehreren Zwecken:
- Geringere Rechenleistung: Durch die Verkleinerung der Merkmalskartengrößen werden die Parameter und die Berechnungskomplexität drastisch reduziert.
- Translationsinvarianz: Pooling-Schichten helfen den Netzwerken, unempfindlich gegenüber geringfügigen Eingabeverschiebungen zu werden. Beim Max-Pooling werden beispielsweise Maximalwerte aus lokalen Regionen ausgewählt, wodurch die Empfindlichkeit gegenüber der genauen Positionierung von Merkmalen verringert wird.
- Verbesserte Generalisierung: Durch die Zusammenfassung von Informationen über lokale Regionen fördert das Pooling das Erlernen robuster, verallgemeinerbarer Merkmale, die einer Überanpassung widerstehen.
Max-Pooling extrahiert Maximal-, Durchschnitts- oder Minimalwerte aus Pixelgruppen. Bei einer 2x2-Pool-Definition werden vier Pixel auf zwei reduziert, wodurch sich die Pixelanzahl halbiert, während die wesentlichen Informationen erhalten bleiben.
Zu den gängigen Pooling-Varianten gehören Max-, Average- und Min-Pooling. Das Max-Pooling setzt sich vor allem wegen seiner Effektivität bei der Erhaltung wichtiger Merkmale während der Dimensionalitätsreduktion durch. Dadurch wird die Effizienz aufrechterhalten und gleichzeitig werden genaue Darstellungen beibehalten.
Visualisierung von CNNs mit CNN Explainer
Einsatz von CNN Explainer für ein besseres Verständnis
Die internen Prozesse von CNNs zu verstehen, kann eine Herausforderung sein. Glücklicherweise bieten Tools wie CNN Explainer visuelle Schnittstellen, die die Vorgänge im Netzwerk verdeutlichen.
CNN Explainer ermöglicht die Visualisierung der Transformationen der einzelnen Schichten und ist damit ein hervorragendes Lehrmittel für das Verständnis von faltigen neuronalen Netzwerken.
Vorteile der Verwendung von CNN Explainer:
- Visualisierung von Merkmalskarten: Beobachten Sie die Feature-Maps der einzelnen Faltungsschichten, um zu verstehen, welche Muster das Netzwerk lernt.
- Verstehen von Kernel-Operationen: Bewegen Sie den Mauszeiger über die Matrizen, um die Auswirkungen der Kernel auf die Eingabebilder und ihre Beiträge zu den Merkmalskarten zu beobachten.
- Verschiedene Architekturen erforschen: Testen Sie verschiedene CNN-Konfigurationen und beobachten Sie deren Auswirkungen auf die gelernten Merkmale.
Durch seine visuelle, interaktive Oberfläche erleichtert der CNN Explainer ein tieferes Verständnis der CNN-Funktionalität.
Kodierung von CNNs mit Keras
Schritte zur Codierung eines Conv2D-Modells
Die Programmierung von CNNs von Grund auf kann sehr anspruchsvoll sein. Frameworks wie Keras - eng mit TensorFlow integriert - vereinfachen diesen Prozess durch High-Level-APIs für Netzwerkdefinition und Training.
Beginnen Sie mit der Konfiguration von TensorFlow. Fahren Sie dann mit diesen Schritten fort:
- Fügen Sie eine 2D-Faltungsschicht hinzu.
- Legen Sie die gewünschte Filtermenge fest.
- Legen Sie die Anzahl der Filter fest (z.B. 10 für ein Demonstrations-CNN).
- Definieren Sie Kernel-Spezifikationen und Eingangsdimensionen.
Die Verwendung dieser High-Level-APIs ermöglicht die schnelle Entwicklung leistungsstarker CNNs für verschiedene Computer-Vision-Anwendungen.
Vor- und Nachteile der Verwendung von CNN
Vorteile
Automatische Merkmalsextraktion: CNNs lernen selbstständig relevante Merkmale und minimieren so den manuellen Entwicklungsaufwand.
Räumliche Bewusstheit: CNNs behalten die räumlichen Beziehungen zwischen den Pixeln bei und sind somit unempfindlich gegenüber Änderungen der Objektposition, des Maßstabs und der Ausrichtung.
Hohe Genauigkeit: CNNs liefern Spitzenleistungen bei zahlreichen Computer-Vision-Aufgaben wie Bildklassifizierung und Objekterkennung.
Verallgemeinerung: CNNs passen sich effektiv an unbekannte Daten an, was sie für reale Implementierungen praktisch macht.
Nachteile
Rechnerische Komplexität: Das CNN-Training erfordert erhebliche Rechenressourcen, insbesondere bei großen Datensätzen und komplexen Architekturen.
Datenanforderungen: CNNs benötigen im Allgemeinen umfangreiche markierte Daten, um optimale Ergebnisse zu erzielen.
Interpretierbarkeit: Es kann schwierig sein, die Entscheidungsprozesse von CNNs zu verstehen.
Überanpassung: CNNs werden häufig überangepasst, wenn sie auf begrenzten Datensätzen trainiert werden.
Häufig gestellte Fragen
Was sind die Hauptunterschiede zwischen CNNs und herkömmlichen neuronalen Netzen?
CNNs sind auf die Verarbeitung visueller Daten unter Beibehaltung räumlicher 2D-Beziehungen spezialisiert, während herkömmliche Netzwerke Bilder als 1D-Arrays verarbeiten. CNNs automatisieren auch das Lernen von Merkmalen, im Gegensatz zu traditionellen Netzwerken, die oft manuelles Feature Engineering benötigen.
Welche Rolle spielen Aktivierungsfunktionen in CNNs?
Aktivierungsfunktionen führen Nichtlinearität ein und ermöglichen eine komplexe Mustererkennung. Ohne sie würden Netze nur lineare Beziehungen erfassen, was ihr Problemlösungspotenzial einschränkt.
Warum wird Google Colab für das Training von CNNs empfohlen?
Das Training von CNNs erfordert intensive Berechnungen. Google Colab bietet kostenlosen GPU- und TPU-Zugriff und beschleunigt das Training im Vergleich zu Standardprozessoren erheblich.
Verwandte Fragen
Können CNNs auch für andere Aufgaben als die Bilderkennung verwendet werden?
CNNs eignen sich zwar hervorragend für die Bildverarbeitung, können aber auch in anderen Bereichen wie der Verarbeitung natürlicher Sprache und der Audioanalyse eingesetzt werden. Diese Anwendungen wandeln Eingabedaten in gitterartige Strukturen um, die von Faltungsschichten verarbeitet werden können. In der NLP wird der Text beispielsweise zu einer Matrix, in der Zeilen Wörter und Spalten Merkmale wie Worteinbettungen darstellen. Das zugrunde liegende Prinzip bleibt bestehen: CNNs extrahieren in hervorragender Weise Muster aus lokalen Regionen der Eingabedaten. Ihre architektonische Flexibilität macht sie für verschiedene Anwendungen des maschinellen Lernens wertvoll.








 DeepMind-CEO Hassabis: Ich schlafe sechs Stunden pro Tag und fühle mich normalerweise gegen 1 Uhr nachts energiegeladen.
Fortune hat kürzlich ein Interview mit Demis Hassabis, dem CEO von Google DeepMind, veröffentlicht, das seinen unkonventionellen Ansatz zu Erholung und Produktivität offenbart. Hassabis gab bekannt, dass er sehr wenig schläft und seine wachen Stunden
 OpenAI und Anthropic kämpfen trotz Umsatzrückgängen um Marktanteile
Obwohl jüngste Berichte darauf hindeuten, dass OpenAI seine Umsatzziele verfehlt hat, was an diesem Dienstag Druck auf die Technologieaktien ausübte, zeigen sich private Investoren in KI-Labore weiter
Einhaltung der Vorschriften für autonome Fahrzeuge in Kalifornien: Eine neue Ära von Bußgeldern, Geofences und 1 Million Meilen
Guident betreibt einen AuveTech-Shuttle in Südflorida und verwaltet mithilfe seiner Fernüberwachungstechnologie eine vier Meilen lange Strecke in West Palm Beach sowie eine eine Meile lange Strecke in

Die besten und am besten bewerteten KI-Tools zur Stem-Trennung des Jahres 2026 – speziell ausgewählt für Remix-Produktionen, die Vorbereitung von Samples und Karaoke-Masters. Diese leistungsstarken, bahnbrechenden Tools haben sich in der Praxis bewährt und bieten präzise Audioisolierung, wodurch die Produktivität erheblich gesteigert wird. XIX.AI stellt einen wöchentlich aktualisierten Vergleichsleitfaden zwischen kostenlosen und kostenpflichtigen Lösungen bereit, der Ihnen hilft, die für Ihre Anforderungen passende Lösung zu finden, die Sie unbedingt ausprobieren sollten. Entdecken Sie ihn jetzt und sichern Sie sich Ihren KI-Vorteil.
8 Tools
xix.ai

2026: Die neuesten und besten AI-SQL-Copiloten – alle in der Rangliste ganz oben! XIX.AI sammelt eine leistungsstarke Auswahl an Tools, die wöchentlich mit aktualisierten Tests aus der Praxis erweitert wird. Mit diesen unverzichtbaren Werkzeugen können Sie präzise Umsatzübersichten erstellen, Verkaufsprozesse analysieren sowie Produktmetriken schnell überwachen und so Ihre Produktivität erheblich steigern. Entdecken Sie jetzt das perfekte Tool für datenbasierte Entscheidungsfindung! 238 Zeichen
9 Tools
xix.ai

2026 Neueste Besten Top-Bewerteten KI-Melodie-Schreibtools für Songentwürfe! XIX.AI hat eine hochleistungsfähige, bahnbrechende Kollektion zusammengestellt, die strengen Praxistests unterzogen wurde, um das beste Schreiberlebnis zu liefern. Sie finden detaillierte kostenlose versus kostenpflichtige Vergleiche, präzise Ranglisten und unbedingt auszuprobierende Optionen, die darauf ausgelegt sind, Ihnen zu helfen, beeindruckende Songentwürfe mühelos zu erstellen und Ihre kreative Produktivität erheblich zu steigern. Entdecken Sie jetzt Ihr perfektes Tool!
8 Tools
xix.ai

2026 Neueste Besten Top-bewerteten KI-Konversationstrainer-Tools für Vorstellungsgesprächspraxis sind hier auf XIX.AI! Diese kuratierte Sammlung enthält leistungsstarke, bahnbrechende Tools, die strengen Praxistests unterzogen wurden, um präzises Feedback zu liefern. Sie finden einen Vergleich zwischen kostenlosen und kostenpflichtigen Optionen sowie detaillierte Rankings, die Ihnen helfen, die empfehlenswerte Option zu wählen, die Ihr Selbstvertrauen und Ihre Fähigkeiten verbessert. Entdecken Sie jetzt Ihr perfektes Tool für den Erfolg im Vorstellungsgespräch!
12 Tools
xix.ai

Die besten und am besten bewerteten KI-Tools für den Stiltransfer im Jahr 2026 – ideal für kreative Experimente! XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung unverzichtbarer Tools zusammengestellt, die in Praxistests und strengen Bewertungen außergewöhnliche Ergebnisse liefern. Diese Top-Lösungen helfen Kreativen dabei, ihre Produktivität deutlich zu steigern, indem sie die Erstellung von Inhalten beschleunigen und unendliche kreative Möglichkeiten eröffnen. Entdecken Sie jetzt Ihr perfektes Tool und legen Sie noch heute los!
9 Tools
xix.ai

Die besten und am besten bewerteten KI-Tools für Sprechblasen zum visuellen Storytelling des Jahres 2026 finden Sie hier auf XIX.AI! Diese sorgfältig zusammengestellte Sammlung umfasst leistungsstarke, bahnbrechende Tools, die Kreativen dabei helfen, ihre Produktivität zu steigern und kreative Blockaden zu überwinden. Holen Sie sich einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, sehen Sie sich Praxistests an und werfen Sie einen Blick auf die aktuellen Rankings, um die unverzichtbaren Lösungen zu finden, die sich perfekt für die Gestaltung fesselnder visueller Erzählungen eignen. Stöbern Sie jetzt und entdecken Sie Ihr ideales Tool!
10 Tools
xix.ai












