


 Heim
SenseTime stellt ein 8B-Multimodal-Modell mit geringer Speicherbelastung, nativer 4K-Ausgabe und umfassenden visuellen Bearbeitungsfunktionen vor
SenseTime hat offiziell SenseNova U1.5Lite veröffentlicht, ein neues, schlankes, natives, einheitliches multimodales Großmodell. Mit 8 Milliarden Parametern übertrifft dieses effiziente Modell Alternativen ähnlicher Größe bei wichtigen visuellen Aufgaben und kann in komplexen Layout- und Textdarstellungsszenarien mit groß angelegten kommerziellen Modellen mithalten.
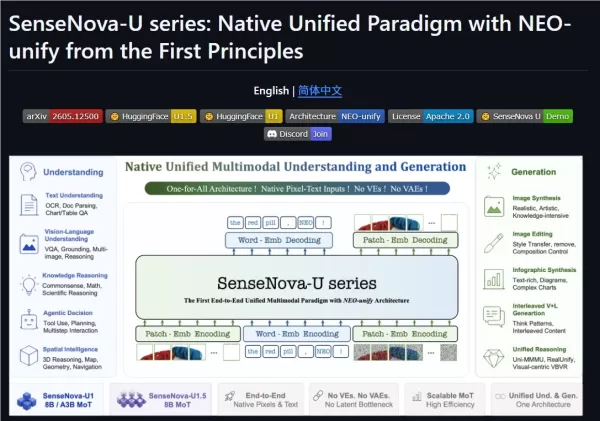
SenseNova U1.5Lite unterstützt nativ Kontextlängen von 3.000 bis 4.000 Zeichen und verarbeitet gleichzeitig mehrere Einschränkungen – darunter Motiv, Menge, räumliche Beziehungen, Text, Layout und Stil –, wodurch eine höhere Stabilität bei komplexen visuellen Aufgaben gewährleistet wird.
Das Modell führt mehrere wesentliche Verbesserungen ein. Erstens liefert es eine qualitativ hochwertigere visuelle Generierung durch die Optimierung von Komposition, Farbe, Material, Beleuchtung, Realismus und lokalen Details, wodurch das häufige Problem lokal korrekter, aber global unvollständiger Ergebnisse wirksam verhindert wird. Zweitens bietet es eine robuste native Bildbearbeitung, bei der die Identität des Motivs, die räumliche Struktur, das Layout und nicht bearbeitbare Bereiche besser erhalten bleiben, während lokale Änderungen, das Ersetzen von Elementen, die Textverfeinerung und die Bearbeitung mit mehreren Referenzen verbessert werden.
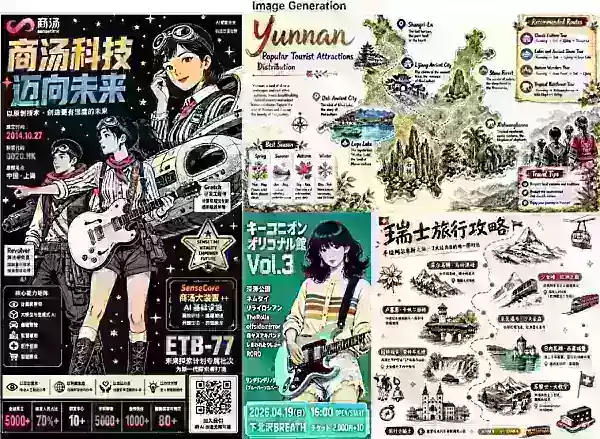
Darüber hinaus zeichnet sich das Modell durch die Verarbeitung von Text und komplexen Layouts aus und stärkt seine Fähigkeiten bei chinesischen und englischen Texten, Plakaten, Infografiken, Markenbildern und der Formatierung mehrerer Texte, um einen vollständigen visuellen Ausdruck zu erzielen. Für eine präzise Steuerung unterstützt es Bounding Box, visuelle Marker sowie Referenzen auf einzelne oder mehrere Bilder. Bemerkenswert ist, dass es eine native 4K-Ausgabe in hoher Auflösung erzielt und dabei sowohl die Makrokomposition als auch feine Texturen, kleinen Text und Lichteffekte beibehält.
Projektadresse: https://github.com/OpenSenseNova/SenseNova-U1
Verwandter Artikel
 Claude enthält die erste vollständige ultraviolette Himmelskarte und kartiert 119 Millionen Sterne
Mit der leistungsstarken Unterstützung von Claude, dem großen Sprachmodell von Anthropic, haben Astrophysiker erfolgreich die erste vollständige ultraviolette Allhimmelskarte der Geschichte erstellt. Dieses weitreichende Sternenkartenwerk, das 119 Mi
Wie AWS und NVIDIA Agentic und Physical AI vorantreiben
NVIDIA-CEO Jensen Huang (Bildnachweis: Tomohiro Ohsumi/Getty Images)Jensen Huangs NVIDIA und AWS bauen ihre weltweite Partnerschaft aus und stellen 2 Millionen GPUs bereit, um die Unternehmensinfrastr
Gehirnwellen-Trainingsroboter: Der nächste Schritt von Physical AI, angetrieben durch menschliche Gehirnsignale
In einem Lagerhaus in San Leandro, Kalifornien, führt Encord, ein Unternehmen für Datenwerkzeuge, ein innovatives Experiment durch: „Piloten“ tragen Headsets mit Kameras und EEG-Sensoren, während sie Jenga spielen, um die Gehirnaktivität aufzuzeichne
Empfehlungen zu verwandten Spezialthemen
Design & Kunst
 Die besten KI-Illustrationstools: Redaktionelle Szenen und Cover-Grafiken schneller erstellen
Die besten und am besten bewerteten KI-Illustrationstools 2026: Unsere sorgfältig zusammengestellte Liste enthält die leistungsstärksten Tools, mit denen Sie im Handumdrehen atemberaubende redaktionelle Szenen und auffällige Cover-Grafiken erstellen können. Jede Option wurde strengen Praxistests unterzogen und wird im Vergleich zwischen kostenlosen und kostenpflichtigen Versionen vorgestellt, damit Sie die perfekte Lösung für Ihren Arbeitsablauf finden können. Probieren Sie diese unverzichtbaren Lösungen noch heute aus, um Ihren KI-Vorteil zu nutzen und Ihre kreative Produktivität zu steigern. Entdecken Sie sie jetzt auf XIX.AI.
 10 Tools
 xix.ai
Bildung und Lernen
Die besten KI-Nachhilfelehrer für die Prüfungsvorbereitung: Üben Sie Mathematik, Naturwissenschaften und Englisch
Die besten und am besten bewerteten KI-Nachhilfetools für die Prüfungsvorbereitung des Jahres 2026 finden Sie hier auf XIX.AI! Unsere sorgfältig zusammengestellte Liste enthält leistungsstarke, bahnbrechende Tools, die einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, Tests aus der Praxis sowie wöchentlich aktualisierte Rankings bieten. Sie helfen Ihnen dabei, Ihre Schreibeffizienz zu steigern, das Erlernen komplexer Themen zu vereinfachen und Ihr akademisches Potenzial voll auszuschöpfen. Entdecken Sie jetzt Ihr perfektes Tool zur Prüfungsvorbereitung und legen Sie noch heute los, um Ihren KI-Vorteil zu nutzen!
10 Tools
xix.ai
Finanzen
KI-Budgetplanungstools für das persönliche Geldmanagement
2026 Neueste Besten Top-Bewertete KI-Budgetplanungs-Tools für persönliches Geldmanagement sind hier auf XIX.AI! Diese kuratierte Sammlung bietet leistungsstarke, revolutionäre Lösungen, die Ihnen helfen, reale Tests durchzuführen, Ausgaben Gewohnheiten zu verstehen und personalisierte Pläne zu erstellen, um die Produktivität zu steigern. Genießen Sie einen kostenlosen vs. bezahlten Vergleich sowie detaillierte Rankings. Unbedingt auszuprobierende Tools, die darauf ausgelegt sind, das Geldmanagement zu vereinfachen und Ihre KI-Vorteile freizuschalten. Entdecken Sie jetzt!
11 Tools
xix.ai
Gesundheit Wellness
KI-gestützte Schlafüberwachungsassistenten: Verbessern Sie Ihre Erholung durch bessere Gewohnheiten vor dem Schlafengehen
2026 – Die neuesten, besten und am höchsten bewerteten AI-Geräte zur Schlafüberwachung, sorgfältig ausgewählt für eine optimale Erholung. Dieser vollständig aktualisierte wöchentliche Leitfaden präsentiert leistungsstarke Tools mit praktischen Tests, einem Vergleich von kostenlosen und kostenpflichtigen Optionen sowie detaillierten Ranglisten, um Ihnen die beste Lösung zu zeigen, die die Schlafqualität verbessert und bessere Gewohnheiten zum Zubettgehen fördert. Entdecken Sie ihn jetzt auf XIX.AI, um Ihren Vorteil durch KI zu nutzen.
10 Tools
xix.ai
Datenanalyse
KI-gestützte SQL-Copilots für Produkt- und Umsatzanalysen
Die besten und am besten bewerteten KI-SQL-Copilots für Produkt- und Umsatzanalysen im Jahr 2026! XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung unverzichtbarer Tools zusammengestellt, die anhand wöchentlich aktualisierter Rankings in der Praxis getestet werden. Diese Tools helfen Anwendern dabei, ihre Produktivität erheblich zu steigern, indem sie die Datenanalyse beschleunigen, komplexe Abfragen optimieren und präzise Erkenntnisse liefern, um intelligentere Geschäftsentscheidungen zu ermöglichen. Entdecken Sie jetzt das perfekte Tool, um Ihren KI-Vorteil voll auszuschöpfen!
14 Tools
xix.ai
Bildung und Lernen
Die besten KI-Hausaufgabenhelfer, die wirklich etwas vermitteln: Lerne Konzepte, nicht nur Antworten
2026: Die aktuell besten und am besten bewerteten KI-Hausaufgabenhelfer, die nicht nur Antworten liefern, sondern auch Kernkonzepte vermitteln – leistungsstarke Tools für Schüler und Studenten. Eine kuratierte Liste, die Sie unbedingt ausprobieren sollten. Wöchentlich aktualisiert. Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten. Praxistests. Genaue Rankings, die Ihnen helfen, Ihr volles Lernpotenzial auszuschöpfen. Entdecken Sie jetzt das perfekte Tool für intelligenteres Lernen.
10 Tools
xix.ai

 Kommentare (0)
SenseTime hat offiziell SenseNova U1.5Lite veröffentlicht, ein neues, schlankes, natives, einheitliches multimodales Großmodell. Mit 8 Milliarden Parametern übertrifft dieses effiziente Modell Alternativen ähnlicher Größe bei wichtigen visuellen Aufgaben und kann in komplexen Layout- und Textdarstellungsszenarien mit groß angelegten kommerziellen Modellen mithalten.
SenseNova U1.5Lite unterstützt nativ Kontextlängen von 3.000 bis 4.000 Zeichen und verarbeitet gleichzeitig mehrere Einschränkungen – darunter Motiv, Menge, räumliche Beziehungen, Text, Layout und Stil –, wodurch eine höhere Stabilität bei komplexen visuellen Aufgaben gewährleistet wird.
Das Modell führt mehrere wesentliche Verbesserungen ein. Erstens liefert es eine qualitativ hochwertigere visuelle Generierung durch die Optimierung von Komposition, Farbe, Material, Beleuchtung, Realismus und lokalen Details, wodurch das häufige Problem lokal korrekter, aber global unvollständiger Ergebnisse wirksam verhindert wird. Zweitens bietet es eine robuste native Bildbearbeitung, bei der die Identität des Motivs, die räumliche Struktur, das Layout und nicht bearbeitbare Bereiche besser erhalten bleiben, während lokale Änderungen, das Ersetzen von Elementen, die Textverfeinerung und die Bearbeitung mit mehreren Referenzen verbessert werden.
Darüber hinaus zeichnet sich das Modell durch die Verarbeitung von Text und komplexen Layouts aus und stärkt seine Fähigkeiten bei chinesischen und englischen Texten, Plakaten, Infografiken, Markenbildern und der Formatierung mehrerer Texte, um einen vollständigen visuellen Ausdruck zu erzielen. Für eine präzise Steuerung unterstützt es Bounding Box, visuelle Marker sowie Referenzen auf einzelne oder mehrere Bilder. Bemerkenswert ist, dass es eine native 4K-Ausgabe in hoher Auflösung erzielt und dabei sowohl die Makrokomposition als auch feine Texturen, kleinen Text und Lichteffekte beibehält.
Projektadresse: https://github.com/OpenSenseNova/SenseNova-U1








 Claude enthält die erste vollständige ultraviolette Himmelskarte und kartiert 119 Millionen Sterne
Mit der leistungsstarken Unterstützung von Claude, dem großen Sprachmodell von Anthropic, haben Astrophysiker erfolgreich die erste vollständige ultraviolette Allhimmelskarte der Geschichte erstellt. Dieses weitreichende Sternenkartenwerk, das 119 Mi
 Wie AWS und NVIDIA Agentic und Physical AI vorantreiben
NVIDIA-CEO Jensen Huang (Bildnachweis: Tomohiro Ohsumi/Getty Images)Jensen Huangs NVIDIA und AWS bauen ihre weltweite Partnerschaft aus und stellen 2 Millionen GPUs bereit, um die Unternehmensinfrastr
 Gehirnwellen-Trainingsroboter: Der nächste Schritt von Physical AI, angetrieben durch menschliche Gehirnsignale
In einem Lagerhaus in San Leandro, Kalifornien, führt Encord, ein Unternehmen für Datenwerkzeuge, ein innovatives Experiment durch: „Piloten“ tragen Headsets mit Kameras und EEG-Sensoren, während sie Jenga spielen, um die Gehirnaktivität aufzuzeichne

Die besten und am besten bewerteten KI-Illustrationstools 2026: Unsere sorgfältig zusammengestellte Liste enthält die leistungsstärksten Tools, mit denen Sie im Handumdrehen atemberaubende redaktionelle Szenen und auffällige Cover-Grafiken erstellen können. Jede Option wurde strengen Praxistests unterzogen und wird im Vergleich zwischen kostenlosen und kostenpflichtigen Versionen vorgestellt, damit Sie die perfekte Lösung für Ihren Arbeitsablauf finden können. Probieren Sie diese unverzichtbaren Lösungen noch heute aus, um Ihren KI-Vorteil zu nutzen und Ihre kreative Produktivität zu steigern. Entdecken Sie sie jetzt auf XIX.AI.
10 Tools
xix.ai

Die besten und am besten bewerteten KI-Nachhilfetools für die Prüfungsvorbereitung des Jahres 2026 finden Sie hier auf XIX.AI! Unsere sorgfältig zusammengestellte Liste enthält leistungsstarke, bahnbrechende Tools, die einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, Tests aus der Praxis sowie wöchentlich aktualisierte Rankings bieten. Sie helfen Ihnen dabei, Ihre Schreibeffizienz zu steigern, das Erlernen komplexer Themen zu vereinfachen und Ihr akademisches Potenzial voll auszuschöpfen. Entdecken Sie jetzt Ihr perfektes Tool zur Prüfungsvorbereitung und legen Sie noch heute los, um Ihren KI-Vorteil zu nutzen!
10 Tools
xix.ai

2026 Neueste Besten Top-Bewertete KI-Budgetplanungs-Tools für persönliches Geldmanagement sind hier auf XIX.AI! Diese kuratierte Sammlung bietet leistungsstarke, revolutionäre Lösungen, die Ihnen helfen, reale Tests durchzuführen, Ausgaben Gewohnheiten zu verstehen und personalisierte Pläne zu erstellen, um die Produktivität zu steigern. Genießen Sie einen kostenlosen vs. bezahlten Vergleich sowie detaillierte Rankings. Unbedingt auszuprobierende Tools, die darauf ausgelegt sind, das Geldmanagement zu vereinfachen und Ihre KI-Vorteile freizuschalten. Entdecken Sie jetzt!
11 Tools
xix.ai

2026 – Die neuesten, besten und am höchsten bewerteten AI-Geräte zur Schlafüberwachung, sorgfältig ausgewählt für eine optimale Erholung. Dieser vollständig aktualisierte wöchentliche Leitfaden präsentiert leistungsstarke Tools mit praktischen Tests, einem Vergleich von kostenlosen und kostenpflichtigen Optionen sowie detaillierten Ranglisten, um Ihnen die beste Lösung zu zeigen, die die Schlafqualität verbessert und bessere Gewohnheiten zum Zubettgehen fördert. Entdecken Sie ihn jetzt auf XIX.AI, um Ihren Vorteil durch KI zu nutzen.
10 Tools
xix.ai

Die besten und am besten bewerteten KI-SQL-Copilots für Produkt- und Umsatzanalysen im Jahr 2026! XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung unverzichtbarer Tools zusammengestellt, die anhand wöchentlich aktualisierter Rankings in der Praxis getestet werden. Diese Tools helfen Anwendern dabei, ihre Produktivität erheblich zu steigern, indem sie die Datenanalyse beschleunigen, komplexe Abfragen optimieren und präzise Erkenntnisse liefern, um intelligentere Geschäftsentscheidungen zu ermöglichen. Entdecken Sie jetzt das perfekte Tool, um Ihren KI-Vorteil voll auszuschöpfen!
14 Tools
xix.ai

2026: Die aktuell besten und am besten bewerteten KI-Hausaufgabenhelfer, die nicht nur Antworten liefern, sondern auch Kernkonzepte vermitteln – leistungsstarke Tools für Schüler und Studenten. Eine kuratierte Liste, die Sie unbedingt ausprobieren sollten. Wöchentlich aktualisiert. Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten. Praxistests. Genaue Rankings, die Ihnen helfen, Ihr volles Lernpotenzial auszuschöpfen. Entdecken Sie jetzt das perfekte Tool für intelligenteres Lernen.
10 Tools
xix.ai












