


 Lar
A SenseTime apresenta um modelo multimodal leve de 8 bilhões de parâmetros com saída nativa em 4K e recursos completos de edição visual
A SenseTime lançou oficialmente o SenseNova U1.5Lite, um novo modelo multimodal unificado, leve e nativo de grande porte. Com 8 bilhões de parâmetros, esse modelo eficiente supera alternativas de tamanho semelhante em tarefas visuais essenciais e se equipara a modelos comerciais de grande escala em cenários complexos de layout e renderização de texto.
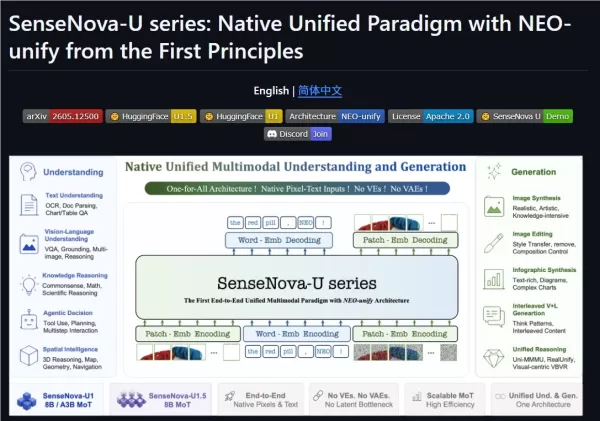
Com suporte nativo a comprimentos de contexto de 3 mil a 4 mil, o SenseNova U1.5Lite gerencia simultaneamente várias restrições — incluindo assunto, quantidade, relações espaciais, texto, layout e estilo —, garantindo maior estabilidade para operações visuais complexas.
O modelo apresenta várias atualizações essenciais. Primeiro, oferece geração visual de maior qualidade ao aprimorar composição, cor, material, iluminação, realismo e detalhes locais, evitando efetivamente o problema comum de resultados localmente corretos, mas globalmente incompletos. Em segundo lugar, oferece uma edição de imagem nativa robusta, preservando melhor a identidade do objeto, a estrutura espacial, o layout e as áreas não editáveis, ao mesmo tempo em que aprimora modificações locais, substituição de elementos, refinamento de texto e edição com múltiplas referências.
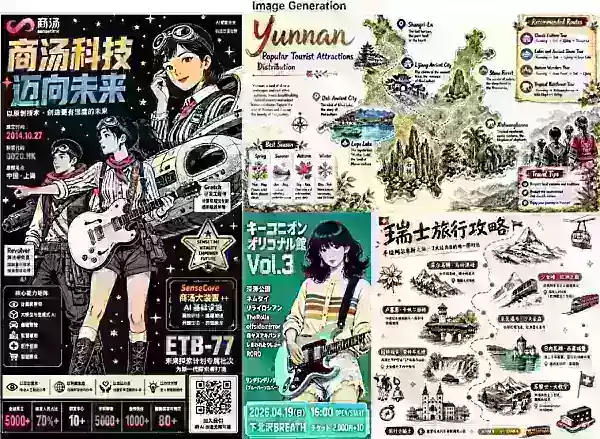
Além disso, o modelo se destaca no tratamento de textos e layouts complexos, fortalecendo suas capacidades em textos em chinês e inglês, pôsteres, infográficos, recursos visuais de marcas e formatação multitesto para alcançar uma expressão visual completa. Para um controle preciso, ele suporta Bounding Box, Visual Marker e referências de uma ou várias imagens. Notavelmente, ele alcança uma saída nativa em alta resolução 4K, mantendo tanto a composição macro quanto as texturas finas, textos pequenos e efeitos de iluminação.
Endereço do projeto: https://github.com/OpenSenseNova/SenseNova-U1
Artigo relacionado
 A Claude revela o primeiro mapa completo do céu ultravioleta, mapeando 119 milhões de estrelas
Com o poderoso auxílio do Claude, o modelo de linguagem grande da Anthropic, astrofísicos geraram com sucesso o primeiro mapa completo do céu inteiro em ultravioleta da história. Este vasto mapa estelar, que apresenta 119 milhões de estrelas, foi amp
Como a AWS e a NVIDIA estão impulsionando a IA agentiva e a IA física
Jensen Huang, CEO da NVIDIA (Crédito: Tomohiro Ohsumi/Getty Images)A NVIDIA, de Jensen Huang, e a AWS ampliam sua parceria global, implantando 2 milhões de GPUs para impulsionar a infraestrutura empre
Robô de Treinamento de Ondas Cerebrais: O Próximo Salto da IA Física Impulsionado por Sinais do Cérebro Humano
Em um armazém em San Leandro, Califórnia, a Encord, uma empresa de ferramentas de dados, está conduzindo um experimento inovador: "pilotos" usam headsets com câmeras e sensores de EEG enquanto jogam Jenga para capturar a atividade cerebral. O headset
Recomendações de tópicos especiais relacionados
Design e Arte
 As melhores ferramentas de ilustração com IA: crie cenas editoriais e capas de forma mais rápida
As melhores ferramentas de ilustração com IA de 2026: nossa lista selecionada apresenta as melhores ferramentas, com design robusto, para criar rapidamente cenas editoriais impressionantes e capas atraentes. Cada opção passou por rigorosos testes práticos, oferecendo uma comparação entre versões gratuitas e pagas para ajudar você a encontrar a opção perfeita para o seu fluxo de trabalho. Experimente hoje mesmo essas soluções imperdíveis para aproveitar ao máximo as vantagens da IA e impulsionar sua produtividade criativa. Explore agora no XIX.AI.
 10 ferramentas
 xix.ai
Educação e Aprendizagem
Os melhores professores particulares especializados em IA para preparação para exames: pratique matemática, ciências e inglês
Os melhores tutores de IA para preparação para exames de 2026, com as melhores avaliações, estão aqui no XIX.AI! Nossa lista cuidadosamente selecionada apresenta ferramentas poderosas e revolucionárias que oferecem comparação entre versões gratuitas e pagas, testes práticos e rankings atualizados semanalmente. Elas ajudam a aumentar sua eficiência na redação, simplificar o aprendizado de tópicos complexos e liberar seu potencial acadêmico. Explore agora para descobrir sua ferramenta perfeita de preparação para exames e comece a criar hoje mesmo para aproveitar toda a vantagem da IA!
10 ferramentas
xix.ai
Financiar
Ferramentas de planejamento orçamentário com IA para gestão financeira pessoal
As melhores e mais bem avaliadas ferramentas de planejamento orçamentário com IA para gestão financeira pessoal de 2026 estão aqui no XIX.AI! Esta seleção especial apresenta soluções poderosas e revolucionárias que ajudam você a realizar testes na prática, entender hábitos de consumo e criar planos personalizados para aumentar a produtividade. Confira uma comparação entre versões gratuitas e pagas, além de rankings detalhados. Ferramentas imperdíveis, projetadas para simplificar a gestão financeira e explorar o potencial da IA. Explore agora!
11 ferramentas
xix.ai
Saúde e Bem-Estar
Assistentes de rastreamento do sono com IA: melhore sua recuperação adotando hábitos mais adequados antes de dormir
2026 – Os melhores assistentes de rastreamento do sono com inteligência artificial mais bem avaliados, selecionados para proporcionar uma recuperação máxima. Este guia semanal completamente atualizado apresenta ferramentas poderosas que incluem testes reais, comparações entre versões gratuitas e pagas, além de classificações detalhadas, visando ajudá-lo a encontrar a solução ideal para melhorar a qualidade do sono e fomentar hábitos noturnos mais saudáveis. Explore agora em XIX.AI e aproveite todas as vantagens oferecidas pela inteligência artificial.
10 ferramentas
xix.ai
Análise de dados
Copilotos de IA em SQL para análise de produtos e receitas
2026: Os melhores e mais bem avaliados copilotos de IA para SQL em análise de produtos e receitas! A XIX.AI selecionou um conjunto poderoso e revolucionário de ferramentas imperdíveis, que passam por testes práticos por meio de rankings atualizados semanalmente. Essas ferramentas ajudam os usuários a aumentar significativamente a produtividade, acelerando a análise de dados, simplificando consultas complexas e gerando insights precisos para impulsionar decisões de negócios mais inteligentes. Explore agora e descubra a ferramenta perfeita para aproveitar ao máximo o potencial da IA!
14 ferramentas
xix.ai
Educação e Aprendizagem
Os melhores auxiliares de tarefas escolares com IA que ensinam: aprenda conceitos, não apenas respostas
2026: Os melhores e mais bem avaliados auxiliares de tarefas com IA que ensinam conceitos fundamentais, não apenas respostas. Ferramentas poderosas para estudantes. Lista selecionada que você não pode deixar de conferir. Atualizada semanalmente. Comparação entre versões gratuitas e pagas. Testes em situações reais. Rankings precisos para ajudar você a atingir todo o seu potencial de aprendizado. Explore agora e descubra a ferramenta perfeita para estudar de forma mais inteligente.
10 ferramentas
xix.ai

 Comentários (0)
A SenseTime lançou oficialmente o SenseNova U1.5Lite, um novo modelo multimodal unificado, leve e nativo de grande porte. Com 8 bilhões de parâmetros, esse modelo eficiente supera alternativas de tamanho semelhante em tarefas visuais essenciais e se equipara a modelos comerciais de grande escala em cenários complexos de layout e renderização de texto.
Com suporte nativo a comprimentos de contexto de 3 mil a 4 mil, o SenseNova U1.5Lite gerencia simultaneamente várias restrições — incluindo assunto, quantidade, relações espaciais, texto, layout e estilo —, garantindo maior estabilidade para operações visuais complexas.
O modelo apresenta várias atualizações essenciais. Primeiro, oferece geração visual de maior qualidade ao aprimorar composição, cor, material, iluminação, realismo e detalhes locais, evitando efetivamente o problema comum de resultados localmente corretos, mas globalmente incompletos. Em segundo lugar, oferece uma edição de imagem nativa robusta, preservando melhor a identidade do objeto, a estrutura espacial, o layout e as áreas não editáveis, ao mesmo tempo em que aprimora modificações locais, substituição de elementos, refinamento de texto e edição com múltiplas referências.
Além disso, o modelo se destaca no tratamento de textos e layouts complexos, fortalecendo suas capacidades em textos em chinês e inglês, pôsteres, infográficos, recursos visuais de marcas e formatação multitesto para alcançar uma expressão visual completa. Para um controle preciso, ele suporta Bounding Box, Visual Marker e referências de uma ou várias imagens. Notavelmente, ele alcança uma saída nativa em alta resolução 4K, mantendo tanto a composição macro quanto as texturas finas, textos pequenos e efeitos de iluminação.
Endereço do projeto: https://github.com/OpenSenseNova/SenseNova-U1








 A Claude revela o primeiro mapa completo do céu ultravioleta, mapeando 119 milhões de estrelas
Com o poderoso auxílio do Claude, o modelo de linguagem grande da Anthropic, astrofísicos geraram com sucesso o primeiro mapa completo do céu inteiro em ultravioleta da história. Este vasto mapa estelar, que apresenta 119 milhões de estrelas, foi amp
 Como a AWS e a NVIDIA estão impulsionando a IA agentiva e a IA física
Jensen Huang, CEO da NVIDIA (Crédito: Tomohiro Ohsumi/Getty Images)A NVIDIA, de Jensen Huang, e a AWS ampliam sua parceria global, implantando 2 milhões de GPUs para impulsionar a infraestrutura empre
 Robô de Treinamento de Ondas Cerebrais: O Próximo Salto da IA Física Impulsionado por Sinais do Cérebro Humano
Em um armazém em San Leandro, Califórnia, a Encord, uma empresa de ferramentas de dados, está conduzindo um experimento inovador: "pilotos" usam headsets com câmeras e sensores de EEG enquanto jogam Jenga para capturar a atividade cerebral. O headset

As melhores ferramentas de ilustração com IA de 2026: nossa lista selecionada apresenta as melhores ferramentas, com design robusto, para criar rapidamente cenas editoriais impressionantes e capas atraentes. Cada opção passou por rigorosos testes práticos, oferecendo uma comparação entre versões gratuitas e pagas para ajudar você a encontrar a opção perfeita para o seu fluxo de trabalho. Experimente hoje mesmo essas soluções imperdíveis para aproveitar ao máximo as vantagens da IA e impulsionar sua produtividade criativa. Explore agora no XIX.AI.
10 ferramentas
xix.ai

Os melhores tutores de IA para preparação para exames de 2026, com as melhores avaliações, estão aqui no XIX.AI! Nossa lista cuidadosamente selecionada apresenta ferramentas poderosas e revolucionárias que oferecem comparação entre versões gratuitas e pagas, testes práticos e rankings atualizados semanalmente. Elas ajudam a aumentar sua eficiência na redação, simplificar o aprendizado de tópicos complexos e liberar seu potencial acadêmico. Explore agora para descobrir sua ferramenta perfeita de preparação para exames e comece a criar hoje mesmo para aproveitar toda a vantagem da IA!
10 ferramentas
xix.ai

As melhores e mais bem avaliadas ferramentas de planejamento orçamentário com IA para gestão financeira pessoal de 2026 estão aqui no XIX.AI! Esta seleção especial apresenta soluções poderosas e revolucionárias que ajudam você a realizar testes na prática, entender hábitos de consumo e criar planos personalizados para aumentar a produtividade. Confira uma comparação entre versões gratuitas e pagas, além de rankings detalhados. Ferramentas imperdíveis, projetadas para simplificar a gestão financeira e explorar o potencial da IA. Explore agora!
11 ferramentas
xix.ai

2026 – Os melhores assistentes de rastreamento do sono com inteligência artificial mais bem avaliados, selecionados para proporcionar uma recuperação máxima. Este guia semanal completamente atualizado apresenta ferramentas poderosas que incluem testes reais, comparações entre versões gratuitas e pagas, além de classificações detalhadas, visando ajudá-lo a encontrar a solução ideal para melhorar a qualidade do sono e fomentar hábitos noturnos mais saudáveis. Explore agora em XIX.AI e aproveite todas as vantagens oferecidas pela inteligência artificial.
10 ferramentas
xix.ai

2026: Os melhores e mais bem avaliados copilotos de IA para SQL em análise de produtos e receitas! A XIX.AI selecionou um conjunto poderoso e revolucionário de ferramentas imperdíveis, que passam por testes práticos por meio de rankings atualizados semanalmente. Essas ferramentas ajudam os usuários a aumentar significativamente a produtividade, acelerando a análise de dados, simplificando consultas complexas e gerando insights precisos para impulsionar decisões de negócios mais inteligentes. Explore agora e descubra a ferramenta perfeita para aproveitar ao máximo o potencial da IA!
14 ferramentas
xix.ai

2026: Os melhores e mais bem avaliados auxiliares de tarefas com IA que ensinam conceitos fundamentais, não apenas respostas. Ferramentas poderosas para estudantes. Lista selecionada que você não pode deixar de conferir. Atualizada semanalmente. Comparação entre versões gratuitas e pagas. Testes em situações reais. Rankings precisos para ajudar você a atingir todo o seu potencial de aprendizado. Explore agora e descubra a ferramenta perfeita para estudar de forma mais inteligente.
10 ferramentas
xix.ai












