


 Hogar
SenseTime presenta un modelo multimodal ligero de 8 mil millones con salida nativa en 4K y capacidades completas de edición visual
SenseTime ha lanzado oficialmente SenseNova U1.5Lite, un nuevo modelo multimodal unificado, ligero y nativo de gran tamaño. Con 8.000 millones de parámetros, este eficiente modelo supera a otras alternativas de tamaño similar en tareas visuales clave y está a la altura de los modelos comerciales a gran escala en escenarios complejos de maquetación y representación de texto.
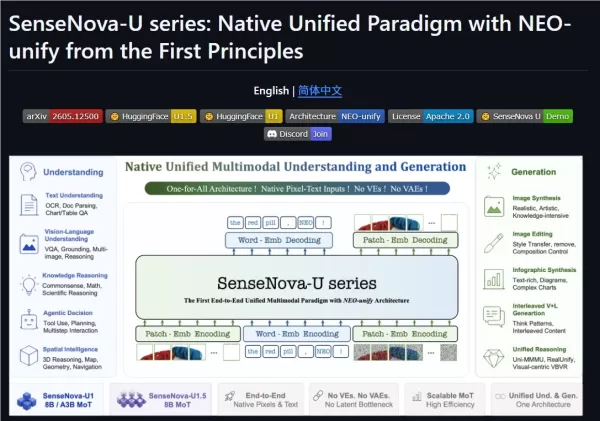
Compatible de forma nativa con longitudes de contexto de entre 3 000 y 4 000, SenseNova U1.5Lite gestiona simultáneamente múltiples restricciones —entre ellas, el sujeto, la cantidad, las relaciones espaciales, el texto, el diseño y el estilo—, lo que garantiza una mayor estabilidad en operaciones visuales complejas.
El modelo introduce varias mejoras fundamentales. En primer lugar, ofrece una generación visual de mayor calidad al mejorar la composición, el color, los materiales, la iluminación, el realismo y los detalles locales, lo que evita de forma eficaz el problema habitual de resultados localmente correctos pero globalmente incompletos. En segundo lugar, ofrece una sólida edición nativa de imágenes, conservando mejor la identidad del sujeto, la estructura espacial, la maquetación y las áreas no editables, al tiempo que mejora las modificaciones locales, la sustitución de elementos, el refinamiento del texto y la edición con múltiples referencias.
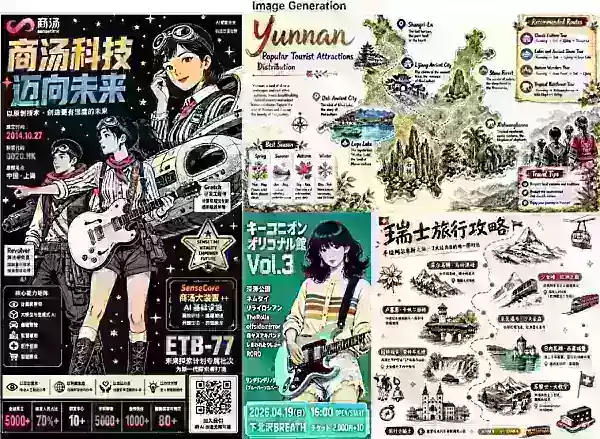
Además, el modelo destaca en el manejo de texto y diseños complejos, reforzando sus capacidades en texto en chino e inglés, carteles, infografías, elementos visuales de marca y formato multitexto para lograr una expresión visual completa. Para un control preciso, admite el uso de recuadros delimitadores, marcadores visuales y referencias de una o varias imágenes. Cabe destacar que ofrece una salida nativa en alta resolución 4K, conservando tanto la composición general como las texturas finas, el texto pequeño y los efectos de iluminación.
Dirección del proyecto: https://github.com/OpenSenseNova/SenseNova-U1
Artículo relacionado
 Claude presenta el primer mapa completo del cielo en ultravioleta, que cartografía 119 millones de estrellas
Con la poderosa asistencia de Claude, el modelo de lenguaje grande de Anthropic, los astrofísicos han generado con éxito el primer mapa completo del cielo en ultravioleta de la historia. Este vasto catálogo estelar, que incluye 119 millones de estrel
Cómo AWS y NVIDIA están impulsando la IA agentiva y la IA física
Jensen Huang, director ejecutivo de NVIDIA (Crédito: Tomohiro Ohsumi/Getty Images)NVIDIA, de Jensen Huang, y AWS amplían su colaboración global con el despliegue de 2 millones de GPU para impulsar la
Robot de entrenamiento de ondas cerebrales: el próximo avance de la IA física impulsado por señales del cerebro humano
En un almacén de San Leandro, California, Encord, una empresa de herramientas de datos, está llevando a cabo un experimento innovador: los "pilotos" llevan cascos con cámaras y sensores EEG mientras juegan al Jenga para capturar la actividad cerebral
Recomendaciones de temas especiales relacionados
Diseño y Arte
 Las mejores herramientas de ilustración con IA: crea escenas editoriales y portadas más rápido
Las mejores herramientas de ilustración con IA de 2026: nuestra lista seleccionada incluye las mejores herramientas, diseñadas con gran potencia, para crear rápidamente impresionantes escenas editoriales y llamativas portadas. Cada opción ha sido sometida a rigurosas pruebas en condiciones reales y ofrece una comparación entre las versiones gratuitas y de pago para ayudarte a encontrar la que mejor se adapte a tu flujo de trabajo. Prueba hoy mismo estas soluciones imprescindibles para sacar el máximo partido a la IA y potenciar tu productividad creativa. Descúbrelas ahora en XIX.AI.
 10 herramientas
 xix.ai
Educación y aprendizaje
Los mejores profesores particulares de IA para la preparación de exámenes: practica matemáticas, ciencias e inglés
¡Ya están aquí, en XIX.AI, los mejores tutores de IA para la preparación de exámenes de 2026, con las mejores valoraciones! Nuestra lista seleccionada incluye potentes herramientas revolucionarias que ofrecen comparativas entre versiones gratuitas y de pago, pruebas reales y clasificaciones actualizadas semanalmente. Te ayudan a mejorar tu eficiencia a la hora de escribir, a simplificar el aprendizaje de temas complejos y a desarrollar todo tu potencial académico. ¡Explora ahora mismo para descubrir tu herramienta perfecta de preparación de exámenes y empieza a crear hoy mismo para sacar partido a tu ventaja con la IA!
10 herramientas
xix.ai
Finanzas
Herramientas de planificación presupuestaria con IA para la gestión personal del dinero
2026 Últimas Mejores Herramientas de Planificación Presupuestaria con IA Mejor Valoradas para la Gestión Personal del Dinero están aquí en XIX.AI. Esta colección seleccionada presenta soluciones poderosas y transformadoras que te ayudan a realizar pruebas en el mundo real, comprender tus hábitos de gasto y crear planes personalizados para aumentar la productividad. Disfruta de una comparación entre versiones gratuitas y de pago junto con clasificaciones detalladas. Herramientas imprescindibles diseñadas para simplificar la gestión del dinero y desbloquear tu ventaja con IA. ¡Explóralas ahora!
11 herramientas
xix.ai
Salud y bienestar
Asistentes de seguimiento del sueño basados en IA: mejora tu recuperación con mejores hábitos a la hora de acostarte
Los mejores asistentes de seguimiento del sueño con IA de 2026, seleccionados para una recuperación óptima. Esta guía semanal totalmente actualizada incluye potentes herramientas que ofrecen pruebas en condiciones reales, comparativas entre opciones gratuitas y de pago, y clasificaciones detalladas para ayudarte a encontrar la solución imprescindible que mejora la calidad del sueño y fomenta mejores hábitos a la hora de acostarse. Descúbrelo ahora en XIX.AI y aprovecha todas las ventajas de la IA.
10 herramientas
xix.ai
Análisis de datos
Copilotos de IA y SQL para el análisis de productos e ingresos
¡Los mejores copilotos de IA para SQL mejor valorados de 2026 para el análisis de productos e ingresos! XIX.AI ha seleccionado una potente colección de herramientas revolucionarias que no te puedes perder y que se someten a pruebas en el mundo real a través de clasificaciones que se actualizan semanalmente. Estas herramientas ayudan a los usuarios a aumentar significativamente su productividad al acelerar el análisis de datos, simplificar consultas complejas y generar información precisa para tomar decisiones empresariales más inteligentes. ¡Explora ahora mismo y descubre la herramienta perfecta para sacar el máximo partido a tu ventaja en IA!
14 herramientas
xix.ai
Educación y aprendizaje
Las mejores herramientas de IA para los deberes que realmente enseñan: aprende conceptos, no solo respuestas
2026: los mejores y más valorados asistentes de deberes con IA que enseñan conceptos básicos, no solo respuestas. Potentes herramientas para estudiantes. Una selección imprescindible que debes probar. Actualización semanal. Comparativa entre opciones gratuitas y de pago. Pruebas en el mundo real. Clasificaciones precisas para ayudarte a desarrollar todo tu potencial de aprendizaje. Explora ahora y descubre la herramienta perfecta para estudiar de forma más inteligente.
10 herramientas
xix.ai

 comentario (0)
0/500
SenseTime ha lanzado oficialmente SenseNova U1.5Lite, un nuevo modelo multimodal unificado, ligero y nativo de gran tamaño. Con 8.000 millones de parámetros, este eficiente modelo supera a otras alternativas de tamaño similar en tareas visuales clave y está a la altura de los modelos comerciales a gran escala en escenarios complejos de maquetación y representación de texto.
Compatible de forma nativa con longitudes de contexto de entre 3 000 y 4 000, SenseNova U1.5Lite gestiona simultáneamente múltiples restricciones —entre ellas, el sujeto, la cantidad, las relaciones espaciales, el texto, el diseño y el estilo—, lo que garantiza una mayor estabilidad en operaciones visuales complejas.
El modelo introduce varias mejoras fundamentales. En primer lugar, ofrece una generación visual de mayor calidad al mejorar la composición, el color, los materiales, la iluminación, el realismo y los detalles locales, lo que evita de forma eficaz el problema habitual de resultados localmente correctos pero globalmente incompletos. En segundo lugar, ofrece una sólida edición nativa de imágenes, conservando mejor la identidad del sujeto, la estructura espacial, la maquetación y las áreas no editables, al tiempo que mejora las modificaciones locales, la sustitución de elementos, el refinamiento del texto y la edición con múltiples referencias.
Además, el modelo destaca en el manejo de texto y diseños complejos, reforzando sus capacidades en texto en chino e inglés, carteles, infografías, elementos visuales de marca y formato multitexto para lograr una expresión visual completa. Para un control preciso, admite el uso de recuadros delimitadores, marcadores visuales y referencias de una o varias imágenes. Cabe destacar que ofrece una salida nativa en alta resolución 4K, conservando tanto la composición general como las texturas finas, el texto pequeño y los efectos de iluminación.
Dirección del proyecto: https://github.com/OpenSenseNova/SenseNova-U1








 Claude presenta el primer mapa completo del cielo en ultravioleta, que cartografía 119 millones de estrellas
Con la poderosa asistencia de Claude, el modelo de lenguaje grande de Anthropic, los astrofísicos han generado con éxito el primer mapa completo del cielo en ultravioleta de la historia. Este vasto catálogo estelar, que incluye 119 millones de estrel
 Cómo AWS y NVIDIA están impulsando la IA agentiva y la IA física
Jensen Huang, director ejecutivo de NVIDIA (Crédito: Tomohiro Ohsumi/Getty Images)NVIDIA, de Jensen Huang, y AWS amplían su colaboración global con el despliegue de 2 millones de GPU para impulsar la
 Robot de entrenamiento de ondas cerebrales: el próximo avance de la IA física impulsado por señales del cerebro humano
En un almacén de San Leandro, California, Encord, una empresa de herramientas de datos, está llevando a cabo un experimento innovador: los "pilotos" llevan cascos con cámaras y sensores EEG mientras juegan al Jenga para capturar la actividad cerebral

Las mejores herramientas de ilustración con IA de 2026: nuestra lista seleccionada incluye las mejores herramientas, diseñadas con gran potencia, para crear rápidamente impresionantes escenas editoriales y llamativas portadas. Cada opción ha sido sometida a rigurosas pruebas en condiciones reales y ofrece una comparación entre las versiones gratuitas y de pago para ayudarte a encontrar la que mejor se adapte a tu flujo de trabajo. Prueba hoy mismo estas soluciones imprescindibles para sacar el máximo partido a la IA y potenciar tu productividad creativa. Descúbrelas ahora en XIX.AI.
10 herramientas
xix.ai

¡Ya están aquí, en XIX.AI, los mejores tutores de IA para la preparación de exámenes de 2026, con las mejores valoraciones! Nuestra lista seleccionada incluye potentes herramientas revolucionarias que ofrecen comparativas entre versiones gratuitas y de pago, pruebas reales y clasificaciones actualizadas semanalmente. Te ayudan a mejorar tu eficiencia a la hora de escribir, a simplificar el aprendizaje de temas complejos y a desarrollar todo tu potencial académico. ¡Explora ahora mismo para descubrir tu herramienta perfecta de preparación de exámenes y empieza a crear hoy mismo para sacar partido a tu ventaja con la IA!
10 herramientas
xix.ai

2026 Últimas Mejores Herramientas de Planificación Presupuestaria con IA Mejor Valoradas para la Gestión Personal del Dinero están aquí en XIX.AI. Esta colección seleccionada presenta soluciones poderosas y transformadoras que te ayudan a realizar pruebas en el mundo real, comprender tus hábitos de gasto y crear planes personalizados para aumentar la productividad. Disfruta de una comparación entre versiones gratuitas y de pago junto con clasificaciones detalladas. Herramientas imprescindibles diseñadas para simplificar la gestión del dinero y desbloquear tu ventaja con IA. ¡Explóralas ahora!
11 herramientas
xix.ai

Los mejores asistentes de seguimiento del sueño con IA de 2026, seleccionados para una recuperación óptima. Esta guía semanal totalmente actualizada incluye potentes herramientas que ofrecen pruebas en condiciones reales, comparativas entre opciones gratuitas y de pago, y clasificaciones detalladas para ayudarte a encontrar la solución imprescindible que mejora la calidad del sueño y fomenta mejores hábitos a la hora de acostarse. Descúbrelo ahora en XIX.AI y aprovecha todas las ventajas de la IA.
10 herramientas
xix.ai

¡Los mejores copilotos de IA para SQL mejor valorados de 2026 para el análisis de productos e ingresos! XIX.AI ha seleccionado una potente colección de herramientas revolucionarias que no te puedes perder y que se someten a pruebas en el mundo real a través de clasificaciones que se actualizan semanalmente. Estas herramientas ayudan a los usuarios a aumentar significativamente su productividad al acelerar el análisis de datos, simplificar consultas complejas y generar información precisa para tomar decisiones empresariales más inteligentes. ¡Explora ahora mismo y descubre la herramienta perfecta para sacar el máximo partido a tu ventaja en IA!
14 herramientas
xix.ai

2026: los mejores y más valorados asistentes de deberes con IA que enseñan conceptos básicos, no solo respuestas. Potentes herramientas para estudiantes. Una selección imprescindible que debes probar. Actualización semanal. Comparativa entre opciones gratuitas y de pago. Pruebas en el mundo real. Clasificaciones precisas para ayudarte a desarrollar todo tu potencial de aprendizaje. Explora ahora y descubre la herramienta perfecta para estudiar de forma más inteligente.
10 herramientas
xix.ai












