


 Heim
Deutsches Forschungskonsortium stellt Open-Source-KI-Modell Soofi vor
Der Deutsche Verein für Künstliche Intelligenz hat offiziell Soofi S30B-A3B veröffentlicht, ein neues Open-Source-Großes Sprachmodell. Dieser Meilenstein fördert Europas souveräne KI-Infrastruktur und belebt den Open-Source-Sektor mit Fokus auf hohe Leistung und Effizienz wieder.
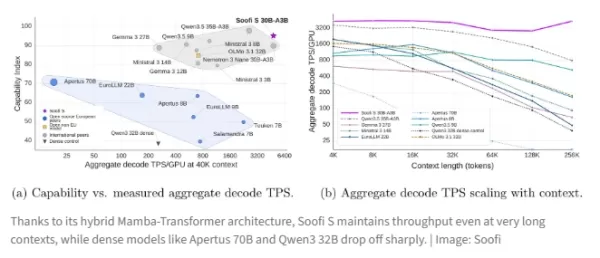
Soofi S30B-A3B zeichnet sich durch eine innovative Architektur aus, die Effizienz und Leistungsfähigkeit in Einklang bringt. Unter Verwendung eines Mixture-of-Experts-(MoE)-Designs in Kombination mit Mamba-2 und Standard-Aufmerksamkeitslagen enthält das Modell 31,6 Milliarden Parameter, aktiviert jedoch nur ca. 3,2 Milliarden pro Token. Dieser Ansatz reduziert die Rechenkosten drastisch und liefert Geschwindigkeiten, die kleineren Modellen entsprechen, während gleichzeitig ein hoher Durchsatz aufrechterhalten wird. Bemerkenswerterweise verarbeitet es lange Kontexte (bis zu 40.000 Token) mit der achtfachen Generierungsdurchsatzleistung traditioneller dichter Modelle und gewährleistet so Stabilität, selbst wenn die Kontextlänge zunimmt.
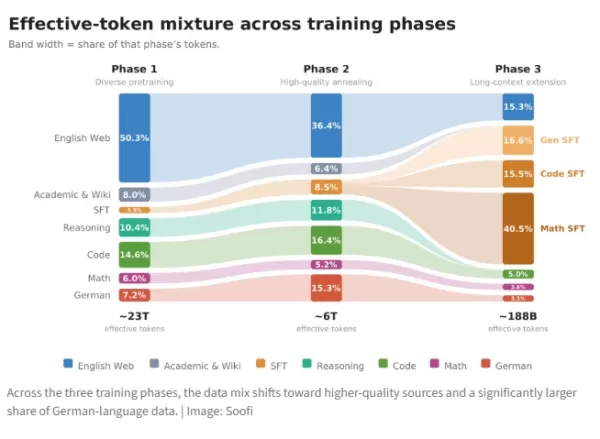
Beim Training stand die Beherrschung der deutschen Sprache im Vordergrund. Über 27 Billionen Token hinweg erhöhte das Team den Anteil deutscher Daten von 7,2 % auf 15,3 % und integrierte diverse Quellen wie Wikipedia, Nachrichten und technische Dokumente. Diese Strategie gewährleistet eine herausragende Leistung bei komplexen Aufgaben in deutscher Sprache.
Benchmark-Ergebnisse bestätigen die Führungsposition von Soofi S30B-A3B unter den Open-Source-Modellen in Englisch und Deutsch, wobei es OLMo332B und Apertus70B übertrifft. Es glänzt bei der Codegenerierung, professioneller Schlussfolgerung und regionalem Wissen. Das Team weist jedoch auf Verbesserungsbedarf bei der Extraktion ultra-langer Kontexte und der mathematischen Schlussfolgerung in deutscher Sprache hin.
Das Projekt wurde in der Industrial AI Cloud der Deutschen Telekom in München unter Verwendung von 512 Nvidia B200 GPUs trainiert und ist Teil der europäischen IPCEI-CIS-Initiative. Vollständig mit erneuerbaren Energien betrieben, werden die Modellgewichte, der Auswertungscode und die Datenlisten schrittweise als Open Source freigegeben. Diese Transparenz unterstützt europäische industrielle Anwendungen, und das Team sucht derzeit nach Industriepartnern, um Anwendungen in technischer Dokumentation und Codegenerierung zu erkunden.
Verwandter Artikel
 Toytas Schätzung von 6,4 Milliarden US-Dollar für Robotik rückt Physical AI in den Fokus
Toyota Motor geht davon aus, dass die flächendeckende Einführung der Automatisierung in ihren Fertigungsstätten, Tochtergesellschaften und wichtigsten Zulieferern ab 2028 etwa 400.000 Roboter und jährliche Ausgaben von rund einer Billion Yen (6,4 Mil
Meta Open-Sources 30B-Parameter Muse Glimmer für Lokale KI-Agenten auf Consumer-Hardware
Am 10. August hat Meta Muse Glimmer veröffentlicht, ein Open-Source-Modell, das darauf abzielt, lokale KI-Agenten auf Consumer-Hardware zu stärken, und damit einen wichtigen Schritt in seiner Strategie der „Personal Superintelligence“ darstellt. Mit
GPT-5.6 könnte nächste Woche starten, mit Fokus auf agentenbasierte operative Fähigkeiten
Die wettbewerbsintensive Landschaft der künstlichen Intelligenz verdichtet sich rasant. Aktuelle Lecks bezüglich Testupdates haben das neue Flaggschiff-Modell GPT-5.6 in den Fokus gerückt. Der Marktkonsens deutet auf einen offiziellen Start im zweite
Empfehlungen zu verwandten Spezialthemen
Produktivität
 KI-Tools zur Aufgabenplanung für vielbeschäftigte Berufstätige
Die besten und am besten bewerteten KI-Tools zur Aufgabenplanung für vielbeschäftigte Berufstätige im Jahr 2026! XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung hocheffizienter Tools zusammengestellt, die Nutzern dabei helfen, Arbeitsabläufe zu optimieren, die Produktivität zu steigern und die täglichen Herausforderungen bei der Terminplanung zu meistern. Jede Option durchläuft strenge Praxistests, um ihre Zuverlässigkeit sicherzustellen. Holen Sie sich einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten und entdecken Sie das perfekte Tool, um Ihren KI-Vorteil auszuschöpfen. Jetzt entdecken!
 15 Tools
 xix.ai
Chatbot
Top-KI-Kundenservice-Chatbots: Beantworten Sie FAQs und qualifizieren Sie Leads rund um die Uhr
Die in dieser kuratierten Liste vorgestellten, 2026 aktuell am besten bewerteten KI-Kundenservice-Chatbots sind die besten Lösungen, um Kunden-Fragenkataloge (FAQs) sofort zu beantworten und Leads rund um die Uhr zu qualifizieren. XIX.AI hat strenge Praxistests durchgeführt, um einen detaillierten kostenlosen versus kostenpflichtigen Vergleich sowie aktuelle Rankings bereitzustellen, die Ihnen helfen, ein leistungsstarkes, produktivitätssteigerndes Werkzeug zu finden. Entdecken Sie jetzt Ihre perfekte KI-Chatbot-Lösung!
9 Tools
xix.ai
Design & Kunst
KI-Storyboard-Generatoren für Kreativteams in der Werbung
Die besten KI-Storyboard-Generatoren 2026 für Werbekreativteams! XIX.AI hat anhand von Praxistests und strengen, wöchentlich aktualisierten Rankings eine Liste der besten leistungsstarken, bahnbrechenden Tools zusammengestellt, mit denen Teams atemberaubende visuelle Inhalte schneller erstellen können. Nutzen Sie den Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, um die perfekte Lösung für Ihren Arbeitsablauf zu finden. Entdecken Sie jetzt die Möglichkeiten und sichern Sie sich Ihren KI-Vorteil bei der Werbegestaltung!
8 Tools
xix.ai
Chatbot
Werkzeuge für KI-gestützte Wissens-Chatbots für interne Dokumentation
2026 Neueste Besten Top-bewertete KI-Wissens-Chatbot-Tools für interne Dokumentation sind hier auf XIX.AI! Diese kuratierte Liste enthält leistungsstarke, bahnbrechende Lösungen, die die Produktivität erheblich steigern, indem sie Teams dabei helfen, schnell hochwertige Inhalte zu generieren, Dokumentationen zu optimieren und häufige Schreibherausforderungen zu bewältigen. Wir führen strenge Praxistests durch und bieten eine wöchentlich aktualisierte kostenlose vs. kostenpflichtige Vergleichstabelle sowie detaillierte Rankings, um Ihnen zu helfen, die beste Option für Ihre Bedürfnisse zu finden. Entdecken Sie jetzt Ihr perfektes Tool!
12 Tools
xix.ai
Text-zu-Sprache
Die besten KI-Text-zu-Sprache-Tools: Erstellen Sie natürliche Sprachausgaben für Videos
2026 Neueste Besten Top-bewertete KI Text-zu-Sprache-Tools Ausgewählt zur Erstellung natürlicher Sprachausgaben in Videos. XIX.AI bietet leistungsstarke, bahnbrechende Lösungen, die die Schreibeffizienz steigern und Ihnen helfen, Kreativitätsengpässe zu durchbrechen. Wir führen Praxistests durch, bieten kostenlose vs. kostenpflichtige Vergleiche und aktualisieren unsere Ranglisten wöchentlich. Empfohlene Optionen werden basierend auf strengen Bewertungen hervorgehoben. Entdecken Sie jetzt Ihr perfektes Tool zur Verbesserung der Videoqualität.
9 Tools
xix.ai
Finanzen
Die besten KI-Tools zur Betrugserkennung: Verdächtige Muster erkennen, bevor Verluste entstehen
Die von XIX.AI zusammengestellten besten und am besten bewerteten KI-Tools zur Betrugserkennung für das Jahr 2026 bieten leistungsstarke, bahnbrechende Lösungen, um verdächtige Muster schnell zu erkennen und kostspielige Verluste zu verhindern. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, Praxistests und detaillierte Rankings, die Ihnen dabei helfen, die beste Option auszuwählen, mit der Sie Ihre Sicherheitseffizienz steigern können. Entdecken Sie jetzt, wie Sie Ihren KI-Vorsprung nutzen können.
10 Tools
xix.ai

 Kommentare (0)
Der Deutsche Verein für Künstliche Intelligenz hat offiziell Soofi S30B-A3B veröffentlicht, ein neues Open-Source-Großes Sprachmodell. Dieser Meilenstein fördert Europas souveräne KI-Infrastruktur und belebt den Open-Source-Sektor mit Fokus auf hohe Leistung und Effizienz wieder.
Soofi S30B-A3B zeichnet sich durch eine innovative Architektur aus, die Effizienz und Leistungsfähigkeit in Einklang bringt. Unter Verwendung eines Mixture-of-Experts-(MoE)-Designs in Kombination mit Mamba-2 und Standard-Aufmerksamkeitslagen enthält das Modell 31,6 Milliarden Parameter, aktiviert jedoch nur ca. 3,2 Milliarden pro Token. Dieser Ansatz reduziert die Rechenkosten drastisch und liefert Geschwindigkeiten, die kleineren Modellen entsprechen, während gleichzeitig ein hoher Durchsatz aufrechterhalten wird. Bemerkenswerterweise verarbeitet es lange Kontexte (bis zu 40.000 Token) mit der achtfachen Generierungsdurchsatzleistung traditioneller dichter Modelle und gewährleistet so Stabilität, selbst wenn die Kontextlänge zunimmt.
Beim Training stand die Beherrschung der deutschen Sprache im Vordergrund. Über 27 Billionen Token hinweg erhöhte das Team den Anteil deutscher Daten von 7,2 % auf 15,3 % und integrierte diverse Quellen wie Wikipedia, Nachrichten und technische Dokumente. Diese Strategie gewährleistet eine herausragende Leistung bei komplexen Aufgaben in deutscher Sprache.
Benchmark-Ergebnisse bestätigen die Führungsposition von Soofi S30B-A3B unter den Open-Source-Modellen in Englisch und Deutsch, wobei es OLMo332B und Apertus70B übertrifft. Es glänzt bei der Codegenerierung, professioneller Schlussfolgerung und regionalem Wissen. Das Team weist jedoch auf Verbesserungsbedarf bei der Extraktion ultra-langer Kontexte und der mathematischen Schlussfolgerung in deutscher Sprache hin.
Das Projekt wurde in der Industrial AI Cloud der Deutschen Telekom in München unter Verwendung von 512 Nvidia B200 GPUs trainiert und ist Teil der europäischen IPCEI-CIS-Initiative. Vollständig mit erneuerbaren Energien betrieben, werden die Modellgewichte, der Auswertungscode und die Datenlisten schrittweise als Open Source freigegeben. Diese Transparenz unterstützt europäische industrielle Anwendungen, und das Team sucht derzeit nach Industriepartnern, um Anwendungen in technischer Dokumentation und Codegenerierung zu erkunden.








 Toytas Schätzung von 6,4 Milliarden US-Dollar für Robotik rückt Physical AI in den Fokus
Toyota Motor geht davon aus, dass die flächendeckende Einführung der Automatisierung in ihren Fertigungsstätten, Tochtergesellschaften und wichtigsten Zulieferern ab 2028 etwa 400.000 Roboter und jährliche Ausgaben von rund einer Billion Yen (6,4 Mil
 Meta Open-Sources 30B-Parameter Muse Glimmer für Lokale KI-Agenten auf Consumer-Hardware
Am 10. August hat Meta Muse Glimmer veröffentlicht, ein Open-Source-Modell, das darauf abzielt, lokale KI-Agenten auf Consumer-Hardware zu stärken, und damit einen wichtigen Schritt in seiner Strategie der „Personal Superintelligence“ darstellt. Mit
 GPT-5.6 könnte nächste Woche starten, mit Fokus auf agentenbasierte operative Fähigkeiten
Die wettbewerbsintensive Landschaft der künstlichen Intelligenz verdichtet sich rasant. Aktuelle Lecks bezüglich Testupdates haben das neue Flaggschiff-Modell GPT-5.6 in den Fokus gerückt. Der Marktkonsens deutet auf einen offiziellen Start im zweite
Die besten und am besten bewerteten KI-Tools zur Aufgabenplanung für vielbeschäftigte Berufstätige im Jahr 2026! XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung hocheffizienter Tools zusammengestellt, die Nutzern dabei helfen, Arbeitsabläufe zu optimieren, die Produktivität zu steigern und die täglichen Herausforderungen bei der Terminplanung zu meistern. Jede Option durchläuft strenge Praxistests, um ihre Zuverlässigkeit sicherzustellen. Holen Sie sich einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten und entdecken Sie das perfekte Tool, um Ihren KI-Vorteil auszuschöpfen. Jetzt entdecken!
15 Tools
xix.ai
Die in dieser kuratierten Liste vorgestellten, 2026 aktuell am besten bewerteten KI-Kundenservice-Chatbots sind die besten Lösungen, um Kunden-Fragenkataloge (FAQs) sofort zu beantworten und Leads rund um die Uhr zu qualifizieren. XIX.AI hat strenge Praxistests durchgeführt, um einen detaillierten kostenlosen versus kostenpflichtigen Vergleich sowie aktuelle Rankings bereitzustellen, die Ihnen helfen, ein leistungsstarkes, produktivitätssteigerndes Werkzeug zu finden. Entdecken Sie jetzt Ihre perfekte KI-Chatbot-Lösung!
9 Tools
xix.ai
Die besten KI-Storyboard-Generatoren 2026 für Werbekreativteams! XIX.AI hat anhand von Praxistests und strengen, wöchentlich aktualisierten Rankings eine Liste der besten leistungsstarken, bahnbrechenden Tools zusammengestellt, mit denen Teams atemberaubende visuelle Inhalte schneller erstellen können. Nutzen Sie den Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, um die perfekte Lösung für Ihren Arbeitsablauf zu finden. Entdecken Sie jetzt die Möglichkeiten und sichern Sie sich Ihren KI-Vorteil bei der Werbegestaltung!
8 Tools
xix.ai
2026 Neueste Besten Top-bewertete KI-Wissens-Chatbot-Tools für interne Dokumentation sind hier auf XIX.AI! Diese kuratierte Liste enthält leistungsstarke, bahnbrechende Lösungen, die die Produktivität erheblich steigern, indem sie Teams dabei helfen, schnell hochwertige Inhalte zu generieren, Dokumentationen zu optimieren und häufige Schreibherausforderungen zu bewältigen. Wir führen strenge Praxistests durch und bieten eine wöchentlich aktualisierte kostenlose vs. kostenpflichtige Vergleichstabelle sowie detaillierte Rankings, um Ihnen zu helfen, die beste Option für Ihre Bedürfnisse zu finden. Entdecken Sie jetzt Ihr perfektes Tool!
12 Tools
xix.ai
2026 Neueste Besten Top-bewertete KI Text-zu-Sprache-Tools Ausgewählt zur Erstellung natürlicher Sprachausgaben in Videos. XIX.AI bietet leistungsstarke, bahnbrechende Lösungen, die die Schreibeffizienz steigern und Ihnen helfen, Kreativitätsengpässe zu durchbrechen. Wir führen Praxistests durch, bieten kostenlose vs. kostenpflichtige Vergleiche und aktualisieren unsere Ranglisten wöchentlich. Empfohlene Optionen werden basierend auf strengen Bewertungen hervorgehoben. Entdecken Sie jetzt Ihr perfektes Tool zur Verbesserung der Videoqualität.
9 Tools
xix.ai
Die von XIX.AI zusammengestellten besten und am besten bewerteten KI-Tools zur Betrugserkennung für das Jahr 2026 bieten leistungsstarke, bahnbrechende Lösungen, um verdächtige Muster schnell zu erkennen und kostspielige Verluste zu verhindern. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, Praxistests und detaillierte Rankings, die Ihnen dabei helfen, die beste Option auszuwählen, mit der Sie Ihre Sicherheitseffizienz steigern können. Entdecken Sie jetzt, wie Sie Ihren KI-Vorsprung nutzen können.
10 Tools
xix.ai












