


 Heim
DeepSeek-V4.1-Flash debütiert auf der Qwen-KI-Plattform mit API und Token-Plan
DeepSeek-V4.1-Flash ist nun auf der Qwen KI-Plattform verfügbar und bietet sowohl API-Zugriff als auch einen flexiblen Token-Plan. Entwickler können das Modell nahtlos in ihre Arbeitsabläufe integrieren, indem sie Standard-APIs nutzen oder den Token-Plan direkt in Tools wie Qoder, der Qwen-App und Codex für Programmierung, Dokumentation, visuelle Analyse und agentengestützte Aufgaben einsetzen.
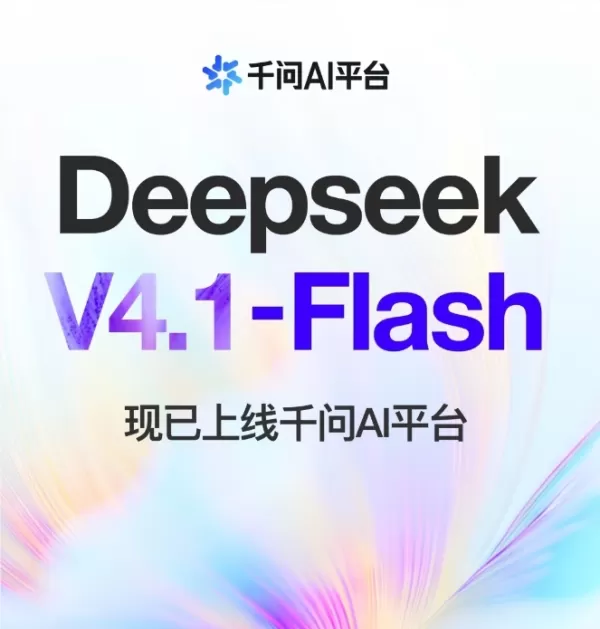
Als DeepSeeks neues leichtgewichtiges Flaggschiff beschrieben, nutzt dieses Modell eine MoE-Architektur mit insgesamt 552 Milliarden Parametern. Es verwendet eine asymmetrische Causal-Encoder-Decoder-Struktur, die nur etwa 8 Milliarden Parameter für die Eingabe und etwa 16 Milliarden Parameter für die Ausgabe aktiviert. Mit nativer Unterstützung für Text- und Bildverständnis verarbeitet es Kontextfenster von bis zu 1 Million Token und generiert Ausgaben von etwa 393K. Offizielle Benchmarks zeigen erhebliche Verbesserungen in den Bereichen Agenten und Code, wobei trotz reduzierter Aktivierungskosten hohe Durchsatzraten und niedrige Latenzzeiten erreicht werden.
Kosteneffizienz ist ein Hauptmerkmal. Durch fortschrittliche Cache-Komprimierung werden die Anforderungen an den KV-Cache-HBM auf 25 % und an die SSD-Speicherung auf 12,5 % der vorherigen Generationen reduziert, was die Ressourcen für lange Kontexte und Mehrinteraktionsgespräche optimiert. Die Preisgestaltung auf der Qwen-Plattform ist gestaffelt: Eingaben kosten 1 CNY pro Million Token in Stoßzeiten (2 CNY Spitzenzeiten), während Ausgaben 4 CNY pro Million Token kosten (8 CNY Spitzenzeiten). Die Ratenlimits liegen bei 15.000 RPM und 1 Million TPM, wobei Prefix-Vervollständigung, Funktionsaufrufe, Caching, strukturierte Ausgaben, Stapelverarbeitung und Online-Suche unterstützt werden.
Alibaba Cloud BaiLian hat sich mit der vLLM Open-Source-Community zusammengeschlossen, um eine breite Bereitstellung in China und internationalen Regionen sicherzustellen, darunter Peking, Singapur, die USA, Deutschland, Japan und Hongkong. Das Modell unterstützt Mehrinteraktionsgespräche, Funktionsaufrufe, Online-Suche, Kontext-Caching und strukturierte Ausgaben, mit einem max_tokens-Limit von etwa 393.216. Dies macht es ideal für Unternehmen, die lange Dokumentenanalysen, Kundenservice-Wissensdatenbanken, Code-Repository-Fragen und -Antworten sowie multimodale Bestellprüfungen in eine einheitliche Schnittstelle migrieren.
Branchenanalysten sind der Ansicht, dass die Integration von „großen Parametern, kleiner Aktivierung und robustem Caching“ in das Qwen-Ökosystem die Kosten für Versuch und Irrtum bei langkontextuellen Agenten senkt. Für kleine Teams ermöglicht die Kombination aus niedrigen Stoßzeitenpreisen und flexiblen Token-Plan-Abonnements eine agilere Stapelinferenz und schnelle Prototypenvalidierung.
Verwandter Artikel
 GitHub Copilot integriert GPT-5.4 innerhalb weniger Stunden
GitHub Copilot hat erneut seine schnelle Reaktionsfähigkeit unter Beweis gestellt. Wenige Stunden nach der Veröffentlichung des neuesten Flaggschiff-Modells GPT-5.4 durch OpenAI kündigte GitHub die vollständige Integration an und bietet Entwicklern w
Anthropic führt den Weg im Börsengang, die KI-Branche betritt ein neues Zeitalter mit Billionen-Umsatz
Der globale KI-Sektor hat einen weiteren wichtigen Meilenstein erreicht. Aktuelle Marktdaten zeigen, dass das KI-Startup Anthropic am 1. Juni einen vertraulichen Börsengang beantragt hat. Wenn dieser genehmigt wird, ist Anthropic darauf vorbereitet,
Wie optimiert man SEO für Google Japan und Yahoo Japan?
Die vernetzte Stadt ist bereits da, sieht aber gewöhnlich ausDie nützlichste IoT-Infrastruktur wirkt selten futuristisch. Sie sieht aus wie eine Mülltonne, die weiß, wann sie voll ist, ein Lieferwagen, der Motorfehler meldet, bevor er ausfällt, ein P
Empfehlungen zu verwandten Spezialthemen
Prompt
 AI-Prompt-Testplattformen für ChatGPT- und Claude-Workflows
2026 Neueste Besten Top-Bewerteten KI-Prompt-Testplattformen für ChatGPT- und Claude-Workflows! XIX.AI kuratiert eine leistungsstarke, spielfreudige Sammlung mit wöchentlich aktualisierten Rankings, kostenlosen versus kostenpflichtigen Vergleichen, realen Tests und detaillierten Funktionsübersichten, um Ihnen zu helfen, die wichtigsten Tools zu identifizieren, die die Produktivität steigern und fehlerfreie Ergebnisse liefern. Entdecken Sie jetzt Ihre perfekte Lösung und nutzen Sie Ihren KI-Vorteil. (249 Zeichen)
 9 Tools
 xix.ai
Marketing
KI-Landingpage-Copy-Tools für SaaS-A/B-Tests, Preisgestaltungsseiten und Demo-Konvertierung
2026 Neueste und beste KI-Tools für Landing Page-Copywriting für SaaS-A/B-Tests, Preisgestaltungsseiten und Demo-Konversionen finden Sie hier auf XIX.AI. Diese kuratierte Liste der am besten bewerteten Tools bietet leistungsstarke, bahnbrechende Lösungen zur Steigerung der Inhaltsqualität, Verbesserung der Schreibeffizienz und Erhöhung der Gesamteffizienz. Wir führen Praxistests durch und bieten einen kostenlosen im Vergleich zu kostenpflichtigen Vergleich sowie wöchentlich aktualisierte Rankings. Unbedingt auszuprobierende Optionen helfen Ihnen, Kreativitätsengpässe zu durchbrechen. Entdecken Sie jetzt Ihr perfektes Tool und erschließen Sie Ihren KI-Vorteil!
8 Tools
xix.ai
Finanzen
Excel KI-Budgetprognose-Tools für die Cashflow-Planung und Kostenkontrolle
2026 Neueste beste Excel-KI-Tools für die Cashflow-Planung und Kostenkontrolle finden Sie auf der hochbewerteten, kuratierten Liste von XIX.AI. Diese leistungsstarken, bahnbrechenden Lösungen helfen Ihnen, die Produktivität durch praxisnahe Tests und strenge Bewertungen erheblich zu steigern. Holen Sie sich einen kostenlosen Vergleich zwischen kostenpflichtigen und kostenlosen Optionen, um die perfekte Lösung für Ihre Bedürfnisse zu finden. Entdecken Sie jetzt, um Ihren KI-Vorteil im Finanzmanagement zu nutzen.
9 Tools
xix.ai
Prompt
AI-Prompt-Management-Tools für Teams
2026 Neueste Besten Top-Bewertete KI-Prompt-Management-Tools für Teams werden hier von XIX.AI kuratiert. Dieser wöchentlich aktualisierte Leitfaden bietet leistungsstarke, bahnbrechende Lösungen, die die Produktivität von Teams durch reale Tests und detaillierte Ranglisten erheblich steigern. Holen Sie sich einen kostenlosen Vergleich zwischen kostenloser und kostenpflichtiger Version, um das perfekte Tool auszuwählen. Entdecken Sie jetzt, um Ihren KI-Vorteil freizuschalten.
9 Tools
xix.ai
Musikkomposition
KI-Tools zur Erarbeitung von Songtexten für die Musikkomposition
Die besten und am besten bewerteten KI-Tools für Songtextideen zur Musikkomposition des Jahres 2026 finden Sie hier auf XIX.AI! Diese sorgfältig zusammengestellte Sammlung umfasst leistungsstarke, bahnbrechende Optionen, die in der Praxis getestet wurden, um schnell hochwertige Songtextkonzepte zu liefern. So können Nutzer ihre Kreativität steigern und ihren Musikschaffungsprozess optimieren. Erhalten Sie außerdem einen Überblick über den Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten. Entdecken Sie jetzt das perfekte Tool für sich!
16 Tools
xix.ai
Comic-Erstellung
Werkzeuge für KI-Charakterbögen zur Erstellung von Comic-Welten
2026 Neueste Besten Top-Bewerteten KI-Charakterbogen-Tools für Comic-Weltenerstellung sind hier auf XIX.AI! Diese kuratierte Liste bietet leistungsstarke, revolutionäre Optionen, die strengen Praxistests unterzogen wurden. Sie finden einen kostenlosen vs. kostenpflichtigen Vergleich sowie wöchentlich aktualisierte Rankings, um Ihnen zu helfen, die unbedingt auszuprobierenden Tools zu entdecken, die Ihre Kreativität fördern und Weltenerstellungsaufgaben optimieren. Entdecken Sie jetzt, um Ihren KI-Vorteil freizuschalten!
13 Tools
xix.ai

 Kommentare (0)
DeepSeek-V4.1-Flash ist nun auf der Qwen KI-Plattform verfügbar und bietet sowohl API-Zugriff als auch einen flexiblen Token-Plan. Entwickler können das Modell nahtlos in ihre Arbeitsabläufe integrieren, indem sie Standard-APIs nutzen oder den Token-Plan direkt in Tools wie Qoder, der Qwen-App und Codex für Programmierung, Dokumentation, visuelle Analyse und agentengestützte Aufgaben einsetzen.
Als DeepSeeks neues leichtgewichtiges Flaggschiff beschrieben, nutzt dieses Modell eine MoE-Architektur mit insgesamt 552 Milliarden Parametern. Es verwendet eine asymmetrische Causal-Encoder-Decoder-Struktur, die nur etwa 8 Milliarden Parameter für die Eingabe und etwa 16 Milliarden Parameter für die Ausgabe aktiviert. Mit nativer Unterstützung für Text- und Bildverständnis verarbeitet es Kontextfenster von bis zu 1 Million Token und generiert Ausgaben von etwa 393K. Offizielle Benchmarks zeigen erhebliche Verbesserungen in den Bereichen Agenten und Code, wobei trotz reduzierter Aktivierungskosten hohe Durchsatzraten und niedrige Latenzzeiten erreicht werden.
Kosteneffizienz ist ein Hauptmerkmal. Durch fortschrittliche Cache-Komprimierung werden die Anforderungen an den KV-Cache-HBM auf 25 % und an die SSD-Speicherung auf 12,5 % der vorherigen Generationen reduziert, was die Ressourcen für lange Kontexte und Mehrinteraktionsgespräche optimiert. Die Preisgestaltung auf der Qwen-Plattform ist gestaffelt: Eingaben kosten 1 CNY pro Million Token in Stoßzeiten (2 CNY Spitzenzeiten), während Ausgaben 4 CNY pro Million Token kosten (8 CNY Spitzenzeiten). Die Ratenlimits liegen bei 15.000 RPM und 1 Million TPM, wobei Prefix-Vervollständigung, Funktionsaufrufe, Caching, strukturierte Ausgaben, Stapelverarbeitung und Online-Suche unterstützt werden.
Alibaba Cloud BaiLian hat sich mit der vLLM Open-Source-Community zusammengeschlossen, um eine breite Bereitstellung in China und internationalen Regionen sicherzustellen, darunter Peking, Singapur, die USA, Deutschland, Japan und Hongkong. Das Modell unterstützt Mehrinteraktionsgespräche, Funktionsaufrufe, Online-Suche, Kontext-Caching und strukturierte Ausgaben, mit einem max_tokens-Limit von etwa 393.216. Dies macht es ideal für Unternehmen, die lange Dokumentenanalysen, Kundenservice-Wissensdatenbanken, Code-Repository-Fragen und -Antworten sowie multimodale Bestellprüfungen in eine einheitliche Schnittstelle migrieren.
Branchenanalysten sind der Ansicht, dass die Integration von „großen Parametern, kleiner Aktivierung und robustem Caching“ in das Qwen-Ökosystem die Kosten für Versuch und Irrtum bei langkontextuellen Agenten senkt. Für kleine Teams ermöglicht die Kombination aus niedrigen Stoßzeitenpreisen und flexiblen Token-Plan-Abonnements eine agilere Stapelinferenz und schnelle Prototypenvalidierung.








 GitHub Copilot integriert GPT-5.4 innerhalb weniger Stunden
GitHub Copilot hat erneut seine schnelle Reaktionsfähigkeit unter Beweis gestellt. Wenige Stunden nach der Veröffentlichung des neuesten Flaggschiff-Modells GPT-5.4 durch OpenAI kündigte GitHub die vollständige Integration an und bietet Entwicklern w
 Anthropic führt den Weg im Börsengang, die KI-Branche betritt ein neues Zeitalter mit Billionen-Umsatz
Der globale KI-Sektor hat einen weiteren wichtigen Meilenstein erreicht. Aktuelle Marktdaten zeigen, dass das KI-Startup Anthropic am 1. Juni einen vertraulichen Börsengang beantragt hat. Wenn dieser genehmigt wird, ist Anthropic darauf vorbereitet,
Wie optimiert man SEO für Google Japan und Yahoo Japan?
Die vernetzte Stadt ist bereits da, sieht aber gewöhnlich ausDie nützlichste IoT-Infrastruktur wirkt selten futuristisch. Sie sieht aus wie eine Mülltonne, die weiß, wann sie voll ist, ein Lieferwagen, der Motorfehler meldet, bevor er ausfällt, ein P

2026 Neueste Besten Top-Bewerteten KI-Prompt-Testplattformen für ChatGPT- und Claude-Workflows! XIX.AI kuratiert eine leistungsstarke, spielfreudige Sammlung mit wöchentlich aktualisierten Rankings, kostenlosen versus kostenpflichtigen Vergleichen, realen Tests und detaillierten Funktionsübersichten, um Ihnen zu helfen, die wichtigsten Tools zu identifizieren, die die Produktivität steigern und fehlerfreie Ergebnisse liefern. Entdecken Sie jetzt Ihre perfekte Lösung und nutzen Sie Ihren KI-Vorteil. (249 Zeichen)
9 Tools
xix.ai

2026 Neueste und beste KI-Tools für Landing Page-Copywriting für SaaS-A/B-Tests, Preisgestaltungsseiten und Demo-Konversionen finden Sie hier auf XIX.AI. Diese kuratierte Liste der am besten bewerteten Tools bietet leistungsstarke, bahnbrechende Lösungen zur Steigerung der Inhaltsqualität, Verbesserung der Schreibeffizienz und Erhöhung der Gesamteffizienz. Wir führen Praxistests durch und bieten einen kostenlosen im Vergleich zu kostenpflichtigen Vergleich sowie wöchentlich aktualisierte Rankings. Unbedingt auszuprobierende Optionen helfen Ihnen, Kreativitätsengpässe zu durchbrechen. Entdecken Sie jetzt Ihr perfektes Tool und erschließen Sie Ihren KI-Vorteil!
8 Tools
xix.ai

2026 Neueste beste Excel-KI-Tools für die Cashflow-Planung und Kostenkontrolle finden Sie auf der hochbewerteten, kuratierten Liste von XIX.AI. Diese leistungsstarken, bahnbrechenden Lösungen helfen Ihnen, die Produktivität durch praxisnahe Tests und strenge Bewertungen erheblich zu steigern. Holen Sie sich einen kostenlosen Vergleich zwischen kostenpflichtigen und kostenlosen Optionen, um die perfekte Lösung für Ihre Bedürfnisse zu finden. Entdecken Sie jetzt, um Ihren KI-Vorteil im Finanzmanagement zu nutzen.
9 Tools
xix.ai

2026 Neueste Besten Top-Bewertete KI-Prompt-Management-Tools für Teams werden hier von XIX.AI kuratiert. Dieser wöchentlich aktualisierte Leitfaden bietet leistungsstarke, bahnbrechende Lösungen, die die Produktivität von Teams durch reale Tests und detaillierte Ranglisten erheblich steigern. Holen Sie sich einen kostenlosen Vergleich zwischen kostenloser und kostenpflichtiger Version, um das perfekte Tool auszuwählen. Entdecken Sie jetzt, um Ihren KI-Vorteil freizuschalten.
9 Tools
xix.ai

Die besten und am besten bewerteten KI-Tools für Songtextideen zur Musikkomposition des Jahres 2026 finden Sie hier auf XIX.AI! Diese sorgfältig zusammengestellte Sammlung umfasst leistungsstarke, bahnbrechende Optionen, die in der Praxis getestet wurden, um schnell hochwertige Songtextkonzepte zu liefern. So können Nutzer ihre Kreativität steigern und ihren Musikschaffungsprozess optimieren. Erhalten Sie außerdem einen Überblick über den Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten. Entdecken Sie jetzt das perfekte Tool für sich!
16 Tools
xix.ai
2026 Neueste Besten Top-Bewerteten KI-Charakterbogen-Tools für Comic-Weltenerstellung sind hier auf XIX.AI! Diese kuratierte Liste bietet leistungsstarke, revolutionäre Optionen, die strengen Praxistests unterzogen wurden. Sie finden einen kostenlosen vs. kostenpflichtigen Vergleich sowie wöchentlich aktualisierte Rankings, um Ihnen zu helfen, die unbedingt auszuprobierenden Tools zu entdecken, die Ihre Kreativität fördern und Weltenerstellungsaufgaben optimieren. Entdecken Sie jetzt, um Ihren KI-Vorteil freizuschalten!
13 Tools
xix.ai












