发现高质量的人工智能工具
将全球领先的人工智能工具聚集在一起,以帮助提高工作效率

由DanielLewis发布的文章
Meta禁止其AI工程师使用诸如Anthropic的Claude Code和OpenAI的Codex之类的竞争对手工具,原因是这些工具存在模型蒸馏的风险——即利用竞争对手的输出来训练自己的AI系统,这种行为违反了使用协议,同时也可能引发法律问题和信任危机。这项自5月份起生效的政策旨在确保研发活动符合相关规定,并保护知识产权。
Meta禁止其AI工程师使用诸如Anthropic的Claude Code和OpenAI的Codex之类的竞争对手工具,原因是这些工具存在模型蒸馏的风险——即利用竞争对手的输出来训练自己的AI系统,这种行为违反了使用协议,同时也可能引发法律问题和信任危机。这项自5月份起生效的政策旨在确保研发活动符合相关规定,并保护知识产权。

开发者 jola 演示了在配备 24GB 内存的 M4 版 MacBook Pro 上部署本地 AI 工作流。经过优化的 Qwen 3.5-9B 模型实现了 40 个令牌/秒的处理速度,在性能与效率之间取得了平衡,适合离线使用。 通过微调参数并启用“思考”模式,该模型在编码任务中的推理能力得到增强。尽管与顶级云端模型相比仍存在差距,但这种配置提供了一种注重隐私且经济高效的替代方案,将 AI 的角色从外包助手转变为互动式的“研究伙伴”。
开发者 jola 演示了在配备 24GB 内存的 M4 版 MacBook Pro 上部署本地 AI 工作流。经过优化的 Qwen 3.5-9B 模型实现了 40 个令牌/秒的处理速度,在性能与效率之间取得了平衡,适合离线使用。 通过微调参数并启用“思考”模式,该模型在编码任务中的推理能力得到增强。尽管与顶级云端模型相比仍存在差距,但这种配置提供了一种注重隐私且经济高效的替代方案,将 AI 的角色从外包助手转变为互动式的“研究伙伴”。
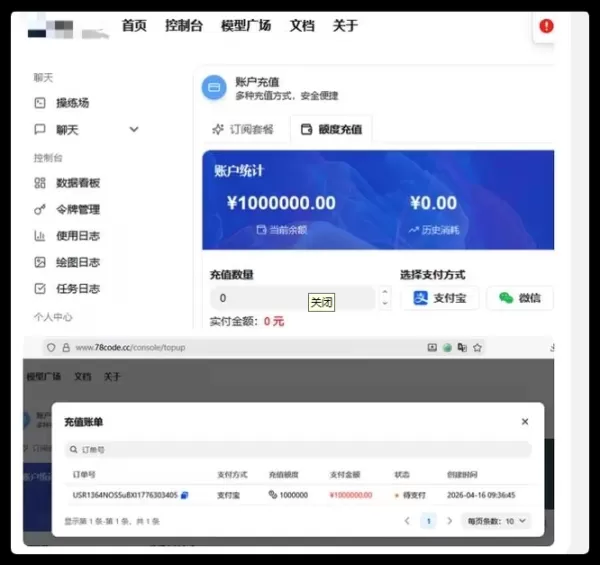
在 AI 模型管理系统 QuantumNous/new-api(NewAPI)中发现了一个关键漏洞。当 Stripe 支付密钥未配置时,攻击者可伪造 webhook 事件绕过支付验证,从而实现“零成本”的任意账户充值。该漏洞源于支付回调过程中对空密钥的签名验证不足。该项目已发布修复版本(v0.12.10)。 强烈建议所有用户立即升级系统,配置强度的 Stripe 密钥,并审核其充值记录。
在 AI 模型管理系统 QuantumNous/new-api(NewAPI)中发现了一个关键漏洞。当 Stripe 支付密钥未配置时,攻击者可伪造 webhook 事件绕过支付验证,从而实现“零成本”的任意账户充值。该漏洞源于支付回调过程中对空密钥的签名验证不足。该项目已发布修复版本(v0.12.10)。 强烈建议所有用户立即升级系统,配置强度的 Stripe 密钥,并审核其充值记录。
据报道,Anthropic的下一代AI模型“Claude Mythos”(内部代号“Capybara”)目前正处于秘密测试阶段。 泄露的文件显示,该模型在性能上实现了重大飞跃,超越了当前的顶级模型Claude Opus。然而,Anthropic针对该模型发出了前所未有的网络安全风险警告,凸显了提升AI能力与确保安全之间的矛盾。该模型的问世势必将加剧行业竞争,并重新定义大型语言模型的基准。
据报道,Anthropic的下一代AI模型“Claude Mythos”(内部代号“Capybara”)目前正处于秘密测试阶段。 泄露的文件显示,该模型在性能上实现了重大飞跃,超越了当前的顶级模型Claude Opus。然而,Anthropic针对该模型发出了前所未有的网络安全风险警告,凸显了提升AI能力与确保安全之间的矛盾。该模型的问世势必将加剧行业竞争,并重新定义大型语言模型的基准。
Nvidia 将向 OpenAI 的人工智能数据中心投资高达 1000 亿美元,提供 10GW 的系统,减少 OpenAI 对微软的依赖,同时扩大与甲骨文和软银的合作。有关支付结构的细节尚不清楚。
Nvidia 将向 OpenAI 的人工智能数据中心投资高达 1000 亿美元,提供 10GW 的系统,减少 OpenAI 对微软的依赖,同时扩大与甲骨文和软银的合作。有关支付结构的细节尚不清楚。
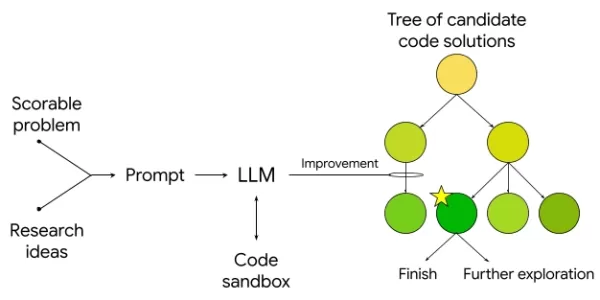
谷歌 DeepMind 推出了一个使用 Gemini 的人工智能驱动系统,帮助科学家为研究生成高性能的经验软件。该系统经过基因组学、公共卫生、地理空间分析、神经科学和数值任务的测试,通过迭代 LLM 驱动的代码优化,其性能优于专家方法。该系统通过自动评估假设,将探索时间从数月缩短到数小时,从而加速了发现。
谷歌 DeepMind 推出了一个使用 Gemini 的人工智能驱动系统,帮助科学家为研究生成高性能的经验软件。该系统经过基因组学、公共卫生、地理空间分析、神经科学和数值任务的测试,通过迭代 LLM 驱动的代码优化,其性能优于专家方法。该系统通过自动评估假设,将探索时间从数月缩短到数小时,从而加速了发现。