首页

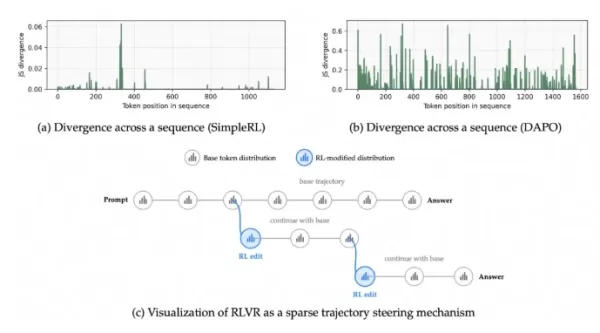
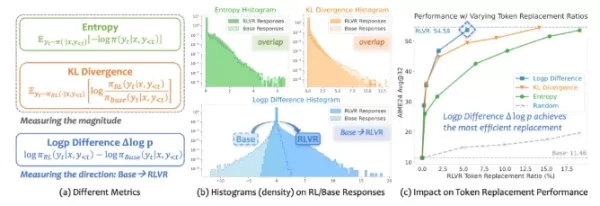
阿里巴巴通一实验室的Qwen Pilot团队引入了FIPO算法,以增强大型模型的推理能力。该算法采用Future-KL机制,对后续推理中至关重要的词元给予奖励,从而克服了推理长度停滞的问题。在测试中,FIPO的表现优于o1-mini等同类模型,并在复杂的数学推理任务中实现了显著的准确率提升。
评论 (0)
0/300