opción
Hogar
Última hora
Contenido
AlbertSanchez
AlbertSanchez
7 de abril de 2026

El equipo Qwen Pilot de Alibaba Tongyi Lab presentó el algoritmo FIPO para mejorar el razonamiento de los modelos a gran escala. Este utiliza un mecanismo Future-KL para recompensar los tokens críticos para el razonamiento posterior, superando así el estancamiento en la longitud del razonamiento. En las pruebas, FIPO superó a modelos comparables como o1-mini y logró mejoras significativas en la precisión en el razonamiento matemático complejo.
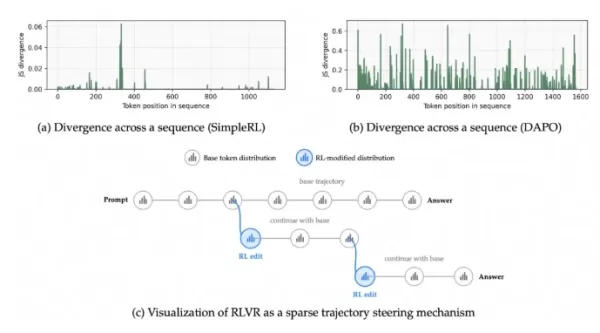
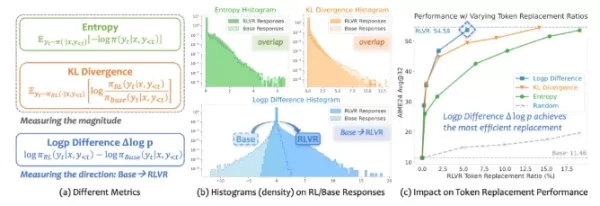
El equipo Qwen Pilot de Alibaba Tongyi Lab presentó el algoritmo FIPO para mejorar el razonamiento de los modelos a gran escala. Este utiliza un mecanismo Future-KL para recompensar los tokens críticos para el razonamiento posterior, superando así el estancamiento en la longitud del razonamiento. En las pruebas, FIPO superó a modelos comparables como o1-mini y logró mejoras significativas en la precisión en el razonamiento matemático complejo. El equipo Qwen Pilot de Alibaba Tongyi Lab presentó el algoritmo FIPO para mejorar el razonamiento de los modelos a gran escala. Este utiliza un mecanismo Future-KL para recompensar los tokens críticos para el razonamiento posterior, superando así el estancamiento en la longitud del razonamiento. En las pruebas, FIPO superó a modelos comparables como o1-mini y logró mejoras significativas en la precisión en el razonamiento matemático complejo.
comentario (0)
0/300
OR