opção
AlbertSanchez
AlbertSanchez
7 de Abril de 2026

A equipe Qwen Pilot do Alibaba Tongyi Lab apresentou o algoritmo FIPO para aprimorar o raciocínio em modelos de grande porte. Ele utiliza um mecanismo Future-KL para recompensar tokens essenciais para o raciocínio subsequente, superando a estagnação na extensão do raciocínio. Em testes, o FIPO superou modelos comparáveis, como o o1-mini, e alcançou ganhos significativos de precisão no raciocínio matemático complexo.
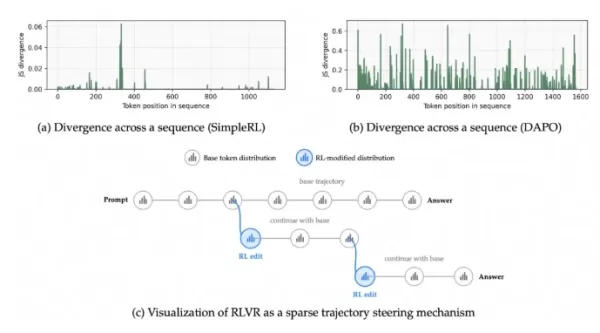
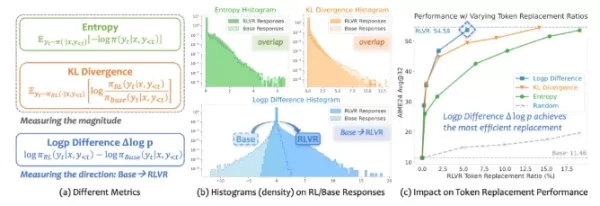
A equipe Qwen Pilot do Alibaba Tongyi Lab apresentou o algoritmo FIPO para aprimorar o raciocínio em modelos de grande porte. Ele utiliza um mecanismo Future-KL para recompensar tokens essenciais para o raciocínio subsequente, superando a estagnação na extensão do raciocínio. Em testes, o FIPO superou modelos comparáveis, como o o1-mini, e alcançou ganhos significativos de precisão no raciocínio matemático complexo. A equipe Qwen Pilot do Alibaba Tongyi Lab apresentou o algoritmo FIPO para aprimorar o raciocínio em modelos de grande porte. Ele utiliza um mecanismo Future-KL para recompensar tokens essenciais para o raciocínio subsequente, superando a estagnação na extensão do raciocínio. Em testes, o FIPO superou modelos comparáveis, como o o1-mini, e alcançou ganhos significativos de precisão no raciocínio matemático complexo.
Comentários (0)
0/300
OR