


 首页
Vanna AI 通过自然语言处理实现无代码数据库查询
自然语言数据库接口的出现标志着数据民主化的变革,而 Vanna AI 则是这一变革的先驱。这个开源 Python 库通过将英语会话转换为准确的 SQL 查询,在企业用户和复杂数据系统之间架起了一座桥梁。通过其创新的检索增强生成(RAG)架构,Vanna 使企业无需专业技术知识就能获得洞察力,同时保持查询的精确性。
主要优势
Vanna AI 提供直观的英语到 SQL 界面,简化了数据探索过程
RAG 架构通过语义理解确保生成上下文准确的查询
完全开源的实现方式可根据企业需求进行深度定制
广泛的 SQL 数据库兼容性,包括 PostgreSQL、MySQL 和 SQLite
与 Python 数据工作流和 Jupyter 环境无缝集成
积极的开源开发,社区采用率不断提高
减少跨组织数据访问的技术障碍
核心技术概述
架构基础
Vanna AI 通过复杂的两阶段方法,将尖端的自然语言处理与数据库智能相结合。系统首先通过向量嵌入分析模式结构和现有查询,了解您的数据环境。当用户提出业务问题时,平台会根据这一知识库执行语义搜索,然后生成针对特定数据环境的优化 SQL 语句。
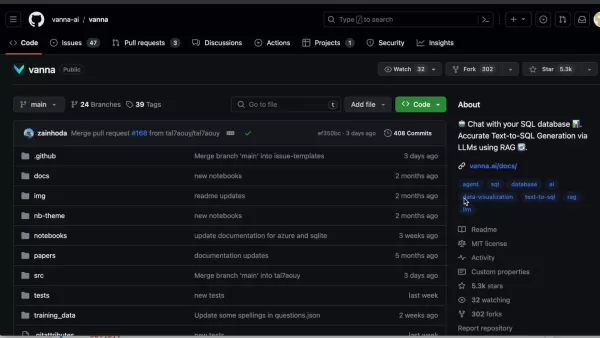
这种双阶段方法确保查询尊重数据库关系和业务规则,同时回答用户的意图。开放式架构允许与现有的 Python 数据堆栈集成,通过与 Jupyter 笔记本的兼容性,在分析工作流方面具有特别的优势。
关键技术组件
Vanna AI 采用了多项创新技术来实现其自然语言界面:
- 嵌入模型:将数据库元数据和自然语言转换为可比较的矢量表示法
- 向量数据库:存储和检索用于生成查询的上下文信息
- 语言模型:根据检索到的上下文将问题转换为可执行的 SQL
- 查询验证:确保生成的 SQL 符合数据库语法规则
- 反馈回路:通过成功的查询强化不断改进
实施指南
安装过程
开始时需要通过 pip 命令直接安装 Python 软件包:
pip install vanna
这将处理所有依赖项,包括所需的机器学习库和数据库连接器。企业部署可考虑采用容器化安装,以便进行生产扩展。
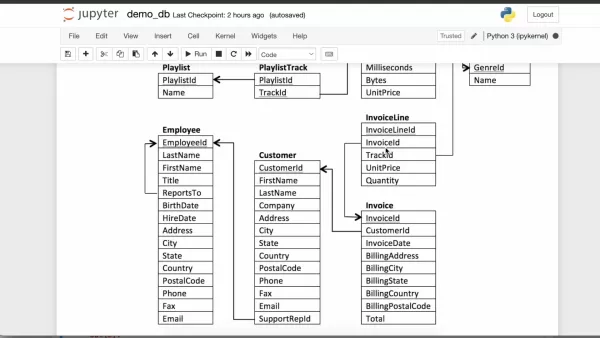
系统配置
与现有数据库的连接使用标准 SQLAlchemy 连接字符串:
import pandas as pd from sqlalchemy import create_engine from vanna.remote import VannaDefaultvn = VannaDefault(model='chinook', api_key='YOUR_API_KEY') vn.connect_to_sqlite('https://vanna.ai/Chinook.sqlite')
知识库开发
培训 Vanna AI 需要提供
- 完整的数据库模式描述
- 代表常见用例的查询示例
- 业务术语定义
- 数据关系文档
这种结构化入职培训通常需要数据库管理员在最终用户访问前进行一次性培训。
经济考虑因素
成本结构分析
作为开源软件,Vanna AI 无需支付许可费用,同时提供完全的透明度。企业应为以下方面做好预算
- 复杂部署的实施服务
- 用于嵌入生成的计算资源
- 矢量数据库基础设施
- 可选的高级支持包
事实证明,总拥有成本往往大大低于商业替代方案,同时还能提供更强的控制能力。
解决方案评估
主要优势
- 使不同技术水平的数据访问民主化
- 减少对专业 SQL 资源的依赖
- 加快分析工作流程的速度
- 实现自助服务报告功能
- 促进探索性数据分析
实施挑战
- 需要对模式有初步了解
- 复杂的分析问题可能需要改进
- 性能因数据库复杂程度而异
- 正在积极开发新功能
工业应用
商业智能
销售团队无需 IT 人员参与即可即时查询客户指标,而管理人员则可通过自然问题实时访问业绩仪表板:
"向我显示西部地区按产品线划分的季度收入趋势"。
数据科学
分析师在开发模型前通过对话方式探索数据集,从而加速功能工程:
"交易金额超过 1000 美元的分布情况如何?
业务报告
管理人员通过保存的自然语言查询自动生成报告,并根据当前数据进行刷新。
常见问题
数据库兼容性
Vanna AI 支持所有主要的 SQL 实现,包括具有 JDBC/ODBC 连接的云数据仓库。性能因数据库特定语法的细微差别而异。
准确性基准
测试表明,普通业务查询的初始准确率为 85-95%,经过针对特定组织问题的反馈培训后,准确率提高到 95% 以上。
安全考虑
查询尊重现有数据库权限。敏感数据的保护需要适当的模式设计和访问控制的实施。
比较分析
替代解决方案
与 Tableau Ask Data 等专有工具不同,Vanna AI 提供完全透明的查询和自定义功能。这种开放式方法允许对特定行业的术语和基本可视化需求之外的复杂分析方案进行调整。
相关文章
 内部细节曝光:下一代 Gemini 算力紧张,内部团队在开发优先级和资源分配上存在分歧
报告显示,谷歌备受期待的下一代 Gemini 模型发布已被推迟。由于内部在开发优先级和资源分配上存在分歧,加上计算能力有限以及复杂的审批流程,导致发布时间延后了两个月。尽管谷歌拥有定制的 TPU 芯片,但由于模型训练、Google Cloud 服务以及众多消费和企业级 AI 应用对计算资源的需求相互竞争,谷歌仍面临计算资源短缺的问题。目前,高层管理人员正通过组织结构调整来解决这些部门间的冲突。与此同时,领导层也发生了变化,联合创始人谢尔盖·布林越来越多地参与到核心模型训练中,并倡导将资源专门用于
OpenAI 否认增长放缓担忧,称多个业务部门加速发展
针对外界对其销售增长放缓及未达内部基准的质疑,人工智能领域的领军企业 OpenAI 于 4 月 28 日(星期二)发表了一份信心十足的声明。该公司澄清称,其消费产品和企业服务正在快速推进,直接驳斥了近期关于业务放缓的猜测。针对该公司“未达成多项内部目标”的说法,OpenAI 将这些报道斥为“典型的标题党”。公司强调了企业对 AI 集成的强劲需求,并指出其广告业务早期增长前景良好。据 OpenAI 内部人士透露,公司内部情绪依然乐观。尽管市场竞争日益激烈,但公司正在向投资者传递信心,声称其商业
阿里巴巴超级杯:Qwen3.8-Max 重磅登场,代码与办公工具能力全面升级
阿里巴巴正式发布了Qwen3.8-Max,这是一款拥有2.4万亿参数的下一代基础大模型。这一重大AI进展在编码和专业办公任务等核心领域带来了显著的性能提升,展现了强大的技术能力。在权威的Arena大模型排名中,Qwen3.8-Max取得了令人瞩目的成绩,仅次于Anthropic的Claude系列,位居行业前列。这一里程碑标志着国内大模型在处理复杂任务方面取得了快速进展,为开发者和企业用户提供了先进的智能工具。该模型的API现已在Qwen AI平台上上线,并集成到新推出的“Qwen Offic
相关专题推荐
音乐创作
 最佳用于歌曲草稿的 AI 旋律创作工具
2026 年最新最佳顶级评分 AI 旋律创作工具,助力歌曲草稿创作!XIX.AI 精心策划了一套极具影响力且经过严格真实世界测试的变革性合集,旨在提供最佳的创作体验。您可以找到详细的免费与付费版对比、精准的排名以及必试选项,这些工具旨在帮助您轻松创作出令人惊艳的歌曲草稿,并显著提升您的创意生产力。立即探索,发现您的完美工具!
 8 个工具
 xix.ai
聊天机器人
最佳AI对话训练工具,助你备战面试
2026年最新、最受好评的AI面试模拟训练工具现已登陆XIX.AI!这份精心精选的合集收录了功能强大、具有革命性意义的工具,它们均经过严格的实际测试,能够提供精准的反馈。 您将看到免费版与付费版的对比分析以及详细排名,助您挑选出必试之选,从而提升自信并精进技能。立即探索,发现助您面试成功的完美工具!
12 个工具
xix.ai
设计与艺术
最适合创意实验的AI风格转换工具
2026年最新最佳、评价最高的AI风格转换工具,助您开展创意实验!XIX.AI精心甄选了一系列功能强大、颠覆性的必试工具,这些工具经过实际测试和严格排名,可带来卓越的效果。这些顶级解决方案通过加速内容创作并释放无限创意潜能,帮助创作者显著提升工作效率。 立即探索,找到最适合您的工具,今天就开始创作吧!
9 个工具
xix.ai
漫画创作
最适合视觉叙事的AI对话气泡工具
2026年最新、最受欢迎的视觉叙事AI对话气泡工具现已登陆XIX.AI!这份精心精选的合集汇集了功能强大、具有颠覆性的工具,可帮助创作者提升工作效率并突破创作瓶颈。 获取免费版与付费版的对比分析,查看实际测试结果,并查阅最新排行榜,找到最适合打造引人入胜的视觉叙事的必试解决方案。立即探索,发现您的理想工具!
10 个工具
xix.ai
会议助理
顶级AI会议摘要工具:清晰追踪决策与后续跟进
2026年最新高评分最佳AI会议摘要工具,助您清晰追踪决策并轻松跟进。这份精心筛选的清单展示了功能强大、具有颠覆性的解决方案,它们通过自动化会议记录、识别关键行动项以及简化所有项目中的团队协调,显著提升工作效率。 获取免费版与付费版的对比分析,以及实际测试报告和每周更新的排行榜,助您找到最适合的工具。立即探索,释放您的AI优势!
9 个工具
xix.ai
数据分析
最佳人工智能数据清洗工具:快速处理缺失值与重复数据
2026年最新、最优秀且评分最高的AI数据清洗工具,可快速处理缺失值与重复数据问题。这份精心挑选的清单展示了那些功能强大、能带来颠覆性变革的解决方案,可显著提升工作效率。所有候选工具都经过了严格的实际应用测试,以确保其稳定性。您可以获取免费版与付费版的对比信息,找出最符合您需求的必备工具。即刻访问XIX.AI,开启您的AI优势之旅。
11 个工具
xix.ai

 评论 (1)
0/500
![WillieRamirez]()
Die Idee ist wirklich bahnbrechend – gerade für Leute wie mich, die mit SQL kämpfen. Aber ich frage mich, wie es mit Datenschutz und der Genauigkeit der abgerufenen Daten aussieht. Könnte in größeren Unternehmen ein Sicherheitsrisiko darstellen, wenn jeder einfach so auf die Datenbank zugreifen kann? Dennoch, ein spannender Schritt in Richtung Barrierefreiheit! 🔍
自然语言数据库接口的出现标志着数据民主化的变革,而 Vanna AI 则是这一变革的先驱。这个开源 Python 库通过将英语会话转换为准确的 SQL 查询,在企业用户和复杂数据系统之间架起了一座桥梁。通过其创新的检索增强生成(RAG)架构,Vanna 使企业无需专业技术知识就能获得洞察力,同时保持查询的精确性。
主要优势
Vanna AI 提供直观的英语到 SQL 界面,简化了数据探索过程
RAG 架构通过语义理解确保生成上下文准确的查询
完全开源的实现方式可根据企业需求进行深度定制
广泛的 SQL 数据库兼容性,包括 PostgreSQL、MySQL 和 SQLite
与 Python 数据工作流和 Jupyter 环境无缝集成
积极的开源开发,社区采用率不断提高
减少跨组织数据访问的技术障碍
核心技术概述
架构基础
Vanna AI 通过复杂的两阶段方法,将尖端的自然语言处理与数据库智能相结合。系统首先通过向量嵌入分析模式结构和现有查询,了解您的数据环境。当用户提出业务问题时,平台会根据这一知识库执行语义搜索,然后生成针对特定数据环境的优化 SQL 语句。
这种双阶段方法确保查询尊重数据库关系和业务规则,同时回答用户的意图。开放式架构允许与现有的 Python 数据堆栈集成,通过与 Jupyter 笔记本的兼容性,在分析工作流方面具有特别的优势。
关键技术组件
Vanna AI 采用了多项创新技术来实现其自然语言界面:
- 嵌入模型:将数据库元数据和自然语言转换为可比较的矢量表示法
- 向量数据库:存储和检索用于生成查询的上下文信息
- 语言模型:根据检索到的上下文将问题转换为可执行的 SQL
- 查询验证:确保生成的 SQL 符合数据库语法规则
- 反馈回路:通过成功的查询强化不断改进
实施指南
安装过程
开始时需要通过 pip 命令直接安装 Python 软件包:
pip install vanna
这将处理所有依赖项,包括所需的机器学习库和数据库连接器。企业部署可考虑采用容器化安装,以便进行生产扩展。
系统配置
与现有数据库的连接使用标准 SQLAlchemy 连接字符串:
import pandas as pd from sqlalchemy import create_engine from vanna.remote import VannaDefaultvn = VannaDefault(model='chinook', api_key='YOUR_API_KEY') vn.connect_to_sqlite('https://vanna.ai/Chinook.sqlite')
知识库开发
培训 Vanna AI 需要提供
- 完整的数据库模式描述
- 代表常见用例的查询示例
- 业务术语定义
- 数据关系文档
这种结构化入职培训通常需要数据库管理员在最终用户访问前进行一次性培训。
经济考虑因素
成本结构分析
作为开源软件,Vanna AI 无需支付许可费用,同时提供完全的透明度。企业应为以下方面做好预算
- 复杂部署的实施服务
- 用于嵌入生成的计算资源
- 矢量数据库基础设施
- 可选的高级支持包
事实证明,总拥有成本往往大大低于商业替代方案,同时还能提供更强的控制能力。
解决方案评估
主要优势
- 使不同技术水平的数据访问民主化
- 减少对专业 SQL 资源的依赖
- 加快分析工作流程的速度
- 实现自助服务报告功能
- 促进探索性数据分析
实施挑战
- 需要对模式有初步了解
- 复杂的分析问题可能需要改进
- 性能因数据库复杂程度而异
- 正在积极开发新功能
工业应用
商业智能
销售团队无需 IT 人员参与即可即时查询客户指标,而管理人员则可通过自然问题实时访问业绩仪表板:
"向我显示西部地区按产品线划分的季度收入趋势"。
数据科学
分析师在开发模型前通过对话方式探索数据集,从而加速功能工程:
"交易金额超过 1000 美元的分布情况如何?
业务报告
管理人员通过保存的自然语言查询自动生成报告,并根据当前数据进行刷新。
常见问题
数据库兼容性
Vanna AI 支持所有主要的 SQL 实现,包括具有 JDBC/ODBC 连接的云数据仓库。性能因数据库特定语法的细微差别而异。
准确性基准
测试表明,普通业务查询的初始准确率为 85-95%,经过针对特定组织问题的反馈培训后,准确率提高到 95% 以上。
安全考虑
查询尊重现有数据库权限。敏感数据的保护需要适当的模式设计和访问控制的实施。
比较分析
替代解决方案
与 Tableau Ask Data 等专有工具不同,Vanna AI 提供完全透明的查询和自定义功能。这种开放式方法允许对特定行业的术语和基本可视化需求之外的复杂分析方案进行调整。








 内部细节曝光:下一代 Gemini 算力紧张,内部团队在开发优先级和资源分配上存在分歧
报告显示,谷歌备受期待的下一代 Gemini 模型发布已被推迟。由于内部在开发优先级和资源分配上存在分歧,加上计算能力有限以及复杂的审批流程,导致发布时间延后了两个月。尽管谷歌拥有定制的 TPU 芯片,但由于模型训练、Google Cloud 服务以及众多消费和企业级 AI 应用对计算资源的需求相互竞争,谷歌仍面临计算资源短缺的问题。目前,高层管理人员正通过组织结构调整来解决这些部门间的冲突。与此同时,领导层也发生了变化,联合创始人谢尔盖·布林越来越多地参与到核心模型训练中,并倡导将资源专门用于
 OpenAI 否认增长放缓担忧,称多个业务部门加速发展
针对外界对其销售增长放缓及未达内部基准的质疑,人工智能领域的领军企业 OpenAI 于 4 月 28 日(星期二)发表了一份信心十足的声明。该公司澄清称,其消费产品和企业服务正在快速推进,直接驳斥了近期关于业务放缓的猜测。针对该公司“未达成多项内部目标”的说法,OpenAI 将这些报道斥为“典型的标题党”。公司强调了企业对 AI 集成的强劲需求,并指出其广告业务早期增长前景良好。据 OpenAI 内部人士透露,公司内部情绪依然乐观。尽管市场竞争日益激烈,但公司正在向投资者传递信心,声称其商业
 阿里巴巴超级杯:Qwen3.8-Max 重磅登场,代码与办公工具能力全面升级
阿里巴巴正式发布了Qwen3.8-Max,这是一款拥有2.4万亿参数的下一代基础大模型。这一重大AI进展在编码和专业办公任务等核心领域带来了显著的性能提升,展现了强大的技术能力。在权威的Arena大模型排名中,Qwen3.8-Max取得了令人瞩目的成绩,仅次于Anthropic的Claude系列,位居行业前列。这一里程碑标志着国内大模型在处理复杂任务方面取得了快速进展,为开发者和企业用户提供了先进的智能工具。该模型的API现已在Qwen AI平台上上线,并集成到新推出的“Qwen Offic

2026 年最新最佳顶级评分 AI 旋律创作工具,助力歌曲草稿创作!XIX.AI 精心策划了一套极具影响力且经过严格真实世界测试的变革性合集,旨在提供最佳的创作体验。您可以找到详细的免费与付费版对比、精准的排名以及必试选项,这些工具旨在帮助您轻松创作出令人惊艳的歌曲草稿,并显著提升您的创意生产力。立即探索,发现您的完美工具!
8 个工具
xix.ai

2026年最新、最受好评的AI面试模拟训练工具现已登陆XIX.AI!这份精心精选的合集收录了功能强大、具有革命性意义的工具,它们均经过严格的实际测试,能够提供精准的反馈。 您将看到免费版与付费版的对比分析以及详细排名,助您挑选出必试之选,从而提升自信并精进技能。立即探索,发现助您面试成功的完美工具!
12 个工具
xix.ai

2026年最新最佳、评价最高的AI风格转换工具,助您开展创意实验!XIX.AI精心甄选了一系列功能强大、颠覆性的必试工具,这些工具经过实际测试和严格排名,可带来卓越的效果。这些顶级解决方案通过加速内容创作并释放无限创意潜能,帮助创作者显著提升工作效率。 立即探索,找到最适合您的工具,今天就开始创作吧!
9 个工具
xix.ai

2026年最新、最受欢迎的视觉叙事AI对话气泡工具现已登陆XIX.AI!这份精心精选的合集汇集了功能强大、具有颠覆性的工具,可帮助创作者提升工作效率并突破创作瓶颈。 获取免费版与付费版的对比分析,查看实际测试结果,并查阅最新排行榜,找到最适合打造引人入胜的视觉叙事的必试解决方案。立即探索,发现您的理想工具!
10 个工具
xix.ai

2026年最新高评分最佳AI会议摘要工具,助您清晰追踪决策并轻松跟进。这份精心筛选的清单展示了功能强大、具有颠覆性的解决方案,它们通过自动化会议记录、识别关键行动项以及简化所有项目中的团队协调,显著提升工作效率。 获取免费版与付费版的对比分析,以及实际测试报告和每周更新的排行榜,助您找到最适合的工具。立即探索,释放您的AI优势!
9 个工具
xix.ai

2026年最新、最优秀且评分最高的AI数据清洗工具,可快速处理缺失值与重复数据问题。这份精心挑选的清单展示了那些功能强大、能带来颠覆性变革的解决方案,可显著提升工作效率。所有候选工具都经过了严格的实际应用测试,以确保其稳定性。您可以获取免费版与付费版的对比信息,找出最符合您需求的必备工具。即刻访问XIX.AI,开启您的AI优势之旅。
11 个工具
xix.ai

Die Idee ist wirklich bahnbrechend – gerade für Leute wie mich, die mit SQL kämpfen. Aber ich frage mich, wie es mit Datenschutz und der Genauigkeit der abgerufenen Daten aussieht. Könnte in größeren Unternehmen ein Sicherheitsrisiko darstellen, wenn jeder einfach so auf die Datenbank zugreifen kann? Dennoch, ein spannender Schritt in Richtung Barrierefreiheit! 🔍












