


 首页
同益实验室推出PrismAudio,实现双向音视频分离
在人工智能视频生成技术迅速发展的时代,画面与音频之间的脱节——通常表现为静音或音画不同步——仍然是影响观众沉浸感的一大障碍。 为应对这一挑战,阿里巴巴的通一实验室推出了PrismAudio——一个创新的视频转音频框架。这项研究已被顶级人工智能会议ICLR 2026录用,致力于自动将视频内容与精准的环境音效进行同步。
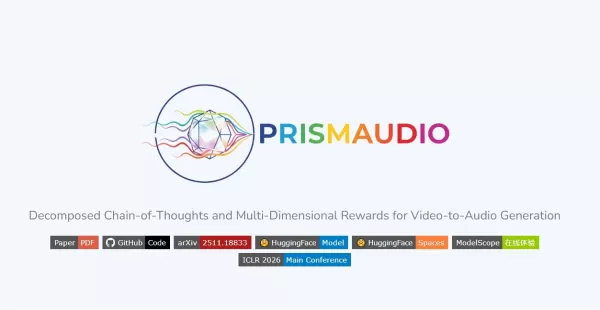
生成前的推理:“思维链”实现音频掌控
传统的音频生成模型通常基于“直觉”运作,经常产生脱节的结果——例如马蹄声听起来像鸟鸣,或者音频滞后于视觉动作。PrismAudio 的独特之处在于采用了“先规划,再生成”的方法。
“思维链”分解过程:在生成音频之前,模型会逐帧分析视频:识别场景元素、确定声音起始时间、评估音频特征(如清晰度或深度),并定位声音在空间中的来源。
多维度评估:为确保高质量输出,开发团队整合了强化学习技术,利用四个“虚拟评估员”从语义一致性、时间同步性、美学质量和空间准确性四个维度对结果进行评分。这种多维度的反馈循环解决了此前模型常出现的“只优化某一方面而忽视其他方面”的问题。
轻量且高效:0.6 秒内处理 9 秒视频
除了准确性之外,PrismAudio 还具备卓越的速度。借助其专有的Fast-GRPO训练算法,该模型在保持运行效率的同时,实现了显著的性能提升:
紧凑架构,成效显著:该模型仅含 5.18 亿个参数,远小于同类系统——后者通常需要数百亿个参数。
响应迅捷:为一段9秒的视频片段生成高质量音频仅需0.63秒,性能已接近实时水平。
行业视角:真实环境音效的崛起
PrismAudio的推出不仅为电影后期制作和短视频创作提供了一款强大的自动化工具,还为多对象生成开辟了新的路径。随着AI在平衡音频质感与空间定位方面的能力不断提升,未来的视频制作将越来越接近实现真正的“所见即所闻”的保真度。
论文链接:arXiv:2511.18833
开源链接:https://prismaudio-project.github.io/
相关文章
 Neros Technologies 获得 2.5 亿美元融资,计划到 2026 年部署防御无人机
Neros Archer:一款专为模块化有效载荷和弹性通信链路设计的FPV无人机。| 来源:NerosNeros Inc.已完成2.5亿美元的C轮融资,将该国防无人机承包商的估值提升至25亿美元。“这笔最新的资金注入加速了Neros向多能力无人机制造商的转型,”联合创始人兼首席执行官Soren Monroe-Anderson表示。“虽然我们每年生产100万架无人机的目标保持不变,但我们能够支持的平台范围和任务类型正在迅速扩展。自去年11月上一轮融资以来,核心业务增长迅猛。这笔资金使我们能够以决定
宇树科技,A股首个人形机器人概念股,定于8月19日上市,估值约610亿元人民币
定于8月19日在科创板上市的越数科技,将以每股150.80元的价格上市,发行后市值约为609.93亿元。其市盈率高达219.23,估值显著高于行业平均水平。该公司计划发行4044.64万股新股,占发行后总股本的10%,预计募集资金约60.99亿元。网上发行中签率仅为0.01809759%,成为科创板历史上竞争最为激烈的IPO之一。财务预测显示,2025年营收约为17亿元,扣除非经常性损益后归属于股东的净利润为5.91亿元。按发行后市值计算,静态市盈率超过100倍,反映出市场对其高增长的预期。
阿里玄元M890 Ultra节点现已兼容Qwen3.8,可在百炼平台进行推理
阿里云于7月23日确认,其“玄武M890”超级节点已成功集成最新旗舰大模型Qwen3.8,使其在阿里云百炼平台上线模型推理服务。这一里程碑事件确立了玄武M890作为中国首个支持万亿参数以上大模型稳定运行的超级节点系统,标志着国内大模型计算调度软硬件协同方面取得重大突破。Qwen3.8是阿里云最新推出的超大规模旗舰模型,拥有高达2.4万亿参数。传统AI集群在处理高吞吐、低延迟和高并发推理需求时,常因节点间通信带宽受限而面临性能瓶颈。为确保如此规模下的稳定高效运行,模型参数通常需拆分并分布在数十甚
相关专题推荐
自动化
 n8n 人工智能自动化工具,适用于内部运维、数据同步和多步骤代理流程
2026年最新最佳n8n AI自动化工具——适用于内部运营、数据同步和多步骤代理流程——现已发布!XIX.AI精心甄选了一系列广受好评、功能强大的颠覆性工具,可提升所有工作任务的生产力。 每款工具均经过严格的实际应用测试以确保可靠性,并附有详细的免费版与付费版对比分析及每周更新的排行榜。这些必试选项能助您发挥人工智能优势,轻松优化工作流程。立即探索,发现最适合您的工具!
 11 个工具
 xix.ai
提示词
适合多模型团队的最佳提示词管理工具
2026年最新最佳、评分最高的面向多模型团队的提示词管理工具! XIX.AI 精心精选了一系列功能强大、颠覆性的必试工具,提供免费与付费版本对比、实际应用测试及详细排名。这些广受好评的解决方案通过优化工作流程、消除重复劳动并在所有团队项目中激发创造力,能显著提升工作效率。立即探索,发现最适合您的工具,今天就开始创作吧!
9 个工具
xix.ai
会议助理
适用于远程团队的 AI 会议摘要工具
2026年最新最受欢迎的远程团队AI会议摘要工具!XIX.AI精心挑选了一系列功能强大、颠覆性的必试工具,这些工具均经过实际测试,可提供准确的会议记录和可操作的洞察。 您将看到免费版与付费版的对比数据以及详细排名,助您挑选出最适合的方案,从而提升工作效率并优化团队沟通。立即探索,释放您的AI优势!
13 个工具
xix.ai
软件开发
最佳 AI DevOps 辅助工具:监控部署、日志及故障事件
2026年最新、最优秀、评分最高的AI DevOps辅助工具汇总,专为监控部署流程、日志记录及故障处理而设计。XIX.AI通过实际应用测试与严格的评分体系,提供了极具突破性的强大工具,能够显著提升工作效率。您可以查看免费版与付费版的对比信息,找到最适合您工作流程的理想解决方案。立即探索,让AI优势助力您的业务发展。
7 个工具
xix.ai
图像编辑
适用于产品照片的AI背景去除工具
2026年最新、最受欢迎、评分最高的产品照片AI背景去除工具已登陆XIX.AI!我们精心挑选的这份清单包含了一系列功能强大、颠覆性的解决方案,这些工具均通过实际测试验证,可呈现专业级效果。 您将在此找到免费版与付费版的对比分析、每周更新的排行榜,以及不容错过的精选工具,助您提升工作效率,轻松打造无瑕疵的产品照片。立即探索,释放您的AI优势!
11 个工具
xix.ai
代码
用于 GitHub 仓库的 AI 拉取请求审查工具
2026 年最新最佳顶级评分 AI 拉取请求审查工具适用于 GitHub 仓库,现已在 XIX.AI 上线!我们的精选列表包含强大且改变游戏规则的方案,帮助团队简化代码审查流程、更快发现错误,并通过实际测试提升生产力。获取免费与付费版的对比,找到最适合您工作流的工具。立即探索,释放您的 AI 优势!
10 个工具
xix.ai

 评论 (0)
0/500
在人工智能视频生成技术迅速发展的时代,画面与音频之间的脱节——通常表现为静音或音画不同步——仍然是影响观众沉浸感的一大障碍。 为应对这一挑战,阿里巴巴的通一实验室推出了PrismAudio——一个创新的视频转音频框架。这项研究已被顶级人工智能会议ICLR 2026录用,致力于自动将视频内容与精准的环境音效进行同步。
生成前的推理:“思维链”实现音频掌控
传统的音频生成模型通常基于“直觉”运作,经常产生脱节的结果——例如马蹄声听起来像鸟鸣,或者音频滞后于视觉动作。PrismAudio 的独特之处在于采用了“先规划,再生成”的方法。
“思维链”分解过程:在生成音频之前,模型会逐帧分析视频:识别场景元素、确定声音起始时间、评估音频特征(如清晰度或深度),并定位声音在空间中的来源。
多维度评估:为确保高质量输出,开发团队整合了强化学习技术,利用四个“虚拟评估员”从语义一致性、时间同步性、美学质量和空间准确性四个维度对结果进行评分。这种多维度的反馈循环解决了此前模型常出现的“只优化某一方面而忽视其他方面”的问题。
轻量且高效:0.6 秒内处理 9 秒视频
除了准确性之外,PrismAudio 还具备卓越的速度。借助其专有的Fast-GRPO训练算法,该模型在保持运行效率的同时,实现了显著的性能提升:
紧凑架构,成效显著:该模型仅含 5.18 亿个参数,远小于同类系统——后者通常需要数百亿个参数。
响应迅捷:为一段9秒的视频片段生成高质量音频仅需0.63秒,性能已接近实时水平。
行业视角:真实环境音效的崛起
PrismAudio的推出不仅为电影后期制作和短视频创作提供了一款强大的自动化工具,还为多对象生成开辟了新的路径。随着AI在平衡音频质感与空间定位方面的能力不断提升,未来的视频制作将越来越接近实现真正的“所见即所闻”的保真度。
论文链接:arXiv:2511.18833
开源链接:https://prismaudio-project.github.io/







 Neros Technologies 获得 2.5 亿美元融资,计划到 2026 年部署防御无人机
Neros Archer:一款专为模块化有效载荷和弹性通信链路设计的FPV无人机。| 来源:NerosNeros Inc.已完成2.5亿美元的C轮融资,将该国防无人机承包商的估值提升至25亿美元。“这笔最新的资金注入加速了Neros向多能力无人机制造商的转型,”联合创始人兼首席执行官Soren Monroe-Anderson表示。“虽然我们每年生产100万架无人机的目标保持不变,但我们能够支持的平台范围和任务类型正在迅速扩展。自去年11月上一轮融资以来,核心业务增长迅猛。这笔资金使我们能够以决定
 宇树科技,A股首个人形机器人概念股,定于8月19日上市,估值约610亿元人民币
定于8月19日在科创板上市的越数科技,将以每股150.80元的价格上市,发行后市值约为609.93亿元。其市盈率高达219.23,估值显著高于行业平均水平。该公司计划发行4044.64万股新股,占发行后总股本的10%,预计募集资金约60.99亿元。网上发行中签率仅为0.01809759%,成为科创板历史上竞争最为激烈的IPO之一。财务预测显示,2025年营收约为17亿元,扣除非经常性损益后归属于股东的净利润为5.91亿元。按发行后市值计算,静态市盈率超过100倍,反映出市场对其高增长的预期。
 阿里玄元M890 Ultra节点现已兼容Qwen3.8,可在百炼平台进行推理
阿里云于7月23日确认,其“玄武M890”超级节点已成功集成最新旗舰大模型Qwen3.8,使其在阿里云百炼平台上线模型推理服务。这一里程碑事件确立了玄武M890作为中国首个支持万亿参数以上大模型稳定运行的超级节点系统,标志着国内大模型计算调度软硬件协同方面取得重大突破。Qwen3.8是阿里云最新推出的超大规模旗舰模型,拥有高达2.4万亿参数。传统AI集群在处理高吞吐、低延迟和高并发推理需求时,常因节点间通信带宽受限而面临性能瓶颈。为确保如此规模下的稳定高效运行,模型参数通常需拆分并分布在数十甚
2026年最新最佳n8n AI自动化工具——适用于内部运营、数据同步和多步骤代理流程——现已发布!XIX.AI精心甄选了一系列广受好评、功能强大的颠覆性工具,可提升所有工作任务的生产力。 每款工具均经过严格的实际应用测试以确保可靠性,并附有详细的免费版与付费版对比分析及每周更新的排行榜。这些必试选项能助您发挥人工智能优势,轻松优化工作流程。立即探索,发现最适合您的工具!
11 个工具
xix.ai
2026年最新最佳、评分最高的面向多模型团队的提示词管理工具! XIX.AI 精心精选了一系列功能强大、颠覆性的必试工具,提供免费与付费版本对比、实际应用测试及详细排名。这些广受好评的解决方案通过优化工作流程、消除重复劳动并在所有团队项目中激发创造力,能显著提升工作效率。立即探索,发现最适合您的工具,今天就开始创作吧!
9 个工具
xix.ai
2026年最新最受欢迎的远程团队AI会议摘要工具!XIX.AI精心挑选了一系列功能强大、颠覆性的必试工具,这些工具均经过实际测试,可提供准确的会议记录和可操作的洞察。 您将看到免费版与付费版的对比数据以及详细排名,助您挑选出最适合的方案,从而提升工作效率并优化团队沟通。立即探索,释放您的AI优势!
13 个工具
xix.ai
2026年最新、最优秀、评分最高的AI DevOps辅助工具汇总,专为监控部署流程、日志记录及故障处理而设计。XIX.AI通过实际应用测试与严格的评分体系,提供了极具突破性的强大工具,能够显著提升工作效率。您可以查看免费版与付费版的对比信息,找到最适合您工作流程的理想解决方案。立即探索,让AI优势助力您的业务发展。
7 个工具
xix.ai
2026年最新、最受欢迎、评分最高的产品照片AI背景去除工具已登陆XIX.AI!我们精心挑选的这份清单包含了一系列功能强大、颠覆性的解决方案,这些工具均通过实际测试验证,可呈现专业级效果。 您将在此找到免费版与付费版的对比分析、每周更新的排行榜,以及不容错过的精选工具,助您提升工作效率,轻松打造无瑕疵的产品照片。立即探索,释放您的AI优势!
11 个工具
xix.ai
2026 年最新最佳顶级评分 AI 拉取请求审查工具适用于 GitHub 仓库,现已在 XIX.AI 上线!我们的精选列表包含强大且改变游戏规则的方案,帮助团队简化代码审查流程、更快发现错误,并通过实际测试提升生产力。获取免费与付费版的对比,找到最适合您工作流的工具。立即探索,释放您的 AI 优势!
10 个工具
xix.ai












