


 Дом
Tongyi Lab представляет PrismAudio для двунаправленного разделения аудио и видео
В эпоху стремительного развития технологий генерации видео с помощью ИИ несогласованность между изображением и звуком — часто проявляющаяся в виде тишины или несоответствия звукового сопровождения — по-прежнему остается серьезным препятствием для погружения зрителя в происходящее. Решая эту проблему, лаборатория Tongyi Lab компании Alibaba представила PrismAudio — инновационную платформу для преобразования видео в аудио. Это исследование, принятое к публикации на ведущей конференции по искусственному интеллекту ICLR 2026, посвящено автоматической синхронизации видеоконтента с точными звуковыми эффектами окружающей среды.
Анализ перед генерацией: управление звуком с помощью «цепочки мыслей»
Обычные модели генерации звука, как правило, работают на основе «интуиции», что часто приводит к несогласованным результатам — например, когда стук копыт лошади звучит как щебетание птиц, или звук отстает от визуального действия. PrismAudio отличается тем, что использует подход «сначала план, потом генерация».
Цепочка декомпозиции мысли: перед генерацией звука модель анализирует видео кадр за кадром: идентифицирует элементы сцены, определяет момент появления звука, оценивает характеристики звука (например, четкость или глубину) и локализует источник звука в пространстве.
Многомерная оценка: чтобы обеспечить высокое качество результатов, команда разработчиков интегрировала метод обучения с подкреплением, используя четыре «виртуальных оценщика» для оценки результатов по таким критериям, как семантическая согласованность, временная синхронизация, эстетическое качество и пространственная точность. Эта многогранная петля обратной связи решает распространенную проблему, когда предыдущие модели оптимизировались под один аспект, игнорируя остальные.
Легкость и эффективность: обработка 9-секундных видео за 0,6 секунды
Помимо точности, PrismAudio обеспечивает исключительную скорость. Благодаря собственному алгоритму обучения Fast-GRPO модель достигает значительного повышения производительности при сохранении операционной эффективности:
Компактная архитектура, высокая эффективность: с всего лишь 518 миллионами параметров модель значительно меньше, чем сопоставимые системы, которым часто требуются десятки миллиардов параметров.
Быстрая реакция: генерация высококачественного аудио для 9-секундного видеоролика занимает всего 0,63 секунды, что близко к производительности в режиме реального времени.
Взгляд из отрасли: рост популярности аутентичного окружающего звука
Запуск PrismAudio не только предоставляет надёжный инструмент автоматизации для постпродакшна фильмов и создания короткометражных видео, но и вдохновляет на новые подходы к генерации нескольких объектов. По мере того как ИИ совершенствует свою способность балансировать текстуру звука и пространственное позиционирование, будущее видеопроизводство будет всё в большей степени достигать подлинной точности по принципу «что видишь, то и слышишь».
Ссылка на статью: arXiv:2511.18833
Ссылка на открытый исходный код: https://prismaudio-project.github.io/
Связанная статья
 Юйшу Технологии, первая акция A-Share в сфере человекоподобных роботов, устанавливает 19 августа листинг с оценкой ~61 миллиард юаней
Запланированное к листингу на Сцене технологических инноваций 19 августа, Yue Shu Technology дебютирует по цене 150,80 юаней за акцию, формируя рыночную капитализацию после выпуска примерно в 60,993 млрд юаней. При коэффициенте цена/прибыль (P/E) 219
Узел Ali Zhenwu M890 Ultra теперь совместим с Qwen3.8, доступен на платформе BaiLian для вывода
Alibaba Cloud подтвердила 23 июля, что её супернода Zhenwu M890 успешно интегрирована с новейшей флагманской большой языковой моделью Qwen3.8, сделав её доступной для сервисов вывода моделей на платформе Alibaba Cloud BaiLian. Этот рубеж закрепляет з
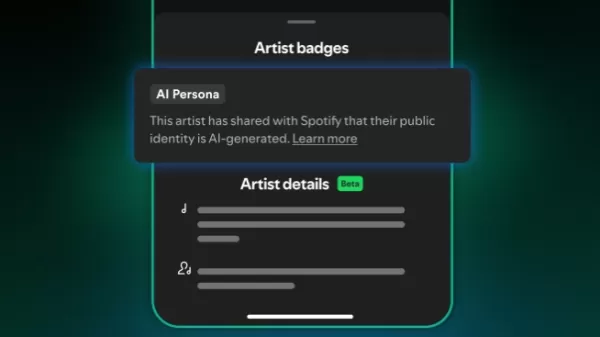
Spotify вводит теги ИИ-персон; алгоритмические плейлисты по умолчанию исключают виртуальных ИИ-артистов
11 августа Spotify объявил о запуске системы тегирования профилей «ИИ-персонаж» (AI Persona) в середине сентября. Эта инициатива четко идентифицирует виртуальных исполнителей, созданных с помощью искусственного интеллекта, и по умолчанию исключает та
Рекомендации по связанным специальным темам
автоматизация
 Инструменты n8n для автоматизации на базе ИИ: управление внутренними операциями, синхронизация данных и многоэтапные рабочие процессы агентов
2026 год: представлены новейшие и лучшие инструменты n8n для автоматизации с помощью ИИ, предназначенные для внутренних операций, синхронизации данных и многоэтапных рабочих процессов агентов! XIX.AI составила рейтинг самых популярных и мощных инструментов, способных кардинально изменить подход к работе и повысить продуктивность при выполнении любых рабочих задач. Каждая позиция в списке проходит тщательные тесты в реальных условиях для обеспечения надёжности, сопровождается подробным сравнением бесплатных и платных версий, а также еженедельно обновляемым рейтингом. Варианты, которые обязательно стоит попробовать, помогут вам раскрыть потенциал ИИ и без лишних усилий оптимизировать рабочие процессы. Ознакомьтесь с ними прямо сейчас, чтобы найти идеальный инструмент для себя!
 11 инструментов
 xix.ai
Быстрый
Лучшие инструменты для управления промтами в командах, работающих с несколькими моделями
2026: новейшие и лучшие инструменты для управления промптами, получившие высокие оценки, для команд, работающих с несколькими моделями! XIX.AI подготовила подборку мощных, революционных инструментов, которые обязательно стоит попробовать. В ней представлено сравнение бесплатных и платных версий, результаты реальных тестов и подробные рейтинги. Эти лучшие решения помогают значительно повысить продуктивность за счет оптимизации рабочих процессов, устранения повторяющихся действий и раскрытия творческого потенциала во всех проектах команды. Ознакомьтесь с подборкой прямо сейчас, чтобы найти идеальный инструмент и начать творить уже сегодня!
9 инструментов
xix.ai
Помощник по встречам
Инструменты для составления отчетов о совещаниях с использованием ИИ для удаленных команд
2026: лучшие и самые популярные инструменты для составления отчетов о встречах с помощью ИИ для удаленных команд! XIX.AI подготовила подборку мощных и революционных инструментов, которые обязательно стоит попробовать. Все они прошли реальные испытания и обеспечивают точные стенограммы и полезные аналитические выводы. Здесь вы найдете сравнительные данные по бесплатным и платным версиям, а также подробные рейтинги, которые помогут вам выбрать идеальный вариант для повышения продуктивности и оптимизации коммуникации в команде. Ознакомьтесь с ними прямо сейчас, чтобы раскрыть весь потенциал искусственного интеллекта!
13 инструментов
xix.ai
Разработка программного обеспечения
Лучшие инструменты AI для DevOps: мониторинг развертываний, журналов событий и инцидентов
2026 год: лучшие и наиболее высоко оценённые инструменты AI DevOps для мониторинга процессов развертывания, логов и инцидентов. XIX.AI предлагает мощные решения, способные кардинально повысить производительность благодаря тестированию в реальных условиях и строгой системе оценки. Получите бесплатное сравнение версий с платными, чтобы выбрать оптимальное решение для вашей рабочей схемы. Ознакомьтесь с продуктом прямо сейчас, чтобы раскрыть потенциал использования ИИ в вашей деятельности.
7 инструментов
xix.ai
Редактирование изображений
Инструменты на базе ИИ для удаления фона на фотографиях товаров
2026 года: лучшие и самые популярные инструменты для удаления фона с фотографий товаров с помощью ИИ — уже здесь, на XIX.AI! В наш тщательно подобранный список вошли мощные, революционные решения, которые, как показали практические тесты, позволяют добиться профессиональных результатов. Здесь вы найдёте сравнение бесплатных и платных версий, еженедельно обновляемые рейтинги, а также варианты, которые обязательно стоит попробовать, чтобы повысить продуктивность и без лишних хлопот создавать безупречные фотографии товаров. Ознакомьтесь с ними прямо сейчас, чтобы раскрыть весь потенциал ИИ!
11 инструментов
xix.ai
код
Инструменты для проверки запросов на вытягивание с использованием ИИ для репозиториев GitHub
2026 г. лучшие, самые популярные и высокооцененные инструменты для проверки pull-запросов на основе ИИ для репозиториев GitHub уже доступны на XIX.AI! В нашем тщательно отобранном списке представлены мощные, революционные решения, которые помогают командам оптимизировать процесс проверки кода, быстрее выявлять ошибки и повышать продуктивность благодаря реальным тестам. Получите бесплатное сравнение платных и бесплатных версий, чтобы найти идеальный инструмент для вашего рабочего процесса. Исследуйте сейчас, чтобы получить преимущество благодаря ИИ!
10 инструментов
xix.ai

 Комментарии (0)
В эпоху стремительного развития технологий генерации видео с помощью ИИ несогласованность между изображением и звуком — часто проявляющаяся в виде тишины или несоответствия звукового сопровождения — по-прежнему остается серьезным препятствием для погружения зрителя в происходящее. Решая эту проблему, лаборатория Tongyi Lab компании Alibaba представила PrismAudio — инновационную платформу для преобразования видео в аудио. Это исследование, принятое к публикации на ведущей конференции по искусственному интеллекту ICLR 2026, посвящено автоматической синхронизации видеоконтента с точными звуковыми эффектами окружающей среды.
Анализ перед генерацией: управление звуком с помощью «цепочки мыслей»
Обычные модели генерации звука, как правило, работают на основе «интуиции», что часто приводит к несогласованным результатам — например, когда стук копыт лошади звучит как щебетание птиц, или звук отстает от визуального действия. PrismAudio отличается тем, что использует подход «сначала план, потом генерация».
Цепочка декомпозиции мысли: перед генерацией звука модель анализирует видео кадр за кадром: идентифицирует элементы сцены, определяет момент появления звука, оценивает характеристики звука (например, четкость или глубину) и локализует источник звука в пространстве.
Многомерная оценка: чтобы обеспечить высокое качество результатов, команда разработчиков интегрировала метод обучения с подкреплением, используя четыре «виртуальных оценщика» для оценки результатов по таким критериям, как семантическая согласованность, временная синхронизация, эстетическое качество и пространственная точность. Эта многогранная петля обратной связи решает распространенную проблему, когда предыдущие модели оптимизировались под один аспект, игнорируя остальные.
Легкость и эффективность: обработка 9-секундных видео за 0,6 секунды
Помимо точности, PrismAudio обеспечивает исключительную скорость. Благодаря собственному алгоритму обучения Fast-GRPO модель достигает значительного повышения производительности при сохранении операционной эффективности:
Компактная архитектура, высокая эффективность: с всего лишь 518 миллионами параметров модель значительно меньше, чем сопоставимые системы, которым часто требуются десятки миллиардов параметров.
Быстрая реакция: генерация высококачественного аудио для 9-секундного видеоролика занимает всего 0,63 секунды, что близко к производительности в режиме реального времени.
Взгляд из отрасли: рост популярности аутентичного окружающего звука
Запуск PrismAudio не только предоставляет надёжный инструмент автоматизации для постпродакшна фильмов и создания короткометражных видео, но и вдохновляет на новые подходы к генерации нескольких объектов. По мере того как ИИ совершенствует свою способность балансировать текстуру звука и пространственное позиционирование, будущее видеопроизводство будет всё в большей степени достигать подлинной точности по принципу «что видишь, то и слышишь».
Ссылка на статью: arXiv:2511.18833
Ссылка на открытый исходный код: https://prismaudio-project.github.io/








 Юйшу Технологии, первая акция A-Share в сфере человекоподобных роботов, устанавливает 19 августа листинг с оценкой ~61 миллиард юаней
Запланированное к листингу на Сцене технологических инноваций 19 августа, Yue Shu Technology дебютирует по цене 150,80 юаней за акцию, формируя рыночную капитализацию после выпуска примерно в 60,993 млрд юаней. При коэффициенте цена/прибыль (P/E) 219
 Узел Ali Zhenwu M890 Ultra теперь совместим с Qwen3.8, доступен на платформе BaiLian для вывода
Alibaba Cloud подтвердила 23 июля, что её супернода Zhenwu M890 успешно интегрирована с новейшей флагманской большой языковой моделью Qwen3.8, сделав её доступной для сервисов вывода моделей на платформе Alibaba Cloud BaiLian. Этот рубеж закрепляет з
 Spotify вводит теги ИИ-персон; алгоритмические плейлисты по умолчанию исключают виртуальных ИИ-артистов
11 августа Spotify объявил о запуске системы тегирования профилей «ИИ-персонаж» (AI Persona) в середине сентября. Эта инициатива четко идентифицирует виртуальных исполнителей, созданных с помощью искусственного интеллекта, и по умолчанию исключает та
2026 год: представлены новейшие и лучшие инструменты n8n для автоматизации с помощью ИИ, предназначенные для внутренних операций, синхронизации данных и многоэтапных рабочих процессов агентов! XIX.AI составила рейтинг самых популярных и мощных инструментов, способных кардинально изменить подход к работе и повысить продуктивность при выполнении любых рабочих задач. Каждая позиция в списке проходит тщательные тесты в реальных условиях для обеспечения надёжности, сопровождается подробным сравнением бесплатных и платных версий, а также еженедельно обновляемым рейтингом. Варианты, которые обязательно стоит попробовать, помогут вам раскрыть потенциал ИИ и без лишних усилий оптимизировать рабочие процессы. Ознакомьтесь с ними прямо сейчас, чтобы найти идеальный инструмент для себя!
11 инструментов
xix.ai
2026: новейшие и лучшие инструменты для управления промптами, получившие высокие оценки, для команд, работающих с несколькими моделями! XIX.AI подготовила подборку мощных, революционных инструментов, которые обязательно стоит попробовать. В ней представлено сравнение бесплатных и платных версий, результаты реальных тестов и подробные рейтинги. Эти лучшие решения помогают значительно повысить продуктивность за счет оптимизации рабочих процессов, устранения повторяющихся действий и раскрытия творческого потенциала во всех проектах команды. Ознакомьтесь с подборкой прямо сейчас, чтобы найти идеальный инструмент и начать творить уже сегодня!
9 инструментов
xix.ai
2026: лучшие и самые популярные инструменты для составления отчетов о встречах с помощью ИИ для удаленных команд! XIX.AI подготовила подборку мощных и революционных инструментов, которые обязательно стоит попробовать. Все они прошли реальные испытания и обеспечивают точные стенограммы и полезные аналитические выводы. Здесь вы найдете сравнительные данные по бесплатным и платным версиям, а также подробные рейтинги, которые помогут вам выбрать идеальный вариант для повышения продуктивности и оптимизации коммуникации в команде. Ознакомьтесь с ними прямо сейчас, чтобы раскрыть весь потенциал искусственного интеллекта!
13 инструментов
xix.ai
2026 год: лучшие и наиболее высоко оценённые инструменты AI DevOps для мониторинга процессов развертывания, логов и инцидентов. XIX.AI предлагает мощные решения, способные кардинально повысить производительность благодаря тестированию в реальных условиях и строгой системе оценки. Получите бесплатное сравнение версий с платными, чтобы выбрать оптимальное решение для вашей рабочей схемы. Ознакомьтесь с продуктом прямо сейчас, чтобы раскрыть потенциал использования ИИ в вашей деятельности.
7 инструментов
xix.ai
2026 года: лучшие и самые популярные инструменты для удаления фона с фотографий товаров с помощью ИИ — уже здесь, на XIX.AI! В наш тщательно подобранный список вошли мощные, революционные решения, которые, как показали практические тесты, позволяют добиться профессиональных результатов. Здесь вы найдёте сравнение бесплатных и платных версий, еженедельно обновляемые рейтинги, а также варианты, которые обязательно стоит попробовать, чтобы повысить продуктивность и без лишних хлопот создавать безупречные фотографии товаров. Ознакомьтесь с ними прямо сейчас, чтобы раскрыть весь потенциал ИИ!
11 инструментов
xix.ai
2026 г. лучшие, самые популярные и высокооцененные инструменты для проверки pull-запросов на основе ИИ для репозиториев GitHub уже доступны на XIX.AI! В нашем тщательно отобранном списке представлены мощные, революционные решения, которые помогают командам оптимизировать процесс проверки кода, быстрее выявлять ошибки и повышать продуктивность благодаря реальным тестам. Получите бесплатное сравнение платных и бесплатных версий, чтобы найти идеальный инструмент для вашего рабочего процесса. Исследуйте сейчас, чтобы получить преимущество благодаря ИИ!
10 инструментов
xix.ai












