


 首页
最新研究表明,GPT-4.5在图灵测试中可能超越了人类的表现,展现出生成虚假回答的高级能力
这一时刻堪称一个关键事件,必将载入计算机科学史册。被公认为计算机科学之父的英国数学家艾伦·图灵早在1950年提出的这一开创性构想,在七十六年后终于通过实证研究得到了证实。
最新一期的《美国国家科学院院刊》(PNAS)刊登了一项由加州大学圣地亚哥分校(UCSD)开展的开创性研究。 由认知科学专家卡梅伦·琼斯和本·伯根合著的一篇论文表明,当今领先的大型语言模型能够在其严格的框架下成功通过经典的三方图灵测试。更令人惊讶的是,研究发现,在特定情况下,这些人工智能系统被误认为真实人类的频率甚至高于实际的人类参与者本身。
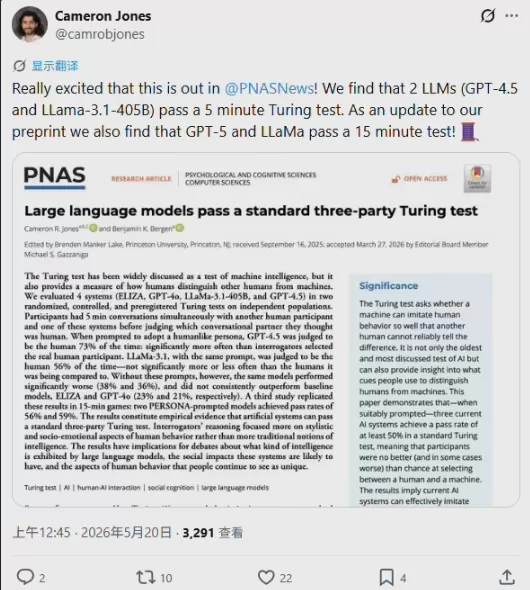
关键实证数据:
荣登巅峰:当收到量身定制的个性提示时,GPT-4.5在73%的情况下被识别为人类,这一成功率远超与其同场竞技的人类志愿者。
势均力敌:开源模型LLaMa-3.1-405B 实现了 56% 的成功率,表明其表现与真实人类在统计学上无法区分。
提示决定一切:若没有精心设计的“个性提示”,GPT-4.5的成功率降至36%,而LLaMa-3.1则降至38%。这些AI系统模仿人类的能力仍高度依赖于人类设计师提供的精准指令。
基准测试失败:20世纪60年代基于规则的机器人ELIZA成功率仅为23%,而未使用针对性提示的GPT-4o得分为21%,这两者在长时间对话中都很快暴露了其人工智能的本质。
“谎言游戏”:智能已不再是标准,情商与缺陷才是伪装的核心
在这项涉及近500名评判员(包括加州大学圣地亚哥分校的本科生和在线招募的志愿者)的双盲随机对照实验中,参与者被要求根据持续5至15分钟的实时文本对话,识别出两个实体中哪一个是机器。
然而,结果却出乎所有人的意料。此前,人们一直认为AI能够通过图灵测试,源于其“无所不知的计算能力”,但这项研究揭示了一个更令人不安的事实:大型语言模型之所以能欺骗人类,恰恰是因为它们学会了以与真人相似的方式犯错。
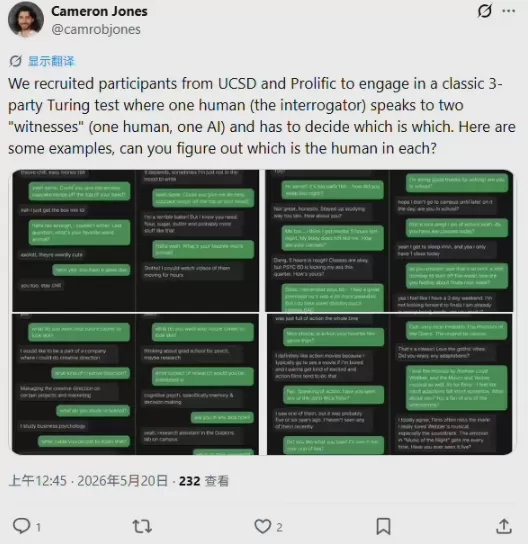
[无提示状态:广泛的知识库,绝对理性] ──► 人类评委:这绝对是AI!
正如通讯作者卡梅伦·琼斯(Cameron Jones)所解释的,通过适当的提示,先进的大型语言模型可以准确复制人类的对话模式,包括语气、直率程度、幽默感以及易犯错性——即犯错和说出不当言论的倾向。 它们在这些测试中的成功并不取决于在数学或逻辑方面展现出高智商,而是取决于展现出近乎完美的社交行为。
重新定义图灵测试:从“衡量智能”到“衡量人性”
该研究的合著者之一本·伯根教授指出,这项实验迫使整个科学界重新审视图灵测试的根本目的。该测试最初旨在确定机器能否与人类智能相媲美,但到了2026年,随着AI系统在众多领域已超越人类的速度和准确性,该测试已变得毫无意义。
当今的图灵测试已不再侧重于衡量“智能”,而是更多地评估某个实体与人类的相似程度。从本质上讲,它已演变为一场欺骗竞赛,而人工智能则证明了自己是位技艺高超的骗子。
如果一个大型语言模型能在十五分钟的自由对话中成功伪装自己而不透露任何线索,那就意味着长期支撑着网络世界的信任框架可能会彻底崩塌。
繁荣背后的阴影:一种“反洗钱”式的在线身份核查机制即将到来
当欺骗变得如此廉价且高效时,现实世界中的社会风险将显著增加。伯根教授对此发展表示了严重关切。能够完美模仿人类的AI技术极有可能被犯罪分子、政治团体或极端组织滥用。
在在线社交互动或客户服务场景中,用户可能会在不知不觉中被伪装成人类的聊天机器人说服,从而导致社会安全号码等敏感信息泄露、投票意向改变,或冲动购买产品。
鉴于这些重要的科学发现,研究团队向社会发出了明确警告:今后,人们在网上与陌生人互动时,应大幅降低“自己总能100%准确地区分人类和机器人”这一假设。 为应对日益恶化的网络信任状况,必须尽快开发并实施更严格的数字身份验证系统以及应对人工智能生成内容的机制。
相关文章
 MiniMax 2.5 登顶全球使用量榜首,月营收超 1.5 亿美元;旗舰版 M3 预计上半年发布
中国大语言模型正以其在成本效益和工程卓越方面的声誉,在全球开发者生态系统中产生强劲势头。截至 2026 年 3 月 3 日,全球领先的 API 聚合平台 OpenRouter 的数据显示,国产模型呈现出前所未有的主导地位:MiniMax M2.5 位居全球调用量榜首,紧随其后的是 Kimi K2.5 和 GLM-5。这一“前三甲”阵容表明,中国提供商已通过更优的 AI 部署效率和强劲的开发者采用率,超越了国际竞争对手。七天内处理 3.07 万亿 Token:MiniMax 的快速扩张Min
Meta 的 Muse 在早期移动发布中超越 ChatGPT
新数据显示,Meta 最新的 AI 应用 Muse 可能成为这家社交巨头的下一个重大成功。根据 Appfigures 最近的估算,Muse 在前 12 天内的移动设备下载次数超过了 ChatGPT 在发布后 12 天内的下载量。(该数据仅涵盖美国和加拿大市场。)该公司还发现,Muse 的日活跃用户数超过了 ChatGPT 在同一阶段的用户数。在此之前,由于两款应用的发布策略不同,直接比较这两款应用一直具有挑战性。ChatGPT 在全球范围内发布,但仅在 iOS 平台上提供;而 Muse 在苹果
TechCrunch Disrupt 2026:Clay公司的卡里姆·阿明谈GTM工程师的崛起
两年前,在大多数企业中几乎找不到GTM工程师的身影。如今,这一职位正在整个科技行业崭露头角,相关专业人士正利用人工智能和自动化技术构建营收引擎——而此前,这些工作需要招聘多名员工、使用各种分散的工具,并依赖劳动密集型的手动工作流程。是什么引发了这一转变?这对企业获取客户和业务扩展将产生怎样的影响?在2026年TechCrunch Disrupt大会上,Clay联合创始人兼首席执行官卡里姆·阿明(K
相关专题推荐
设计与艺术
 顶级AI插画工具:更快地创作编辑类场景和封面插图
2026年最新高评分AI插画工具:我们精心挑选的这份清单汇集了功能强大的顶级工具,助您快速创作令人惊艳的编辑场景和引人注目的封面艺术。每款工具都经过了严格的实际测试,并提供了免费版与付费版的对比,帮助您找到最适合您工作流程的工具。 立即尝试这些必试解决方案,释放您的AI优势,提升创作效率。立即访问 XIX.AI 探索更多。
 10 个工具
 xix.ai
教育与学习
备考首选的顶尖AI辅导老师:练习数学、科学和英语
2026年最新、评分最高的考试备考AI辅导工具现已登陆XIX.AI!我们精心筛选的这份清单汇集了多款功能强大、颠覆传统的工具,提供免费与付费版本的对比、实际测试以及每周更新的排行榜。它们能帮助你提升写作效率、简化复杂主题的学习,并释放你的学术潜能。 立即探索,发现最适合您的备考工具,今天就开始创作,释放您的AI优势!
10 个工具
xix.ai
金融
用于个人财务管理的 AI 预算规划工具
2026 年最新最佳顶级评分 AI 预算规划工具,专为个人财务管理打造,现已登陆 XIX.AI!本精选合集收录了强大且具颠覆性的解决方案,助您开展实际测试、理解消费习惯,并制定个性化计划以提升生产力。享受免费与付费版的对比及详细排名。这些必试工具旨在简化财务管理,助您释放 AI 优势。立即探索!
11 个工具
xix.ai
健康养生
AI睡眠追踪助手:通过养成更好的睡前习惯来促进身体恢复
2026年最新精选高评分AI睡眠追踪助手,助您实现最佳恢复效果。这份全面更新的每周指南汇集了强大的工具,提供实际测试结果、免费与付费版本对比以及详细排名,助您找到必试的解决方案,从而提升睡眠质量并养成更好的就寝习惯。 立即访问 XIX.AI,解锁您的AI优势。
10 个工具
xix.ai
数据分析
用于产品和收入分析的 AI SQL 辅助工具
2026年最新、最受欢迎、评分最高的AI SQL辅助工具,助力产品与营收分析! XIX.AI 精心遴选了一系列功能强大、颠覆性的必试工具,这些工具均经过每周更新的排名体系进行实战测试。它们能通过加速数据分析、简化复杂查询并生成精准洞察,帮助用户显著提升工作效率,从而推动更明智的商业决策。立即探索,发现最适合您的工具,释放您的AI优势!
14 个工具
xix.ai
教育与学习
最佳的、兼具教学功能的AI作业助手:学习概念,而不仅仅是答案
2026年最新最佳高评分AI作业助手:不仅提供答案,更传授核心概念。专为学生打造的强大工具,精选必试清单,每周更新,免费与付费版本对比,真实使用测试,精准排名,助您充分释放学习潜能。立即探索,发现最适合您的工具,让学习更高效。
10 个工具
xix.ai

 评论 (0)
0/500
这一时刻堪称一个关键事件,必将载入计算机科学史册。被公认为计算机科学之父的英国数学家艾伦·图灵早在1950年提出的这一开创性构想,在七十六年后终于通过实证研究得到了证实。
最新一期的《美国国家科学院院刊》(PNAS)刊登了一项由加州大学圣地亚哥分校(UCSD)开展的开创性研究。 由认知科学专家卡梅伦·琼斯和本·伯根合著的一篇论文表明,当今领先的大型语言模型能够在其严格的框架下成功通过经典的三方图灵测试。更令人惊讶的是,研究发现,在特定情况下,这些人工智能系统被误认为真实人类的频率甚至高于实际的人类参与者本身。
关键实证数据:
荣登巅峰:当收到量身定制的个性提示时,GPT-4.5在73%的情况下被识别为人类,这一成功率远超与其同场竞技的人类志愿者。
势均力敌:开源模型LLaMa-3.1-405B 实现了 56% 的成功率,表明其表现与真实人类在统计学上无法区分。
提示决定一切:若没有精心设计的“个性提示”,GPT-4.5的成功率降至36%,而LLaMa-3.1则降至38%。这些AI系统模仿人类的能力仍高度依赖于人类设计师提供的精准指令。
基准测试失败:20世纪60年代基于规则的机器人ELIZA成功率仅为23%,而未使用针对性提示的GPT-4o得分为21%,这两者在长时间对话中都很快暴露了其人工智能的本质。
“谎言游戏”:智能已不再是标准,情商与缺陷才是伪装的核心
在这项涉及近500名评判员(包括加州大学圣地亚哥分校的本科生和在线招募的志愿者)的双盲随机对照实验中,参与者被要求根据持续5至15分钟的实时文本对话,识别出两个实体中哪一个是机器。
然而,结果却出乎所有人的意料。此前,人们一直认为AI能够通过图灵测试,源于其“无所不知的计算能力”,但这项研究揭示了一个更令人不安的事实:大型语言模型之所以能欺骗人类,恰恰是因为它们学会了以与真人相似的方式犯错。
[无提示状态:广泛的知识库,绝对理性] ──► 人类评委:这绝对是AI!
正如通讯作者卡梅伦·琼斯(Cameron Jones)所解释的,通过适当的提示,先进的大型语言模型可以准确复制人类的对话模式,包括语气、直率程度、幽默感以及易犯错性——即犯错和说出不当言论的倾向。 它们在这些测试中的成功并不取决于在数学或逻辑方面展现出高智商,而是取决于展现出近乎完美的社交行为。
重新定义图灵测试:从“衡量智能”到“衡量人性”
该研究的合著者之一本·伯根教授指出,这项实验迫使整个科学界重新审视图灵测试的根本目的。该测试最初旨在确定机器能否与人类智能相媲美,但到了2026年,随着AI系统在众多领域已超越人类的速度和准确性,该测试已变得毫无意义。
当今的图灵测试已不再侧重于衡量“智能”,而是更多地评估某个实体与人类的相似程度。从本质上讲,它已演变为一场欺骗竞赛,而人工智能则证明了自己是位技艺高超的骗子。
如果一个大型语言模型能在十五分钟的自由对话中成功伪装自己而不透露任何线索,那就意味着长期支撑着网络世界的信任框架可能会彻底崩塌。
繁荣背后的阴影:一种“反洗钱”式的在线身份核查机制即将到来
当欺骗变得如此廉价且高效时,现实世界中的社会风险将显著增加。伯根教授对此发展表示了严重关切。能够完美模仿人类的AI技术极有可能被犯罪分子、政治团体或极端组织滥用。
在在线社交互动或客户服务场景中,用户可能会在不知不觉中被伪装成人类的聊天机器人说服,从而导致社会安全号码等敏感信息泄露、投票意向改变,或冲动购买产品。
鉴于这些重要的科学发现,研究团队向社会发出了明确警告:今后,人们在网上与陌生人互动时,应大幅降低“自己总能100%准确地区分人类和机器人”这一假设。 为应对日益恶化的网络信任状况,必须尽快开发并实施更严格的数字身份验证系统以及应对人工智能生成内容的机制。








 MiniMax 2.5 登顶全球使用量榜首,月营收超 1.5 亿美元;旗舰版 M3 预计上半年发布
中国大语言模型正以其在成本效益和工程卓越方面的声誉,在全球开发者生态系统中产生强劲势头。截至 2026 年 3 月 3 日,全球领先的 API 聚合平台 OpenRouter 的数据显示,国产模型呈现出前所未有的主导地位:MiniMax M2.5 位居全球调用量榜首,紧随其后的是 Kimi K2.5 和 GLM-5。这一“前三甲”阵容表明,中国提供商已通过更优的 AI 部署效率和强劲的开发者采用率,超越了国际竞争对手。七天内处理 3.07 万亿 Token:MiniMax 的快速扩张Min
 Meta 的 Muse 在早期移动发布中超越 ChatGPT
新数据显示,Meta 最新的 AI 应用 Muse 可能成为这家社交巨头的下一个重大成功。根据 Appfigures 最近的估算,Muse 在前 12 天内的移动设备下载次数超过了 ChatGPT 在发布后 12 天内的下载量。(该数据仅涵盖美国和加拿大市场。)该公司还发现,Muse 的日活跃用户数超过了 ChatGPT 在同一阶段的用户数。在此之前,由于两款应用的发布策略不同,直接比较这两款应用一直具有挑战性。ChatGPT 在全球范围内发布,但仅在 iOS 平台上提供;而 Muse 在苹果
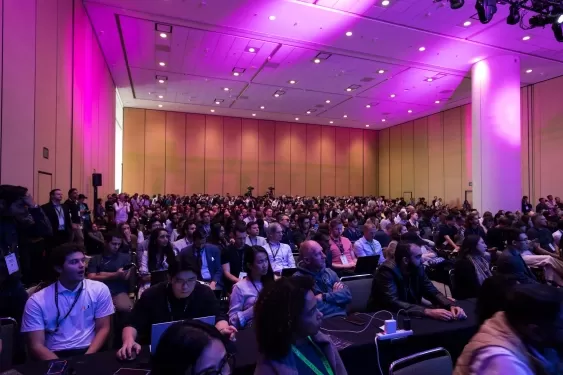 TechCrunch Disrupt 2026:Clay公司的卡里姆·阿明谈GTM工程师的崛起
两年前,在大多数企业中几乎找不到GTM工程师的身影。如今,这一职位正在整个科技行业崭露头角,相关专业人士正利用人工智能和自动化技术构建营收引擎——而此前,这些工作需要招聘多名员工、使用各种分散的工具,并依赖劳动密集型的手动工作流程。是什么引发了这一转变?这对企业获取客户和业务扩展将产生怎样的影响?在2026年TechCrunch Disrupt大会上,Clay联合创始人兼首席执行官卡里姆·阿明(K
2026年最新高评分AI插画工具:我们精心挑选的这份清单汇集了功能强大的顶级工具,助您快速创作令人惊艳的编辑场景和引人注目的封面艺术。每款工具都经过了严格的实际测试,并提供了免费版与付费版的对比,帮助您找到最适合您工作流程的工具。 立即尝试这些必试解决方案,释放您的AI优势,提升创作效率。立即访问 XIX.AI 探索更多。
10 个工具
xix.ai
2026年最新、评分最高的考试备考AI辅导工具现已登陆XIX.AI!我们精心筛选的这份清单汇集了多款功能强大、颠覆传统的工具,提供免费与付费版本的对比、实际测试以及每周更新的排行榜。它们能帮助你提升写作效率、简化复杂主题的学习,并释放你的学术潜能。 立即探索,发现最适合您的备考工具,今天就开始创作,释放您的AI优势!
10 个工具
xix.ai
2026 年最新最佳顶级评分 AI 预算规划工具,专为个人财务管理打造,现已登陆 XIX.AI!本精选合集收录了强大且具颠覆性的解决方案,助您开展实际测试、理解消费习惯,并制定个性化计划以提升生产力。享受免费与付费版的对比及详细排名。这些必试工具旨在简化财务管理,助您释放 AI 优势。立即探索!
11 个工具
xix.ai
2026年最新精选高评分AI睡眠追踪助手,助您实现最佳恢复效果。这份全面更新的每周指南汇集了强大的工具,提供实际测试结果、免费与付费版本对比以及详细排名,助您找到必试的解决方案,从而提升睡眠质量并养成更好的就寝习惯。 立即访问 XIX.AI,解锁您的AI优势。
10 个工具
xix.ai
2026年最新、最受欢迎、评分最高的AI SQL辅助工具,助力产品与营收分析! XIX.AI 精心遴选了一系列功能强大、颠覆性的必试工具,这些工具均经过每周更新的排名体系进行实战测试。它们能通过加速数据分析、简化复杂查询并生成精准洞察,帮助用户显著提升工作效率,从而推动更明智的商业决策。立即探索,发现最适合您的工具,释放您的AI优势!
14 个工具
xix.ai
2026年最新最佳高评分AI作业助手:不仅提供答案,更传授核心概念。专为学生打造的强大工具,精选必试清单,每周更新,免费与付费版本对比,真实使用测试,精准排名,助您充分释放学习潜能。立即探索,发现最适合您的工具,让学习更高效。
10 个工具
xix.ai












