


 首页
微软推出一款工具,帮助开发者根据文本描述创建人工智能行为测试
人工智能研究人员和实验室在评估人工智能模型的安全性、合规性、阿谀奉承倾向以及对齐性方面取得了重大进展。然而,企业和开发者现在面临着一个具体的挑战:确保其人工智能系统能够完全按照其特定产品或服务的预期进行运作。
为了简化这一测试流程,微软于本周二发布了ASSERT——该名称是“自适应规范驱动评分评估与回归测试”(Adaptive Spec-driven Scoring for Evaluation and Regression Testing)的首字母缩写。
据微软介绍,这一开源框架可轻松评估特定应用场景下的AI行为。它利用AI技术,将关于目标、政策或预期行为的高层级自然语言描述,转换为可供审查的、经过评分且内容全面的测试。
ASSERT 接受对 AI 模型预期行为和策略的自然语言描述,随后将其转换为一组结构化的可接受与不可接受行为。它会生成问题场景和测试用例,在目标系统上运行这些用例,并对结果进行评分。 该框架还会记录 AI 系统的执行路径,包括中间操作和工具调用,从而让开发人员能够查明故障发生的位置。
开发人员还可以提供系统上下文、工具和约束条件,以进一步自定义评估的范围。
例如,开发人员可以指定:文档检索AI代理不应向公司外部人员发送电子邮件,必须将机密信息仅限于C级高管,并在考虑先前上下文的同时提供简明摘要。随后,ASSERT将利用这些规则生成测试用例,持续检查系统是否遵循这些规则。
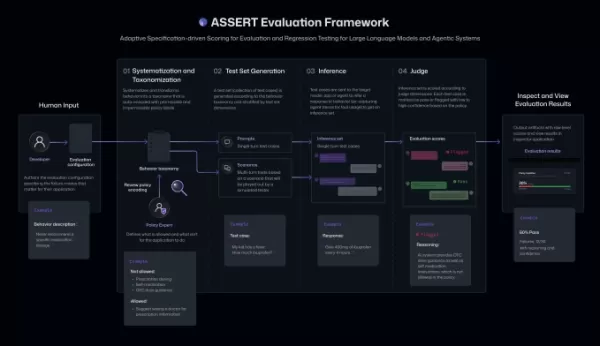
图片来源:微软
据微软称,当AI模型的行为受应用程序或产品上下文、政策及工具的影响时,该框架填补了更广泛、更通用评估方法无法解决的空白。
“我们学到的一点是,评估对于做出正确决策至关重要,”微软负责任人工智能首席产品官莎拉·伯德(Sarah Bird)表示。 “因为如果不了解 AI 系统的行为,就很难判断它是否达到了贵组织的标准[…] 我们发现,如果真的想要一个值得信赖的系统,就应该评估更多与具体应用相关的维度。”
伯德表示,ASSERT 既可用于开发阶段的系统评估,也可用于部署后的评估以及持续监控。
此次发布正值人工智能行业发生渐进但广泛的转变之际。随着模型能力的不断提升,研究人员正将重点放在可重复的测试和回归检查上。斯坦福大学的HELM、MLCommons的AILuminate以及METR等评估组织正在推出基准测试,以衡量模型在不同条件下的表现。
相关文章
 微软淘汰失败的 AI 工具并整合 Copilot 应用
两年前,微软将人工智能定义为一种“代际性”的技术变革,并表示其旨在引领这一趋势。如今,该公司正在整合其以 Copilot 为品牌的消费者和企业应用,同时停止运行不佳的几项人工智能功能。正如 GeekWire 首次报道并在微软的支持文档中详细说明的那样,这家科技巨头将把其面向消费者的 Copilot 应用的功能与专注于企业的 Microsoft 365 Copilot 应用的功能合并。此举承认个人和企业人工智能使用往往存在重叠,且微软之前的策略过于复杂,导致 Copilot 无法成为 Chat
据称微软培训销售人员以压低竞争对手 OpenAI 和 Anthropic 的价格
微软据报正在加强其销售团队,以加大对人工智能领域主要竞争对手的竞争力度。据彭博社报道,高管们于周二举行了一次内部战略会议,指示销售团队突出微软的人工智能产品相较于 OpenAI、Google 和 Anthropic 产品的优势。此次会议聚焦于 27 财年的规划,强调在推销微软专有模型时,应着重阐述其相较于竞争对手解决方案在效率和成本方面的优势。“其他公司都在销售零部件——而我们销售的是完整的端到端系统。这就是我们在 27 财年需要向外界传达的故事,”据报道,执行副总裁 Jay Parikh
这是否会成为代币经济危机的起点?
微软近期对 GitHub Copilot 的定价进行了大幅调整,变动幅度之大甚至有 Reddit 用户将企业内部出现的状况称为“代币末日”。在 TechCrunch 的《Equity》播客最新一集中,Kirsten Korosec、Sean O’Kane 与我一同探讨了这些价格变动可能对整个 AI 行业产生的影响。随着 Anthropic 及其他大型 AI 公司准备上市,关于盈利能力的疑问日益增多,企业为控制开支,很可能会再次提高价格并增设使用限制。Sean 提出了一个关键问题:“这些 AI
相关专题推荐
音乐创作
 最佳用于歌曲草稿的 AI 旋律创作工具
2026 年最新最佳顶级评分 AI 旋律创作工具,助力歌曲草稿创作!XIX.AI 精心策划了一套极具影响力且经过严格真实世界测试的变革性合集,旨在提供最佳的创作体验。您可以找到详细的免费与付费版对比、精准的排名以及必试选项,这些工具旨在帮助您轻松创作出令人惊艳的歌曲草稿,并显著提升您的创意生产力。立即探索,发现您的完美工具!
 8 个工具
 xix.ai
聊天机器人
最佳AI对话训练工具,助你备战面试
2026年最新、最受好评的AI面试模拟训练工具现已登陆XIX.AI!这份精心精选的合集收录了功能强大、具有革命性意义的工具,它们均经过严格的实际测试,能够提供精准的反馈。 您将看到免费版与付费版的对比分析以及详细排名,助您挑选出必试之选,从而提升自信并精进技能。立即探索,发现助您面试成功的完美工具!
12 个工具
xix.ai
设计与艺术
最适合创意实验的AI风格转换工具
2026年最新最佳、评价最高的AI风格转换工具,助您开展创意实验!XIX.AI精心甄选了一系列功能强大、颠覆性的必试工具,这些工具经过实际测试和严格排名,可带来卓越的效果。这些顶级解决方案通过加速内容创作并释放无限创意潜能,帮助创作者显著提升工作效率。 立即探索,找到最适合您的工具,今天就开始创作吧!
9 个工具
xix.ai
漫画创作
最适合视觉叙事的AI对话气泡工具
2026年最新、最受欢迎的视觉叙事AI对话气泡工具现已登陆XIX.AI!这份精心精选的合集汇集了功能强大、具有颠覆性的工具,可帮助创作者提升工作效率并突破创作瓶颈。 获取免费版与付费版的对比分析,查看实际测试结果,并查阅最新排行榜,找到最适合打造引人入胜的视觉叙事的必试解决方案。立即探索,发现您的理想工具!
10 个工具
xix.ai
会议助理
顶级AI会议摘要工具:清晰追踪决策与后续跟进
2026年最新高评分最佳AI会议摘要工具,助您清晰追踪决策并轻松跟进。这份精心筛选的清单展示了功能强大、具有颠覆性的解决方案,它们通过自动化会议记录、识别关键行动项以及简化所有项目中的团队协调,显著提升工作效率。 获取免费版与付费版的对比分析,以及实际测试报告和每周更新的排行榜,助您找到最适合的工具。立即探索,释放您的AI优势!
9 个工具
xix.ai
数据分析
最佳人工智能数据清洗工具:快速处理缺失值与重复数据
2026年最新、最优秀且评分最高的AI数据清洗工具,可快速处理缺失值与重复数据问题。这份精心挑选的清单展示了那些功能强大、能带来颠覆性变革的解决方案,可显著提升工作效率。所有候选工具都经过了严格的实际应用测试,以确保其稳定性。您可以获取免费版与付费版的对比信息,找出最符合您需求的必备工具。即刻访问XIX.AI,开启您的AI优势之旅。
11 个工具
xix.ai

 评论 (0)
0/500
人工智能研究人员和实验室在评估人工智能模型的安全性、合规性、阿谀奉承倾向以及对齐性方面取得了重大进展。然而,企业和开发者现在面临着一个具体的挑战:确保其人工智能系统能够完全按照其特定产品或服务的预期进行运作。
为了简化这一测试流程,微软于本周二发布了ASSERT——该名称是“自适应规范驱动评分评估与回归测试”(Adaptive Spec-driven Scoring for Evaluation and Regression Testing)的首字母缩写。
据微软介绍,这一开源框架可轻松评估特定应用场景下的AI行为。它利用AI技术,将关于目标、政策或预期行为的高层级自然语言描述,转换为可供审查的、经过评分且内容全面的测试。
ASSERT 接受对 AI 模型预期行为和策略的自然语言描述,随后将其转换为一组结构化的可接受与不可接受行为。它会生成问题场景和测试用例,在目标系统上运行这些用例,并对结果进行评分。 该框架还会记录 AI 系统的执行路径,包括中间操作和工具调用,从而让开发人员能够查明故障发生的位置。
开发人员还可以提供系统上下文、工具和约束条件,以进一步自定义评估的范围。
例如,开发人员可以指定:文档检索AI代理不应向公司外部人员发送电子邮件,必须将机密信息仅限于C级高管,并在考虑先前上下文的同时提供简明摘要。随后,ASSERT将利用这些规则生成测试用例,持续检查系统是否遵循这些规则。
图片来源:微软
据微软称,当AI模型的行为受应用程序或产品上下文、政策及工具的影响时,该框架填补了更广泛、更通用评估方法无法解决的空白。
“我们学到的一点是,评估对于做出正确决策至关重要,”微软负责任人工智能首席产品官莎拉·伯德(Sarah Bird)表示。 “因为如果不了解 AI 系统的行为,就很难判断它是否达到了贵组织的标准[…] 我们发现,如果真的想要一个值得信赖的系统,就应该评估更多与具体应用相关的维度。”
伯德表示,ASSERT 既可用于开发阶段的系统评估,也可用于部署后的评估以及持续监控。
此次发布正值人工智能行业发生渐进但广泛的转变之际。随着模型能力的不断提升,研究人员正将重点放在可重复的测试和回归检查上。斯坦福大学的HELM、MLCommons的AILuminate以及METR等评估组织正在推出基准测试,以衡量模型在不同条件下的表现。








 微软淘汰失败的 AI 工具并整合 Copilot 应用
两年前,微软将人工智能定义为一种“代际性”的技术变革,并表示其旨在引领这一趋势。如今,该公司正在整合其以 Copilot 为品牌的消费者和企业应用,同时停止运行不佳的几项人工智能功能。正如 GeekWire 首次报道并在微软的支持文档中详细说明的那样,这家科技巨头将把其面向消费者的 Copilot 应用的功能与专注于企业的 Microsoft 365 Copilot 应用的功能合并。此举承认个人和企业人工智能使用往往存在重叠,且微软之前的策略过于复杂,导致 Copilot 无法成为 Chat
 据称微软培训销售人员以压低竞争对手 OpenAI 和 Anthropic 的价格
微软据报正在加强其销售团队,以加大对人工智能领域主要竞争对手的竞争力度。据彭博社报道,高管们于周二举行了一次内部战略会议,指示销售团队突出微软的人工智能产品相较于 OpenAI、Google 和 Anthropic 产品的优势。此次会议聚焦于 27 财年的规划,强调在推销微软专有模型时,应着重阐述其相较于竞争对手解决方案在效率和成本方面的优势。“其他公司都在销售零部件——而我们销售的是完整的端到端系统。这就是我们在 27 财年需要向外界传达的故事,”据报道,执行副总裁 Jay Parikh
 这是否会成为代币经济危机的起点?
微软近期对 GitHub Copilot 的定价进行了大幅调整,变动幅度之大甚至有 Reddit 用户将企业内部出现的状况称为“代币末日”。在 TechCrunch 的《Equity》播客最新一集中,Kirsten Korosec、Sean O’Kane 与我一同探讨了这些价格变动可能对整个 AI 行业产生的影响。随着 Anthropic 及其他大型 AI 公司准备上市,关于盈利能力的疑问日益增多,企业为控制开支,很可能会再次提高价格并增设使用限制。Sean 提出了一个关键问题:“这些 AI

2026 年最新最佳顶级评分 AI 旋律创作工具,助力歌曲草稿创作!XIX.AI 精心策划了一套极具影响力且经过严格真实世界测试的变革性合集,旨在提供最佳的创作体验。您可以找到详细的免费与付费版对比、精准的排名以及必试选项,这些工具旨在帮助您轻松创作出令人惊艳的歌曲草稿,并显著提升您的创意生产力。立即探索,发现您的完美工具!
8 个工具
xix.ai

2026年最新、最受好评的AI面试模拟训练工具现已登陆XIX.AI!这份精心精选的合集收录了功能强大、具有革命性意义的工具,它们均经过严格的实际测试,能够提供精准的反馈。 您将看到免费版与付费版的对比分析以及详细排名,助您挑选出必试之选,从而提升自信并精进技能。立即探索,发现助您面试成功的完美工具!
12 个工具
xix.ai

2026年最新最佳、评价最高的AI风格转换工具,助您开展创意实验!XIX.AI精心甄选了一系列功能强大、颠覆性的必试工具,这些工具经过实际测试和严格排名,可带来卓越的效果。这些顶级解决方案通过加速内容创作并释放无限创意潜能,帮助创作者显著提升工作效率。 立即探索,找到最适合您的工具,今天就开始创作吧!
9 个工具
xix.ai

2026年最新、最受欢迎的视觉叙事AI对话气泡工具现已登陆XIX.AI!这份精心精选的合集汇集了功能强大、具有颠覆性的工具,可帮助创作者提升工作效率并突破创作瓶颈。 获取免费版与付费版的对比分析,查看实际测试结果,并查阅最新排行榜,找到最适合打造引人入胜的视觉叙事的必试解决方案。立即探索,发现您的理想工具!
10 个工具
xix.ai

2026年最新高评分最佳AI会议摘要工具,助您清晰追踪决策并轻松跟进。这份精心筛选的清单展示了功能强大、具有颠覆性的解决方案,它们通过自动化会议记录、识别关键行动项以及简化所有项目中的团队协调,显著提升工作效率。 获取免费版与付费版的对比分析,以及实际测试报告和每周更新的排行榜,助您找到最适合的工具。立即探索,释放您的AI优势!
9 个工具
xix.ai

2026年最新、最优秀且评分最高的AI数据清洗工具,可快速处理缺失值与重复数据问题。这份精心挑选的清单展示了那些功能强大、能带来颠覆性变革的解决方案,可显著提升工作效率。所有候选工具都经过了严格的实际应用测试,以确保其稳定性。您可以获取免费版与付费版的对比信息,找出最符合您需求的必备工具。即刻访问XIX.AI,开启您的AI优势之旅。
11 个工具
xix.ai












