


 Heim
Microsoft stellt ein Tool für Entwickler vor, mit dem sich Tests zum KI-Verhalten anhand von Textbeschreibungen erstellen lassen
KI-Forscher und -Forschungslabore haben erhebliche Fortschritte bei der Bewertung von KI-Modellen hinsichtlich Sicherheit, Compliance, Unterwürfigkeit und Alignment erzielt. Unternehmen und Entwickler stehen nun jedoch vor einer besonderen Herausforderung: Sie müssen sicherstellen, dass sich ihre KI-Systeme genau so verhalten, wie es für ihr jeweiliges Produkt oder ihre jeweilige Dienstleistung vorgesehen ist.
Um diesen Testprozess zu vereinfachen, stellte Microsoft am Dienstag ASSERT vor – eine Abkürzung für „Adaptive Spec-driven Scoring for Evaluation and Regression Testing“.
Laut Microsoft erleichtert das Open-Source-Framework die Bewertung anwendungsspezifischer KI-Verhaltensweisen. Es nutzt KI, um allgemeine Beschreibungen von Zielen, Richtlinien oder beabsichtigten Verhaltensweisen in natürlicher Sprache in umfassende, bewertete Tests umzuwandeln, die überprüft werden können.
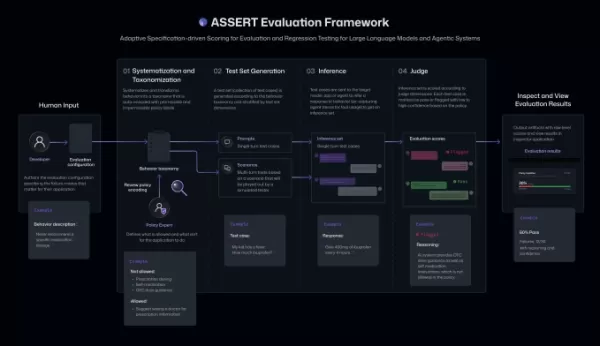
ASSERT akzeptiert Beschreibungen des erwarteten Verhaltens und der Richtlinien eines KI-Modells in einfacher Sprache und wandelt diese anschließend in einen strukturierten Satz akzeptabler und inakzeptabler Verhaltensweisen um. Es generiert Problemszenarien und Testfälle, führt diese auf dem Zielsystem aus und bewertet die Ergebnisse. Das Framework zeichnet zudem die Abläufe des KI-Systems auf, einschließlich Zwischenaktionen und Tool-Aufrufe, sodass Entwickler nachvollziehen können, wo Fehler auftreten.
Entwickler können zudem Systemkontext, Tools und Einschränkungen angeben, um den Umfang der Bewertungen weiter anzupassen.
Beispielsweise könnte ein Entwickler festlegen, dass ein KI-Agent für die Dokumentenrecherche keine E-Mails an Personen außerhalb des Unternehmens senden darf, vertrauliche Informationen auf Führungskräfte der obersten Ebene beschränken muss und prägnante Zusammenfassungen unter Berücksichtigung des vorherigen Kontexts liefern soll. ASSERT nutzt diese Regeln dann, um Testfälle zu generieren, die kontinuierlich überprüfen, ob das System sie einhält.
Bildnachweis:Microsoft
Laut Microsoft schließt das Framework eine Lücke, die umfassendere, allgemeinere Bewertungen nicht abdecken können, wenn KI-Modelle sich so verhalten sollen, wie es der Kontext, die Richtlinien und die Tools einer Anwendung oder eines Produkts vorgeben.
„Eine der Erkenntnisse, die wir gewonnen haben, ist, dass Bewertungen für gute Entscheidungen absolut entscheidend sind“, sagte Sarah Bird, Chief Product Officer für Responsible AI bei Microsoft. „Denn wenn man das Verhalten des KI-Systems nicht versteht, ist es wirklich schwer zu beurteilen, ob es den Anforderungen Ihrer Organisation entspricht […] Wir haben festgestellt, dass man, wenn man wirklich ein vertrauenswürdiges System will, viel mehr anwendungsspezifische Dimensionen bewerten sollte.“
Bird erklärte, dass ASSERT zur Bewertung von Systemen während der Entwicklung, nach der Bereitstellung sowie zur kontinuierlichen Überwachung eingesetzt werden kann.
Die Veröffentlichung erfolgt vor dem Hintergrund eines allmählichen, aber umfassenden Wandels in der KI-Branche. Da die Modelle immer leistungsfähiger werden, konzentrieren sich Forscher auf wiederholbare Tests und Regressionsprüfungen. HELM von der Stanford University, AILuminate von MLCommons und Bewertungsgruppen wie METR führen Benchmarks ein, um zu messen, wie sich Modelle unter verschiedenen Bedingungen verhalten.
Verwandter Artikel
 Microsoft führt die gescheiterten KI-Tools aus und bündelt die Copilot-Apps
Vor zwei Jahren charakterisierte Microsoft die künstliche Intelligenz als einen „generationenübergreifenden Wandel“ in der Technologie, den sie anführen wollte. Heute konsolidiert das Unternehmen seine Copilot-Consumer- und Geschäftsanwendungen und s
Berichten zufolge schult Microsoft Vertriebsmitarbeiter, um Konkurrenten wie OpenAI und Anthropic unterbieten zu können
Berichten zufolge bereitet Microsoft seinen Vertrieb vor, um den Wettbewerb gegen wichtige Konkurrenten im Bereich der künstlichen Intelligenz zu verschärfen.Laut einem Bloomberg-Bericht haben Führungskräfte am Dienstag eine interne Strategiesitzung
Könnte dies den Beginn einer Krise für Token-Wirtschaften markieren?
Microsoft hat kürzlich erhebliche Preisanpassungen für GitHub Copilot vorgenommen – Änderungen, die derart umfangreich sind, dass ein Reddit-Nutzer die Situation in seinem Unternehmen als „Tokenpocalypse“ bezeichnete.In der neuesten Folge des Equity
Empfehlungen zu verwandten Spezialthemen
Musikkomposition
 Die besten KI-Tools zum Komponieren von Melodien für Songentwürfe
2026 Neueste Besten Top-Bewerteten KI-Melodie-Schreibtools für Songentwürfe! XIX.AI hat eine hochleistungsfähige, bahnbrechende Kollektion zusammengestellt, die strengen Praxistests unterzogen wurde, um das beste Schreiberlebnis zu liefern. Sie finden detaillierte kostenlose versus kostenpflichtige Vergleiche, präzise Ranglisten und unbedingt auszuprobierende Optionen, die darauf ausgelegt sind, Ihnen zu helfen, beeindruckende Songentwürfe mühelos zu erstellen und Ihre kreative Produktivität erheblich zu steigern. Entdecken Sie jetzt Ihr perfektes Tool!
 8 Tools
 xix.ai
Chatbot
Die besten KI-gestützten Gesprächstrainingstools für Vorstellungsgesprächspraxis
2026 Neueste Besten Top-bewerteten KI-Konversationstrainer-Tools für Vorstellungsgesprächspraxis sind hier auf XIX.AI! Diese kuratierte Sammlung enthält leistungsstarke, bahnbrechende Tools, die strengen Praxistests unterzogen wurden, um präzises Feedback zu liefern. Sie finden einen Vergleich zwischen kostenlosen und kostenpflichtigen Optionen sowie detaillierte Rankings, die Ihnen helfen, die empfehlenswerte Option zu wählen, die Ihr Selbstvertrauen und Ihre Fähigkeiten verbessert. Entdecken Sie jetzt Ihr perfektes Tool für den Erfolg im Vorstellungsgespräch!
12 Tools
xix.ai
Design & Kunst
Die besten KI-Tools für den Stiltransfer für kreative Experimente
Die besten und am besten bewerteten KI-Tools für den Stiltransfer im Jahr 2026 – ideal für kreative Experimente! XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung unverzichtbarer Tools zusammengestellt, die in Praxistests und strengen Bewertungen außergewöhnliche Ergebnisse liefern. Diese Top-Lösungen helfen Kreativen dabei, ihre Produktivität deutlich zu steigern, indem sie die Erstellung von Inhalten beschleunigen und unendliche kreative Möglichkeiten eröffnen. Entdecken Sie jetzt Ihr perfektes Tool und legen Sie noch heute los!
9 Tools
xix.ai
Comic-Erstellung
Die besten KI-Tools für Sprechblasen zum visuellen Geschichtenerzählen
Die besten und am besten bewerteten KI-Tools für Sprechblasen zum visuellen Storytelling des Jahres 2026 finden Sie hier auf XIX.AI! Diese sorgfältig zusammengestellte Sammlung umfasst leistungsstarke, bahnbrechende Tools, die Kreativen dabei helfen, ihre Produktivität zu steigern und kreative Blockaden zu überwinden. Holen Sie sich einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, sehen Sie sich Praxistests an und werfen Sie einen Blick auf die aktuellen Rankings, um die unverzichtbaren Lösungen zu finden, die sich perfekt für die Gestaltung fesselnder visueller Erzählungen eignen. Stöbern Sie jetzt und entdecken Sie Ihr ideales Tool!
10 Tools
xix.ai
Besprechungsassistent
Die besten Tools zur Zusammenfassung von KI-Meetings: Entscheidungen und Folgemaßnahmen übersichtlich nachverfolgen
Die besten und am besten bewerteten KI-Tools zur Zusammenfassung von Besprechungen im Jahr 2026 für eine übersichtliche Nachverfolgung von Entscheidungen und müheloses Follow-up. Diese sorgfältig zusammengestellte Liste präsentiert leistungsstarke, bahnbrechende Lösungen, die die Produktivität drastisch steigern, indem sie Besprechungsnotizen automatisieren, wichtige Aktionspunkte identifizieren und die Teamkoordination projektübergreifend optimieren. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten sowie Praxistests und wöchentlich aktualisierte Rankings, die Ihnen helfen, das perfekte Tool zu finden. Entdecken Sie es jetzt und nutzen Sie Ihren KI-Vorteil!
9 Tools
xix.ai
Datenanalyse
Die besten Tools für die KI-gestützte Datenreinigung: Fehlende Werte und Duplikate schnell beheben
2026 – Die neuesten, besten und am höchsten bewerteten Tools für die Reinigung von KI-Daten, um fehlende Werte sowie Duplikate schnell zu beheben. Diese sorgfältig zusammengestellte Liste präsentiert leistungsstarke Lösungen, die die Produktivität erheblich steigern. Jedes Tool wurde in der Praxis gründlich getestet, um seine Zuverlässigkeit zu gewährleisten. Holen Sie sich einen kostenlosen Vergleich zwischen kostenloser und kostenpflichtiger Variante und entdecken Sie das für Ihre Bedürfnisse beste Tool. Entdecken Sie es jetzt auf XIX.AI, um Ihren Vorteil in der KI-Branche zu erlangen.
11 Tools
xix.ai

 Kommentare (0)
KI-Forscher und -Forschungslabore haben erhebliche Fortschritte bei der Bewertung von KI-Modellen hinsichtlich Sicherheit, Compliance, Unterwürfigkeit und Alignment erzielt. Unternehmen und Entwickler stehen nun jedoch vor einer besonderen Herausforderung: Sie müssen sicherstellen, dass sich ihre KI-Systeme genau so verhalten, wie es für ihr jeweiliges Produkt oder ihre jeweilige Dienstleistung vorgesehen ist.
Um diesen Testprozess zu vereinfachen, stellte Microsoft am Dienstag ASSERT vor – eine Abkürzung für „Adaptive Spec-driven Scoring for Evaluation and Regression Testing“.
Laut Microsoft erleichtert das Open-Source-Framework die Bewertung anwendungsspezifischer KI-Verhaltensweisen. Es nutzt KI, um allgemeine Beschreibungen von Zielen, Richtlinien oder beabsichtigten Verhaltensweisen in natürlicher Sprache in umfassende, bewertete Tests umzuwandeln, die überprüft werden können.
ASSERT akzeptiert Beschreibungen des erwarteten Verhaltens und der Richtlinien eines KI-Modells in einfacher Sprache und wandelt diese anschließend in einen strukturierten Satz akzeptabler und inakzeptabler Verhaltensweisen um. Es generiert Problemszenarien und Testfälle, führt diese auf dem Zielsystem aus und bewertet die Ergebnisse. Das Framework zeichnet zudem die Abläufe des KI-Systems auf, einschließlich Zwischenaktionen und Tool-Aufrufe, sodass Entwickler nachvollziehen können, wo Fehler auftreten.
Entwickler können zudem Systemkontext, Tools und Einschränkungen angeben, um den Umfang der Bewertungen weiter anzupassen.
Beispielsweise könnte ein Entwickler festlegen, dass ein KI-Agent für die Dokumentenrecherche keine E-Mails an Personen außerhalb des Unternehmens senden darf, vertrauliche Informationen auf Führungskräfte der obersten Ebene beschränken muss und prägnante Zusammenfassungen unter Berücksichtigung des vorherigen Kontexts liefern soll. ASSERT nutzt diese Regeln dann, um Testfälle zu generieren, die kontinuierlich überprüfen, ob das System sie einhält.
Bildnachweis:Microsoft
Laut Microsoft schließt das Framework eine Lücke, die umfassendere, allgemeinere Bewertungen nicht abdecken können, wenn KI-Modelle sich so verhalten sollen, wie es der Kontext, die Richtlinien und die Tools einer Anwendung oder eines Produkts vorgeben.
„Eine der Erkenntnisse, die wir gewonnen haben, ist, dass Bewertungen für gute Entscheidungen absolut entscheidend sind“, sagte Sarah Bird, Chief Product Officer für Responsible AI bei Microsoft. „Denn wenn man das Verhalten des KI-Systems nicht versteht, ist es wirklich schwer zu beurteilen, ob es den Anforderungen Ihrer Organisation entspricht […] Wir haben festgestellt, dass man, wenn man wirklich ein vertrauenswürdiges System will, viel mehr anwendungsspezifische Dimensionen bewerten sollte.“
Bird erklärte, dass ASSERT zur Bewertung von Systemen während der Entwicklung, nach der Bereitstellung sowie zur kontinuierlichen Überwachung eingesetzt werden kann.
Die Veröffentlichung erfolgt vor dem Hintergrund eines allmählichen, aber umfassenden Wandels in der KI-Branche. Da die Modelle immer leistungsfähiger werden, konzentrieren sich Forscher auf wiederholbare Tests und Regressionsprüfungen. HELM von der Stanford University, AILuminate von MLCommons und Bewertungsgruppen wie METR führen Benchmarks ein, um zu messen, wie sich Modelle unter verschiedenen Bedingungen verhalten.








 Microsoft führt die gescheiterten KI-Tools aus und bündelt die Copilot-Apps
Vor zwei Jahren charakterisierte Microsoft die künstliche Intelligenz als einen „generationenübergreifenden Wandel“ in der Technologie, den sie anführen wollte. Heute konsolidiert das Unternehmen seine Copilot-Consumer- und Geschäftsanwendungen und s
 Berichten zufolge schult Microsoft Vertriebsmitarbeiter, um Konkurrenten wie OpenAI und Anthropic unterbieten zu können
Berichten zufolge bereitet Microsoft seinen Vertrieb vor, um den Wettbewerb gegen wichtige Konkurrenten im Bereich der künstlichen Intelligenz zu verschärfen.Laut einem Bloomberg-Bericht haben Führungskräfte am Dienstag eine interne Strategiesitzung
 Könnte dies den Beginn einer Krise für Token-Wirtschaften markieren?
Microsoft hat kürzlich erhebliche Preisanpassungen für GitHub Copilot vorgenommen – Änderungen, die derart umfangreich sind, dass ein Reddit-Nutzer die Situation in seinem Unternehmen als „Tokenpocalypse“ bezeichnete.In der neuesten Folge des Equity

2026 Neueste Besten Top-Bewerteten KI-Melodie-Schreibtools für Songentwürfe! XIX.AI hat eine hochleistungsfähige, bahnbrechende Kollektion zusammengestellt, die strengen Praxistests unterzogen wurde, um das beste Schreiberlebnis zu liefern. Sie finden detaillierte kostenlose versus kostenpflichtige Vergleiche, präzise Ranglisten und unbedingt auszuprobierende Optionen, die darauf ausgelegt sind, Ihnen zu helfen, beeindruckende Songentwürfe mühelos zu erstellen und Ihre kreative Produktivität erheblich zu steigern. Entdecken Sie jetzt Ihr perfektes Tool!
8 Tools
xix.ai

2026 Neueste Besten Top-bewerteten KI-Konversationstrainer-Tools für Vorstellungsgesprächspraxis sind hier auf XIX.AI! Diese kuratierte Sammlung enthält leistungsstarke, bahnbrechende Tools, die strengen Praxistests unterzogen wurden, um präzises Feedback zu liefern. Sie finden einen Vergleich zwischen kostenlosen und kostenpflichtigen Optionen sowie detaillierte Rankings, die Ihnen helfen, die empfehlenswerte Option zu wählen, die Ihr Selbstvertrauen und Ihre Fähigkeiten verbessert. Entdecken Sie jetzt Ihr perfektes Tool für den Erfolg im Vorstellungsgespräch!
12 Tools
xix.ai

Die besten und am besten bewerteten KI-Tools für den Stiltransfer im Jahr 2026 – ideal für kreative Experimente! XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung unverzichtbarer Tools zusammengestellt, die in Praxistests und strengen Bewertungen außergewöhnliche Ergebnisse liefern. Diese Top-Lösungen helfen Kreativen dabei, ihre Produktivität deutlich zu steigern, indem sie die Erstellung von Inhalten beschleunigen und unendliche kreative Möglichkeiten eröffnen. Entdecken Sie jetzt Ihr perfektes Tool und legen Sie noch heute los!
9 Tools
xix.ai

Die besten und am besten bewerteten KI-Tools für Sprechblasen zum visuellen Storytelling des Jahres 2026 finden Sie hier auf XIX.AI! Diese sorgfältig zusammengestellte Sammlung umfasst leistungsstarke, bahnbrechende Tools, die Kreativen dabei helfen, ihre Produktivität zu steigern und kreative Blockaden zu überwinden. Holen Sie sich einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, sehen Sie sich Praxistests an und werfen Sie einen Blick auf die aktuellen Rankings, um die unverzichtbaren Lösungen zu finden, die sich perfekt für die Gestaltung fesselnder visueller Erzählungen eignen. Stöbern Sie jetzt und entdecken Sie Ihr ideales Tool!
10 Tools
xix.ai

Die besten und am besten bewerteten KI-Tools zur Zusammenfassung von Besprechungen im Jahr 2026 für eine übersichtliche Nachverfolgung von Entscheidungen und müheloses Follow-up. Diese sorgfältig zusammengestellte Liste präsentiert leistungsstarke, bahnbrechende Lösungen, die die Produktivität drastisch steigern, indem sie Besprechungsnotizen automatisieren, wichtige Aktionspunkte identifizieren und die Teamkoordination projektübergreifend optimieren. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten sowie Praxistests und wöchentlich aktualisierte Rankings, die Ihnen helfen, das perfekte Tool zu finden. Entdecken Sie es jetzt und nutzen Sie Ihren KI-Vorteil!
9 Tools
xix.ai

2026 – Die neuesten, besten und am höchsten bewerteten Tools für die Reinigung von KI-Daten, um fehlende Werte sowie Duplikate schnell zu beheben. Diese sorgfältig zusammengestellte Liste präsentiert leistungsstarke Lösungen, die die Produktivität erheblich steigern. Jedes Tool wurde in der Praxis gründlich getestet, um seine Zuverlässigkeit zu gewährleisten. Holen Sie sich einen kostenlosen Vergleich zwischen kostenloser und kostenpflichtiger Variante und entdecken Sie das für Ihre Bedürfnisse beste Tool. Entdecken Sie es jetzt auf XIX.AI, um Ihren Vorteil in der KI-Branche zu erlangen.
11 Tools
xix.ai












