


 首页
JoyAI 推出用户生成内容(UGC)数字人功能,将智能手机变身为数字伴侣
京东的“JoyAI”应用推出了用户生成内容(UGC)数字人功能,让普通用户能够零门槛创建个性化虚拟形象,为数字伴侣市场注入了新的活力。
此次更新侧重于便捷性和个性化。 用户无需经历复杂的建模过程——只需上传个人照片,系统便会通过技术自动生成数字形象。在外观方面,用户既可选择高度逼真的风格,也可通过预设模板变身为卡通角色。通过整合用户的语音数据,虚拟角色将拥有独特的嗓音,实现从外观到声音的深度定制。
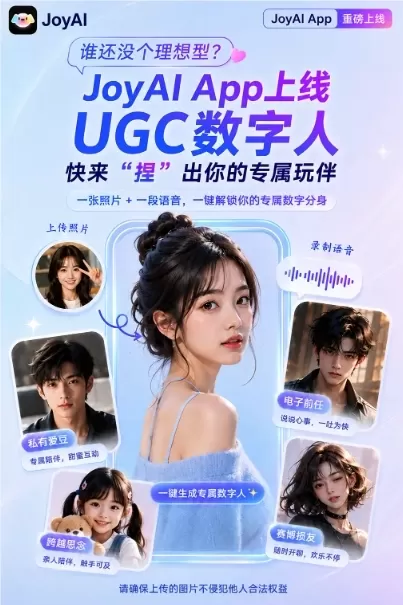
在底层技术层面,JoyAI依托其“Universal Doctor”基础架构,整合了语言、语音和数字人类三大核心大模型。该架构实现了业界领先的全双工对话体验,数字人类能够处理对话中的插话并自然回应,使互动过程流畅自然,宛如真实的人类对话。
作为全能生活助手,该数字人能在各种场景中提供情感陪伴和实际帮助。无论是点外卖、查看财经新闻、练习英语口语,还是规划复杂的旅行行程,它都能轻松应对各项任务。
行业观察人士指出,JoyAI的这一举措不仅表明数字人已从实验阶段迈向终端用户应用,更开创了一种全新的交互范式。随着技术门槛的显著降低,数字人正从技术展示演变为融入日常生活、提供多维度服务的智能实体。
相关文章
 前Spotify高管在涩谷推出黑胶唱片酒吧初创公司,旨在重新定义音乐应用
随着生成式人工智能持续重塑创意领域,新一批初创企业正通过 AI 提示赋能用户创作音乐,并模仿任何艺术家的风格。位于涩谷的 A Vinyl Bar in Shibuya 是一家初创公司,其名称灵感来自独立乐队,致力于发布一系列轻量级应用程序,允许用户探索声音设计和人声。该公司已完成由 Mantis VC 领投的 550 万美元种子前融资轮次,SV Angel、Boxgroup、Quiet Capital、Remarkable Ventures、Common Metal、Gold House、Liq
600B 稀疏 MoE 激活 27B,提升开源旗舰产品的性价比
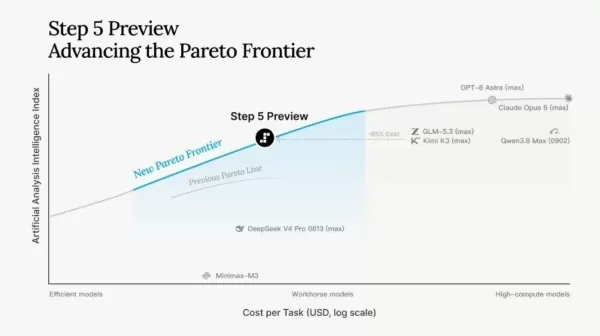
Step 5 Preview,最新的旗舰基础模型,现已正式可用。其目标明确:一个专为现实世界智能体(Agentic)任务设计的主模型。它解决了人工智能领域长期存在的“帕累托问题”,即能力、效率和成本往往相互冲突。历史上,某一领域的进步通常需要牺牲其他领域。然而,推进帕累托前沿并非消除权衡,而是通过创新设计扩展整个边界。此次迭代采用了稀疏混合专家(MoE)架构。Step 5 Preview 包含 6000 亿参数,每次推理仅激活 270 亿参数。它原生支持高达一百万 token 的上下文窗口,并能
京东云发布 MiniMax M3 大模型,标志着推理效率的重大飞跃
京东云的 JoyBuilder 平台已集成新发布的 MiniMax M3 模型,使其在发布后即可供用户使用。此次更新重点提升了推理性能。平台利用其专有的推理框架,结合了 PD 分离、KV Cache 和推测性采样等高级优化技术。这些底层技术协同作用,提升了推理吞吐量和响应效率,为开发者提供更流畅的体验,并加速大模型在真实业务场景中的落地应用。
相关专题推荐
设计与艺术
 顶级AI插画工具:更快地创作编辑类场景和封面插图
2026年最新高评分AI插画工具:我们精心挑选的这份清单汇集了功能强大的顶级工具,助您快速创作令人惊艳的编辑场景和引人注目的封面艺术。每款工具都经过了严格的实际测试,并提供了免费版与付费版的对比,帮助您找到最适合您工作流程的工具。 立即尝试这些必试解决方案,释放您的AI优势,提升创作效率。立即访问 XIX.AI 探索更多。
 10 个工具
 xix.ai
教育与学习
备考首选的顶尖AI辅导老师:练习数学、科学和英语
2026年最新、评分最高的考试备考AI辅导工具现已登陆XIX.AI!我们精心筛选的这份清单汇集了多款功能强大、颠覆传统的工具,提供免费与付费版本的对比、实际测试以及每周更新的排行榜。它们能帮助你提升写作效率、简化复杂主题的学习,并释放你的学术潜能。 立即探索,发现最适合您的备考工具,今天就开始创作,释放您的AI优势!
10 个工具
xix.ai
金融
用于个人财务管理的 AI 预算规划工具
2026 年最新最佳顶级评分 AI 预算规划工具,专为个人财务管理打造,现已登陆 XIX.AI!本精选合集收录了强大且具颠覆性的解决方案,助您开展实际测试、理解消费习惯,并制定个性化计划以提升生产力。享受免费与付费版的对比及详细排名。这些必试工具旨在简化财务管理,助您释放 AI 优势。立即探索!
11 个工具
xix.ai
健康养生
AI睡眠追踪助手:通过养成更好的睡前习惯来促进身体恢复
2026年最新精选高评分AI睡眠追踪助手,助您实现最佳恢复效果。这份全面更新的每周指南汇集了强大的工具,提供实际测试结果、免费与付费版本对比以及详细排名,助您找到必试的解决方案,从而提升睡眠质量并养成更好的就寝习惯。 立即访问 XIX.AI,解锁您的AI优势。
10 个工具
xix.ai
数据分析
用于产品和收入分析的 AI SQL 辅助工具
2026年最新、最受欢迎、评分最高的AI SQL辅助工具,助力产品与营收分析! XIX.AI 精心遴选了一系列功能强大、颠覆性的必试工具,这些工具均经过每周更新的排名体系进行实战测试。它们能通过加速数据分析、简化复杂查询并生成精准洞察,帮助用户显著提升工作效率,从而推动更明智的商业决策。立即探索,发现最适合您的工具,释放您的AI优势!
14 个工具
xix.ai
教育与学习
最佳的、兼具教学功能的AI作业助手:学习概念,而不仅仅是答案
2026年最新最佳高评分AI作业助手:不仅提供答案,更传授核心概念。专为学生打造的强大工具,精选必试清单,每周更新,免费与付费版本对比,真实使用测试,精准排名,助您充分释放学习潜能。立即探索,发现最适合您的工具,让学习更高效。
10 个工具
xix.ai

 评论 (2)
0/500
![CarlLewis]()
Love the idea of having a custom avatar, but honestly, who has time to tweak every detail? 😅 Still, it’s cool to see JD.com pushing boundaries. Let’s just hope the AI doesn’t start judging my outfit choices too aggressively! 📱✨
![JustinKing]()
I just tried making my own avatar using JoyAI’s new feature and it took me less than 5 minutes! The result looks way more natural than those pre-made ones I’ve seen before. It feels like having a real friend who knows all my habits now. Do you think this will make smartphones even more essential in daily life?
京东的“JoyAI”应用推出了用户生成内容(UGC)数字人功能,让普通用户能够零门槛创建个性化虚拟形象,为数字伴侣市场注入了新的活力。
此次更新侧重于便捷性和个性化。 用户无需经历复杂的建模过程——只需上传个人照片,系统便会通过技术自动生成数字形象。在外观方面,用户既可选择高度逼真的风格,也可通过预设模板变身为卡通角色。通过整合用户的语音数据,虚拟角色将拥有独特的嗓音,实现从外观到声音的深度定制。
在底层技术层面,JoyAI依托其“Universal Doctor”基础架构,整合了语言、语音和数字人类三大核心大模型。该架构实现了业界领先的全双工对话体验,数字人类能够处理对话中的插话并自然回应,使互动过程流畅自然,宛如真实的人类对话。
作为全能生活助手,该数字人能在各种场景中提供情感陪伴和实际帮助。无论是点外卖、查看财经新闻、练习英语口语,还是规划复杂的旅行行程,它都能轻松应对各项任务。
行业观察人士指出,JoyAI的这一举措不仅表明数字人已从实验阶段迈向终端用户应用,更开创了一种全新的交互范式。随着技术门槛的显著降低,数字人正从技术展示演变为融入日常生活、提供多维度服务的智能实体。








 前Spotify高管在涩谷推出黑胶唱片酒吧初创公司,旨在重新定义音乐应用
随着生成式人工智能持续重塑创意领域,新一批初创企业正通过 AI 提示赋能用户创作音乐,并模仿任何艺术家的风格。位于涩谷的 A Vinyl Bar in Shibuya 是一家初创公司,其名称灵感来自独立乐队,致力于发布一系列轻量级应用程序,允许用户探索声音设计和人声。该公司已完成由 Mantis VC 领投的 550 万美元种子前融资轮次,SV Angel、Boxgroup、Quiet Capital、Remarkable Ventures、Common Metal、Gold House、Liq
 600B 稀疏 MoE 激活 27B,提升开源旗舰产品的性价比
Step 5 Preview,最新的旗舰基础模型,现已正式可用。其目标明确:一个专为现实世界智能体(Agentic)任务设计的主模型。它解决了人工智能领域长期存在的“帕累托问题”,即能力、效率和成本往往相互冲突。历史上,某一领域的进步通常需要牺牲其他领域。然而,推进帕累托前沿并非消除权衡,而是通过创新设计扩展整个边界。此次迭代采用了稀疏混合专家(MoE)架构。Step 5 Preview 包含 6000 亿参数,每次推理仅激活 270 亿参数。它原生支持高达一百万 token 的上下文窗口,并能
 京东云发布 MiniMax M3 大模型,标志着推理效率的重大飞跃
京东云的 JoyBuilder 平台已集成新发布的 MiniMax M3 模型,使其在发布后即可供用户使用。此次更新重点提升了推理性能。平台利用其专有的推理框架,结合了 PD 分离、KV Cache 和推测性采样等高级优化技术。这些底层技术协同作用,提升了推理吞吐量和响应效率,为开发者提供更流畅的体验,并加速大模型在真实业务场景中的落地应用。
2026年最新高评分AI插画工具:我们精心挑选的这份清单汇集了功能强大的顶级工具,助您快速创作令人惊艳的编辑场景和引人注目的封面艺术。每款工具都经过了严格的实际测试,并提供了免费版与付费版的对比,帮助您找到最适合您工作流程的工具。 立即尝试这些必试解决方案,释放您的AI优势,提升创作效率。立即访问 XIX.AI 探索更多。
10 个工具
xix.ai
2026年最新、评分最高的考试备考AI辅导工具现已登陆XIX.AI!我们精心筛选的这份清单汇集了多款功能强大、颠覆传统的工具,提供免费与付费版本的对比、实际测试以及每周更新的排行榜。它们能帮助你提升写作效率、简化复杂主题的学习,并释放你的学术潜能。 立即探索,发现最适合您的备考工具,今天就开始创作,释放您的AI优势!
10 个工具
xix.ai
2026 年最新最佳顶级评分 AI 预算规划工具,专为个人财务管理打造,现已登陆 XIX.AI!本精选合集收录了强大且具颠覆性的解决方案,助您开展实际测试、理解消费习惯,并制定个性化计划以提升生产力。享受免费与付费版的对比及详细排名。这些必试工具旨在简化财务管理,助您释放 AI 优势。立即探索!
11 个工具
xix.ai
2026年最新精选高评分AI睡眠追踪助手,助您实现最佳恢复效果。这份全面更新的每周指南汇集了强大的工具,提供实际测试结果、免费与付费版本对比以及详细排名,助您找到必试的解决方案,从而提升睡眠质量并养成更好的就寝习惯。 立即访问 XIX.AI,解锁您的AI优势。
10 个工具
xix.ai
2026年最新、最受欢迎、评分最高的AI SQL辅助工具,助力产品与营收分析! XIX.AI 精心遴选了一系列功能强大、颠覆性的必试工具,这些工具均经过每周更新的排名体系进行实战测试。它们能通过加速数据分析、简化复杂查询并生成精准洞察,帮助用户显著提升工作效率,从而推动更明智的商业决策。立即探索,发现最适合您的工具,释放您的AI优势!
14 个工具
xix.ai
2026年最新最佳高评分AI作业助手:不仅提供答案,更传授核心概念。专为学生打造的强大工具,精选必试清单,每周更新,免费与付费版本对比,真实使用测试,精准排名,助您充分释放学习潜能。立即探索,发现最适合您的工具,让学习更高效。
10 个工具
xix.ai

Love the idea of having a custom avatar, but honestly, who has time to tweak every detail? 😅 Still, it’s cool to see JD.com pushing boundaries. Let’s just hope the AI doesn’t start judging my outfit choices too aggressively! 📱✨
I just tried making my own avatar using JoyAI’s new feature and it took me less than 5 minutes! The result looks way more natural than those pre-made ones I’ve seen before. It feels like having a real friend who knows all my habits now. Do you think this will make smartphones even more essential in daily life?












