


 首页
Google的Gemma 3仅使用一个GPU实现了DeepSeek准确性的98%
人工智能经济学近期备受关注,尤其是初创公司DeepSeek AI展示的GPU芯片规模经济令人印象深刻。但Google不甘示弱。周三,这家科技巨头发布了最新的开源大型语言模型Gemma 3,其准确性几乎与DeepSeek的R1模型相当,但计算资源消耗显著减少。
Google使用“Elo”评分衡量性能,这是一种常用于国际象棋和体育的排名系统。Gemma 3得分1338,略低于R1的1363,意味着R1技术上优于Gemma 3。然而,Google估计达到R1的得分需要32个Nvidia H100 GPU芯片,而Gemma 3仅用一个H100 GPU即可实现。Google称这种计算与Elo评分的平衡为“最佳点”。
在博客文章中,Google描述Gemma 3为“可在单一GPU或TPU上运行的最强大模型”,指的是其定制AI芯片“张量处理单元”。公司宣称Gemma 3“在其规模下提供顶尖性能”,在LMArena排行榜的人类偏好评估中超越Llama-405B、DeepSeek-V3和o3-mini等模型。这种性能使其更容易在单一GPU或TPU主机上创建引人入胜的用户体验。
 Google
的模型在Elo评分上也超越了Meta的Llama 3,Google估计后者需16个GPU。值得注意的是,这些竞争模型的数据是Google的估计;DeepSeek AI仅透露R1使用了1814个性能较低的Nvidia H800 GPU。
更多详细信息可在HuggingFace的开发者博客文章中找到,Gemma 3仓库也已开放。Gemma 3专为设备端使用而非数据中心设计,参数数量远少于R1和其他开源模型。Gemma 3的参数从10亿到270亿不等,相比当前标准较为适中,而R1拥有高达6710亿参数,尽管可选择性使用370亿参数。
Gemma 3效率的关键在于广泛使用的AI技术——蒸馏,即将大模型的训练权重转移到较小的模型以提升其能力。此外,蒸馏模型经过三项质量控制措施:基于人类反馈的强化学习(RLHF)、基于机器反馈的强化学习(RLMF)和基于执行反馈的强化学习(RLEF)。这些措施优化模型输出,使其更实用,并提升数学和编码能力。
Google的开发者博客详细介绍了这些方法,另一篇文章讨论了针对最小10亿参数模型的优化技术,面向移动设备,包括量化、更新键值缓存布局、改进变量加载时间和GPU权重共享。
Google不仅基于Elo评分比较Gemma 3,还与前代Gemma 2及其闭源Gemini模型在LiveCodeBench等基准测试中进行对比。虽然Gemma 3在准确性上通常不及Gemini 1.5和Gemini 2.0,但Google指出,尽管参数较少,其“与闭源Gemini模型相比表现出色”。
 Google
Gemma 3相较Gemma 2的重大升级是其“上下文窗口”从8000个令牌扩展到128000个令牌,可处理整篇论文或书籍等大型文本。Gemma 3还支持多模态,可处理文本和图像输入,不同于前代。此外,它支持超过140种语言,远超Gemma 2的仅英语能力。
除主要功能外,Gemma 3还有其他有趣特点。大型语言模型可能记住训练数据部分内容,导致隐私泄露风险。Google的研究人员测试发现,Gemma 3对长文本的记忆率低于前代,表明隐私保护有所改进。
对细节感兴趣的用户可参阅Gemma 3技术论文,全面了解模型能力和开发过程。
相关文章
 Recursive Intelligence 如何在4个月内以40亿美元估值筹集3.35亿美元
初创公司Ricursive Intelligence的联合创始人似乎注定要成为联合创始人。首席执行官安娜·戈迪(Anna Goldie)和首席技术官阿扎莉亚·米尔霍塞伊尼(Azalia Mirhoseini)在人工智能界声名显赫,戈迪向TechCrunch笑称,她们正是那些“收到扎克伯格发来的奇怪邮件、里面提出疯狂邀约”的人工智能工程师之一。(她们最终没有接受这些邀约。) 两人曾共同在谷歌大脑(G
人工智能竞赛不会等待,TechCrunch Disrupt 的 25% 折扣也不会等待
目前每一位投身人工智能领域的创始人都在思考同一个问题:我们的发展速度够快吗?效率够高吗?TechCrunch Disrupt 2026 将让您与那些正在最高层面思考这一关乎存亡问题的行业领军人物共聚一堂。 10月13日至15日,在旧金山,来自OpenAI、英伟达(Nvidia)、Anthropic、微软等公司的领军人物将分享他们的见解,届时数千名初创企业社区成员将齐聚一堂,进行交流。限时优惠:结账
“钱文AI免费版”与机构版:揭穿高价写作骗局
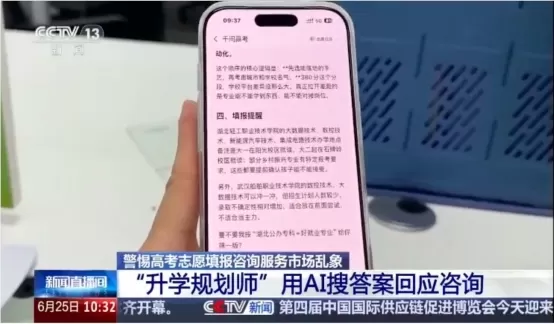
6月25日,中央电视台播出了关于混乱的高考志愿填报市场的一则调查报道,引发了广泛的公众讨论。 报道画面显示,许多高中升学中介机构打着“十年教龄教师”和“教授”等头衔的旗号,收取4,980至12,980元不等的天价费用。 实际上,这些所谓的“资深顾问”往往是入职不到两个月的新员工,甚至是兼职的大学生。他们的“专业方案”都是通过免费的Qwen AI生成的,有些机构甚至直接将Qwen生成的内容加价转卖给
相关专题推荐
设计与艺术
 顶级AI插画工具:更快地创作编辑类场景和封面插图
2026年最新高评分AI插画工具:我们精心挑选的这份清单汇集了功能强大的顶级工具,助您快速创作令人惊艳的编辑场景和引人注目的封面艺术。每款工具都经过了严格的实际测试,并提供了免费版与付费版的对比,帮助您找到最适合您工作流程的工具。 立即尝试这些必试解决方案,释放您的AI优势,提升创作效率。立即访问 XIX.AI 探索更多。
 10 个工具
 xix.ai
教育与学习
备考首选的顶尖AI辅导老师:练习数学、科学和英语
2026年最新、评分最高的考试备考AI辅导工具现已登陆XIX.AI!我们精心筛选的这份清单汇集了多款功能强大、颠覆传统的工具,提供免费与付费版本的对比、实际测试以及每周更新的排行榜。它们能帮助你提升写作效率、简化复杂主题的学习,并释放你的学术潜能。 立即探索,发现最适合您的备考工具,今天就开始创作,释放您的AI优势!
10 个工具
xix.ai
金融
用于个人财务管理的 AI 预算规划工具
2026 年最新最佳顶级评分 AI 预算规划工具,专为个人财务管理打造,现已登陆 XIX.AI!本精选合集收录了强大且具颠覆性的解决方案,助您开展实际测试、理解消费习惯,并制定个性化计划以提升生产力。享受免费与付费版的对比及详细排名。这些必试工具旨在简化财务管理,助您释放 AI 优势。立即探索!
11 个工具
xix.ai
健康养生
AI睡眠追踪助手:通过养成更好的睡前习惯来促进身体恢复
2026年最新精选高评分AI睡眠追踪助手,助您实现最佳恢复效果。这份全面更新的每周指南汇集了强大的工具,提供实际测试结果、免费与付费版本对比以及详细排名,助您找到必试的解决方案,从而提升睡眠质量并养成更好的就寝习惯。 立即访问 XIX.AI,解锁您的AI优势。
10 个工具
xix.ai
数据分析
用于产品和收入分析的 AI SQL 辅助工具
2026年最新、最受欢迎、评分最高的AI SQL辅助工具,助力产品与营收分析! XIX.AI 精心遴选了一系列功能强大、颠覆性的必试工具,这些工具均经过每周更新的排名体系进行实战测试。它们能通过加速数据分析、简化复杂查询并生成精准洞察,帮助用户显著提升工作效率,从而推动更明智的商业决策。立即探索,发现最适合您的工具,释放您的AI优势!
14 个工具
xix.ai
教育与学习
最佳的、兼具教学功能的AI作业助手:学习概念,而不仅仅是答案
2026年最新最佳高评分AI作业助手:不仅提供答案,更传授核心概念。专为学生打造的强大工具,精选必试清单,每周更新,免费与付费版本对比,真实使用测试,精准排名,助您充分释放学习潜能。立即探索,发现最适合您的工具,让学习更高效。
10 个工具
xix.ai

 评论 (12)
0/500
![StephenGreen]()
Googleも結構追いついてきたんだね…ただ、オープンソースなのは良いけど、本当に個人開発者が活用できる環境整ってるのかな?🤔 最近は色んなモデルが出てきて混乱しそうだわ。
![JonathanKing]()
¡Estas mejoras en eficiencia son una locura! 🔥 Si Google logra casi el mismo rendimiento con solo una GPU, ¿esto cambiará por completo el acceso a la IA para pequeños desarrolladores? Aun así, me pregunto cómo manejarán temas como el consumo energético real en uso masivo... 😅
![RonaldMartinez]()
Google's Gemma 3 sounds like a game-changer! 98% of DeepSeek's accuracy with just one GPU? That's some serious efficiency. Curious how this'll shake up the AI startup scene. 🚀
![GaryJones]()
Google's Gemma 3 sounds like a game-changer! 98% of DeepSeek's accuracy with just one GPU? That's some serious efficiency. Curious how this stacks up in real-world apps! 😎
![JonathanDavis]()
Google's Gemma 3 sounds like a game-changer! Achieving 98% of DeepSeek's accuracy with just one GPU is wild. Makes me wonder how this’ll shake up the AI race—more power to the little guys? 🤔
![ArthurSanchez]()
Google's Gemma 3 sounds like a game-changer! 98% of DeepSeek's accuracy with just one GPU? That's like getting a sports car for the price of a bike! 😎 Can't wait to see how this shakes up the AI race.
人工智能经济学近期备受关注,尤其是初创公司DeepSeek AI展示的GPU芯片规模经济令人印象深刻。但Google不甘示弱。周三,这家科技巨头发布了最新的开源大型语言模型Gemma 3,其准确性几乎与DeepSeek的R1模型相当,但计算资源消耗显著减少。
Google使用“Elo”评分衡量性能,这是一种常用于国际象棋和体育的排名系统。Gemma 3得分1338,略低于R1的1363,意味着R1技术上优于Gemma 3。然而,Google估计达到R1的得分需要32个Nvidia H100 GPU芯片,而Gemma 3仅用一个H100 GPU即可实现。Google称这种计算与Elo评分的平衡为“最佳点”。
在博客文章中,Google描述Gemma 3为“可在单一GPU或TPU上运行的最强大模型”,指的是其定制AI芯片“张量处理单元”。公司宣称Gemma 3“在其规模下提供顶尖性能”,在LMArena排行榜的人类偏好评估中超越Llama-405B、DeepSeek-V3和o3-mini等模型。这种性能使其更容易在单一GPU或TPU主机上创建引人入胜的用户体验。
Google的模型在Elo评分上也超越了Meta的Llama 3,Google估计后者需16个GPU。值得注意的是,这些竞争模型的数据是Google的估计;DeepSeek AI仅透露R1使用了1814个性能较低的Nvidia H800 GPU。
更多详细信息可在HuggingFace的开发者博客文章中找到,Gemma 3仓库也已开放。Gemma 3专为设备端使用而非数据中心设计,参数数量远少于R1和其他开源模型。Gemma 3的参数从10亿到270亿不等,相比当前标准较为适中,而R1拥有高达6710亿参数,尽管可选择性使用370亿参数。
Gemma 3效率的关键在于广泛使用的AI技术——蒸馏,即将大模型的训练权重转移到较小的模型以提升其能力。此外,蒸馏模型经过三项质量控制措施:基于人类反馈的强化学习(RLHF)、基于机器反馈的强化学习(RLMF)和基于执行反馈的强化学习(RLEF)。这些措施优化模型输出,使其更实用,并提升数学和编码能力。
Google的开发者博客详细介绍了这些方法,另一篇文章讨论了针对最小10亿参数模型的优化技术,面向移动设备,包括量化、更新键值缓存布局、改进变量加载时间和GPU权重共享。
Google不仅基于Elo评分比较Gemma 3,还与前代Gemma 2及其闭源Gemini模型在LiveCodeBench等基准测试中进行对比。虽然Gemma 3在准确性上通常不及Gemini 1.5和Gemini 2.0,但Google指出,尽管参数较少,其“与闭源Gemini模型相比表现出色”。
Gemma 3相较Gemma 2的重大升级是其“上下文窗口”从8000个令牌扩展到128000个令牌,可处理整篇论文或书籍等大型文本。Gemma 3还支持多模态,可处理文本和图像输入,不同于前代。此外,它支持超过140种语言,远超Gemma 2的仅英语能力。
除主要功能外,Gemma 3还有其他有趣特点。大型语言模型可能记住训练数据部分内容,导致隐私泄露风险。Google的研究人员测试发现,Gemma 3对长文本的记忆率低于前代,表明隐私保护有所改进。
对细节感兴趣的用户可参阅Gemma 3技术论文,全面了解模型能力和开发过程。








 Recursive Intelligence 如何在4个月内以40亿美元估值筹集3.35亿美元
初创公司Ricursive Intelligence的联合创始人似乎注定要成为联合创始人。首席执行官安娜·戈迪(Anna Goldie)和首席技术官阿扎莉亚·米尔霍塞伊尼(Azalia Mirhoseini)在人工智能界声名显赫,戈迪向TechCrunch笑称,她们正是那些“收到扎克伯格发来的奇怪邮件、里面提出疯狂邀约”的人工智能工程师之一。(她们最终没有接受这些邀约。) 两人曾共同在谷歌大脑(G
 人工智能竞赛不会等待,TechCrunch Disrupt 的 25% 折扣也不会等待
目前每一位投身人工智能领域的创始人都在思考同一个问题:我们的发展速度够快吗?效率够高吗?TechCrunch Disrupt 2026 将让您与那些正在最高层面思考这一关乎存亡问题的行业领军人物共聚一堂。 10月13日至15日,在旧金山,来自OpenAI、英伟达(Nvidia)、Anthropic、微软等公司的领军人物将分享他们的见解,届时数千名初创企业社区成员将齐聚一堂,进行交流。限时优惠:结账
 “钱文AI免费版”与机构版:揭穿高价写作骗局
6月25日,中央电视台播出了关于混乱的高考志愿填报市场的一则调查报道,引发了广泛的公众讨论。 报道画面显示,许多高中升学中介机构打着“十年教龄教师”和“教授”等头衔的旗号,收取4,980至12,980元不等的天价费用。 实际上,这些所谓的“资深顾问”往往是入职不到两个月的新员工,甚至是兼职的大学生。他们的“专业方案”都是通过免费的Qwen AI生成的,有些机构甚至直接将Qwen生成的内容加价转卖给

2026年最新高评分AI插画工具:我们精心挑选的这份清单汇集了功能强大的顶级工具,助您快速创作令人惊艳的编辑场景和引人注目的封面艺术。每款工具都经过了严格的实际测试,并提供了免费版与付费版的对比,帮助您找到最适合您工作流程的工具。 立即尝试这些必试解决方案,释放您的AI优势,提升创作效率。立即访问 XIX.AI 探索更多。
10 个工具
xix.ai

2026年最新、评分最高的考试备考AI辅导工具现已登陆XIX.AI!我们精心筛选的这份清单汇集了多款功能强大、颠覆传统的工具,提供免费与付费版本的对比、实际测试以及每周更新的排行榜。它们能帮助你提升写作效率、简化复杂主题的学习,并释放你的学术潜能。 立即探索,发现最适合您的备考工具,今天就开始创作,释放您的AI优势!
10 个工具
xix.ai

2026 年最新最佳顶级评分 AI 预算规划工具,专为个人财务管理打造,现已登陆 XIX.AI!本精选合集收录了强大且具颠覆性的解决方案,助您开展实际测试、理解消费习惯,并制定个性化计划以提升生产力。享受免费与付费版的对比及详细排名。这些必试工具旨在简化财务管理,助您释放 AI 优势。立即探索!
11 个工具
xix.ai

2026年最新精选高评分AI睡眠追踪助手,助您实现最佳恢复效果。这份全面更新的每周指南汇集了强大的工具,提供实际测试结果、免费与付费版本对比以及详细排名,助您找到必试的解决方案,从而提升睡眠质量并养成更好的就寝习惯。 立即访问 XIX.AI,解锁您的AI优势。
10 个工具
xix.ai

2026年最新、最受欢迎、评分最高的AI SQL辅助工具,助力产品与营收分析! XIX.AI 精心遴选了一系列功能强大、颠覆性的必试工具,这些工具均经过每周更新的排名体系进行实战测试。它们能通过加速数据分析、简化复杂查询并生成精准洞察,帮助用户显著提升工作效率,从而推动更明智的商业决策。立即探索,发现最适合您的工具,释放您的AI优势!
14 个工具
xix.ai

2026年最新最佳高评分AI作业助手:不仅提供答案,更传授核心概念。专为学生打造的强大工具,精选必试清单,每周更新,免费与付费版本对比,真实使用测试,精准排名,助您充分释放学习潜能。立即探索,发现最适合您的工具,让学习更高效。
10 个工具
xix.ai

Googleも結構追いついてきたんだね…ただ、オープンソースなのは良いけど、本当に個人開発者が活用できる環境整ってるのかな?🤔 最近は色んなモデルが出てきて混乱しそうだわ。
¡Estas mejoras en eficiencia son una locura! 🔥 Si Google logra casi el mismo rendimiento con solo una GPU, ¿esto cambiará por completo el acceso a la IA para pequeños desarrolladores? Aun así, me pregunto cómo manejarán temas como el consumo energético real en uso masivo... 😅
Google's Gemma 3 sounds like a game-changer! 98% of DeepSeek's accuracy with just one GPU? That's some serious efficiency. Curious how this'll shake up the AI startup scene. 🚀
Google's Gemma 3 sounds like a game-changer! 98% of DeepSeek's accuracy with just one GPU? That's some serious efficiency. Curious how this stacks up in real-world apps! 😎
Google's Gemma 3 sounds like a game-changer! Achieving 98% of DeepSeek's accuracy with just one GPU is wild. Makes me wonder how this’ll shake up the AI race—more power to the little guys? 🤔
Google's Gemma 3 sounds like a game-changer! 98% of DeepSeek's accuracy with just one GPU? That's like getting a sports car for the price of a bike! 😎 Can't wait to see how this shakes up the AI race.












