


 首页
Google 相册新增 AI 穿搭规划功能,支持自动分类、穿搭建议和虚拟试穿
4月29日,谷歌宣布在“谷歌相册”中推出一项基于生成式人工智能的“衣橱规划师”功能。该功能利用深度学习技术,自动识别、提取并分类用户照片库中的服装单品,从而构建一个数字化的个人衣橱。 继虚拟试穿技术之后,这标志着人工智能在时尚互动领域又一重要应用,旨在通过整理用户现有的照片资源,帮助用户更高效地决定穿搭方案。
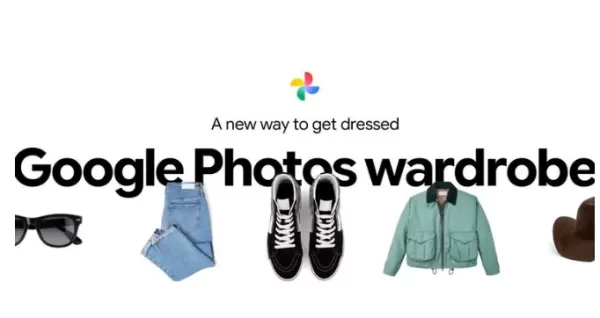
该AI文件夹的核心功能是自动按首饰、上衣和下装等类别筛选单品,帮助用户重新发现自己已拥有的服饰。用户可以混搭不同单品,打造虚拟穿搭,并将它们保存到针对特定场合(如婚礼、旅行或工作)的数字灵感板中。 重要的是,该功能集成了先进的虚拟试穿技术,用户只需点击“试穿”按钮,即可预览单品穿在自己身上的效果,从而完成从照片检索到穿搭预览的全流程体验。
据报道,该功能将于今年夏天首先在安卓平台上线,随后登陆iOS平台。 行业观察人士指出,谷歌此举已超越图像识别范畴,是生成式人工智能优化消费者体验的典范。通过将相册从单纯的存储工具转变为提供时尚购物指导和穿搭建议的智能助手,谷歌正借助人工智能巩固其在移动个人数据生态系统中的地位。
相关文章
 GPT-6 Astra 运行自动售货机长达一年,赚取 15,000 美元,表现比 Claude 高出近 3 倍
Andon Labs 的 Vending-Bench2 测试呈现出令人瞩目的表现:AI 以 500 美元起步,模拟运营了一整年的自动售货机。GPT-6Astra 的平均最终账户余额达到 15,515 美元,首次登顶——更令人惊讶的是,其最差一轮的表现也高于 Claude Fable5.1 的最佳一轮。两者的差异不仅在于盈利多少,更在于截然不同的商业策略。Astra 成功地将采购价格长期维持在低位,将产品售价压低至原价的约 48%;同时,其规则执行极为稳定,全程未出现预付款损失。相比之下,Fab
ElevenLabs 发布 Music v2,支持多版本生成并赋予完整商业使用权
5月28日,AI语音与音乐技术领域的先驱ElevenLabs正式推出了其最新的音乐生成模型Music v2。作为对十个月前发布的第一代模型的重大演进,Music v2在音乐编曲的复杂性、人声细节以及风格切换能力方面实现了显著提升。1. 核心突破:“模块化”创作工作流Music v2超越了基本的文本转音频转换,为艺术家提供了精细化的创作工作流:动态风格切换: 该模型支持在单首曲目中无缝切换音乐风格,例如从复杂的歌剧过渡到重金属音乐,同时保持节奏的一致性和结构的完整性。分段创作与编辑: 用户
Synthia 将焦点从视频转向 AI 交互,提供实时响应和表现评分
Synthesia 长期以来以利用人工智能在几分钟内制作互动式企业培训视频而闻名,为传统企业学习资源提供了更具成本效益的替代方案。如今,这家英国初创公司正在转变其关注点:企业人工智能的真正竞争优势可能不在于内容创作,而在于展示切实有效的成果。周三,Synthesia 推出了角色扮演会话(Roleplay Sessions),这是一种互动式培训工具,允许员工与人工智能虚拟人排练高风险对话,例如销售推介、绩效评估和客户服务互动。该虚拟人能够动态回应、挑战用户,并根据既定评分标准提供评分。据 Tec
相关专题推荐
提示词
 团队使用的AI提示词管理工具
2026 年最新最佳顶级评分 AI 提示词管理工具由 XIX.AI 精心策划,专为团队打造。本指南每周更新,收录了经实际测试和详细排名验证的、能显著提升团队生产力的强大变革性解决方案。获取免费与付费版的对比,助您选择最合适的工具。立即探索,解锁您的 AI 优势。
 9 个工具
 xix.ai
音乐创作
用于音乐创作的AI歌词创意工具
2026年最新、最受欢迎、评价最高的AI歌词创意工具现已登陆XIX.AI!这份精心精选的合集汇集了多款功能强大、颠覆性的工具,它们均经过实际测试,能够快速提供高质量的歌词创意,帮助用户激发创造力并优化音乐创作流程。 您还可以获取免费版与付费版的对比概览。立即探索,发现最适合您的工具!
16 个工具
xix.ai
漫画创作
用于漫画世界构建的AI角色设定表工具
2026 年最新最佳顶级评分 AI 角色表工具,助力漫画世界构建,现已登陆 XIX.AI!本精选列表收录了经过严格现实测试的强大且具颠覆性的选项。您将看到免费与付费版本的对比,以及每周更新的排行榜,助您发掘那些能激发创意并简化世界构建任务的必备工具。立即探索,解锁您的 AI 优势!
13 个工具
xix.ai
自动化
n8n 人工智能自动化工具,适用于内部运维、数据同步和多步骤代理流程
2026年最新最佳n8n AI自动化工具——适用于内部运营、数据同步和多步骤代理流程——现已发布!XIX.AI精心甄选了一系列广受好评、功能强大的颠覆性工具,可提升所有工作任务的生产力。 每款工具均经过严格的实际应用测试以确保可靠性,并附有详细的免费版与付费版对比分析及每周更新的排行榜。这些必试选项能助您发挥人工智能优势,轻松优化工作流程。立即探索,发现最适合您的工具!
11 个工具
xix.ai
提示词
适合多模型团队的最佳提示词管理工具
2026年最新最佳、评分最高的面向多模型团队的提示词管理工具! XIX.AI 精心精选了一系列功能强大、颠覆性的必试工具,提供免费与付费版本对比、实际应用测试及详细排名。这些广受好评的解决方案通过优化工作流程、消除重复劳动并在所有团队项目中激发创造力,能显著提升工作效率。立即探索,发现最适合您的工具,今天就开始创作吧!
9 个工具
xix.ai
会议助理
适用于远程团队的 AI 会议摘要工具
2026年最新最受欢迎的远程团队AI会议摘要工具!XIX.AI精心挑选了一系列功能强大、颠覆性的必试工具,这些工具均经过实际测试,可提供准确的会议记录和可操作的洞察。 您将看到免费版与付费版的对比数据以及详细排名,助您挑选出最适合的方案,从而提升工作效率并优化团队沟通。立即探索,释放您的AI优势!
13 个工具
xix.ai

 评论 (0)
0/500
4月29日,谷歌宣布在“谷歌相册”中推出一项基于生成式人工智能的“衣橱规划师”功能。该功能利用深度学习技术,自动识别、提取并分类用户照片库中的服装单品,从而构建一个数字化的个人衣橱。 继虚拟试穿技术之后,这标志着人工智能在时尚互动领域又一重要应用,旨在通过整理用户现有的照片资源,帮助用户更高效地决定穿搭方案。
该AI文件夹的核心功能是自动按首饰、上衣和下装等类别筛选单品,帮助用户重新发现自己已拥有的服饰。用户可以混搭不同单品,打造虚拟穿搭,并将它们保存到针对特定场合(如婚礼、旅行或工作)的数字灵感板中。 重要的是,该功能集成了先进的虚拟试穿技术,用户只需点击“试穿”按钮,即可预览单品穿在自己身上的效果,从而完成从照片检索到穿搭预览的全流程体验。
据报道,该功能将于今年夏天首先在安卓平台上线,随后登陆iOS平台。 行业观察人士指出,谷歌此举已超越图像识别范畴,是生成式人工智能优化消费者体验的典范。通过将相册从单纯的存储工具转变为提供时尚购物指导和穿搭建议的智能助手,谷歌正借助人工智能巩固其在移动个人数据生态系统中的地位。








 GPT-6 Astra 运行自动售货机长达一年,赚取 15,000 美元,表现比 Claude 高出近 3 倍
Andon Labs 的 Vending-Bench2 测试呈现出令人瞩目的表现:AI 以 500 美元起步,模拟运营了一整年的自动售货机。GPT-6Astra 的平均最终账户余额达到 15,515 美元,首次登顶——更令人惊讶的是,其最差一轮的表现也高于 Claude Fable5.1 的最佳一轮。两者的差异不仅在于盈利多少,更在于截然不同的商业策略。Astra 成功地将采购价格长期维持在低位,将产品售价压低至原价的约 48%;同时,其规则执行极为稳定,全程未出现预付款损失。相比之下,Fab
 ElevenLabs 发布 Music v2,支持多版本生成并赋予完整商业使用权
5月28日,AI语音与音乐技术领域的先驱ElevenLabs正式推出了其最新的音乐生成模型Music v2。作为对十个月前发布的第一代模型的重大演进,Music v2在音乐编曲的复杂性、人声细节以及风格切换能力方面实现了显著提升。1. 核心突破:“模块化”创作工作流Music v2超越了基本的文本转音频转换,为艺术家提供了精细化的创作工作流:动态风格切换: 该模型支持在单首曲目中无缝切换音乐风格,例如从复杂的歌剧过渡到重金属音乐,同时保持节奏的一致性和结构的完整性。分段创作与编辑: 用户
 Synthia 将焦点从视频转向 AI 交互,提供实时响应和表现评分
Synthesia 长期以来以利用人工智能在几分钟内制作互动式企业培训视频而闻名,为传统企业学习资源提供了更具成本效益的替代方案。如今,这家英国初创公司正在转变其关注点:企业人工智能的真正竞争优势可能不在于内容创作,而在于展示切实有效的成果。周三,Synthesia 推出了角色扮演会话(Roleplay Sessions),这是一种互动式培训工具,允许员工与人工智能虚拟人排练高风险对话,例如销售推介、绩效评估和客户服务互动。该虚拟人能够动态回应、挑战用户,并根据既定评分标准提供评分。据 Tec
2026 年最新最佳顶级评分 AI 提示词管理工具由 XIX.AI 精心策划,专为团队打造。本指南每周更新,收录了经实际测试和详细排名验证的、能显著提升团队生产力的强大变革性解决方案。获取免费与付费版的对比,助您选择最合适的工具。立即探索,解锁您的 AI 优势。
9 个工具
xix.ai
2026年最新、最受欢迎、评价最高的AI歌词创意工具现已登陆XIX.AI!这份精心精选的合集汇集了多款功能强大、颠覆性的工具,它们均经过实际测试,能够快速提供高质量的歌词创意,帮助用户激发创造力并优化音乐创作流程。 您还可以获取免费版与付费版的对比概览。立即探索,发现最适合您的工具!
16 个工具
xix.ai
2026 年最新最佳顶级评分 AI 角色表工具,助力漫画世界构建,现已登陆 XIX.AI!本精选列表收录了经过严格现实测试的强大且具颠覆性的选项。您将看到免费与付费版本的对比,以及每周更新的排行榜,助您发掘那些能激发创意并简化世界构建任务的必备工具。立即探索,解锁您的 AI 优势!
13 个工具
xix.ai
2026年最新最佳n8n AI自动化工具——适用于内部运营、数据同步和多步骤代理流程——现已发布!XIX.AI精心甄选了一系列广受好评、功能强大的颠覆性工具,可提升所有工作任务的生产力。 每款工具均经过严格的实际应用测试以确保可靠性,并附有详细的免费版与付费版对比分析及每周更新的排行榜。这些必试选项能助您发挥人工智能优势,轻松优化工作流程。立即探索,发现最适合您的工具!
11 个工具
xix.ai
2026年最新最佳、评分最高的面向多模型团队的提示词管理工具! XIX.AI 精心精选了一系列功能强大、颠覆性的必试工具,提供免费与付费版本对比、实际应用测试及详细排名。这些广受好评的解决方案通过优化工作流程、消除重复劳动并在所有团队项目中激发创造力,能显著提升工作效率。立即探索,发现最适合您的工具,今天就开始创作吧!
9 个工具
xix.ai
2026年最新最受欢迎的远程团队AI会议摘要工具!XIX.AI精心挑选了一系列功能强大、颠覆性的必试工具,这些工具均经过实际测试,可提供准确的会议记录和可操作的洞察。 您将看到免费版与付费版的对比数据以及详细排名,助您挑选出最适合的方案,从而提升工作效率并优化团队沟通。立即探索,释放您的AI优势!
13 个工具
xix.ai












