


 首页
Bytedance加入DeepFake AI视频市场
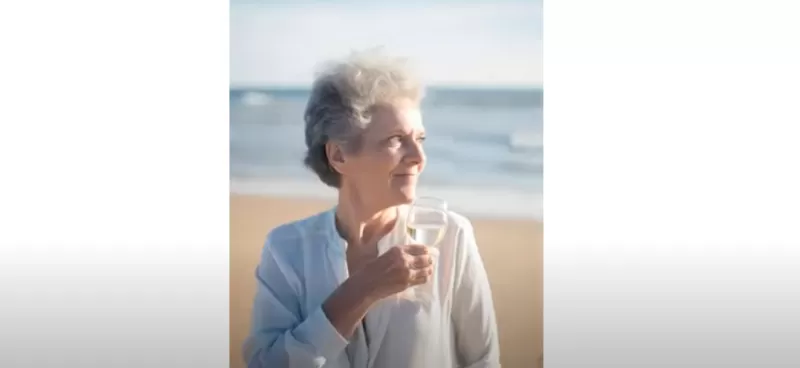
字节跳动,TikTok背后的公司,刚刚展示了他们最新的AI创作OmniHuman-1,效果相当惊艳。这个新系统能够生成超级逼真的视频,只需一张参考图像和一些音频即可。酷的是,你可以调整视频的宽高比,甚至稍微改变主体的身体比例。现在,OmniHuman-1并非完美无瑕,但我得说,它比我们见过的其他深伪技术前进了一大步。
相关文章
 Google Vids 推出新功能,让用户能在定制的 AI 生成视频中担任主角
尽管OpenAI的Sora项目已停止开发,但谷歌认为,市场对能够让用户在AI生成的视频中化身主角的工具仍存在强劲需求。周四,该公司发布了Google Vids的更新版本,新增了根据用户上传的自拍照和语音录音创建个性化数字化身的功能。此外,谷歌正在将多模态AI模型Gemini Omni集成到Vids中。通过此次集成,用户可以结合文字描述和上传的参考图片来制作视频。 随后,Gemini Omni会综合
OpenAI 简化了 AI 生成的图像的验证流程
随着人工智能图像生成工具在网络上的普及和日益成熟,区分真实图像与伪造图像的难度也前所未有地增加。本周二,OpenAI公布了两项新措施以应对这一问题。该公司已采用开放的C2PA标准,该标准会在元数据中嵌入一个清晰信号,表明该图像由AI生成。此外,OpenAI正与谷歌合作,引入名为SynthID的隐形水印——该水印设计得更难被检测到,如果恶意行为者试图掩盖行踪,则更难被移除。这些保护措施目前仅适用于由
随着内容创作者寻求对AI媒体的控制权,ComfyUI估值达到5亿美元
初创公司ComfyUI通过基于节点的流程,使创作者能够精确控制扩散模型生成的图像、视频和音频输出,该公司已获得3000万美元融资,估值达5亿美元。本轮融资由 Craft Ventures 领投,Pace Capital、Chemistry 和 TruArrow 跟投。ComfyUI 始于 2023 年,在扩散模型刚出现不久时作为开源项目启动。当时,像 Midjourney 和 OpenAI 的 D
相关专题推荐
设计与艺术
 最适合创意实验的AI风格转换工具
2026年最新最佳、评价最高的AI风格转换工具,助您开展创意实验!XIX.AI精心甄选了一系列功能强大、颠覆性的必试工具,这些工具经过实际测试和严格排名,可带来卓越的效果。这些顶级解决方案通过加速内容创作并释放无限创意潜能,帮助创作者显著提升工作效率。 立即探索,找到最适合您的工具,今天就开始创作吧!
 9 个工具
 xix.ai
漫画创作
最适合视觉叙事的AI对话气泡工具
2026年最新、最受欢迎的视觉叙事AI对话气泡工具现已登陆XIX.AI!这份精心精选的合集汇集了功能强大、具有颠覆性的工具,可帮助创作者提升工作效率并突破创作瓶颈。 获取免费版与付费版的对比分析,查看实际测试结果,并查阅最新排行榜,找到最适合打造引人入胜的视觉叙事的必试解决方案。立即探索,发现您的理想工具!
10 个工具
xix.ai
会议助理
顶级AI会议摘要工具:清晰追踪决策与后续跟进
2026年最新高评分最佳AI会议摘要工具,助您清晰追踪决策并轻松跟进。这份精心筛选的清单展示了功能强大、具有颠覆性的解决方案,它们通过自动化会议记录、识别关键行动项以及简化所有项目中的团队协调,显著提升工作效率。 获取免费版与付费版的对比分析,以及实际测试报告和每周更新的排行榜,助您找到最适合的工具。立即探索,释放您的AI优势!
9 个工具
xix.ai
数据分析
最佳人工智能数据清洗工具:快速处理缺失值与重复数据
2026年最新、最优秀且评分最高的AI数据清洗工具,可快速处理缺失值与重复数据问题。这份精心挑选的清单展示了那些功能强大、能带来颠覆性变革的解决方案,可显著提升工作效率。所有候选工具都经过了严格的实际应用测试,以确保其稳定性。您可以获取免费版与付费版的对比信息,找出最符合您需求的必备工具。即刻访问XIX.AI,开启您的AI优势之旅。
11 个工具
xix.ai
设计与艺术
最佳AI创意构思工具,助力艺术家突破视觉瓶颈
2026 年最新最佳顶级评分 AI 创意构思工具由 XIX.AI 精心策划,旨在帮助创作者突破视觉瓶颈并即时提升创造力。这些强大的变革性工具提供真实世界测试、详细的免费与付费对比以及每周更新的排名。发现您的完美工具,加速内容创作,并立即释放您的 AI 优势。立即探索!
14 个工具
xix.ai
音乐创作
适用于 TikTok 背景音乐、Reels 音频和创作者宣传音乐的 AI 节拍生成器
2026年最新最全的AI节拍生成器,适用于TikTok背景音乐、Reels音频及创作者宣传音乐!XIX.AI精心筛选了一系列广受好评、功能强大的革命性工具,这些工具均经过实际测试,可为各类内容创作需求提供完美的音乐。 您将在此找到详尽的免费版与付费版对比数据、每周更新的排行榜,以及不容错过的精选工具,助您激发创意并提升工作效率。立即探索,发现最适合您的工具!
11 个工具
xix.ai

 评论 (48)
0/500
![BrianLewis]()
This AI from ByteDance is wild! OmniHuman-1 making videos from just one photo and audio is next-level. Imagine the creative stuff we could do with this, but kinda scary how real it looks. 😳 Anyone else worried about deepfakes getting out of hand?
![NicholasHernández]()
ByteDance's OmniHuman-1 is wild! Turning one photo into a lifelike video is straight-up sci-fi. But, man, this deepfake stuff could get messy fast—imagine fake celeb scandals everywhere! 😬
![HarryClark]()
ByteDance's OmniHuman-1 is wild! Turning one photo into a lifelike video with just audio is next-level. But, like, how long until we can't trust any video online? 😅 Kinda scary thinking about deepfake chaos in elections or ads.
![RichardJackson]()
ByteDanceのOmniHuman-1はすごいです!一枚の画像と音声だけで超リアルなビデオを作れます。アスペクト比を変更できるのはいい機能です。ただ、ビデオが時々あまりにも完璧すぎて、ちょっと気持ち悪いです。でも、ビデオコンテンツには革命的です!🎥
![CharlesYoung]()
El OmniHuman-1 de ByteDance es alucinante! Puede crear videos super realistas a partir de solo una imagen y algo de audio. La capacidad de cambiar la proporción del video es un buen toque. Pero a veces los videos parecen demasiado perfectos, casi espeluznantes. Aún así, es un cambio de juego para el contenido de video! 🎥
![GaryWilson]()
ByteDance의 OmniHuman-1 정말 대단해요! 한 장의 이미지와 음성만으로 초현실적인 비디오를 만들 수 있어요. 아스펙트 비율을 변경할 수 있는 기능도 좋아요. 다만, 비디오가 때때로 너무 완벽해서 좀 섬뜩해요. 그래도 비디오 콘텐츠에는 혁신적이에요! 🎥
字节跳动,TikTok背后的公司,刚刚展示了他们最新的AI创作OmniHuman-1,效果相当惊艳。这个新系统能够生成超级逼真的视频,只需一张参考图像和一些音频即可。酷的是,你可以调整视频的宽高比,甚至稍微改变主体的身体比例。现在,OmniHuman-1并非完美无瑕,但我得说,它比我们见过的其他深伪技术前进了一大步。








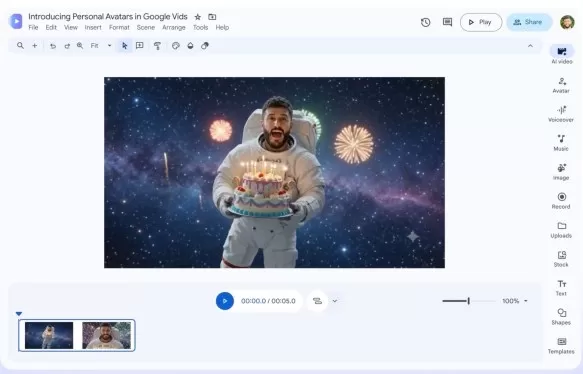 Google Vids 推出新功能,让用户能在定制的 AI 生成视频中担任主角
尽管OpenAI的Sora项目已停止开发,但谷歌认为,市场对能够让用户在AI生成的视频中化身主角的工具仍存在强劲需求。周四,该公司发布了Google Vids的更新版本,新增了根据用户上传的自拍照和语音录音创建个性化数字化身的功能。此外,谷歌正在将多模态AI模型Gemini Omni集成到Vids中。通过此次集成,用户可以结合文字描述和上传的参考图片来制作视频。 随后,Gemini Omni会综合
 OpenAI 简化了 AI 生成的图像的验证流程
随着人工智能图像生成工具在网络上的普及和日益成熟,区分真实图像与伪造图像的难度也前所未有地增加。本周二,OpenAI公布了两项新措施以应对这一问题。该公司已采用开放的C2PA标准,该标准会在元数据中嵌入一个清晰信号,表明该图像由AI生成。此外,OpenAI正与谷歌合作,引入名为SynthID的隐形水印——该水印设计得更难被检测到,如果恶意行为者试图掩盖行踪,则更难被移除。这些保护措施目前仅适用于由
 随着内容创作者寻求对AI媒体的控制权,ComfyUI估值达到5亿美元
初创公司ComfyUI通过基于节点的流程,使创作者能够精确控制扩散模型生成的图像、视频和音频输出,该公司已获得3000万美元融资,估值达5亿美元。本轮融资由 Craft Ventures 领投,Pace Capital、Chemistry 和 TruArrow 跟投。ComfyUI 始于 2023 年,在扩散模型刚出现不久时作为开源项目启动。当时,像 Midjourney 和 OpenAI 的 D

2026年最新最佳、评价最高的AI风格转换工具,助您开展创意实验!XIX.AI精心甄选了一系列功能强大、颠覆性的必试工具,这些工具经过实际测试和严格排名,可带来卓越的效果。这些顶级解决方案通过加速内容创作并释放无限创意潜能,帮助创作者显著提升工作效率。 立即探索,找到最适合您的工具,今天就开始创作吧!
9 个工具
xix.ai

2026年最新、最受欢迎的视觉叙事AI对话气泡工具现已登陆XIX.AI!这份精心精选的合集汇集了功能强大、具有颠覆性的工具,可帮助创作者提升工作效率并突破创作瓶颈。 获取免费版与付费版的对比分析,查看实际测试结果,并查阅最新排行榜,找到最适合打造引人入胜的视觉叙事的必试解决方案。立即探索,发现您的理想工具!
10 个工具
xix.ai

2026年最新高评分最佳AI会议摘要工具,助您清晰追踪决策并轻松跟进。这份精心筛选的清单展示了功能强大、具有颠覆性的解决方案,它们通过自动化会议记录、识别关键行动项以及简化所有项目中的团队协调,显著提升工作效率。 获取免费版与付费版的对比分析,以及实际测试报告和每周更新的排行榜,助您找到最适合的工具。立即探索,释放您的AI优势!
9 个工具
xix.ai

2026年最新、最优秀且评分最高的AI数据清洗工具,可快速处理缺失值与重复数据问题。这份精心挑选的清单展示了那些功能强大、能带来颠覆性变革的解决方案,可显著提升工作效率。所有候选工具都经过了严格的实际应用测试,以确保其稳定性。您可以获取免费版与付费版的对比信息,找出最符合您需求的必备工具。即刻访问XIX.AI,开启您的AI优势之旅。
11 个工具
xix.ai
2026 年最新最佳顶级评分 AI 创意构思工具由 XIX.AI 精心策划,旨在帮助创作者突破视觉瓶颈并即时提升创造力。这些强大的变革性工具提供真实世界测试、详细的免费与付费对比以及每周更新的排名。发现您的完美工具,加速内容创作,并立即释放您的 AI 优势。立即探索!
14 个工具
xix.ai
2026年最新最全的AI节拍生成器,适用于TikTok背景音乐、Reels音频及创作者宣传音乐!XIX.AI精心筛选了一系列广受好评、功能强大的革命性工具,这些工具均经过实际测试,可为各类内容创作需求提供完美的音乐。 您将在此找到详尽的免费版与付费版对比数据、每周更新的排行榜,以及不容错过的精选工具,助您激发创意并提升工作效率。立即探索,发现最适合您的工具!
11 个工具
xix.ai

This AI from ByteDance is wild! OmniHuman-1 making videos from just one photo and audio is next-level. Imagine the creative stuff we could do with this, but kinda scary how real it looks. 😳 Anyone else worried about deepfakes getting out of hand?
ByteDance's OmniHuman-1 is wild! Turning one photo into a lifelike video is straight-up sci-fi. But, man, this deepfake stuff could get messy fast—imagine fake celeb scandals everywhere! 😬
ByteDance's OmniHuman-1 is wild! Turning one photo into a lifelike video with just audio is next-level. But, like, how long until we can't trust any video online? 😅 Kinda scary thinking about deepfake chaos in elections or ads.
ByteDanceのOmniHuman-1はすごいです!一枚の画像と音声だけで超リアルなビデオを作れます。アスペクト比を変更できるのはいい機能です。ただ、ビデオが時々あまりにも完璧すぎて、ちょっと気持ち悪いです。でも、ビデオコンテンツには革命的です!🎥
El OmniHuman-1 de ByteDance es alucinante! Puede crear videos super realistas a partir de solo una imagen y algo de audio. La capacidad de cambiar la proporción del video es un buen toque. Pero a veces los videos parecen demasiado perfectos, casi espeluznantes. Aún así, es un cambio de juego para el contenido de video! 🎥
ByteDance의 OmniHuman-1 정말 대단해요! 한 장의 이미지와 음성만으로 초현실적인 비디오를 만들 수 있어요. 아스펙트 비율을 변경할 수 있는 기능도 좋아요. 다만, 비디오가 때때로 너무 완벽해서 좀 섬뜩해요. 그래도 비디오 콘텐츠에는 혁신적이에요! 🎥












